ما هي واجهة برمجة تطبيقات GPT-5.2
واجهة برمجة تطبيقات GPT-5.2 هي نفسها GPT-5.2 Thinking في ChatGPT. GPT-5.2 Thinking هي الفئة المتوسطة من عائلة GPT-5.2 لدى OpenAI، والمصممة للأعمال الأعمق: الاستدلال متعدد الخطوات، تلخيص المستندات الطويلة، توليد كود عالي الجودة، وأعمال المعرفة الاحترافية حيث تهم الدقة والبنية القابلة للاستخدام أكثر من معدل الإخراج الخام. ضمن الـ API تظهر على شكل النموذج gpt-5.2 (Responses API / Chat Completions)، وتقع بين نسخة Instant منخفضة زمن الاستجابة ونسخة Pro الأعلى جودةً ولكن الأعلى كلفةً.
الميزات الرئيسية
- سياق طويل جدًا والتكثيف: نافذة فعّالة بحجم 400K وأدوات تكثيف لإدارة الملاءمة عبر المحادثات والمستندات الطويلة.
- جهد استدلال قابل للتهيئة:
none | medium | high | xhigh(xhigh يفعّل أقصى حوسبة داخلية للاستدلالات الصعبة). يتاحxhighلإصدارات Thinking/Pro. - دعم أقوى للأدوات والدوال: استدعاء أدوات من الدرجة الأولى، قواعد (CFG/Lark) لتقييد المخرجات المهيكلة، وسلوكيات وكيليّة محسّنة تُبسّط الأتمتة المعقّدة متعددة الخطوات.
- فهم متعدد الوسائط: فهم أغنى للصور + النص ودمجهما في مهام متعددة الخطوات.
- تحسين الأمان/التعامل مع المحتوى الحساس: تدخلات موجّهة لتقليل الاستجابات غير المرغوبة في مجالات مثل إيذاء النفس وسياقات حساسة أخرى.
الإمكانات التقنية والمواصفات (من منظور المطوّر)
- نقاط نهاية API ومعرّفات النماذج:
gpt-5.2لـ Thinking (Responses API)، وgpt-5.2-chat-latestلتدفقات chat/instant، وgpt-5.2-proلفئة Pro؛ متاحة عبر Responses API وChat Completions حيثما هو مذكور. - رموز الاستدلال وإدارة الجهد: يدعم الـ API معاملات صريحة لتخصيص الحوسبة (جهد الاستدلال) لكل طلب؛ زيادة الجهد ترفع زمن الاستجابة والتكلفة لكنها تحسّن جودة المخرجات للمهام المعقّدة.
- أدوات مخرجات مهيكلة: دعم القواعد (Lark / CFG) لتقييد مخرجات النموذج إلى DSL أو صياغة دقيقة (مفيد لـ SQL وJSON وتوليد DSL).
- استدعاء أدوات بالتوازي والتنسيق الوكيلي: توازي محسّن وتنظيم أوضح للأدوات يقلّل الحاجة إلى مطالبات نظام معقّدة وهياكل متعددة الوكلاء.
أداء المقاييس والبيانات الداعمة
نشرت OpenAI مجموعة متنوعة من نتائج المقارنات القياسية الداخلية والخارجية لـ GPT-5.2. أبرز النقاط المختارة (وفق الأرقام المعلنة من OpenAI):
- GDPval (44 مهنة، أعمال معرفية) — تشير OpenAI إلى أن GPT-5.2 Thinking «يتفوّق أو يعادل أفضل محترفي الصناعة في 70.9% من المقارنات»؛ وتذكر أن المخرجات أُنجزت عند >11× سرعة الإنجاز و**<1% من التكلفة** مقارنة بالمحترفين الخبراء في مهام GDPval لديهم (تقديرات السرعة والتكلفة مبنية على بيانات تاريخية). تشمل هذه المهام نماذج جداول البيانات، العروض التقديمية، ومقاطع الفيديو القصيرة.
- SWE-Bench Pro (coding) — يحقق GPT-5.2 Thinking ≈55.6% على SWE-Bench Pro و**~80%** على SWE-Bench Verified (Python فقط) وفق OpenAI، ما يؤسس لمستوى جديد من الحدّ الأعلى في تقييم توليد الكود/الهندسة ضمن اختباراتهم. ويُترجم ذلك عمليًا إلى تنقيح أكثر موثوقية وإصلاحات شاملة من طرف إلى طرف، بحسب أمثلة OpenAI.
- GPQA Diamond (أسئلة وأجوبة في علوم مستوى الدراسات العليا) — GPT-5.2 Pro: 93.2%، وGPT-5.2 Thinking: 92.4% على GPQA Diamond (من دون أدوات، أقصى استدلال).
- سلسلة ARC-AGI — على ARC-AGI-2 (مقياس أصعب للاستدلال السائل)، حقق GPT-5.2 Thinking درجة 52.9% وGPT-5.2 Pro 54.2% (تقول OpenAI إنها علامات جديدة تعكس أعلى مستوى لنماذج أسلوب chain-of-thought).
- سياق طويل (OpenAI MRCRv2) — يُظهر GPT-5.2 Thinking دقة شبه 100% على متغير MRCR بأربع إبر حتى 256k tokens وتحسنًا كبيرًا مقارنةً بـ GPT-5.1 عبر إعدادات السياق الطويل. (نشرت OpenAI رسومًا وجداول MRCRv2.)
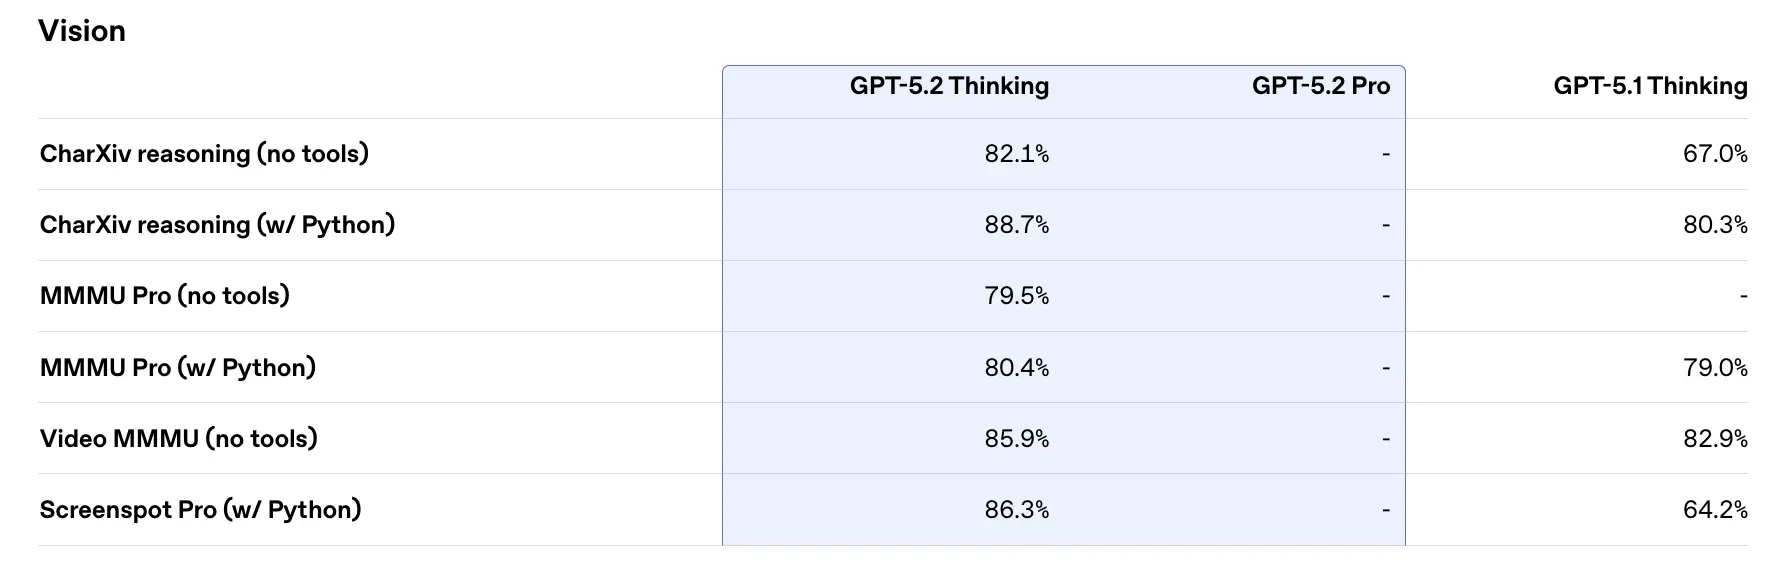
المقارنة مع المعاصرين
- مقابل Google Gemini 3 (Gemini 3 Pro / Deep Think): جرى الترويج لـ Gemini 3 Pro بنافذة سياق تقارب 1,048,576 (~1M) توكن ومدخلات متعددة الوسائط واسعة (نص، صورة، صوت، فيديو، ملفات PDF) وتكاملات وكيليّة قوية عبر Vertex AI / AI Studio. نظريًا، تشكل نافذة السياق الأكبر في Gemini 3 عامل تمييز لأعباء العمل الضخمة ضمن جلسة واحدة؛ وتشمل المقايضات مساحة الأدوات وملاءمة المنظومة البيئية.
- مقابل Anthropic Claude Opus 4.5: يركز Opus 4.5 على مسارات عمل ترميز/وكلاء المؤسسات ويعرض نتائج قوية على SWE-bench ومتانة للجلسات الوكيليّة الطويلة؛ وتضعه Anthropic للأتمتة وتوليد الكود مع نافذة سياق 200k وتكاملات وكيل/Excel متخصصة. Opus 4.5 منافس قوي في أتمتة المؤسسات ومهام الكود.
الخلاصة العملية: يستهدف GPT-5.2 مجموعة متوازنة من التحسينات (سياق 400k، مخرجات توكن مرتفعة، تحسين الاستدلال/البرمجة). يستهدف Gemini 3 أكبر سياقات الجلسة الواحدة (≈1M)، بينما يركّز Claude Opus على هندسة المؤسسات ومتانة السلوك الوكيلي. اختر بناءً على حجم السياق، احتياجات النمط/الوسائط، التوافق مع الميزات/الأدوات، ومقايضات التكلفة/زمن الاستجابة.
كيفية الوصول إلى واستخدام واجهة برمجة تطبيقات GPT-5.2
الخطوة 1: التسجيل للحصول على مفتاح API
سجّل الدخول إلى cometapi.com. إن لم تكن مستخدمًا لدينا بعد، يُرجى التسجيل أولًا. سجّل الدخول إلى CometAPI console. احصل على اعتماد الوصول (مفتاح API) للواجهة. انقر “Add Token” ضمن رمز API في المركز الشخصي، واحصل على مفتاح الرمز: sk-xxxxx ثم أرسله.
الخطوة 2: إرسال الطلبات إلى واجهة برمجة تطبيقات GPT-5.2
اختر نقطة النهاية “gpt-5.2” لإرسال طلب API وقُم بضبط جسم الطلب. يمكن الحصول على طريقة الطلب وجسمه من وثيقة API على موقعنا. يوفر موقعنا أيضًا اختبار Apifox لراحتك. استبدل <YOUR_API_KEY> بمفتاح CometAPI الفعلي من حسابك. يستدعي المطوّرون ذلك عبر Responses API / نقاط نهاية Chat.
أدرج سؤالك أو طلبك في حقل المحتوى—فهذا ما سيستجيب له النموذج. عالج استجابة API للحصول على الإجابة المُولَّدة.
الخطوة 3: استرجاع النتائج والتحقق منها
قم بمعالجة استجابة API للحصول على الإجابة المُولَّدة. بعد المعالجة، تستجيب الـ API بحالة المهمة وبيانات المخرجات.
راجع أيضًا Gemini 3 Pro Preview API