Tekniske specifikationer for gpt-realtime-1.5
| Punkt | gpt-realtime-1.5 (public positioning) |
|---|---|
| Modelfamilie | GPT Realtime 1.5 (stemmeoptimeret variant) |
| Primær modalitet | Tale-til-tale (S2S) |
| Inputtyper | Lyd (streaming), tekst |
| Outputtyper | Lyd (streaming), tekst, strukturerede funktionskald |
| API | Realtime API (WebRTC / vedvarende streaming-sessioner) |
| Latensprofil | Optimeret til lav latens, live samtaleinteraktion |
| Sessionsmodel | Tilstandsbevarende streaming-sessioner |
| Brug af værktøjer | Understøtter funktionskald og værktøjsintegrationer |
| Målanvendelse | Live stemmeagenter, assistenter, interaktive systemer |
Bemærk: Præcise token-grænser og kontekstvinduesstørrelser er ikke fremhævet i offentlige oversigter; modellen er positioneret til reaktionsevne i realtid frem for ekstremt lange kontekstsessions.
Hvad er gpt-realtime-1.5?
gpt-realtime-1.5 er en lav-latens, tale-til-tale-optimeret model designet til live samtalesystemer. I modsætning til traditionelle request-response-modeller fungerer den gennem vedvarende streaming-sessioner, hvilket muliggør naturlig turtagning, håndtering af afbrydelser og dynamisk stemmeinteraktion.
Den er specialbygget til applikationer, hvor hastigheden i samtaleforløbet er vigtigere end maksimal kontekstlængde.
Hovedfunktioner
- Ægte tale-til-tale-interaktion — Accepterer live-lydinput og streamer talte svar i realtid.
- Lav-latens-arkitektur — Designet til under-sekunds reaktionshastighed i stemmeagenter.
- Streaming-først-design — Fungerer via vedvarende sessioner (WebRTC eller streamingprotokoller).
- Naturlig turtagning — Understøtter håndtering af afbrydelser og dynamisk samtaleflow.
- Understøttelse af funktionskald — Kan udløse strukturerede funktionskald under en realtidsession.
- Produktionsklar base for stemmeagenter — Bygget specifikt til interaktive assistenter, kiosker og indlejrede enheder.
Benchmark og ydelsespositionering
OpenAI positionerer gpt-realtime-1.5 som en videreudvikling af tidligere realtime-modeller med forbedret efterlevelse af instruktioner, større stabilitet under længere stemmesessioner og mere naturlig prosodi sammenlignet med tidligere udgivelser.
I modsætning til kodefokuserede modeller (fx Codex-varianter) måles ydeevnen mere på samtalelatens, stemmens naturlighed og sessionsstabilitet end på leaderboard-lignende benchmarks.
gpt-realtime-1.5 vs. relaterede modeller
| Funktion | gpt-realtime-1.5 | gpt-audio-1.5 |
|---|---|---|
| Primært mål | Live stemmeinteraktion | Chat-arbejdsgange med lyd |
| Latens | Optimeret til minimal forsinkelse | Balanceret kvalitet/hastighed |
| Sessionstype | Vedvarende streaming-session | Standard Chat Completions-flow |
| Kontekststørrelse | Optimeret til reaktionshastighed | Større kontekstunderstøttelse |
| Bedste anvendelse | Realtids-stemmeagenter | Samtaleassistenter med lyd |
Hvornår du skal vælge hver
- Vælg gpt-realtime-1.5 til callcentre, kiosker, AI-receptionister eller live indlejrede assistenter.
- Vælg gpt-audio-1.5 til stemmeaktiverede chatapps, der kræver længere samtalehukommelse eller multimodale arbejdsgange.
Repræsentative anvendelsestilfælde
- AI-callcenteragenter
- Assistenter til smarte enheder
- Interaktive kiosker
- Live-undervisningssystemer
- Værktøjer til sprogtræning i realtid
- Stemmestyrede applikationer
- Sådan får du adgang til GPT realtime 1.5 API
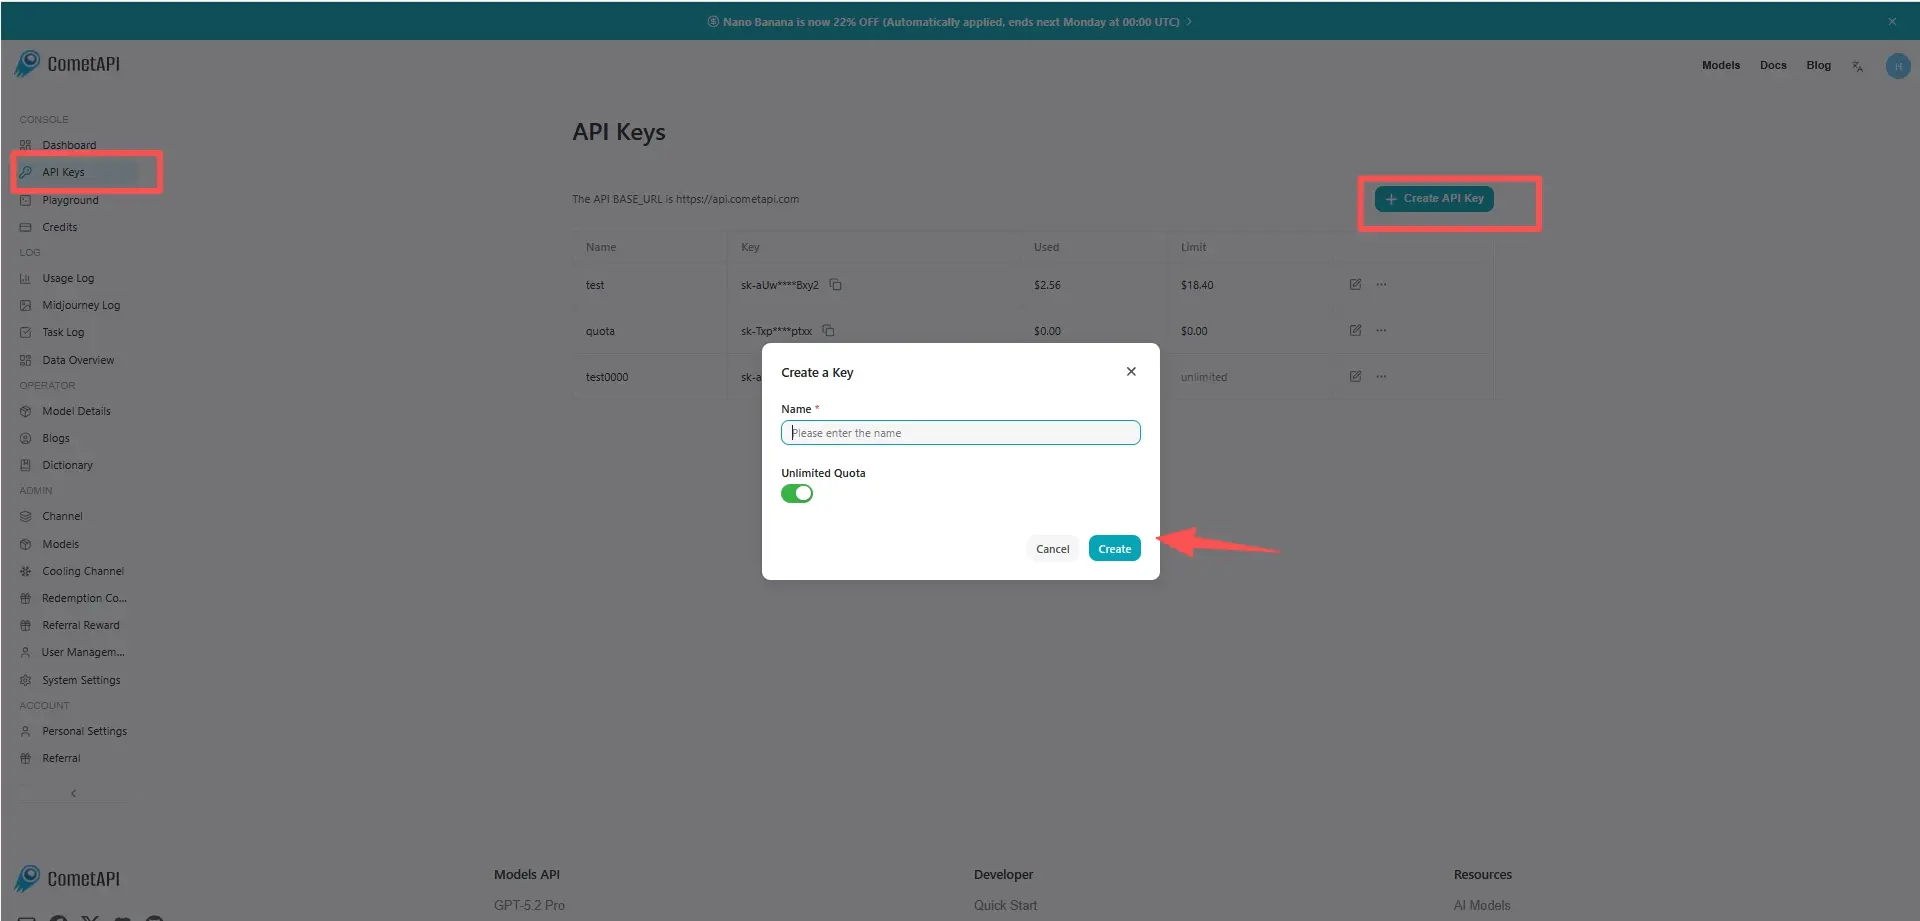
Trin 1: Tilmeld dig for at få en API-nøgle
Log ind på cometapi.com. Hvis du endnu ikke er bruger hos os, skal du først registrere dig. Log ind på din CometAPI-konsol. Hent API-nøglen til adgangslegitimation for interfacet. Klik på “Add Token” ved API-token i det personlige center, få token-nøglen: sk-xxxxx og indsend.
Trin 2: Send forespørgsler til GPT realtime 1.5 API
Vælg “gpt-realtime-1.5”-endepunktet for at sende API-forespørgslen og angiv request body. Anmodningsmetode og request body findes i vores websteds API-dokumentation. Vores website tilbyder også Apifox-test for din bekvemmelighed. Erstat <YOUR_API_KEY> med din faktiske CometAPI-nøgle fra din konto. Basis-URL er Chat Completions
Indsæt dit spørgsmål eller din anmodning i content-feltet—det er dette, modellen svarer på. Behandl API-svaret for at få det genererede svar.
Trin 3: Hent og verificer resultater
Behandl API-svaret for at få det genererede svar. Efter behandlingen svarer API'et med opgavestatus og outputdata.