Was ist die GPT-5.2-API
Die GPT-5.2-API entspricht in ChatGPT der GPT-5.2 Thinking. GPT-5.2 Thinking ist die mittlere Variante der GPT-5.2‑Familie von OpenAI, entwickelt für tiefere Arbeit: mehrstufiges Reasoning, Zusammenfassung langer Dokumente, hochwertige Codegenerierung sowie professionelles Wissens‑ und Strukturarbeiten, bei dem Genauigkeit und nutzbare Struktur wichtiger sind als reiner Durchsatz. In der API ist sie als Modell gpt-5.2 (Responses API / Chat Completions) verfügbar und positioniert sich zwischen der latenzarmen Instant‑Variante und der höherwertigen, aber teureren Pro‑Variante.
Hauptfunktionen
- Sehr langer Kontext & Kompaktierung: Effektives Fenster mit 400K sowie Kompaktierungswerkzeuge zur Relevanzsteuerung in langen Gesprächen und Dokumenten.
- Konfigurierter Reasoning‑Aufwand:
none | medium | high | xhigh(xhigh aktiviert maximale interne Rechenleistung für schwieriges Reasoning).xhighist in den Thinking/Pro‑Varianten verfügbar. - Stärkere Tool‑ und Funktionsunterstützung: Erstklassiges Tool‑Calling, Grammatiken (CFG/Lark) zur Einschränkung strukturierter Ausgaben und verbesserte agentische Verhaltensweisen, die komplexe mehrstufige Automatisierung vereinfachen.
- Multimodales Verständnis: Reichere Bild‑ und Textverständnisfunktionen und Integration in mehrstufige Aufgaben.
- Verbesserte Sicherheit/Umgang mit sensiblen Inhalten: Zielgerichtete Maßnahmen zur Reduktion unerwünschter Antworten in Bereichen wie Selbstverletzung und anderen sensiblen Kontexten.
Technische Fähigkeiten & Spezifikationen (Entwicklersicht)
- API‑Endpoints & Modell‑IDs:
gpt-5.2für Thinking (Responses API),gpt-5.2-chat-latestfür Chat/Instant‑Workflows undgpt-5.2-profür die Pro‑Stufe; verfügbar über die Responses API und Chat Completions, wo angegeben. - Reasoning‑Tokens & Aufwandssteuerung: Die API unterstützt explizite Parameter zur Zuteilung von Rechenaufwand (Reasoning‑Effort) pro Anfrage; höherer Aufwand erhöht Latenz und Kosten, verbessert aber die Ausgabequalität bei komplexen Aufgaben.
- Werkzeuge für strukturierte Ausgaben: Unterstützung für Grammatiken (Lark / CFG), um Modellausgaben auf eine DSL oder eine exakte Syntax zu beschränken (nützlich für SQL, JSON, DSL‑Generierung).
- Paralleles Tool‑Calling & agentische Koordination: Verbesserte Parallelität und saubere Tool‑Orchestrierung reduzieren den Bedarf an aufwendigen System‑Prompts und Multi‑Agent‑Gerüsten.
Benchmark‑Leistung & unterstützende Daten
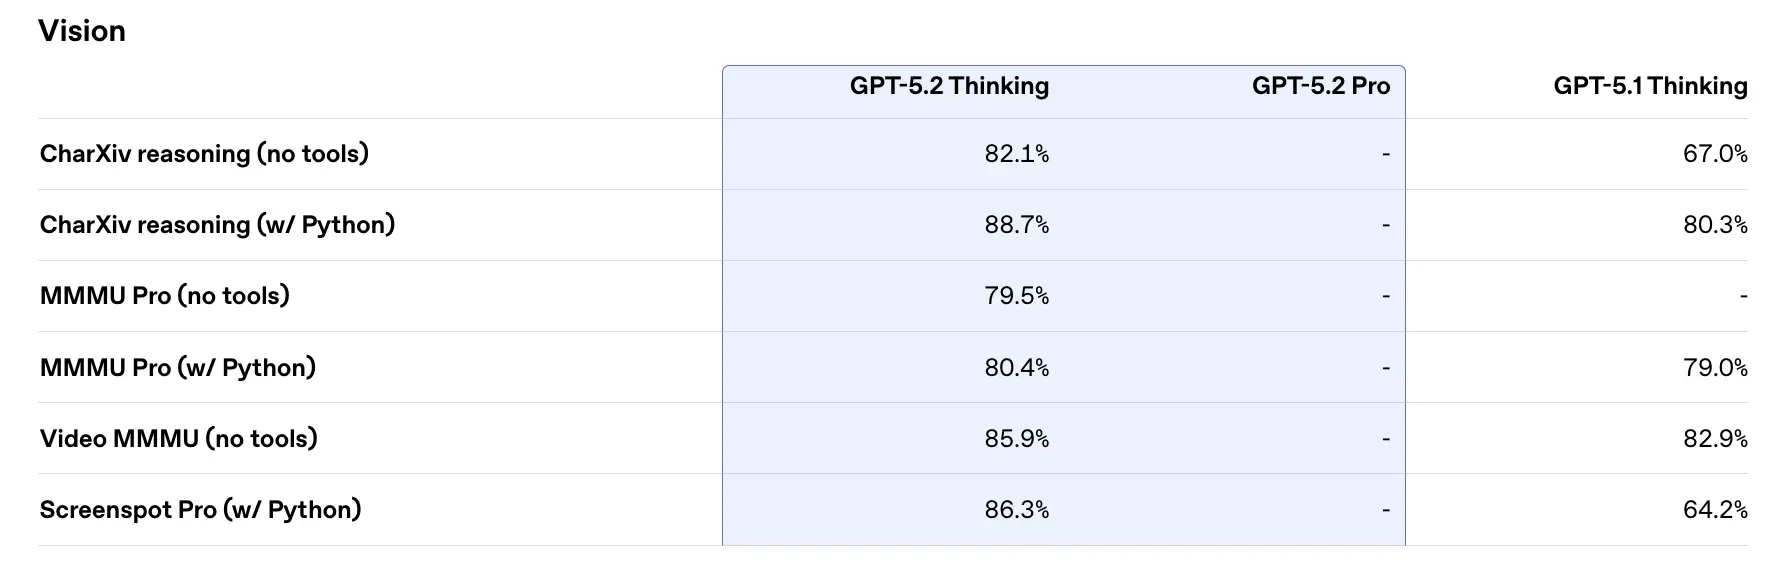
OpenAI hat verschiedene interne und externe Benchmarks für GPT-5.2 veröffentlicht. Ausgewählte Highlights (von OpenAI gemeldete Zahlen):
- GDPval (44 Berufe, Knowledge Work) — GPT-5.2 Thinking „übertrifft oder erreicht Top‑Industrieprofis in 70,9 % der Vergleiche“; OpenAI berichtet, dass Ausgaben mit >11× der Geschwindigkeit und <1% der Kosten von Expertenprofis bei ihren GDPval‑Aufgaben produziert wurden (Geschwindigkeits‑ und Kostenschätzungen sind historisch basiert). Diese Aufgaben umfassen Tabellenkalkulationsmodelle, Präsentationen und kurze Videos.
- SWE‑Bench Pro (Coding) — GPT-5.2 Thinking erreicht ≈55,6 % auf SWE‑Bench Pro und ~80 % auf SWE‑Bench Verified (nur Python) laut OpenAI und setzt damit in ihren Tests einen neuen Stand der Technik für Codegenerierung/Engineering‑Evaluierungen. Dies führt in der Praxis zu zuverlässigerem Debugging und End‑to‑End‑Fixes, so OpenAI.
- GPQA Diamond (wissenschaftliche Q&A auf Graduiertenniveau) — GPT-5.2 Pro: 93,2 %, GPT-5.2 Thinking: 92,4 % auf GPQA Diamond (ohne Tools, maximales Reasoning).
- ARC‑AGI‑Reihe — Auf ARC‑AGI‑2 (ein schwereres Benchmark für flüssiges Reasoning) erzielte GPT-5.2 Thinking 52,9 % und GPT-5.2 Pro 54,2 % (OpenAI bezeichnet dies als neue SOTA‑Werte für Chain‑of‑Thought‑Modelle).
- Langkontext (OpenAI MRCRv2) — GPT-5.2 Thinking zeigt nahezu 100 % Genauigkeit bei der 4‑Needle‑MRCR‑Variante bis 256k Tokens und deutlich verbesserte Werte gegenüber GPT‑5.1 in Langkontext‑Einstellungen. (OpenAI hat MRCRv2‑Diagramme und ‑Tabellen veröffentlicht.)
Vergleich mit Zeitgenossen
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro wurde mit einem Kontextfenster von ~1.048.576 (≈1M) Tokens und breiten multimodalen Eingaben (Text, Bild, Audio, Video, PDFs) sowie starken agentischen Integrationen über Vertex AI / AI Studio beworben. Auf dem Papier ist das größere Kontextfenster von Gemini 3 ein Differenzierungsmerkmal für extrem große Workloads in einer einzigen Sitzung; Trade‑offs umfassen die Tooling‑Fläche und die Ökosystem‑Passung.
- vs Anthropic Claude Opus 4.5: Anthropics Opus 4.5 betont Enterprise‑Coding/Agent‑Workflows und berichtet starke SWE‑Bench‑Ergebnisse sowie Robustheit für lange agentische Sitzungen; Anthropic positioniert Opus für Automatisierung und Codegenerierung mit einem 200k‑Kontextfenster und spezialisierten Agent/Excel‑Integrationen. Opus 4.5 ist ein starker Wettbewerber bei Enterprise‑Automatisierung und Code‑Aufgaben.
Praktisches Fazit: GPT-5.2 zielt auf einen ausgewogenen Satz an Verbesserungen (400k Kontext, hohe Token‑Ausgaben, verbessertes Reasoning/Coding). Gemini 3 zielt auf die absolut größten Kontexte in einer Sitzung (≈1M), während Claude Opus den Schwerpunkt auf Enterprise‑Engineering und agentische Robustheit legt. Wählen Sie anhand von Kontextgröße, Modalitätsbedarf, Feature/Tooling‑Passung sowie Kosten/Latenz‑Abwägungen.
Zugriff und Nutzung der GPT-5.2‑API
Schritt 1: Für einen API‑Schlüssel registrieren
Melden Sie sich bei cometapi.com an. Wenn Sie noch kein Nutzer sind, registrieren Sie sich bitte zuerst. Melden Sie sich bei Ihrer CometAPI console an. Holen Sie sich die Zugangsdaten (API‑Schlüssel) der Schnittstelle. Klicken Sie im persönlichen Zentrum beim API‑Token auf „Add Token“, erhalten Sie den Token‑Key: sk-xxxxx und senden Sie ihn ab.
Schritt 2: Anfragen an die GPT-5.2‑API senden
Wählen Sie den „gpt-5.2“-Endpoint, um die API‑Anfrage zu senden, und setzen Sie den Request‑Body. Methode und Request‑Body erhalten Sie aus der API‑Dokumentation auf unserer Website. Unsere Website bietet außerdem einen Apifox‑Test zu Ihrer Bequemlichkeit. Ersetzen Sie <YOUR_API_KEY> durch Ihren tatsächlichen CometAPI‑Schlüssel aus Ihrem Konto. Entwickler rufen diese über die Responses API / Chat Endpunkte auf.
Fügen Sie Ihre Frage oder Anfrage in das content‑Feld ein — darauf wird das Modell antworten. Verarbeiten Sie die API‑Antwort, um die generierte Antwort zu erhalten.
Schritt 3: Ergebnisse abrufen und verifizieren
Verarbeiten Sie die API‑Antwort, um die generierte Ausgabe zu erhalten. Nach der Verarbeitung antwortet die API mit dem Task‑Status und den Ausgabedaten.
Siehe auch Gemini 3 Pro Preview API