Technische Spezifikationen von GLM-5-Turbo
| Element | GLM-5-Turbo (geschätzt / frühe Veröffentlichung) |
|---|---|
| Modellfamilie | GLM-5 (Turbo-Variante – für geringe Latenz optimiert) |
| Anbieter | Zhipu AI (Z.ai) |
| Architektur | Mixture-of-Experts (MoE) mit sparsamer Aufmerksamkeit |
| Eingabetypen | Text |
| Ausgabetypen | Text |
| Kontextfenster | ~200,000 tokens |
| Maximale Ausgabe-Token | Bis zu ~128,000 (frühe Berichte) |
| Kernfokus | Agenten-Workflows, Tool-Nutzung, schnelle Inferenz |
| Veröffentlichungsstatus | Experimentell / teilweise Closed Source |
Was ist GLM-5-Turbo
GLM-5-Turbo ist eine auf Latenz optimierte Variante der GLM-5-Modellfamilie, die speziell für produktionsreife Agent-Workflows und Echtzeitanwendungen entwickelt wurde. Es baut auf der großskaligen MoE-Architektur von GLM-5 (~745B Parameter) auf und verlagert den Schwerpunkt auf Geschwindigkeit, Reaktionsfähigkeit und Zuverlässigkeit der Tool-Orchestrierung statt auf maximale Reasoning-Tiefe.
Im Gegensatz zur Basisversion GLM-5 (die auf Spitzen-Reasoning und Coding-Benchmarks abzielt) ist die Turbo-Version auf interaktive Systeme, Automatisierungspipelines und mehrstufige Tool-Ausführung abgestimmt.
Wichtige Funktionen von GLM-5-Turbo
- Inferenz mit geringer Latenz: Für kürzere Antwortzeiten im Vergleich zu Standard-GLM-5 optimiert, wodurch es sich für Echtzeitanwendungen eignet.
- Agent-first-Training: Von der Trainingsphase an auf Tool-Nutzung und mehrstufige Workflows ausgelegt, nicht nur auf Fine-Tuning nach dem Training.
- Großes Kontextfenster (200K): Verarbeitet lange Dokumente, Codebasen und mehrstufige Reasoning-Ketten in einer einzelnen Sitzung.
- Hohe Zuverlässigkeit beim Tool-Calling: Verbesserte Funktionsausführung und Workflow-Verkettung für Agentensysteme.
- Effiziente MoE-Architektur: Aktiviert pro Token nur einen Teil der Parameter und balanciert so Kosten und Leistung.
- Produktionsorientiertes Design: Priorisiert Stabilität und Durchsatz gegenüber maximalen Benchmark-Werten.
Benchmark- und Performance-Einblicke
Auch wenn GLM-5-Turbo-spezifische Benchmarks nicht vollständig offengelegt sind, übernimmt es Leistungsmerkmale von GLM-5:
- ~77.8% auf SWE-bench Verified (GLM-5-Basislinie)
- Starke Leistung bei agentischem Coding und Aufgaben mit langem Horizont
- Wettbewerbsfähig mit Modellen wie Claude Opus und Systemen der GPT-Klasse bei Reasoning und Coding
👉 Turbo tauscht etwas Spitzenpräzision gegen schnellere Inferenz und bessere Echtzeittauglichkeit ein.
GLM-5-Turbo vs. vergleichbare Modelle
| Modell | Stärke | Schwäche | Bestes Einsatzszenario |
|---|---|---|---|
| GLM-5-Turbo | Schnell, agentenfokussiert, langer Kontext | Weniger Spitzen-Reasoning gegenüber Flaggschiff | Echtzeit-Agenten, Automatisierung |
| GLM-5 (Basis) | Starkes Reasoning, hohe Benchmarks | Langsamere Inferenz | Forschung, komplexes Coding |
| Modelle der GPT-5-Klasse | Erstklassiges Reasoning, multimodal | Höhere Kosten, geschlossen | Unternehmensgerechte KI |
| Claude Opus (neueste) | Zuverlässiges Reasoning, Sicherheit | Langsamer in Agentenschleifen | Langform-Reasoning |
Beste Anwendungsfälle
- KI-Agenten & Automatisierungspipelines (mehrstufige Workflows)
- Echtzeit-Chat-Systeme mit geringer Latenz
- Tool-integrierte Anwendungen (APIs, Retrieval, Funktionsaufrufe)
- Entwickler-Copiloten mit schnellen Feedback-Schleifen
- Anwendungen mit langem Kontext wie Dokumentanalyse
Zugriff auf die GLM-5 Turbo API
Schritt 1: Für den API-Schlüssel anmelden
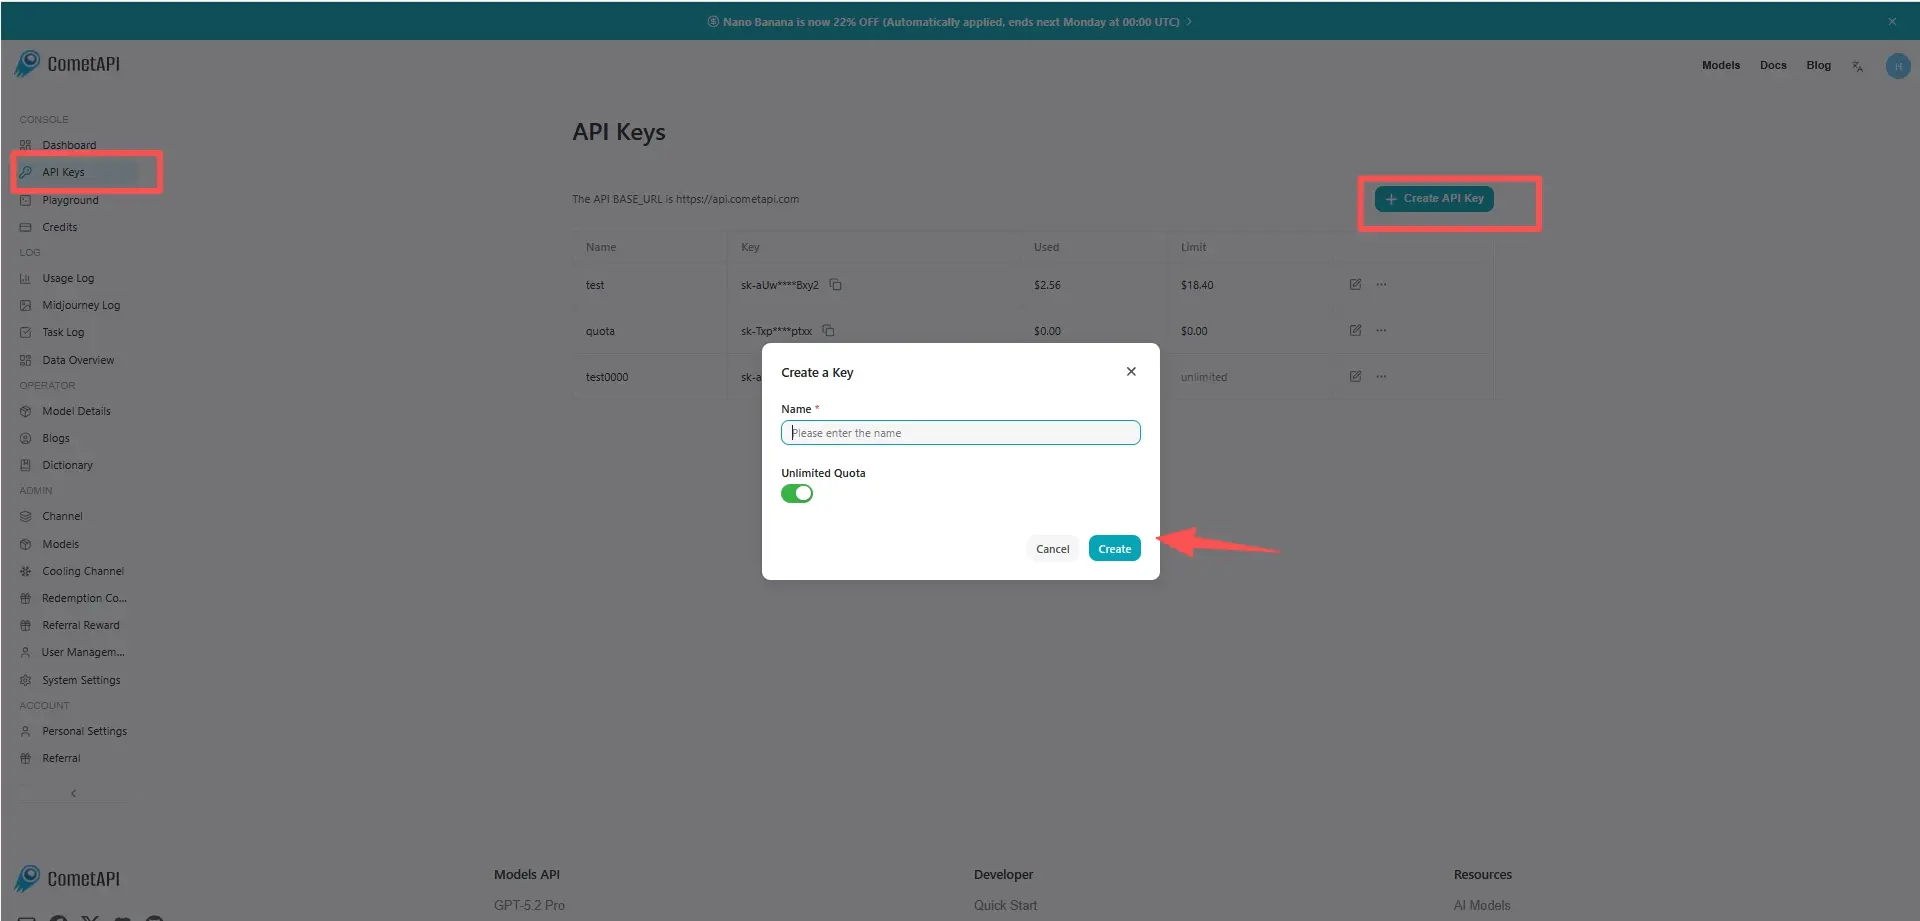
Melden Sie sich bei cometapi.com an. Wenn Sie noch kein Nutzer sind, registrieren Sie sich bitte zuerst. Melden Sie sich in Ihrer CometAPI console an. Erhalten Sie den Zugangsberechtigungs-API-Schlüssel der Schnittstelle. Klicken Sie im persönlichen Zentrum beim API-Token auf „Add Token“, holen Sie den Token-Schlüssel: sk-xxxxx und senden Sie ihn ab.
Schritt 2: Anfragen an die GLM-5 Turbo API senden
Wählen Sie den „glm-5-turbo“-Endpunkt, um die API-Anfrage zu senden, und legen Sie den Request-Body fest. Die Anfragemethode und der Request-Body werden aus der API-Dokumentation unserer Website entnommen. Unsere Website bietet Ihnen auch einen Apifox-Test zur Verfügung. Ersetzen Sie <YOUR_API_KEY> durch Ihren tatsächlichen CometAPI-Schlüssel aus Ihrem Konto. Basis-URL ist Chat Completions
Fügen Sie Ihre Frage oder Anfrage in das Feld content ein—darauf wird das Modell antworten. Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten.
Schritt 3: Ergebnisse abrufen und verifizieren
Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten. Nach der Verarbeitung antwortet die API mit dem Aufgabenstatus und den Ausgabedaten.