Specifiche tecniche di GPT-5.4 Mini
| Voce | GPT-5.4 Mini (stima basata su fonti ufficiali + convalida incrociata) |
|---|---|
| Famiglia di modelli | Serie GPT-5.4 (variante “mini” efficiente in termini di costi) |
| Fornitore | OpenAI |
| Tipi di input | Testo, Immagine |
| Tipi di output | Testo |
| Finestra di contesto | 400,000 token |
| Token massimi in output | 128,000 token |
| Limite di conoscenze | ~31 maggio 2024 (eredita la linea mini) |
| Supporto al ragionamento | Sì (leggero rispetto al GPT-5.4 completo) |
| Supporto agli strumenti | Chiamate di funzione, ricerca sul web, ricerca file, agenti (dedotto dalla famiglia GPT-5) |
| Posizionamento | Modello vicino alla frontiera ad alta velocità ed efficiente in termini di costi |
Che cos'è GPT-5.4 Mini?
GPT-5.4 Mini è una variante di GPT-5.4 ad alta velocità ed efficiente in termini di costi, progettata per carichi di lavoro sensibili alla latenza e ad alto volume. Porta una parte significativa delle capacità di ragionamento, programmazione e multimodali di GPT-5.4 in un modello più piccolo e veloce, ottimizzato per sistemi su scala di produzione.
Rispetto ai precedenti modelli “mini”, GPT-5.4 Mini è posizionato come un piccolo modello vicino alla frontiera, il che significa che si avvicina alle prestazioni di livello di punta riducendo drasticamente costi e tempi di risposta.
Caratteristiche principali di GPT-5.4 Mini
- Inferenza ad alta velocità: ottimizzato per applicazioni a bassa latenza come chatbot, copiloti e sistemi in tempo reale
- Ampia finestra di contesto (400K): supporta documenti lunghi, flussi di lavoro multi-step e memoria degli agenti
- Solido supporto alla programmazione e agli agenti: progettato per l'uso di strumenti, il ragionamento a più passaggi e attività delegate a sotto-agenti
- Input multimodale: accetta input sia di testo sia di immagini per flussi di lavoro più ricchi
- Scalabilità efficiente in termini di costi: significativamente più economico di GPT-5.4 pur mantenendo una solida capacità di ragionamento
- Ottimizzazione delle pipeline di agenti: ideale per architetture multi-modello in cui i modelli grandi pianificano e i modelli mini eseguono
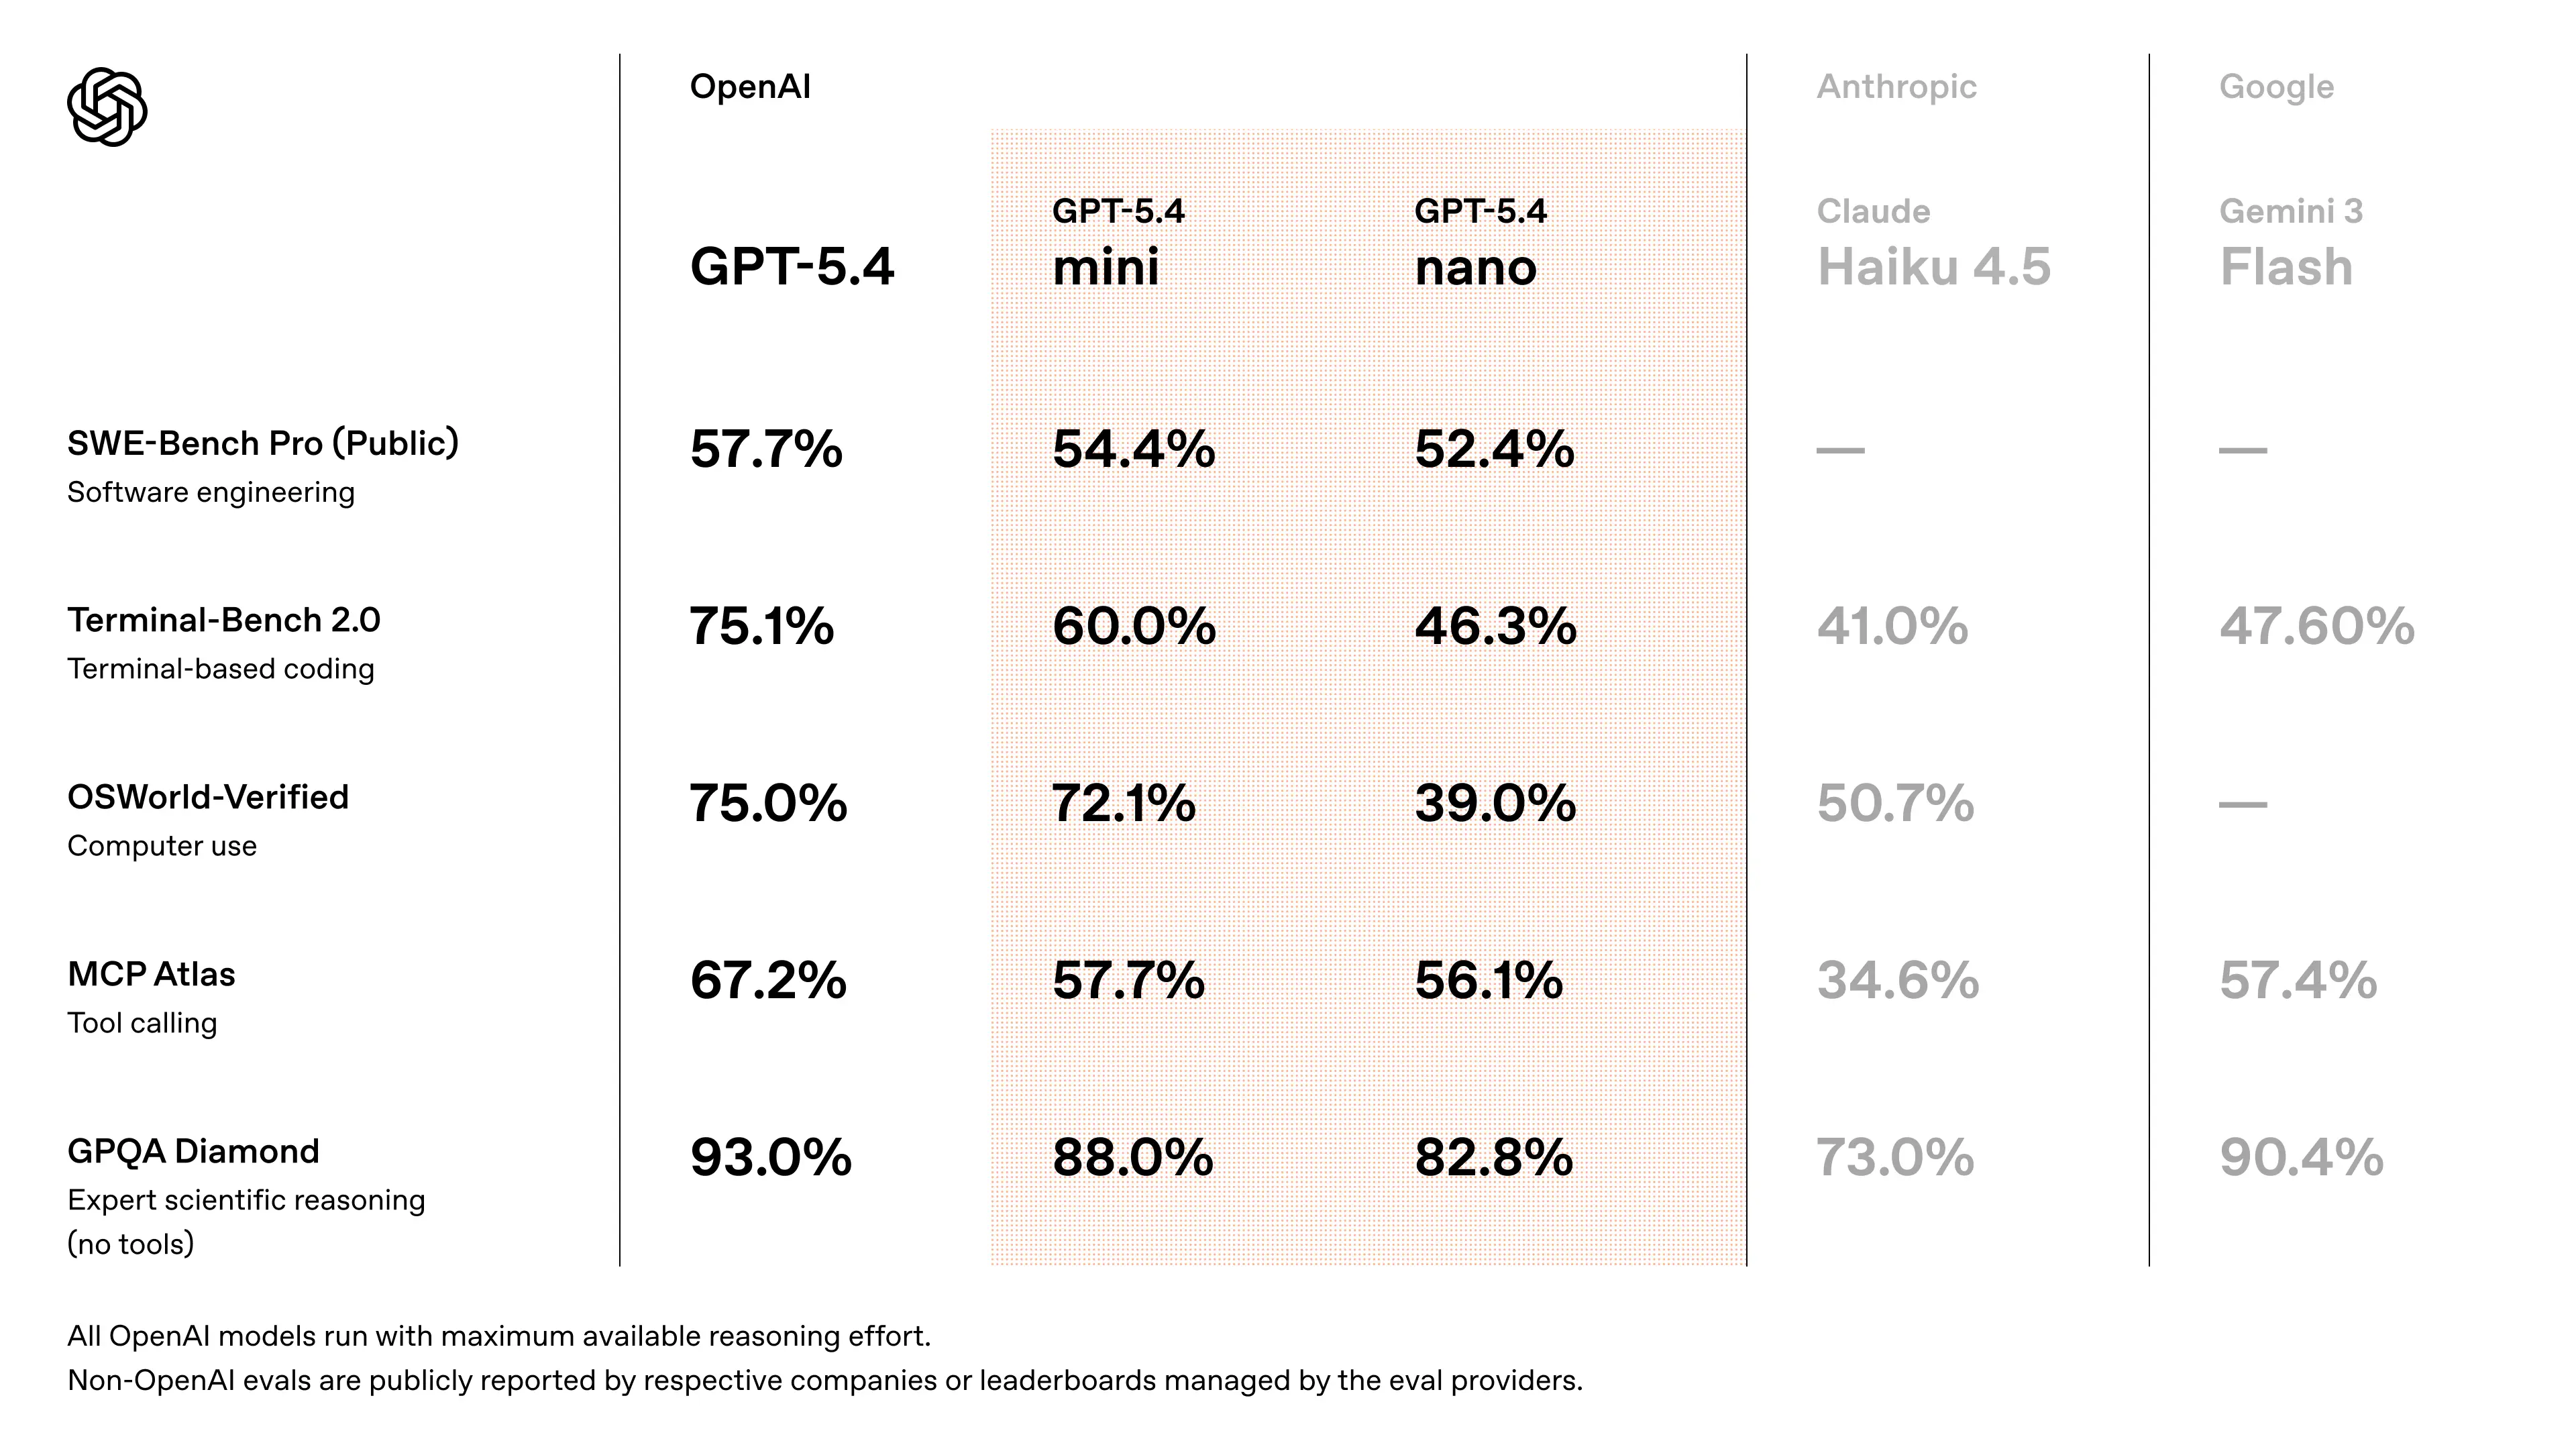
Prestazioni nei benchmark di GPT-5.4 Mini
- Si avvicina alle prestazioni di GPT-5.4 su attività di coding in stile SWE-Bench (~94–95% delle prestazioni del modello di punta) (stima con convalida incrociata dalle discussioni sul rilascio)
- Miglioramenti significativi rispetto a GPT-5 Mini in:
- accuratezza del ragionamento
- affidabilità nell'uso degli strumenti
- comprensione multimodale
- Progettato per superare le precedenti generazioni “mini” nei flussi di lavoro basati su agenti e nei benchmark di programmazione
- misurazioni di velocità: i primi tester dell'API riportano ~180–190 token/sec su GPT-5.4 Mini (vs ~55–120 t/s per le varianti GPT-5 mini più vecchie a seconda delle modalità di priorità).
👉 Punto chiave: GPT-5.4 Mini offre prestazioni vicine alla frontiera a una frazione di costo e latenza, rendendolo ideale per sistemi scalabili.
Casi d'uso rappresentativi
- Assistenti di programmazione ed editor (plugin IDE, Copilot): il rapido parsing del contesto, l'esplorazione del codebase e i completamenti rapidi rendono GPT-5.4 Mini ideale per suggerimenti in-editor dove il tempo al primo token è fondamentale. GitHub Copilot è una delle prime integrazioni.
- Sotto-agenti / worker delegati: quando un agente principale delega task brevi e veloci (formattazione, piccoli passaggi di ragionamento, ricerche in stile grep) a un worker economico e veloce. OpenAI posiziona mini/nano per questi ruoli.
- Automazione API ad alto volume: generazione di codice in batch, triage automatico dei ticket, sintesi dei log su larga scala dove costo per chiamata e latenza sono vincoli primari. I numeri di throughput della community indicano vantaggi operativi significativi per i modelli mini.
- Wrapping di strumenti e toolchain: chiamate rapide agli strumenti in cui il modello orchestra chiamate a strumenti esterni (ricerca, grep, esecuzione test) e restituisce output compatti e azionabili. La famiglia GPT-5.4 include capacità migliorate di “computer use”.
Come accedere all'API di GPT-5.4 Mini
Passaggio 1: Registrati per ottenere una chiave API
Accedi a cometapi.com. Se non sei ancora nostro utente, registrati prima. Accedi alla console CometAPI. Ottieni la chiave API di accesso all'interfaccia. Fai clic su “Add Token” nella sezione dei token API del centro personale, ottieni la chiave del token: sk-xxxxx e invia.

Passaggio 2: Invia richieste all'API GPT-5.4 Mini
Seleziona l'endpoint “gpt-5.4-mini” per inviare la richiesta API e imposta il body della richiesta. Il metodo e il body della richiesta sono disponibili nella documentazione API del nostro sito. Il nostro sito fornisce anche test Apifox per comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva del tuo account. L'URL di base è Chat Completions e Responses.
Inserisci la tua domanda o richiesta nel campo content—è a questo che il modello risponderà. Elabora la risposta dell'API per ottenere la risposta generata.
Passaggio 3: Recupera e verifica i risultati
Elabora la risposta dell'API per ottenere la risposta generata. Dopo l'elaborazione, l'API restituisce lo stato dell'attività e i dati di output.