Specifiche tecniche di GLM-5-Turbo
| Voce | GLM-5-Turbo (stimato / rilascio anticipato) |
|---|---|
| Famiglia di modelli | GLM-5 (variante Turbo – ottimizzata per bassa latenza) |
| Fornitore | Zhipu AI (Z.ai) |
| Architettura | Mixture-of-Experts (MoE) con attenzione sparsa |
| Tipi di input | Testo |
| Tipi di output | Testo |
| Finestra di contesto | ~200,000 tokens |
| Token massimi in output | Fino a ~128,000 (prime segnalazioni) |
| Focus principale | Flussi di lavoro per agenti, uso di strumenti, inferenza rapida |
| Stato di rilascio | Sperimentale / parzialmente a sorgente chiuso |
Che cos'è GLM-5-Turbo
GLM-5-Turbo è una variante ottimizzata per la latenza della famiglia di modelli GLM-5, progettata specificamente per flussi di lavoro di agenti di livello produttivo e applicazioni in tempo reale. Si basa sull'architettura MoE su larga scala di GLM-5 (~745B parametri) e sposta l'attenzione su velocità, reattività e affidabilità dell'orchestrazione degli strumenti piuttosto che sulla massima profondità di ragionamento.
A differenza del GLM-5 base (che mira a benchmark di frontiera per ragionamento e coding), la versione Turbo è ottimizzata per sistemi interattivi, pipeline di automazione ed esecuzione di strumenti multi-step.
Caratteristiche principali di GLM-5-Turbo
- Inferenza a bassa latenza: Ottimizzata per tempi di risposta più rapidi rispetto al GLM-5 standard, rendendola adatta alle applicazioni in tempo reale.
- Addestramento orientato agli agenti: Progettata attorno all'uso di strumenti e a flussi di lavoro multi-step fin dalla fase di addestramento, non solo con il fine-tuning post-addestramento.
- Ampia finestra di contesto (200K): Gestisce documenti lunghi, codebase e catene di ragionamento multi-step in una singola sessione.
- Elevata affidabilità nelle chiamate agli strumenti: Esecuzione delle funzioni e concatenazione dei flussi migliorate per i sistemi agentici.
- Architettura MoE efficiente: Attiva solo un sottoinsieme di parametri per token, bilanciando costi e prestazioni.
- Design orientato alla produzione: Privilegia stabilità e throughput rispetto ai punteggi massimi nei benchmark.
Benchmark e informazioni sulle prestazioni
Sebbene i benchmark specifici di GLM-5-Turbo non siano completamente divulgati, eredita caratteristiche prestazionali da GLM-5:
- ~77,8% su SWE-bench Verified (baseline GLM-5)
- Prestazioni solide nel coding agentico e nei compiti di lungo orizzonte
- Competitivo con modelli come Claude Opus e sistemi della classe GPT nel ragionamento e nel coding
👉 Turbo sacrifica parte della precisione di picco in cambio di un'inferenza più rapida e di una migliore usabilità in tempo reale.
GLM-5-Turbo vs modelli comparabili
| Modello | Punti di forza | Punti deboli | Caso d'uso ideale |
|---|---|---|---|
| GLM-5-Turbo | Veloce, incentrato sugli agenti, lungo contesto | Minore capacità di ragionamento al picco rispetto ai modelli di punta | Agenti in tempo reale, automazione |
| GLM-5 (base) | Forte capacità di ragionamento, benchmark elevati | Inferenza più lenta | Ricerca, coding complesso |
| Modelli classe GPT-5 | Ragionamento di livello top, multimodale | Costo più elevato, chiusi | AI di livello enterprise |
| Claude Opus (latest) | Ragionamento affidabile, sicurezza | Più lento nei cicli degli agenti | Ragionamento esteso |
Casi d'uso migliori
- Agenti AI e pipeline di automazione (flussi di lavoro multi-step)
- Sistemi di chat in tempo reale che richiedono bassa latenza
- Applicazioni integrate con strumenti (API, retrieval, chiamate di funzione)
- Copiloti per sviluppatori con cicli di feedback rapidi
- Applicazioni a lungo contesto come l'analisi di documenti
Come accedere all'API GLM-5 Turbo
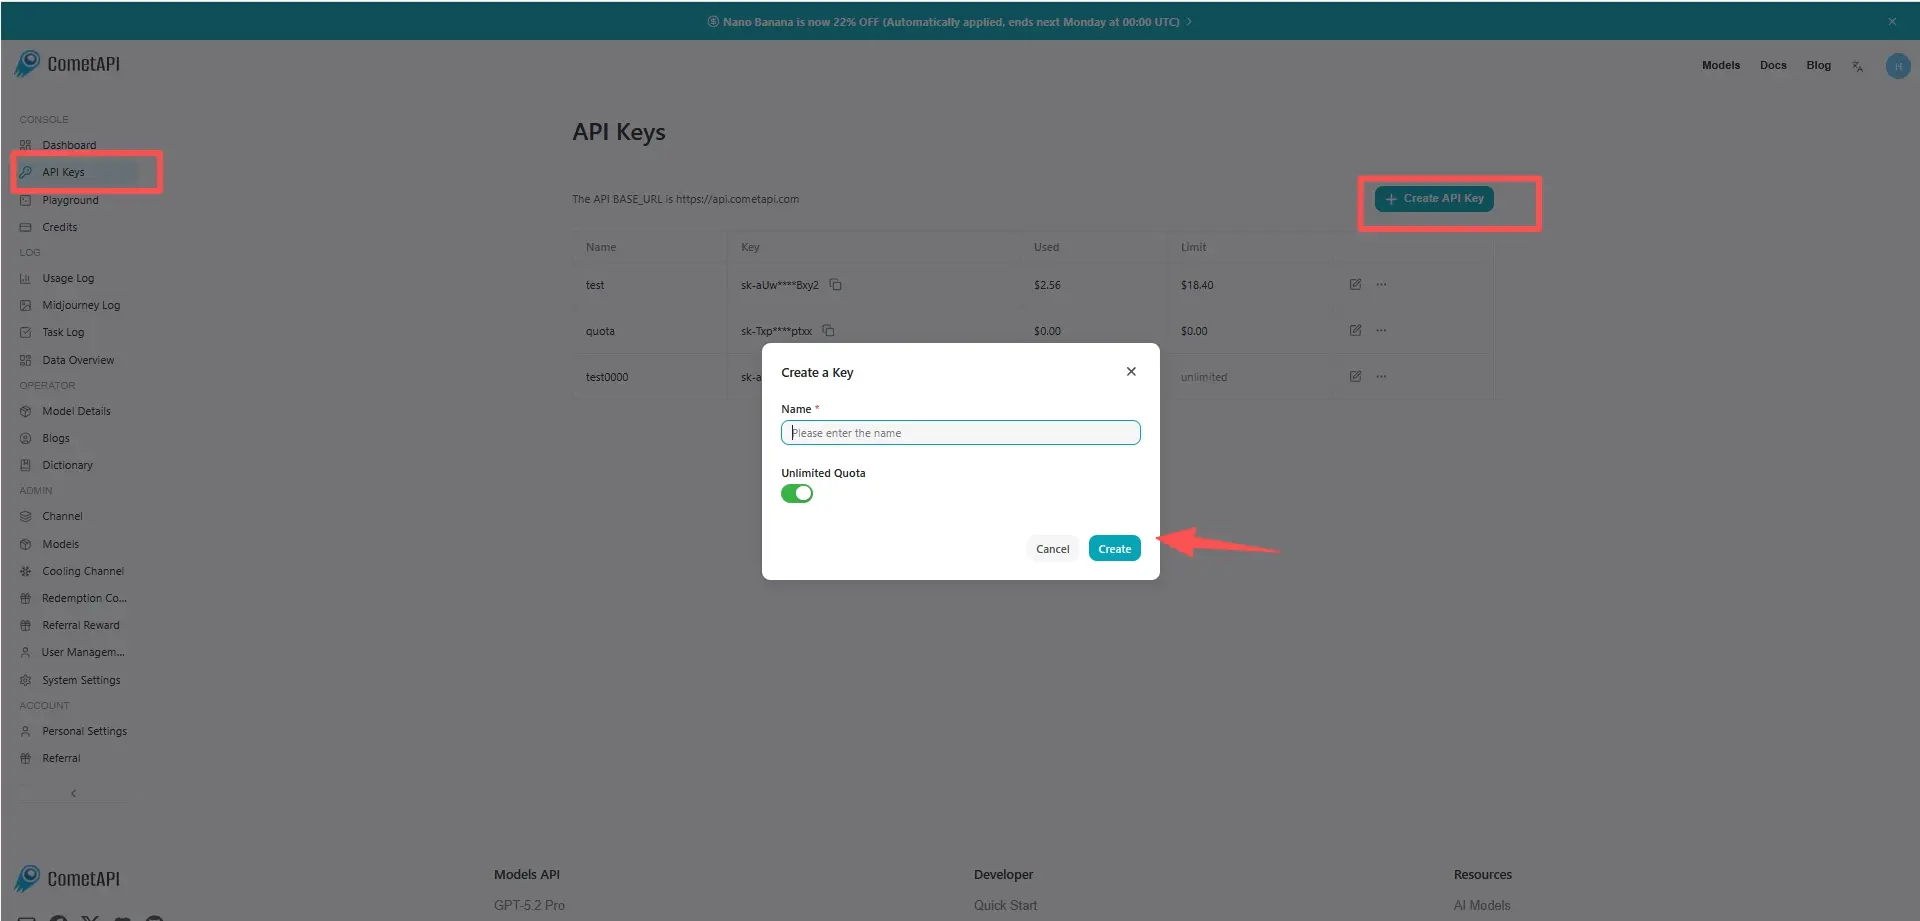
Passaggio 1: Registrati per ottenere la chiave API
Accedi a cometapi.com. Se non sei ancora nostro utente, registrati prima. Accedi alla tua CometAPI console. Ottieni la chiave API delle credenziali di accesso dell'interfaccia. Fai clic su “Add Token” nella sezione API token del centro personale, ottieni la chiave del token: sk-xxxxx e invia.
Passaggio 2: Invia richieste all'API GLM-5 Turbo
Seleziona l'endpoint “glm-5-turbo” per inviare la richiesta API e imposta il body della richiesta. Il metodo e il body della richiesta sono ottenuti dalla documentazione API del nostro sito. Il nostro sito fornisce anche test Apifox per la tua comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva del tuo account. l'URL base è Chat Completions
Inserisci la tua domanda o richiesta nel campo content — a cui il modello risponderà. Elabora la risposta dell'API per ottenere la risposta generata.
Passaggio 3: Recupera e verifica i risultati
Elabora la risposta dell'API per ottenere la risposta generata. Dopo l'elaborazione, l'API risponde con lo stato dell'attività e i dati di output.