Specyfikacje techniczne GLM-5-Turbo
| Pozycja | GLM-5-Turbo (szacunkowe / wczesne wydanie) |
|---|---|
| Rodzina modeli | GLM-5 (wariant Turbo — zoptymalizowany pod niskie opóźnienia) |
| Dostawca | Zhipu AI (Z.ai) |
| Architektura | Mixture-of-Experts (MoE) z rzadką atencją |
| Typy wejścia | Tekst |
| Typy wyjścia | Tekst |
| Okno kontekstu | ~200,000 tokenów |
| Maksymalna liczba tokenów wyjściowych | Do ~128,000 (wczesne doniesienia) |
| Główny cel | Przepływy pracy agentów, użycie narzędzi, szybka inferencja |
| Status wydania | Eksperymentalny / częściowo zamknięty kod źródłowy |
Czym jest GLM-5-Turbo
GLM-5-Turbo to wariant zoptymalizowany pod opóźnienia w rodzinie modeli GLM-5, zaprojektowany specjalnie do przemysłowych przepływów pracy agentów i aplikacji czasu rzeczywistego. Opiera się na wielkoskalowej architekturze MoE GLM-5 (~745B parametrów) i przesuwa nacisk na szybkość, responsywność oraz niezawodność orkiestracji narzędzi, zamiast na maksymalną głębokość rozumowania.
W odróżnieniu od bazowego GLM-5 (który celuje w czołowy poziom rozumowania i benchmarki programistyczne), wersja Turbo jest dostrojona do systemów interaktywnych, potoków automatyzacji i wieloetapowego wykonywania narzędzi.
Kluczowe funkcje GLM-5-Turbo
- Inferencja o niskich opóźnieniach: Zoptymalizowana pod szybsze czasy odpowiedzi w porównaniu ze standardowym GLM-5, co czyni ją odpowiednią dla aplikacji czasu rzeczywistego.
- Trening ukierunkowany na agentów: Projektowany wokół użycia narzędzi i wieloetapowych przepływów pracy już na etapie treningu, nie tylko poprzez strojenie po treningu.
- Duże okno kontekstu (200K): Obsługuje długie dokumenty, zbiory kodu i wieloetapowe łańcuchy rozumowania w jednej sesji.
- Wysoka niezawodność wywoływania narzędzi: Ulepszone wykonywanie funkcji i łańcuchowanie przepływów dla systemów agentowych.
- Wydajna architektura MoE: Aktywuje tylko podzbiór parametrów na token, równoważąc koszt i wydajność.
- Projekt nastawiony na produkcję: Przedkłada stabilność i przepustowość nad maksymalne wyniki benchmarków.
Benchmarki i informacje o wydajności
Choć benchmarki specyficzne dla GLM-5-Turbo nie są w pełni ujawnione, model dziedziczy charakterystyki wydajności z GLM-5:
- ~77.8% na SWE-bench Verified (bazowy GLM-5)
- Silna wydajność w kodowaniu agentowym i zadaniach o długim horyzoncie
- Konkurencyjny wobec modeli takich jak Claude Opus oraz systemów klasy GPT w rozumowaniu i programowaniu
👉 Turbo poświęca część szczytowej dokładności na rzecz szybszej inferencji i lepszej użyteczności w czasie rzeczywistym.
GLM-5-Turbo w porównaniu z podobnymi modelami
| Model | Mocne strony | Słabe strony | Najlepsze zastosowanie |
|---|---|---|---|
| GLM-5-Turbo | Szybki, ukierunkowany na agentów, długi kontekst | Mniejsza szczytowa zdolność rozumowania vs. flagowy | Agenci czasu rzeczywistego, automatyzacja |
| GLM-5 (base) | Silne rozumowanie, wysokie wyniki benchmarków | Wolniejsza inferencja | Badania, złożone programowanie |
| GPT-5-class models | Najwyższej klasy rozumowanie, multimodalność | Wyższy koszt, zamknięty | AI klasy korporacyjnej |
| Claude Opus (latest) | Niezawodne rozumowanie, bezpieczeństwo | Wolniejszy w pętlach agenta | Długie formy rozumowania |
Najlepsze przypadki użycia
- Agenci AI i potoki automatyzacji (wieloetapowe przepływy pracy)
- Systemy czatu w czasie rzeczywistym wymagające niskich opóźnień
- Aplikacje z integracją narzędzi (API, wyszukiwanie, wywołania funkcji)
- Kopiloci deweloperscy z szybkimi pętlami informacji zwrotnej
- Aplikacje z długim kontekstem jak analiza dokumentów
Jak uzyskać dostęp do API GLM-5 Turbo
Krok 1: Zarejestruj się po klucz API
Zaloguj się na cometapi.com. Jeśli nie jesteś jeszcze naszym użytkownikiem, zarejestruj się najpierw. Zaloguj się do konsoli CometAPI. Uzyskaj poświadczenie dostępu — klucz API do interfejsu. Kliknij „Add Token” przy tokenie API w centrum osobistym, uzyskaj klucz tokena: sk-xxxxx i zatwierdź.
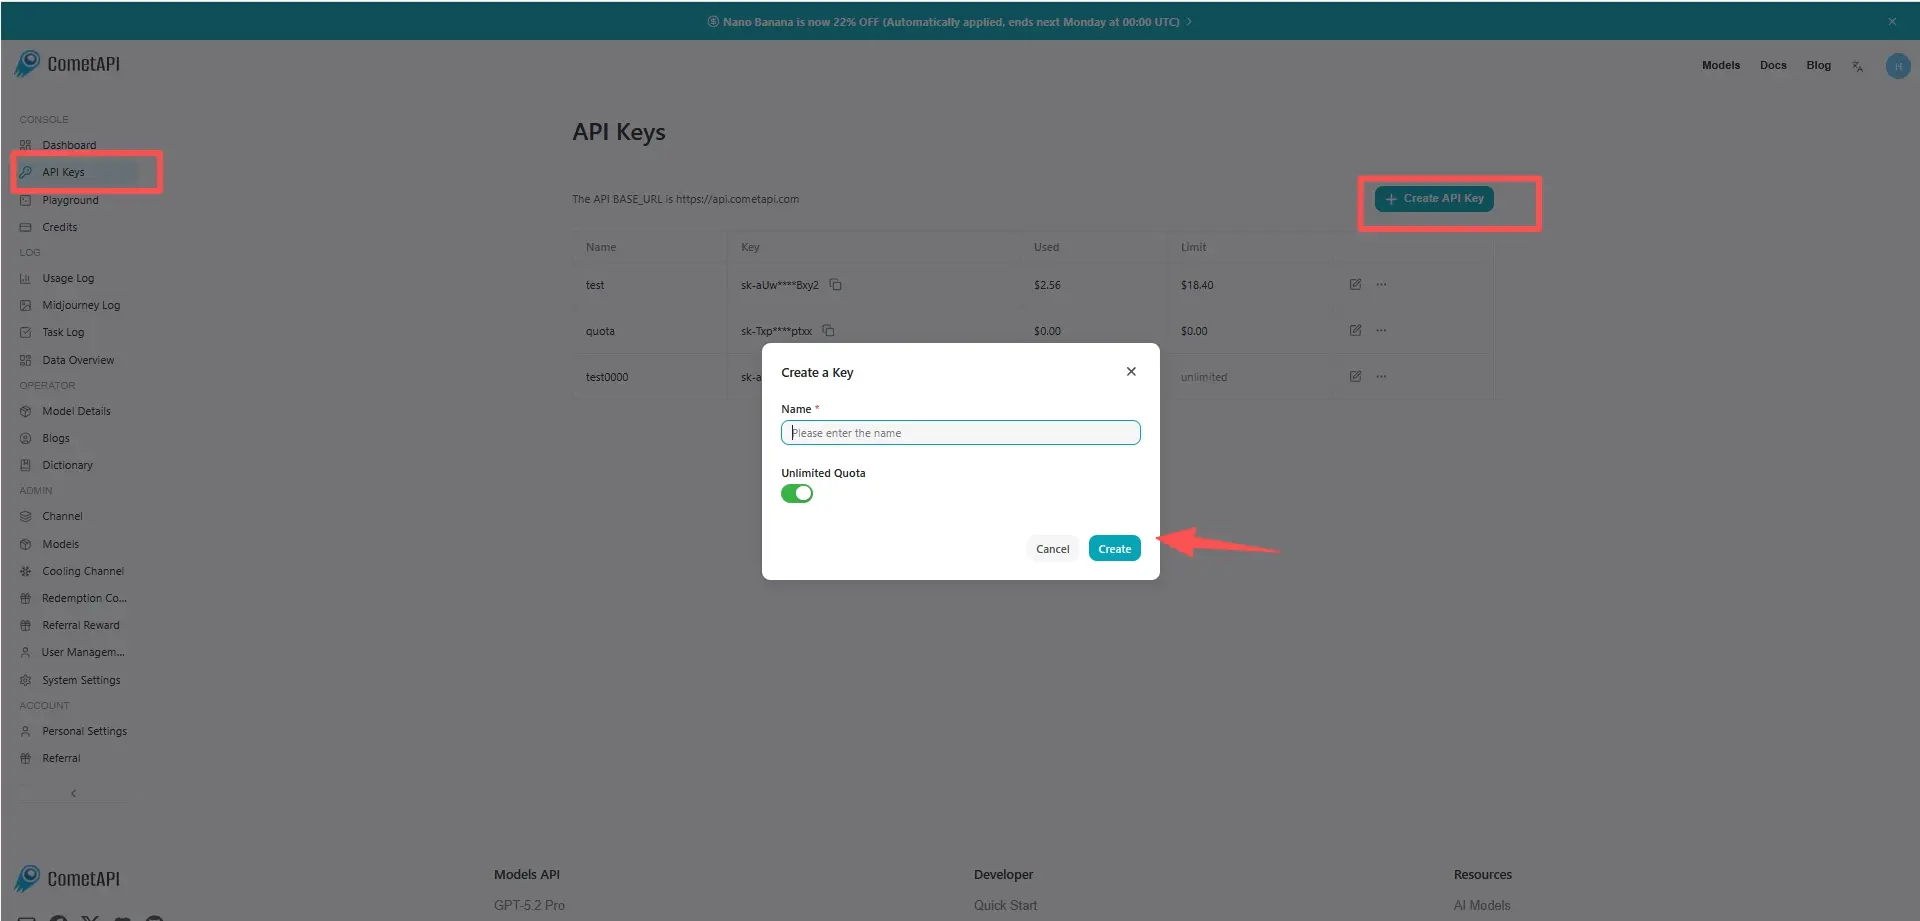
Krok 2: Wyślij żądania do API GLM-5 Turbo
Wybierz punkt końcowy “glm-5-turbo”, aby wysłać żądanie API i ustaw treść żądania. Metodę żądania i treść żądania można uzyskać z dokumentacji API na naszej stronie. Nasza strona oferuje również testy w Apifox dla Twojej wygody. Zastąp <YOUR_API_KEY> swoim rzeczywistym kluczem CometAPI z konta. Adres bazowy to Chat Completions
Wstaw swoje pytanie lub żądanie w pole content — na to model odpowie. Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Pobierz i zweryfikuj wyniki
Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Po przetworzeniu API zwraca status zadania i dane wyjściowe.