Especificações Técnicas do GLM-5-Turbo
| Item | GLM-5-Turbo (estimado / lançamento inicial) |
|---|---|
| Família do modelo | GLM-5 (variante Turbo – otimizada para baixa latência) |
| Provedor | Zhipu AI (Z.ai) |
| Arquitetura | Mistura de Especialistas (MoE) com atenção esparsa |
| Tipos de entrada | Texto |
| Tipos de saída | Texto |
| Janela de contexto | ~200,000 tokens |
| Máximo de tokens de saída | Até ~128,000 (relatos iniciais) |
| Foco principal | Fluxos de trabalho de agentes, uso de ferramentas, inferência rápida |
| Status de lançamento | Experimental / parcialmente de código fechado |
O que é o GLM-5-Turbo
O GLM-5-Turbo é uma variante do modelo GLM-5 otimizada para latência, projetada especificamente para fluxos de trabalho de agentes em nível de produção e aplicações em tempo real. Ele se baseia na arquitetura MoE de grande escala do GLM-5 (~745B parâmetros) e desloca o foco para velocidade, capacidade de resposta e confiabilidade na orquestração de ferramentas, em vez da profundidade máxima de raciocínio.
Ao contrário do GLM-5 base (que mira benchmarks de raciocínio e codificação de nível de ponta), a versão Turbo é ajustada para sistemas interativos, pipelines de automação e execução multietapas de ferramentas.
Principais Recursos do GLM-5-Turbo
- Inferência de baixa latência: Otimizado para tempos de resposta mais rápidos em comparação com o GLM-5 padrão, tornando-o adequado para aplicações em tempo real.
- Treinamento centrado em agentes: Projetado em torno do uso de ferramentas e fluxos de trabalho multietapas desde a fase de treinamento, não apenas em ajustes pós-treinamento.
- Janela de contexto ampla (200K): Lida com documentos longos, bases de código e cadeias de raciocínio multietapas em uma única sessão.
- Alta confiabilidade em chamadas de ferramentas: Melhor execução de funções e encadeamento de fluxos de trabalho para sistemas de agentes.
- Arquitetura MoE eficiente: Ativa apenas um subconjunto de parâmetros por token, equilibrando custo e desempenho.
- Design orientado à produção: Prioriza estabilidade e throughput em vez de pontuações máximas em benchmarks.
Benchmark e insights de desempenho
Embora os benchmarks específicos do GLM-5-Turbo não tenham sido totalmente divulgados, ele herda características de desempenho do GLM-5:
- ~77.8% no SWE-bench Verified (GLM-5 linha de base)
- Forte desempenho em codificação orientada a agentes e tarefas de horizonte longo
- Competitivo com modelos como Claude Opus e sistemas da classe GPT em raciocínio e codificação
👉 O Turbo troca parte da precisão de pico por inferência mais rápida e melhor usabilidade em tempo real.
GLM-5-Turbo vs. modelos comparáveis
| Modelo | Ponto forte | Ponto fraco | Melhor caso de uso |
|---|---|---|---|
| GLM-5-Turbo | Rápido, focado em agentes, contexto longo | Menos raciocínio de pico em relação ao principal | Agentes em tempo real, automação |
| GLM-5 (base) | Forte raciocínio, benchmarks altos | Inferência mais lenta | Pesquisa, codificação complexa |
| Modelos da classe GPT-5 | Raciocínio de alto nível, multimodal | Custo mais alto, fechado | IA de nível empresarial |
| Claude Opus (mais recente) | Raciocínio confiável, segurança | Mais lento em loops de agentes | Raciocínio de longo formato |
Melhores casos de uso
- Agentes de IA e pipelines de automação (fluxos de trabalho multietapas)
- Sistemas de chat em tempo real que exigem baixa latência
- Aplicações integradas a ferramentas (APIs, recuperação, chamadas de função)
- Copilotos de desenvolvedor com ciclos de feedback rápidos
- Aplicações de contexto longo como análise de documentos
Como acessar a API do GLM-5 Turbo
Etapa 1: Inscreva-se para obter a chave de API
Faça login em cometapi.com. Se você ainda não é nosso usuário, registre-se primeiro. Entre no seu console do CometAPI. Obtenha a chave de API de credencial de acesso da interface. Clique em “Add Token” no token de API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
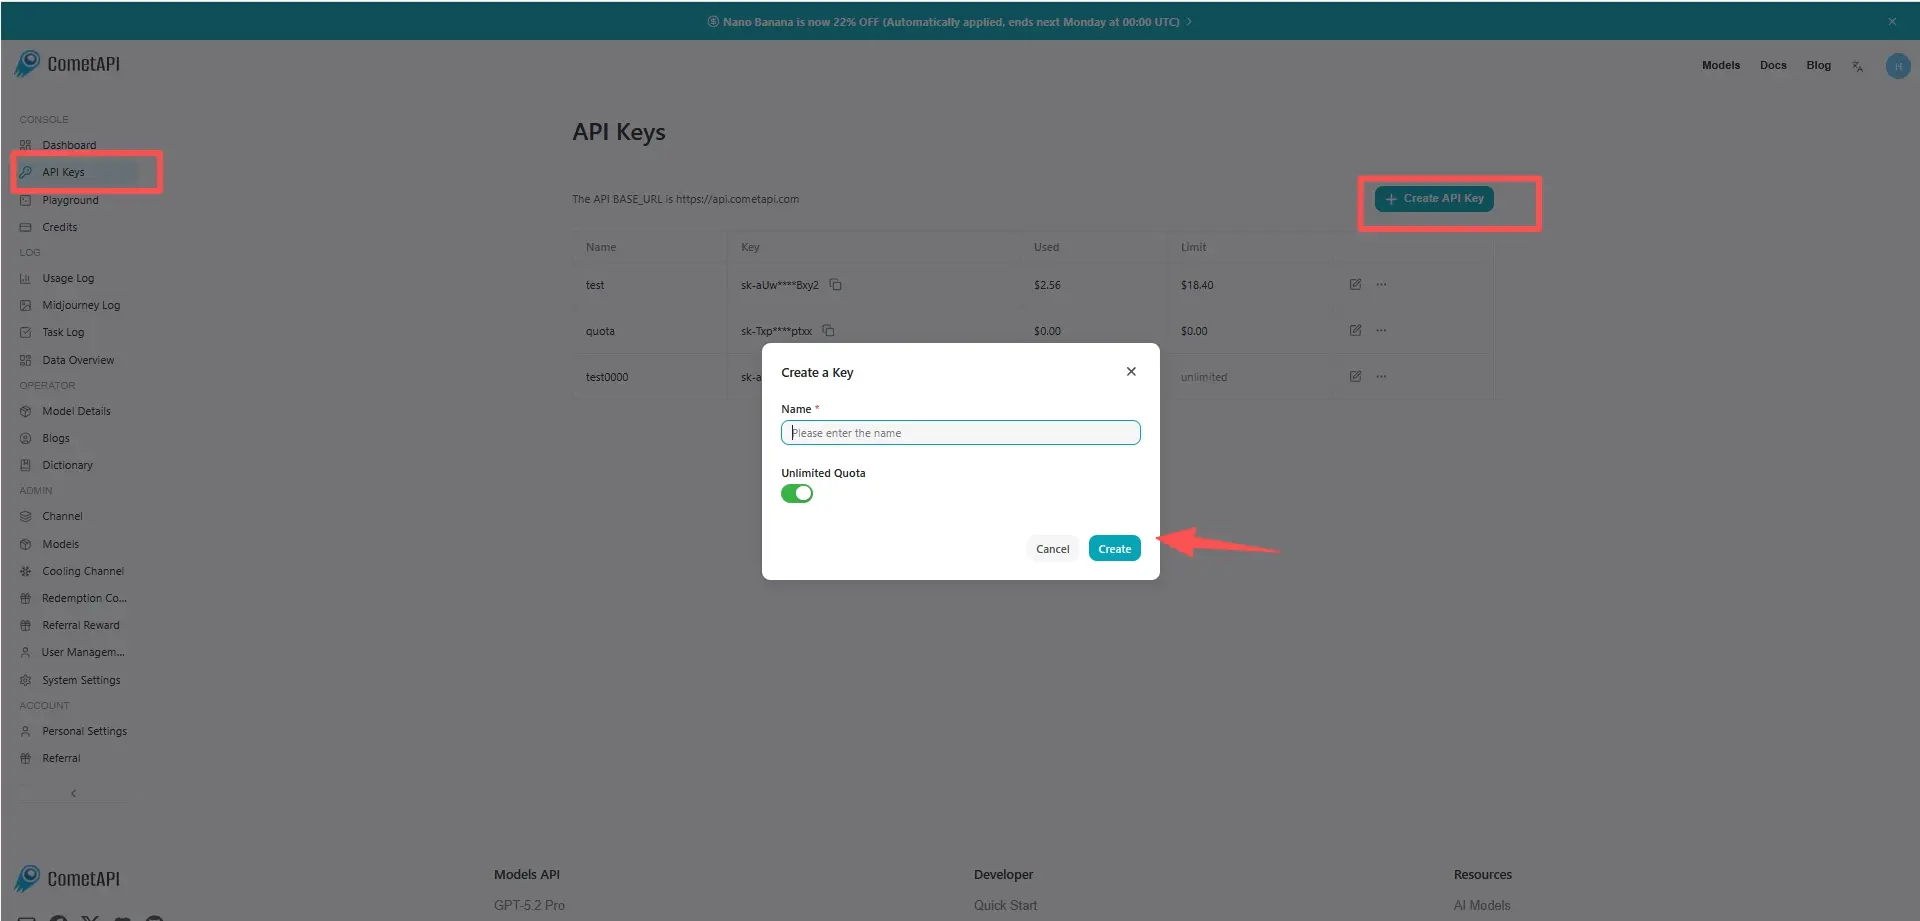
Etapa 2: Envie solicitações para a API do GLM-5 Turbo
Selecione o endpoint “glm-5-turbo” para enviar a solicitação de API e defina o corpo da solicitação. O método e o corpo da solicitação são obtidos na documentação de API do nosso site. Nosso site também fornece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave CometAPI real da sua conta. A URL base é Chat Completions
Insira sua pergunta ou solicitação no campo content — é a isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Recupere e verifique os resultados
Processe a resposta da API para obter a resposta gerada. Após o processamento, a API responde com o status da tarefa e os dados de saída.