สเปกทางเทคนิคของ GPT-5.4 Mini
| รายการ | GPT-5.4 Mini (ประมาณการจากข้อมูลทางการ + ตรวจสอบไขว้) |
|---|---|
| ตระกูลโมเดล | ซีรีส์ GPT-5.4 (รุ่น “mini” ที่คุ้มค่า) |
| ผู้ให้บริการ | OpenAI |
| ประเภทอินพุต | ข้อความ, รูปภาพ |
| ประเภทเอาต์พุต | ข้อความ |
| หน้าต่างบริบท | 400,000 โทเค็น |
| จำนวนโทเค็นเอาต์พุตสูงสุด | 128,000 โทเค็น |
| ขอบเขตความรู้ | ~31 พฤษภาคม 2024 (สืบทอดสายตระกูล mini) |
| รองรับการให้เหตุผล | ใช่ (น้ำหนักเบาเมื่อเทียบกับ GPT-5.4 ฉบับเต็ม) |
| รองรับเครื่องมือ | การเรียกใช้ฟังก์ชัน, การค้นหาเว็บ, การค้นหาไฟล์, เอเจนต์ (อนุมานจากตระกูล GPT-5) |
| การวางตำแหน่ง | โมเดลใกล้แนวหน้าที่มีความเร็วสูงและคุ้มค่า |
GPT-5.4 Mini คืออะไร?
GPT-5.4 Mini คือรุ่นที่มีความคุ้มค่าและความเร็วสูงของ GPT-5.4 ออกแบบมาสำหรับเวิร์กโหลดที่ต้องการความหน่วงต่ำและปริมาณงานสูง นำความสามารถด้านการให้เหตุผล การเขียนโค้ด และมัลติโหมดของ GPT-5.4 ส่วนใหญ่ มาสู่โมเดลที่เล็กและเร็วกว่า ซึ่งปรับแต่งเพื่อระบบระดับโปรดักชัน
เมื่อเทียบกับรุ่น “mini” ก่อนหน้า GPT-5.4 Mini ถูกวางตำแหน่งให้เป็นโมเดลขนาดเล็กที่ใกล้ระดับแนวหน้า หมายความว่าเข้าใกล้ประสิทธิภาพระดับเรือธง ในขณะที่ลดต้นทุนและเวลาในการตอบสนองลงอย่างมาก
คุณลักษณะเด่นของ GPT-5.4 Mini
- การอนุมานความเร็วสูง: ปรับแต่งสำหรับแอปฯ หน่วงต่ำ เช่น แชตบอต โคไพล็อต และระบบเรียลไทม์
- หน้าต่างบริบทขนาดใหญ่ (400K): รองรับเอกสารยาว เวิร์กโฟลว์หลายขั้นตอน และหน่วยความจำของเอเจนต์
- ความสามารถด้านโค้ดดิ้งและเอเจนต์ที่แข็งแกร่ง: ออกแบบมาสำหรับการใช้เครื่องมือ การให้เหตุผลหลายขั้นตอน และงานย่อยแบบเอเจนต์
- อินพุตมัลติโหมด: รองรับทั้งข้อความและรูปภาพเพื่อเวิร์กโฟลว์ที่หลากหลายยิ่งขึ้น
- ปรับขนาดได้คุ้มต้นทุน: ถูกกว่ามากเมื่อเทียบกับ GPT-5.4 แต่ยังคงความสามารถในการให้เหตุผลที่แข็งแกร่ง
- การปรับแต่งไปป์ไลน์ของเอเจนต์: เหมาะสำหรับสถาปัตยกรรมหลายโมเดลที่โมเดลขนาดใหญ่ใช้วางแผนและโมเดลขนาดเล็กทำงาน
ประสิทธิภาพตามชุดทดสอบมาตรฐานของ GPT-5.4 Mini
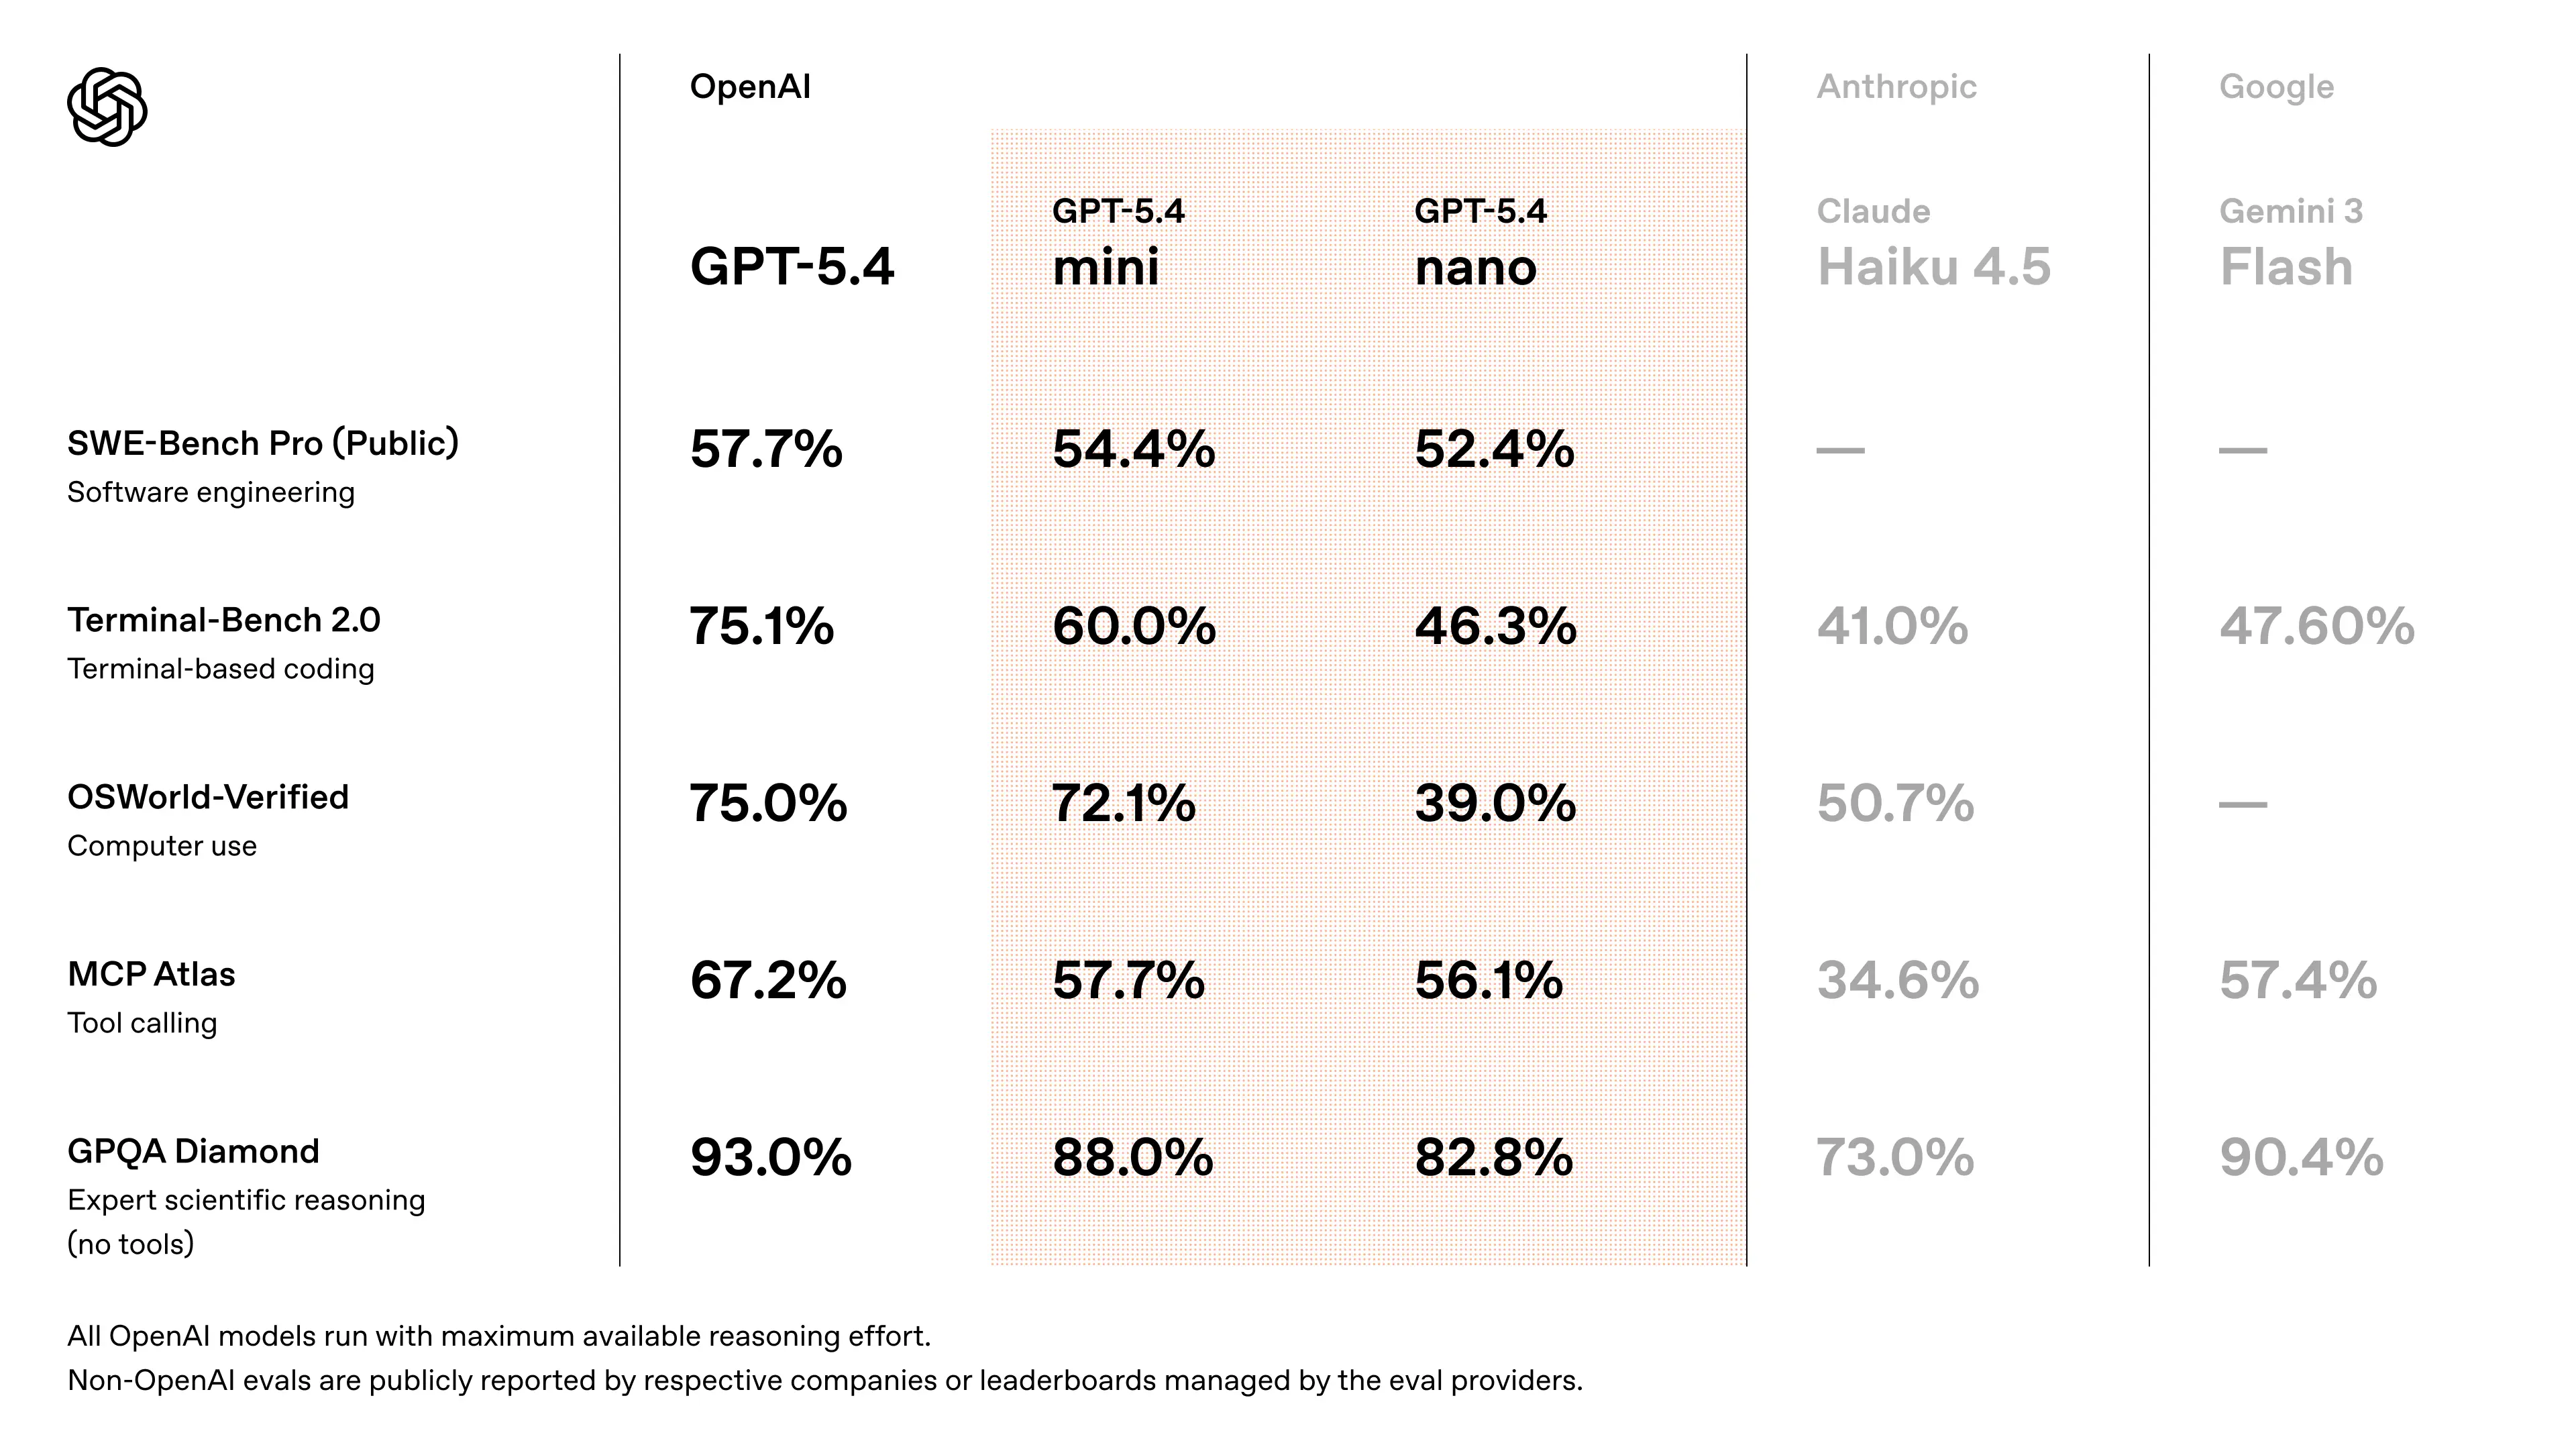
- เข้าใกล้ประสิทธิภาพของ GPT-5.4 ในงานโค้ดดิ้งลักษณะ SWE-Bench (~94–95% ของประสิทธิภาพรุ่นเรือธง) (ประมาณการจากการสนทนาช่วงเปิดตัวที่ตรวจสอบไขว้)
- มีการปรับปรุงอย่างมีนัยสำคัญเหนือ GPT-5 Mini ในด้าน:
- ความแม่นยำในการให้เหตุผล
- ความเชื่อถือได้ในการใช้เครื่องมือ
- ความเข้าใจแบบมัลติโหมด
- ออกแบบมาให้เหนือกว่ารุ่น “mini” ก่อนหน้าในเวิร์กโฟลว์ของเอเจนต์และชุดทดสอบด้านโค้ดดิ้ง
- การวัดความเร็ว: ผู้ทดสอบ API ระยะแรก รายงาน ~180–190 tokens/sec บน GPT-5.4 Mini (เทียบกับ ~55–120 t/s สำหรับรุ่น GPT-5 mini เก่าขึ้นอยู่กับโหมดลำดับความสำคัญ)
👉 สรุปสำคัญ: GPT-5.4 Mini มอบประสิทธิภาพใกล้ระดับแนวหน้าด้วยต้นทุนและความหน่วงที่ต่ำ เหมาะอย่างยิ่งสำหรับระบบที่ต้องการสเกล
กรณีการใช้งานตัวอย่าง
- ผู้ช่วยโค้ดดิ้งและเอดิเตอร์ (ปลั๊กอิน IDE, Copilot): การพาร์สบริบทอย่างรวดเร็ว การสำรวจโค้ดเบส และการเติมให้สมบูรณ์อย่างรวดเร็ว ทำให้ GPT-5.4 Mini เหมาะกับคำแนะนำในเอดิเตอร์ที่เวลาเริ่มส่งโทเค็นตัวแรกเป็นเรื่องสำคัญ GitHub Copilot เป็นการผสานใช้งานระยะแรก
- ซับเอเจนต์/คนงานที่รับมอบหมาย: กรณีที่เอเจนต์หลักมอบหมายงานสั้นและเร็ว (จัดรูปแบบ ขั้นตอนการให้เหตุผลขนาดเล็ก การค้นหาแบบ grep) ให้กับคนงานที่ราคาถูกและรวดเร็ว OpenAI วางตำแหน่ง mini/nano สำหรับบทบาทเหล่านี้
- ระบบอัตโนมัติของ API ปริมาณสูง: การสร้างโค้ดจำนวนมาก การคัดแยกทิกเก็ตอัตโนมัติ การสรุปล็อกในระดับสเกล ซึ่งต้นทุนต่อครั้งและความหน่วงเป็นข้อจำกัดหลัก ตัวเลขด้านปริมาณงานจากชุมชนบ่งชี้ถึงข้อได้เปรียบในการปฏิบัติการอย่างมีนัยสำคัญสำหรับรุ่น mini
- การห่อหุ้มเครื่องมือและสายโซ่เครื่องมือ: การเรียกเครื่องมือที่รวดเร็วซึ่งโมเดลทำหน้าที่จัดลำดับการเรียกไปยังเครื่องมือภายนอก (ค้นหา grep รันเทสต์) และส่งคืนผลลัพธ์ที่กะทัดรัดและนำไปใช้ได้ ตระกูล GPT-5.4 มีความสามารถด้าน “computer use” ที่ปรับปรุงแล้ว
วิธีเข้าถึง GPT-5.4 Mini API
ขั้นตอนที่ 1: สมัครเพื่อรับ API Key
เข้าสู่ระบบที่ cometapi.com หากคุณยังไม่เป็นผู้ใช้ของเรา โปรดลงทะเบียนก่อน ลงชื่อเข้าใช้ CometAPI console รับ API key สำหรับการเข้าถึงอินเทอร์เฟซ คลิก “Add Token” ที่ API token ในศูนย์ส่วนบุคคล รับ token key: sk-xxxxx แล้วส่ง

ขั้นตอนที่ 2: ส่งคำขอไปยัง GPT-5.4 Mini API
เลือกเอ็นด์พอยต์ “gpt-5.4-mini” เพื่อส่งคำขอ API และกำหนด request body วิธีการและ request body สามารถดูได้จากเอกสาร API บนเว็บไซต์ของเรา เว็บไซต์ของเรายังมีการทดสอบผ่าน Apifox เพื่อความสะดวกของคุณ แทนที่ <YOUR_API_KEY> ด้วย CometAPI key จริงจากบัญชีของคุณ base url คือ Chat Completions และ Responses
ใส่คำถามหรือคำขอของคุณลงในช่อง content—ซึ่งเป็นสิ่งที่โมเดลจะตอบสนอง ประมวลผลการตอบกลับจาก API เพื่อรับคำตอบที่สร้างขึ้น
ขั้นตอนที่ 3: ดึงและตรวจสอบผลลัพธ์
ประมวลผลการตอบกลับจาก API เพื่อรับคำตอบที่สร้างขึ้น หลังการประมวลผล API จะตอบกลับด้วยสถานะงานและข้อมูลเอาต์พุต