ข้อมูลจำเพาะทางเทคนิคของ GLM-5-Turbo
| รายการ | GLM-5-Turbo (โดยประมาณ / รุ่นเผยแพร่ช่วงต้น) |
|---|---|
| ตระกูลโมเดล | GLM-5 (รุ่น Turbo – ปรับแต่งเพื่อความหน่วงต่ำ) |
| ผู้ให้บริการ | Zhipu AI (Z.ai) |
| สถาปัตยกรรม | Mixture-of-Experts (MoE) พร้อม attention แบบ sparse |
| ประเภทอินพุต | ข้อความ |
| ประเภทเอาต์พุต | ข้อความ |
| หน้าต่างบริบท | ~200,000 โทเคน |
| โทเคนผลลัพธ์สูงสุด | สูงสุด ~128,000 (รายงานช่วงต้น) |
| จุดโฟกัสหลัก | เวิร์กโฟลว์แบบเอเจนต์ การใช้เครื่องมือ การอนุมานที่รวดเร็ว |
| สถานะการเผยแพร่ | เชิงทดลอง / ปิดซอร์สบางส่วน |
GLM-5-Turbo คืออะไร
GLM-5-Turbo เป็นรุ่นที่ปรับให้มีความหน่วงต่ำของตระกูลโมเดล GLM-5 ออกแบบมาโดยเฉพาะสำหรับ เวิร์กโฟลว์เอเจนต์ระดับผลิตจริงและแอปพลิเคชันเรียลไทม์ โดยอาศัยสถาปัตยกรรม MoE ขนาดใหญ่ของ GLM-5 (~745B พารามิเตอร์) และปรับจุดเน้นไปที่ ความเร็ว การตอบสนอง และความน่าเชื่อถือในการจัดการเครื่องมือ มากกว่าความลึกในการให้เหตุผลสูงสุด
ต่างจาก GLM-5 รุ่นฐาน (ที่มุ่งเป้าไปยังการให้เหตุผลระดับแนวหน้าและมาตรฐานการทดสอบด้านการเขียนโค้ด) รุ่น Turbo ถูกปรับจูนสำหรับ ระบบเชิงโต้ตอบ ไปป์ไลน์อัตโนมัติ และการเรียกใช้เครื่องมือแบบหลายขั้นตอน
คุณสมบัติเด่นของ GLM-5-Turbo
- การอนุมานความหน่วงต่ำ: ปรับแต่งเพื่อเวลาตอบสนองที่เร็วกว่าเมื่อเทียบกับ GLM-5 มาตรฐาน เหมาะสำหรับแอปพลิเคชันเรียลไทม์
- การฝึกแบบเน้นเอเจนต์เป็นหลัก: ออกแบบรอบการใช้เครื่องมือและเวิร์กโฟลว์หลายขั้นตั้งแต่ช่วงการฝึก ไม่ใช่แค่ปรับจูนภายหลัง
- หน้าต่างบริบทขนาดใหญ่ (200K): รองรับเอกสารยาว โค้ดเบส และโซ่เหตุผลหลายขั้นในเซสชันเดียว
- ความน่าเชื่อถือในการเรียกใช้เครื่องมือที่สูง: ปรับปรุงการเรียกฟังก์ชันและการเชื่อมโยงเวิร์กโฟลว์สำหรับระบบเอเจนต์
- สถาปัตยกรรม MoE ที่มีประสิทธิภาพ: เปิดใช้งานเฉพาะส่วนหนึ่งของพารามิเตอร์ต่อโทเคน เพื่อสมดุลต้นทุนและประสิทธิภาพ
- ออกแบบเพื่อการผลิตจริง: ให้ความสำคัญกับเสถียรภาพและปริมาณงานมากกว่าคะแนนมาตรฐานสูงสุด
ผลทดสอบมาตรฐานและข้อมูลเชิงประสิทธิภาพ
แม้ว่า ผลทดสอบเฉพาะของ GLM-5-Turbo ยังไม่เปิดเผยครบถ้วน แต่โมเดลนี้ได้รับลักษณะสมรรถนะจาก GLM-5:
- ~77.8% บน SWE-bench Verified (GLM-5 baseline)
- ผลงานแข็งแกร่งใน การเขียนโค้ดเชิงเอเจนต์และงานระยะยาว
- แข่งขันได้กับโมเดลอย่าง Claude Opus และระบบระดับ GPT-class ในด้านการให้เหตุผลและการเขียนโค้ด
👉 Turbo แลกความแม่นยำระดับสูงบางส่วนเพื่อ การอนุมานที่เร็วกว่าและความสามารถใช้งานแบบเรียลไทม์ที่ดีกว่า
GLM-5-Turbo เทียบกับโมเดลใกล้เคียง
| โมเดล | จุดแข็ง | จุดอ่อน | กรณีใช้งานที่เหมาะสมที่สุด |
|---|---|---|---|
| GLM-5-Turbo | เร็ว เน้นเอเจนต์ บริบทยาว | ความสามารถให้เหตุผลระดับสูงสุดน้อยกว่ารุ่นเรือธง | เอเจนต์เรียลไทม์ งานอัตโนมัติ |
| GLM-5 (base) | การให้เหตุผลแข็งแกร่ง คะแนนมาตรฐานสูง | อนุมานช้ากว่า | งานวิจัย การเขียนโค้ดซับซ้อน |
| GPT-5-class models | การให้เหตุผลระดับแนวหน้า มัลติโมดัล | ต้นทุนสูงกว่า ปิดซอร์ส | AI ระดับองค์กร |
| Claude Opus (latest) | การให้เหตุผลเชื่อถือได้ ความปลอดภัย | ช้ากว่าในลูปของเอเจนต์ | การให้เหตุผลแบบยาว |
กรณีใช้งานที่ดีที่สุด
- เอเจนต์ AI และไปป์ไลน์อัตโนมัติ (เวิร์กโฟลว์หลายขั้น)
- ระบบแชตแบบเรียลไทม์ ที่ต้องการความหน่วงต่ำ
- แอปพลิเคชันที่ผสานเครื่องมือ (API, การค้นคืน, การเรียกฟังก์ชัน)
- ผู้ช่วยนักพัฒนา ที่มีวงจรป้อนกลับรวดเร็ว
- แอปพลิเคชันบริบทยาว เช่น การวิเคราะห์เอกสาร
วิธีเข้าถึง GLM-5 Turbo API
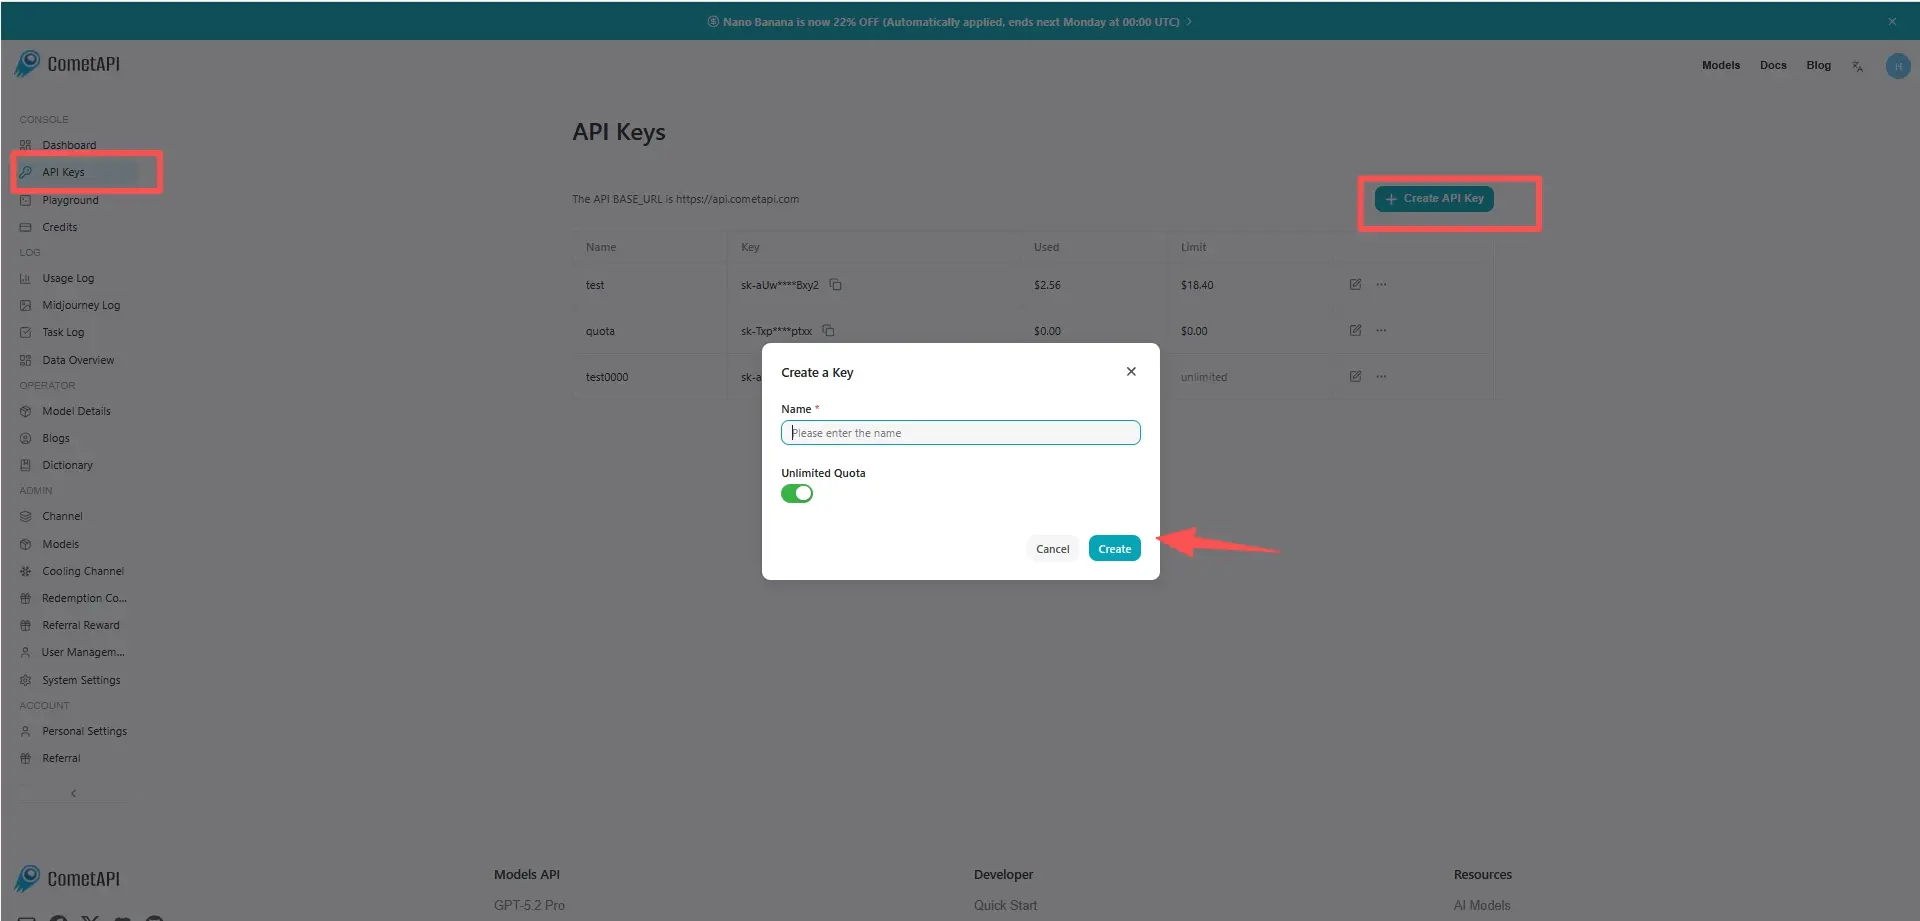
ขั้นตอนที่ 1: สมัครรับ API Key
เข้าสู่ระบบที่ cometapi.com หากคุณยังไม่ใช้งานของเรา โปรดลงทะเบียนก่อน ลงชื่อเข้าใช้ CometAPI console รับ API key สำหรับสิทธิ์เข้าถึงอินเทอร์เฟซ คลิก “Add Token” ที่ส่วน API token ในศูนย์ส่วนบุคคล รับ token key: sk-xxxxx แล้วส่ง
ขั้นตอนที่ 2: ส่งคำขอไปยัง GLM-5 Turbo API
เลือกปลายทาง “glm-5-turbo” เพื่อส่งคำขอ API และตั้งค่า request body วิธีการร้องขอและเนื้อหาคำขอสามารถดูได้จากเอกสาร API บนเว็บไซต์ของเรา เว็บไซต์ยังมีการทดสอบด้วย Apifox เพื่อความสะดวกของคุณ แทนที่ <YOUR_API_KEY> ด้วย CometAPI key จริงจากบัญชีของคุณ base url คือ Chat Completions
ใส่คำถามหรือคำขอของคุณลงในช่อง content—นี่คือสิ่งที่โมเดลจะตอบกลับ ประมวลผลการตอบกลับจาก API เพื่อรับคำตอบที่สร้างขึ้น
ขั้นตอนที่ 3: ดึงและตรวจสอบผลลัพธ์
ประมวลผลการตอบกลับจาก API เพื่อรับคำตอบที่สร้างขึ้น หลังจากประมวลผลแล้ว API จะส่งสถานะงานและข้อมูลผลลัพธ์กลับมา