GLM-5-Turbo 的技術規格
| 項目 | GLM-5-Turbo(估計/早期釋出) |
|---|---|
| 模型家族 | GLM-5(Turbo 變體—低延遲優化) |
| 提供方 | Zhipu AI (Z.ai) |
| 架構 | 專家混合(MoE)並配合稀疏注意力 |
| 輸入類型 | 文字 |
| 輸出類型 | 文字 |
| 上下文視窗 | ~200,000 tokens |
| 最大輸出 tokens | 最高可達 ~128,000(早期報告) |
| 核心重點 | 代理工作流程、工具使用、快速推理 |
| 發布狀態 | 實驗性/部分閉源 |
什麼是 GLM-5-Turbo
GLM-5-Turbo 是 GLM-5 模型家族中針對延遲優化的變體,專為「生產級代理工作流程與即時應用」而設計。它構建於 GLM-5 的大規模 MoE 架構(約 745B 參數)之上,重點由「追求最大推理深度」轉向「速度、響應性與工具編排的可靠性」。
不同於基礎版 GLM-5(以前沿級推理與程式設計基準為目標),Turbo 版本針對「互動式系統、自動化管線與多步驟工具執行」進行調校。
GLM-5-Turbo 的關鍵特性
- 低延遲推理:相較標準 GLM-5,回應更快,適合即時應用。
- 以代理為先的訓練:從訓練階段即圍繞工具使用與多步驟工作流程,而非僅靠訓練後微調。
- 超大上下文視窗(200K):可在單一會話中處理長文檔、程式碼庫與多步推理鏈。
- 強健的工具呼叫可靠性:改進函式執行與工作流程串接,面向代理系統。
- 高效 MoE 架構:每個 token 僅啟用部分參數,兼顧成本與效能。
- 面向生產的設計:優先穩定性與吞吐量,而非追求最高基準分數。
基準與效能洞察
雖然尚未完整披露 GLM-5-Turbo 的專屬基準,但其承襲 GLM-5 的效能特性:
- 在 SWE-bench Verified 上約為 77.8%(GLM-5 基線)
- 在代理式程式設計與長期任務上表現強勁
- 在推理與程式設計方面,與 Claude Opus 與 GPT 級系統具競爭力
👉 Turbo 以部分峰值準確率為代價,換取更快的推理與更佳的即時可用性。
GLM-5-Turbo 與同級模型對比
| 模型 | 優勢 | 劣勢 | 最佳使用場景 |
|---|---|---|---|
| GLM-5-Turbo | 快速、聚焦代理、長上下文 | 相較旗艦,峰值推理較弱 | 即時代理、自動化 |
| GLM-5(基礎) | 強推理、高基準 | 推理速度較慢 | 研究、複雜程式開發 |
| GPT-5-class models | 頂級推理、多模態 | 成本更高、閉源 | 企業級 AI |
| Claude Opus(最新) | 穩定推理與安全性 | 在代理迴圈中較慢 | 長篇推理 |
最佳使用案例
- AI 代理與自動化管線(多步驟工作流程)
- 需要低延遲的即時聊天系統
- 工具整合型應用(API、檢索、函式呼叫)
- 追求快速回饋的開發者輔助工具
- 長上下文應用,如文件分析
如何存取 GLM-5 Turbo API
步驟 1:註冊以取得 API 金鑰
登入 cometapi.com。若您尚未成為我們的用戶,請先註冊。登入您的 CometAPI 控制台。取得介面存取憑證 API 金鑰。在個人中心的 API token 處點選「Add Token」,取得 token 金鑰:sk-xxxxx 並提交。
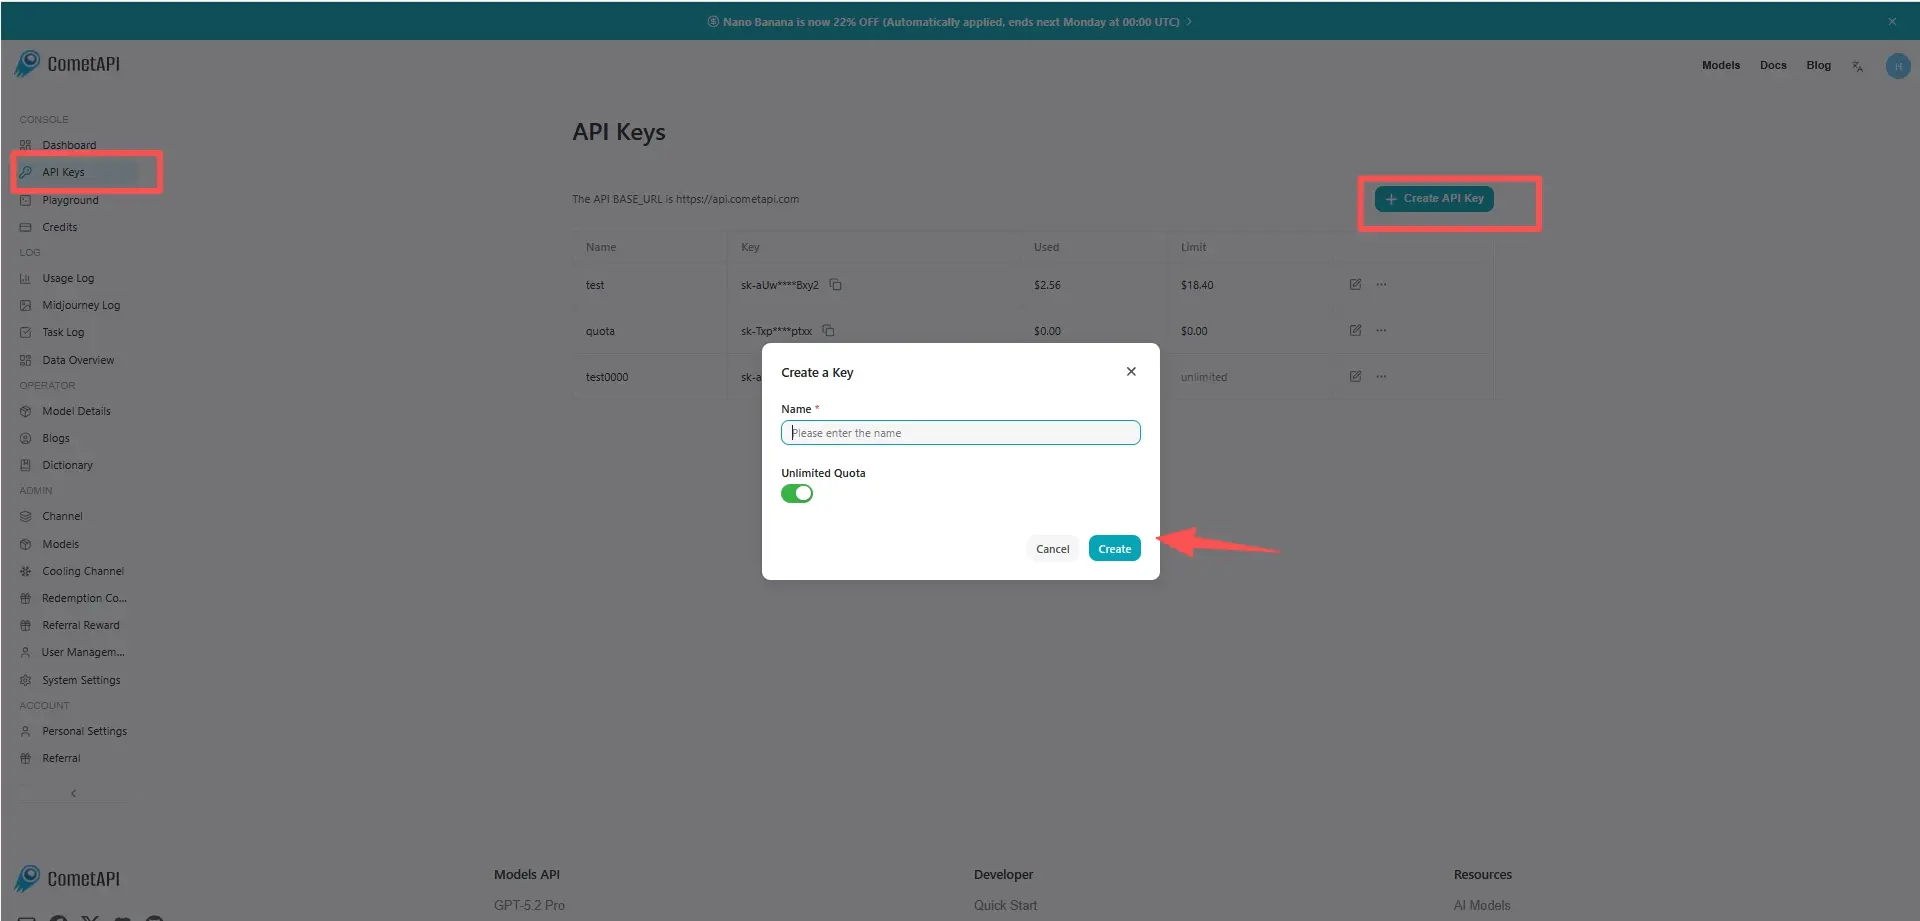
步驟 2:向 GLM-5 Turbo API 發送請求
選擇 “glm-5-turbo” 端點發送 API 請求並設定請求主體。請求方法與請求主體可於我們的網站 API 文件取得。我們的網站也提供 Apifox 測試以便您使用。將 <YOUR_API_KEY> 替換為您帳戶中的實際 CometAPI 金鑰。基礎 URL 為 Chat Completions
將您的問題或請求插入 content 欄位——模型將對此做出回應。處理 API 回應以獲得生成的答案。
步驟 3:擷取並驗證結果
處理 API 回應以取得生成的答案。處理完成後,API 會回傳任務狀態與輸出資料。