Especificaciones técnicas de GPT-5.4 Mini
| Elemento | GPT-5.4 Mini (estimado a partir de información oficial + validación cruzada) |
|---|---|
| Familia del modelo | Serie GPT-5.4 (variante “mini” eficiente en costos) |
| Proveedor | OpenAI |
| Tipos de entrada | Texto, Imagen |
| Tipos de salida | Texto |
| Ventana de contexto | 400,000 tokens |
| Tokens máximos de salida | 128,000 tokens |
| Límite de conocimiento | ~31 de mayo de 2024 (hereda el linaje mini) |
| Compatibilidad con razonamiento | Sí (ligero frente al GPT-5.4 completo) |
| Compatibilidad con herramientas | Llamadas a funciones, búsqueda web, búsqueda de archivos, agentes (inferido de la familia GPT-5) |
| Posicionamiento | Modelo de alta velocidad y eficiente en costos, cercano a la frontera |
¿Qué es GPT-5.4 Mini?
GPT-5.4 Mini es una variante de GPT-5.4 de alta velocidad y eficiente en costos, diseñada para cargas de trabajo sensibles a la latencia y de alto volumen. Aporta una parte significativa de las capacidades de razonamiento, programación y multimodales de GPT-5.4 a un modelo más pequeño y rápido, optimizado para sistemas a escala de producción.
En comparación con los modelos “mini” anteriores, GPT-5.4 Mini se posiciona como un modelo pequeño cercano a la frontera, lo que significa que se acerca al rendimiento de un modelo insignia mientras reduce drásticamente el costo y el tiempo de respuesta.
Características clave de GPT-5.4 Mini
- Inferencia de alta velocidad: optimizado para aplicaciones de baja latencia como chatbots, copilotos y sistemas en tiempo real
- Ventana de contexto grande (400K): admite documentos largos, flujos de trabajo de múltiples pasos y memoria de agentes
- Sólida compatibilidad con programación y agentes: diseñado para el uso de herramientas, el razonamiento de múltiples pasos y tareas delegadas a subagentes
- Entrada multimodal: acepta entradas de texto e imagen para flujos de trabajo más ricos
- Escalado eficiente en costos: significativamente más barato que GPT-5.4 manteniendo una fuerte capacidad de razonamiento
- Optimización de la canalización de agentes: ideal para arquitecturas multimodelo donde los modelos grandes planifican y los mini ejecutan
Rendimiento en pruebas de referencia de GPT-5.4 Mini
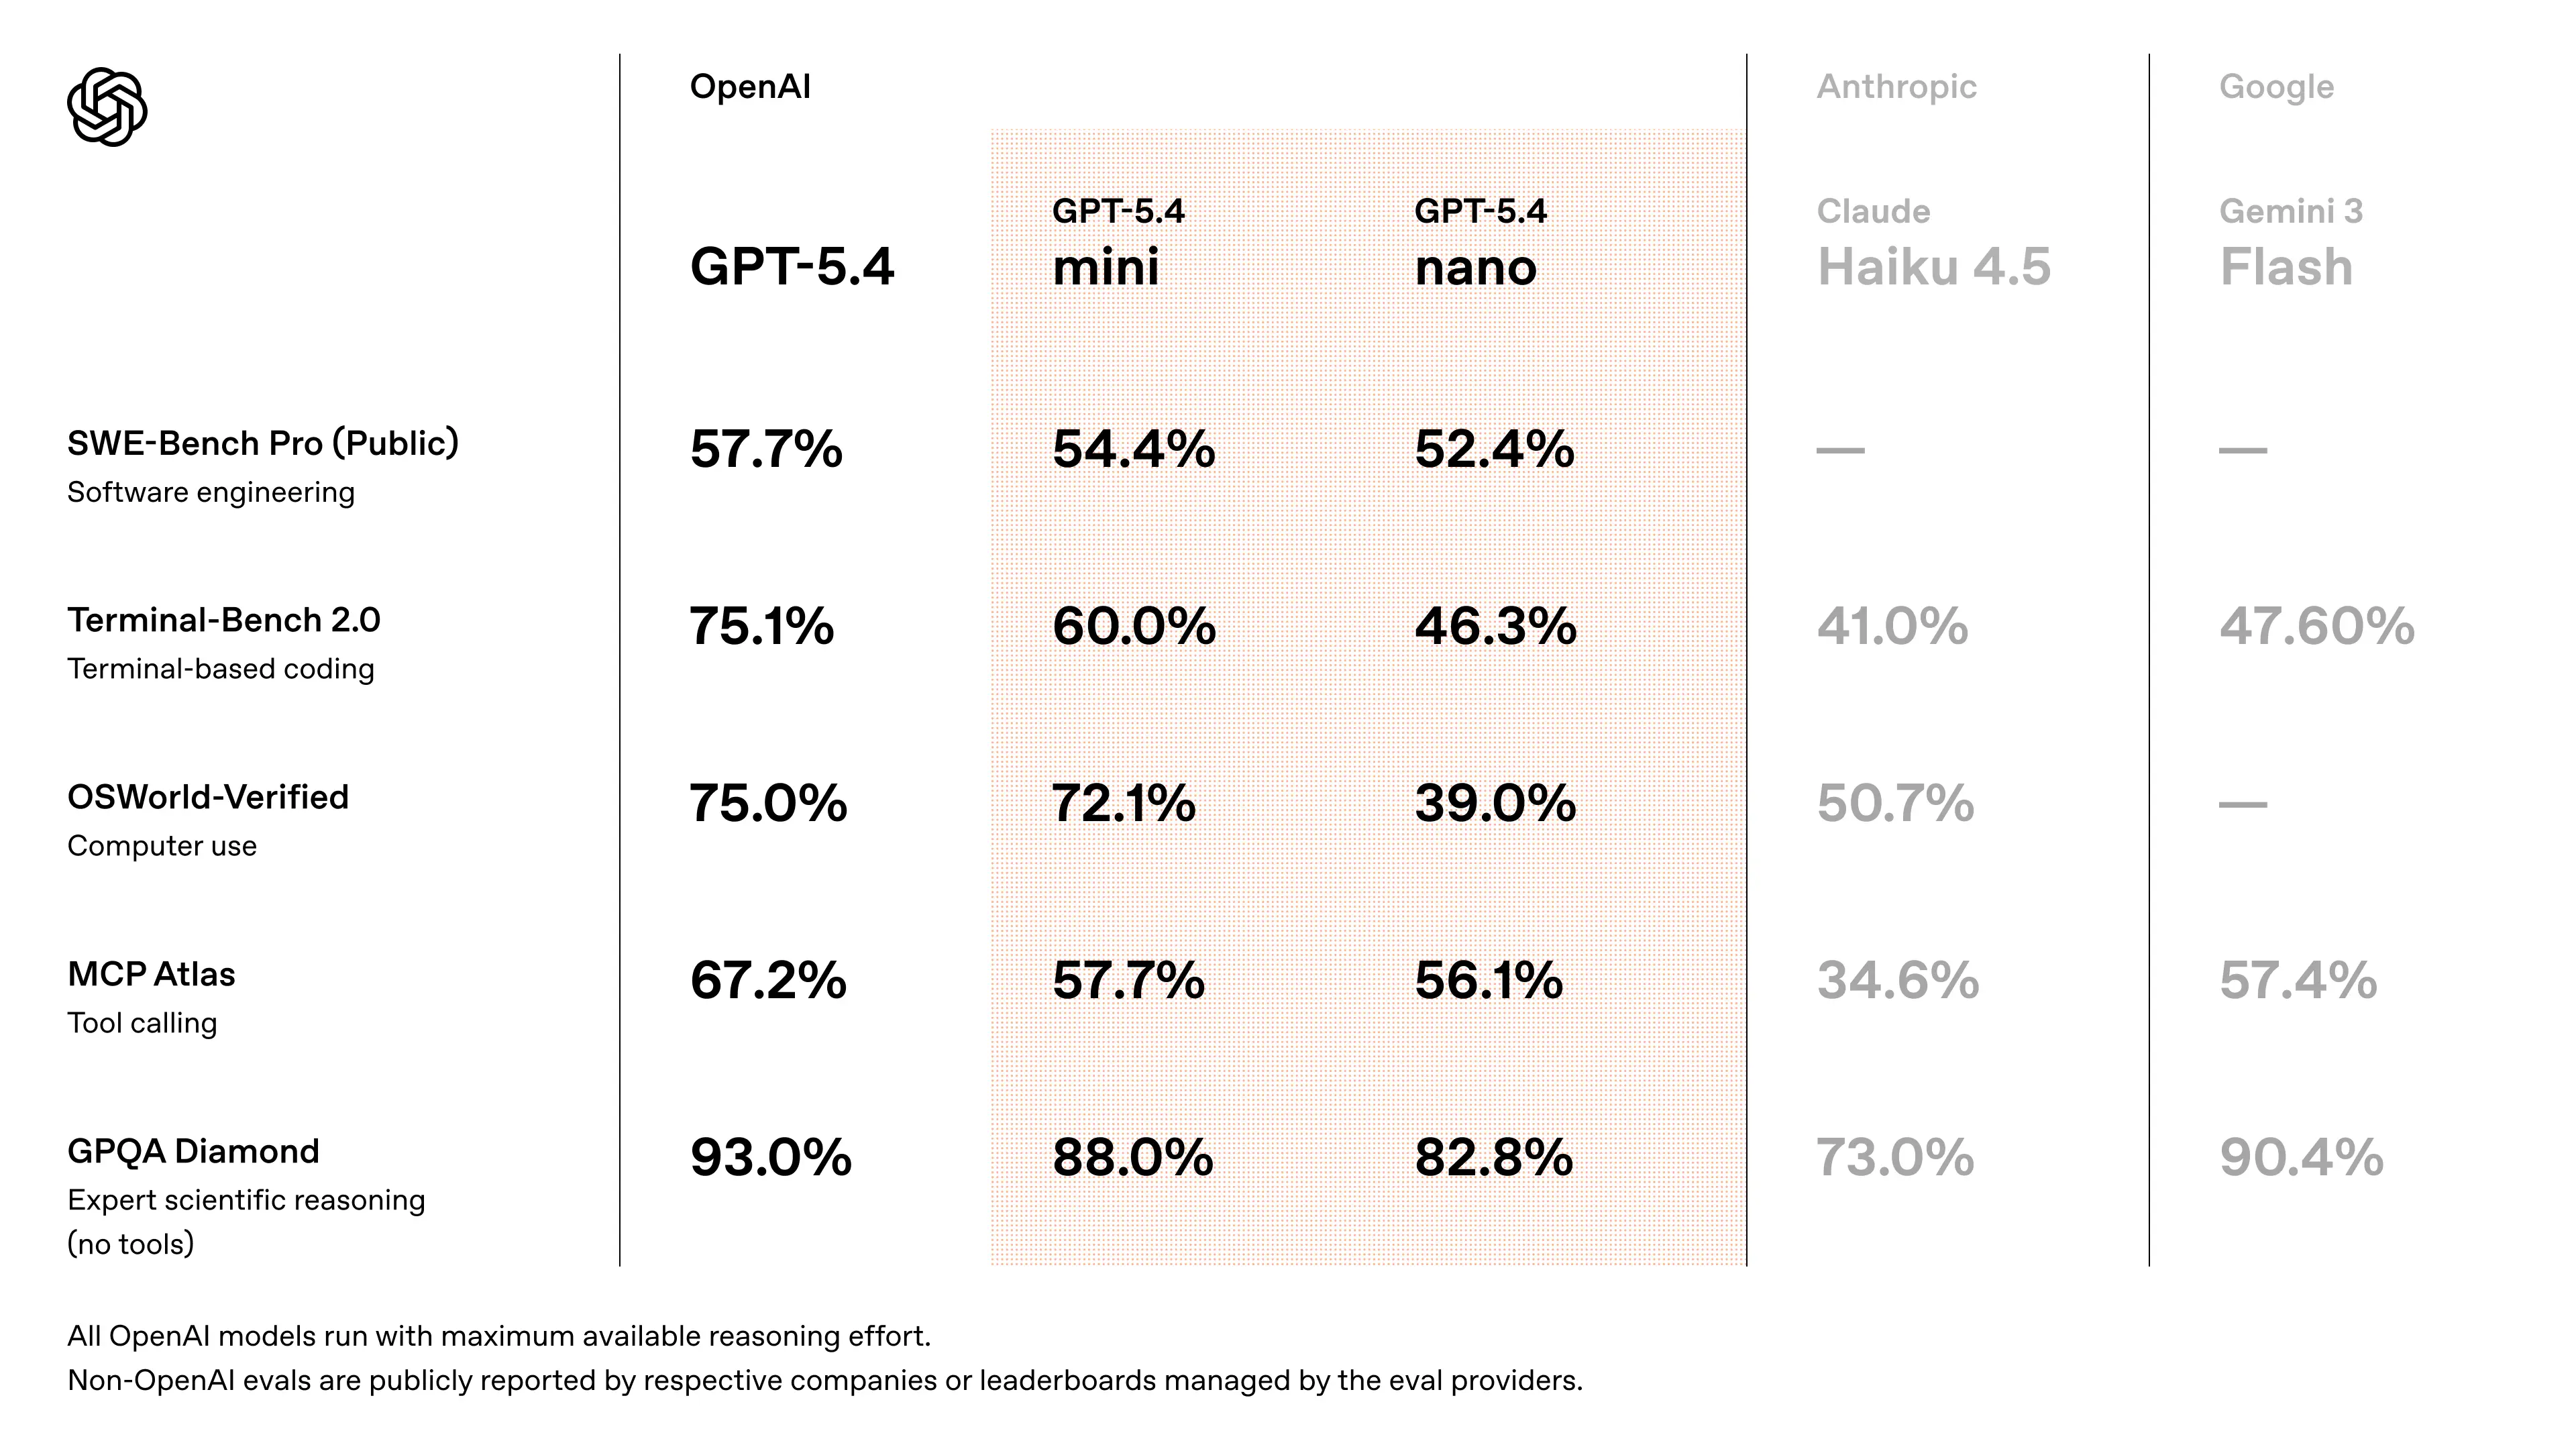
- Se aproxima al rendimiento de GPT-5.4 en tareas de programación tipo SWE-Bench (~94–95% del rendimiento del modelo insignia) (estimación validada de forma cruzada a partir de discusiones del lanzamiento)
- Mejoras significativas con respecto a GPT-5 Mini en:
- precisión de razonamiento
- fiabilidad en el uso de herramientas
- comprensión multimodal
- Diseñado para superar a las generaciones “mini” anteriores en flujos de trabajo con agentes y benchmarks de programación
- mediciones de velocidad: los primeros evaluadores de la API reportan ~180–190 tokens/sec en GPT-5.4 Mini (frente a ~55–120 t/s en variantes GPT-5 mini anteriores dependiendo de los modos de prioridad).
👉 Idea clave: GPT-5.4 Mini ofrece un rendimiento cercano a la frontera a una fracción del costo y la latencia, lo que lo hace ideal para sistemas escalables.
Casos de uso representativos
- Asistentes y editores de programación (plugins de IDE, Copilot): el análisis rápido del contexto, la exploración de bases de código y las completaciones ágiles hacen que GPT-5.4 Mini sea ideal para sugerencias dentro del editor donde el tiempo hasta el primer token es crucial. GitHub Copilot es una integración temprana.
- Subagentes / trabajadores delegados: donde un agente maestro delega tareas cortas y rápidas (formateo, pequeños pasos de razonamiento, búsquedas estilo grep) a un trabajador barato y veloz. OpenAI posiciona los mini/nano para estos roles.
- Automatización de API de alto volumen: generación masiva de código, clasificación automatizada de tickets, resumen de logs a escala, donde el costo por llamada y la latencia son las principales restricciones. Las cifras de rendimiento de la comunidad indican ventajas operativas sustanciales para el mini.
- Envoltura de herramientas y cadenas de herramientas: llamadas rápidas a herramientas donde el modelo orquesta llamadas a herramientas externas (search, grep, run tests) y devuelve salidas compactas y accionables. La familia GPT-5.4 incluye capacidades mejoradas de “uso del ordenador”.
Cómo acceder a la API de GPT-5.4 Mini
Paso 1: Regístrese para obtener la clave de API
Inicie sesión en cometapi.com. Si aún no es usuario, regístrese primero. Ingrese a su consola de CometAPI. Obtenga la clave de API de credencial de acceso de la interfaz. Haga clic en “Add Token” en el token de API del centro personal, obtenga la clave del token: sk-xxxxx y envíela.

Paso 2: Envíe solicitudes a la API de GPT-5.4 Mini
Seleccione el endpoint “gpt-5.4-mini” para enviar la solicitud a la API y configure el cuerpo de la solicitud. El método y el cuerpo de la solicitud se obtienen de la documentación de la API en nuestro sitio web. Nuestro sitio también ofrece pruebas en Apifox para su comodidad. Reemplace <YOUR_API_KEY> con su clave real de CometAPI de su cuenta. La URL base es Chat Completions y Responses.
Inserte su pregunta o solicitud en el campo content—esto es a lo que responderá el modelo. Procese la respuesta de la API para obtener la respuesta generada.
Paso 3: Recupere y verifique los resultados
Procese la respuesta de la API para obtener la respuesta generada. Tras el procesamiento, la API responde con el estado de la tarea y los datos de salida.