Especificaciones técnicas de GLM-5-Turbo
| Elemento | GLM-5-Turbo (estimado / lanzamiento anticipado) |
|---|---|
| Familia de modelos | GLM-5 (variante Turbo – optimizada para baja latencia) |
| Proveedor | Zhipu AI (Z.ai) |
| Arquitectura | Mezcla de expertos (MoE) con atención dispersa |
| Tipos de entrada | Texto |
| Tipos de salida | Texto |
| Ventana de contexto | ~200,000 tokens |
| Máximo de tokens de salida | Hasta ~128,000 (informes tempranos) |
| Enfoque principal | Flujos de trabajo de agentes, uso de herramientas, inferencia rápida |
| Estado de lanzamiento | Experimental / parcialmente de código cerrado |
Qué es GLM-5-Turbo
GLM-5-Turbo es una variante optimizada para latencia de la familia de modelos GLM-5, diseñada específicamente para flujos de trabajo de agentes de nivel de producción y aplicaciones en tiempo real. Se basa en la arquitectura MoE a gran escala de GLM-5 (~745B parámetros) y desplaza el enfoque hacia la velocidad, la capacidad de respuesta y la fiabilidad en la orquestación de herramientas, en lugar de la máxima profundidad de razonamiento.
A diferencia del GLM-5 base (que apunta a razonamiento de frontera y benchmarks de programación), la versión Turbo está ajustada para sistemas interactivos, canalizaciones de automatización y ejecución de herramientas en múltiples pasos.
Características clave
- Inferencia de baja latencia: Optimizada para tiempos de respuesta más rápidos en comparación con GLM-5 estándar, lo que la hace adecuada para aplicaciones en tiempo real.
- Entrenamiento orientado al agente: Diseñada en torno al uso de herramientas y flujos de trabajo de múltiples pasos desde la fase de entrenamiento, no solo mediante ajuste fino posterior.
- Ventana de contexto amplia (200K): Maneja documentos extensos, bases de código y cadenas de razonamiento de múltiples pasos en una sola sesión.
- Alta fiabilidad en llamadas a herramientas: Ejecución de funciones y encadenamiento de flujos de trabajo mejorados para sistemas de agentes.
- Arquitectura MoE eficiente: Activa solo un subconjunto de parámetros por token, equilibrando costo y rendimiento.
- Diseño orientado a producción: Prioriza la estabilidad y el rendimiento sostenido sobre las puntuaciones máximas en benchmarks.
Resultados de referencia e información de rendimiento
Aunque los benchmarks específicos de GLM-5-Turbo no se han divulgado por completo, hereda características de rendimiento de GLM-5:
- ~77.8% en SWE-bench Verified (línea base de GLM-5)
- Desempeño sólido en programación orientada a agentes y tareas de largo horizonte
- Competitivo frente a modelos como Claude Opus y sistemas de clase GPT en razonamiento y programación
👉 Turbo sacrifica cierta precisión máxima a cambio de una inferencia más rápida y mejor usabilidad en tiempo real.
GLM-5-Turbo vs. modelos comparables
| Modelo | Fortalezas | Debilidades | Mejor caso de uso |
|---|---|---|---|
| GLM-5-Turbo | Rápido, centrado en agentes, contexto largo | Menor razonamiento máximo frente al modelo insignia | Agentes en tiempo real, automatización |
| GLM-5 (base) | Razonamiento sólido, altos benchmarks | Inferencia más lenta | Investigación, programación compleja |
| Modelos clase GPT-5 | Razonamiento de primer nivel, multimodal | Mayor costo, cerrado | IA de nivel empresarial |
| Claude Opus (latest) | Razonamiento fiable, seguridad | Más lento en bucles de agentes | Razonamiento de formato largo |
Mejores casos de uso
- Agentes de IA y canalizaciones de automatización (flujos de trabajo de múltiples pasos)
- Sistemas de chat en tiempo real que requieren baja latencia
- Aplicaciones integradas con herramientas (APIs, recuperación, llamadas a funciones)
- Copilotos para desarrolladores con bucles de retroalimentación rápidos
- Aplicaciones de contexto amplio como análisis de documentos
Cómo acceder a la API de GLM-5 Turbo
Paso 1: Regístrate para obtener la clave de API
Inicia sesión en cometapi.com. Si aún no eres nuestro usuario, regístrate primero. Inicia sesión en tu Consola de CometAPI. Obtén la credencial de acceso (clave de API) de la interfaz. Haz clic en “Add Token” en el token de API del centro personal, obtén la clave del token: sk-xxxxx y envíalo.
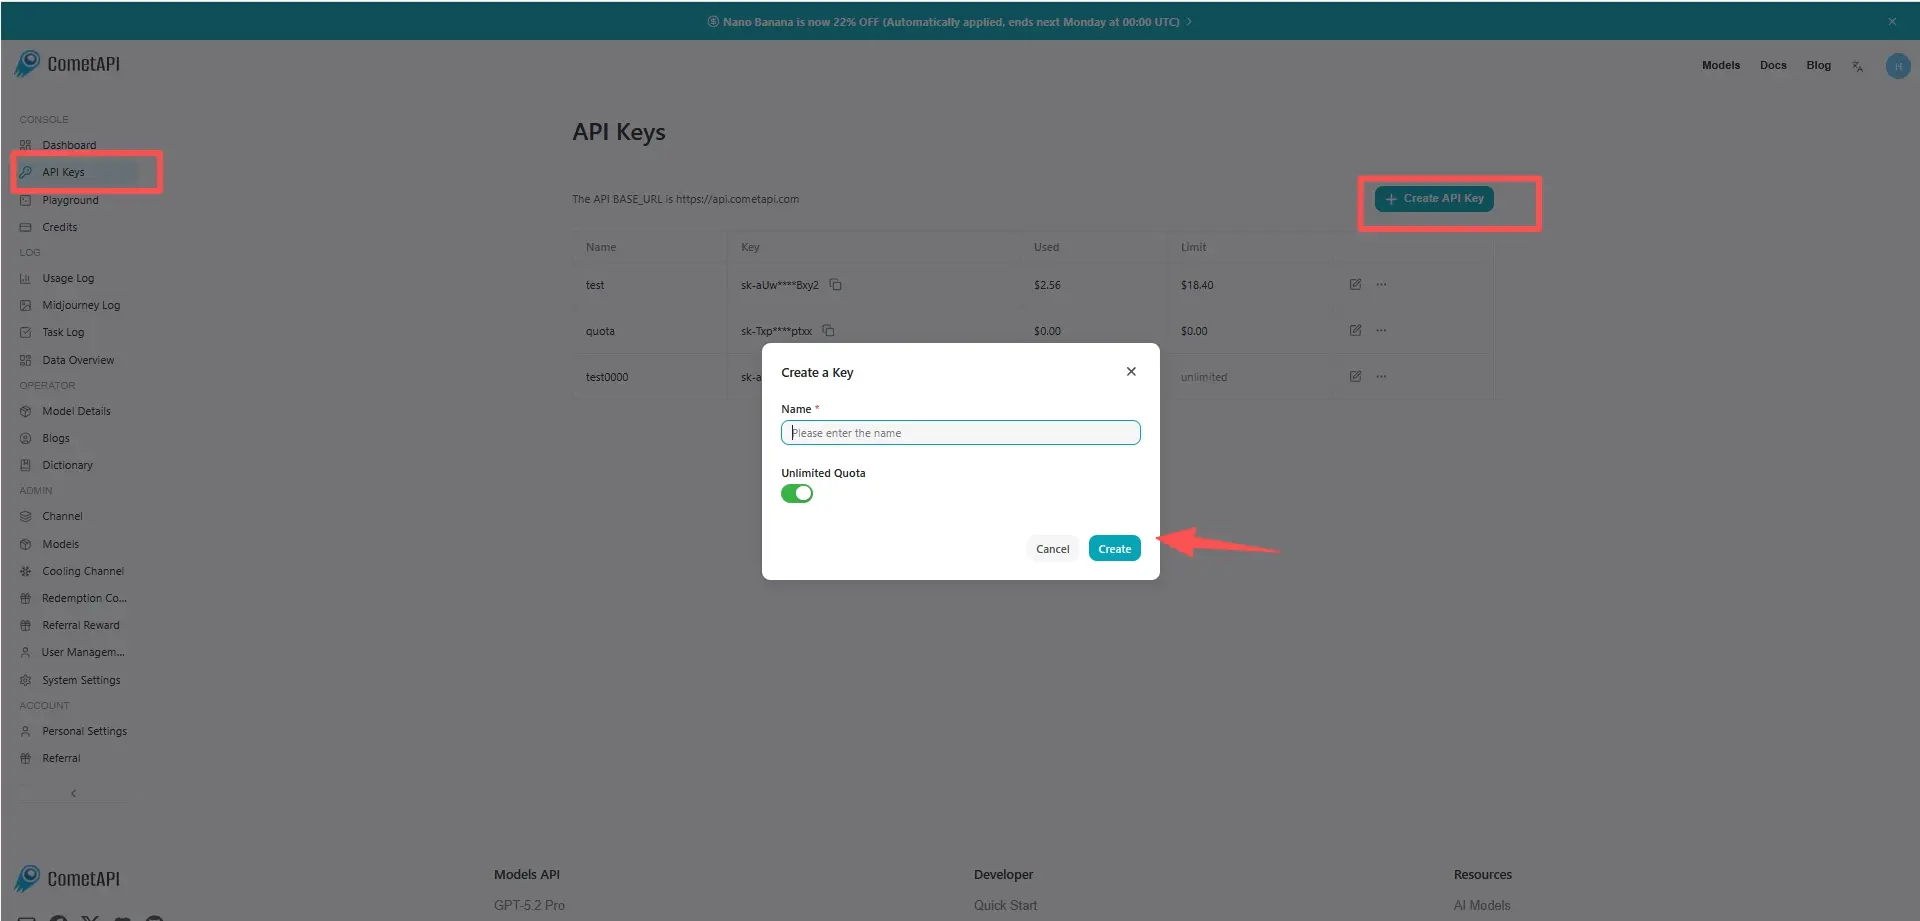
Paso 2: Envía solicitudes a la API de GLM-5 Turbo
Selecciona el endpoint “glm-5-turbo” para enviar la solicitud de API y establece el cuerpo de la solicitud. El método y el cuerpo de la solicitud se obtienen de la documentación de la API en nuestro sitio web. Nuestro sitio también ofrece pruebas en Apifox para tu comodidad. Reemplaza <YOUR_API_KEY> por tu clave real de CometAPI de tu cuenta. La URL base es Chat Completions
Inserta tu pregunta o solicitud en el campo content—esto es a lo que responderá el modelo. Procesa la respuesta de la API para obtener la respuesta generada.
Paso 3: Recupera y verifica los resultados
Procesa la respuesta de la API para obtener la respuesta generada. Tras el procesamiento, la API responde con el estado de la tarea y los datos de salida.