Spesifikasi Teknis GLM-5-Turbo
| Item | GLM-5-Turbo (perkiraan / rilis awal) |
|---|---|
| Keluarga model | GLM-5 (varian Turbo – dioptimalkan untuk latensi rendah) |
| Penyedia | Zhipu AI (Z.ai) |
| Arsitektur | Mixture-of-Experts (MoE) dengan perhatian jarang |
| Jenis input | Teks |
| Jenis output | Teks |
| Jendela konteks | ~200,000 token |
| Maksimal token keluaran | Hingga ~128,000 (laporan awal) |
| Fokus inti | Alur kerja agen, penggunaan alat, inferensi cepat |
| Status rilis | Eksperimental / sumber tertutup sebagian |
Apa itu GLM-5-Turbo
GLM-5-Turbo adalah varian yang dioptimalkan untuk latensi dari keluarga model GLM-5, yang dirancang khusus untuk alur kerja agen tingkat produksi dan aplikasi waktu nyata. Model ini dibangun di atas arsitektur MoE skala besar GLM-5 (~745B parameter) dan mengalihkan fokus ke kecepatan, responsivitas, dan keandalan orkestrasi alat alih-alih kedalaman penalaran maksimum.
Berbeda dari GLM-5 dasar (yang menargetkan tolok ukur penalaran dan pengodean tingkat terdepan), versi Turbo disetel untuk sistem interaktif, pipeline otomatisasi, dan eksekusi alat multi-langkah.
Fitur Utama GLM-5-Turbo
- Inferensi berlatensi rendah: Dioptimalkan untuk waktu respons lebih cepat dibanding GLM-5 standar, membuatnya cocok untuk aplikasi waktu nyata.
- Pelatihan berfokus pada agen: Dirancang mengelilingi penggunaan alat dan alur kerja multi-langkah sejak fase pelatihan, bukan hanya penyetelan halus pasca-pelatihan.
- Jendela konteks besar (200K): Menangani dokumen panjang, basis kode, dan rantai penalaran multi-langkah dalam satu sesi.
- Keandalan pemanggilan alat yang kuat: Peningkatan eksekusi fungsi dan perangkaian alur kerja untuk sistem agen.
- Arsitektur MoE yang efisien: Mengaktifkan hanya sebagian parameter per token, menyeimbangkan biaya dan kinerja.
- Desain berorientasi produksi: Mengutamakan stabilitas dan throughput dibanding skor tolok ukur maksimum.
Tolok Ukur & Wawasan Kinerja
Walau tolok ukur spesifik GLM-5-Turbo belum sepenuhnya diungkapkan, model ini mewarisi karakteristik kinerja dari GLM-5:
- ~77.8% pada SWE-bench Verified (baseline GLM-5)
- Kinerja kuat dalam pengodean berbasis agen dan tugas jangka panjang
- Kompetitif dengan model seperti Claude Opus dan sistem kelas GPT dalam penalaran dan pengodean
👉 Turbo menukar sebagian akurasi puncak demi inferensi lebih cepat dan kegunaan waktu nyata yang lebih baik.
GLM-5-Turbo vs Model yang Sebanding
| Model | Kekuatan | Kelemahan | Kasus Penggunaan Terbaik |
|---|---|---|---|
| GLM-5-Turbo | Cepat, berfokus pada agen, konteks panjang | Penalaran puncak lebih rendah dibanding unggulan | Agen waktu nyata, otomasi |
| GLM-5 (base) | Penalaran kuat, tolok ukur tinggi | Inferensi lebih lambat | Riset, pengodean kompleks |
| GPT-5-class models | Penalaran kelas atas, multimodal | Biaya lebih tinggi, tertutup | AI tingkat perusahaan |
| Claude Opus (terbaru) | Penalaran andal, keamanan | Lebih lambat dalam loop agen | Penalaran bentuk panjang |
Kasus Penggunaan Terbaik
- Agen AI & pipeline otomasi (alur kerja multi-langkah)
- Sistem chat waktu nyata yang membutuhkan latensi rendah
- Aplikasi terintegrasi alat (API, pengambilan, pemanggilan fungsi)
- Copilot pengembang dengan loop umpan balik cepat
- Aplikasi konteks panjang seperti analisis dokumen
Cara mengakses API GLM-5 Turbo
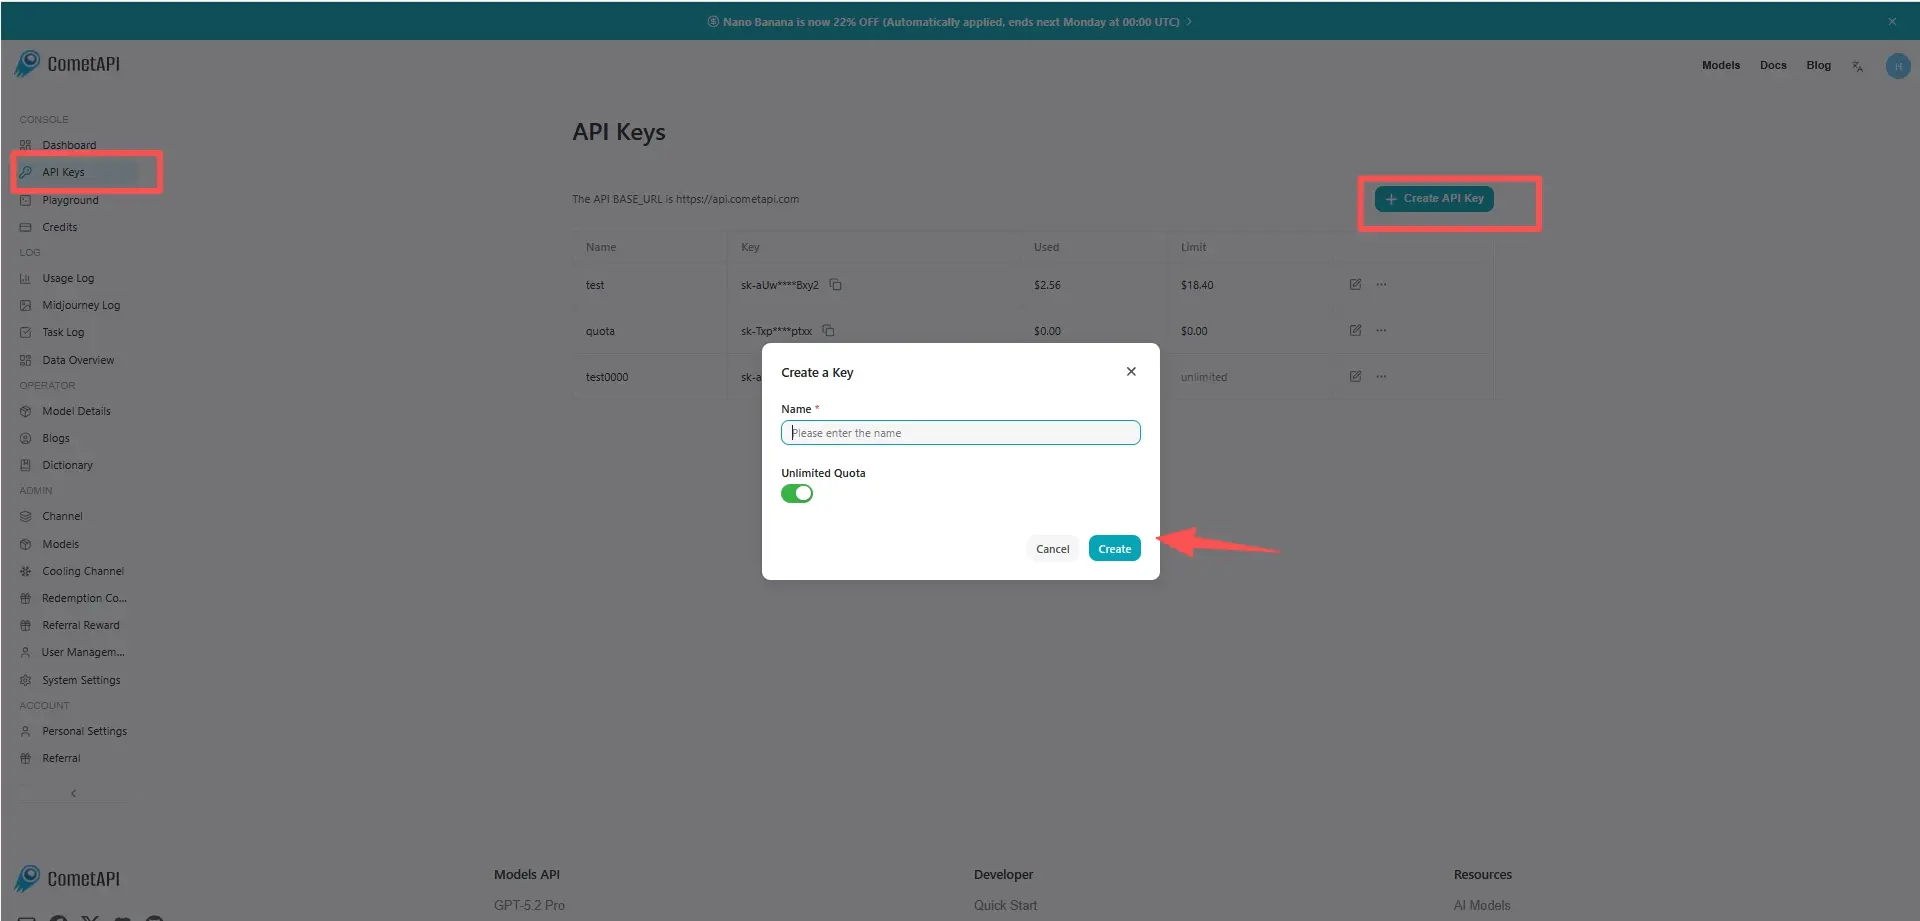
Langkah 1: Daftar untuk Kunci API
Masuk ke cometapi.com. Jika Anda belum menjadi pengguna kami, silakan daftar terlebih dahulu. Masuk ke Konsol CometAPI. Dapatkan kredensial akses kunci API dari antarmuka. Klik “Add Token” pada token API di pusat pribadi, dapatkan kunci token: sk-xxxxx dan kirimkan.
Langkah 2: Kirim Permintaan ke API GLM-5 Turbo
Pilih endpoint “glm-5-turbo” untuk mengirim permintaan API dan tetapkan body permintaan. Metode permintaan dan body permintaan diperoleh dari dokumen API di situs kami. Situs kami juga menyediakan pengujian Apifox untuk kenyamanan Anda. Ganti <YOUR_API_KEY> dengan kunci CometAPI Anda yang sebenarnya dari akun Anda. URL dasar adalah Chat Completions
Masukkan pertanyaan atau permintaan Anda ke bidang content—itulah yang akan direspons oleh model. Proses respons API untuk mendapatkan jawaban yang dihasilkan.
Langkah 3: Ambil dan Verifikasi Hasil
Proses respons API untuk mendapatkan jawaban yang dihasilkan. Setelah diproses, API akan merespons dengan status tugas dan data keluaran.