Thông số kỹ thuật của GLM-5-Turbo
| Hạng mục | GLM-5-Turbo (ước tính / phát hành sớm) |
|---|---|
| Họ mô hình | GLM-5 (biến thể Turbo – tối ưu độ trễ thấp) |
| Nhà cung cấp | Zhipu AI (Z.ai) |
| Kiến trúc | Mixture-of-Experts (MoE) với cơ chế chú ý thưa |
| Kiểu đầu vào | Văn bản |
| Kiểu đầu ra | Văn bản |
| Cửa sổ ngữ cảnh | ~200,000 token |
| Số token đầu ra tối đa | Lên đến ~128,000 (báo cáo ban đầu) |
| Trọng tâm cốt lõi | Luồng công việc agent, sử dụng công cụ, suy luận nhanh |
| Trạng thái phát hành | Thử nghiệm / đóng nguồn một phần |
GLM-5-Turbo là gì
GLM-5-Turbo là một biến thể tối ưu độ trễ của họ mô hình GLM-5, được thiết kế riêng cho các luồng công việc agent cấp độ sản xuất và ứng dụng thời gian thực. Mô hình kế thừa kiến trúc MoE quy mô lớn của GLM-5 (~745B tham số) và chuyển trọng tâm sang tốc độ, độ phản hồi và độ tin cậy trong điều phối công cụ thay vì độ sâu suy luận tối đa.
Khác với GLM-5 bản cơ sở (hướng đến các điểm chuẩn suy luận và lập trình ở mức tiên phong), phiên bản Turbo được tinh chỉnh cho hệ thống tương tác, pipeline tự động hóa và thực thi công cụ nhiều bước.
Tính năng chính của GLM-5-Turbo
- Suy luận độ trễ thấp: Tối ưu để phản hồi nhanh hơn so với GLM-5 tiêu chuẩn, phù hợp cho ứng dụng thời gian thực.
- Huấn luyện ưu tiên agent: Được thiết kế xoay quanh việc sử dụng công cụ và luồng công việc nhiều bước ngay từ giai đoạn huấn luyện, không chỉ tinh chỉnh hậu huấn luyện.
- Cửa sổ ngữ cảnh lớn (200K): Xử lý tài liệu dài, codebase và chuỗi suy luận nhiều bước trong một phiên.
- Độ tin cậy cao khi gọi công cụ: Cải thiện thực thi hàm và xâu chuỗi luồng công việc cho hệ thống agent.
- Kiến trúc MoE hiệu quả: Chỉ kích hoạt một tập con tham số cho mỗi token, cân bằng chi phí và hiệu năng.
- Thiết kế định hướng sản xuất: Ưu tiên tính ổn định và thông lượng thay vì điểm số tối đa trên điểm chuẩn.
Điểm chuẩn & Thông tin hiệu năng
Dù các điểm chuẩn riêng của GLM-5-Turbo chưa được công bố đầy đủ, mô hình kế thừa các đặc tính hiệu năng từ GLM-5:
- ~77,8% trên SWE-bench Verified (đường cơ sở GLM-5)
- Hiệu năng mạnh trong lập trình dạng agent và các tác vụ tầm dài
- Cạnh tranh với các mô hình như Claude Opus và hệ GPT-class về suy luận và lập trình
👉 Turbo đánh đổi một phần độ chính xác đỉnh để có suy luận nhanh hơn và khả năng sử dụng thời gian thực tốt hơn.
GLM-5-Turbo so với các mô hình tương đương
| Mô hình | Điểm mạnh | Điểm yếu | Trường hợp sử dụng tốt nhất |
|---|---|---|---|
| GLM-5-Turbo | Nhanh, tập trung vào agent, ngữ cảnh dài | Khả năng suy luận đỉnh kém hơn so với bản đầu bảng | Agent thời gian thực, tự động hóa |
| GLM-5 (cơ sở) | Suy luận mạnh, điểm chuẩn cao | Suy luận chậm hơn | Nghiên cứu, lập trình phức tạp |
| Mô hình GPT-5-class | Suy luận hàng đầu, đa phương thức | Chi phí cao hơn, đóng | AI cấp doanh nghiệp |
| Claude Opus (mới nhất) | Suy luận đáng tin cậy, an toàn | Chậm hơn trong vòng lặp agent | Suy luận dạng dài |
Trường hợp sử dụng tốt nhất
- Agent AI & pipeline tự động hóa (luồng công việc nhiều bước)
- Hệ thống chat thời gian thực yêu cầu độ trễ thấp
- Ứng dụng tích hợp công cụ (API, truy xuất, gọi hàm)
- Trợ lý lập trình viên với vòng phản hồi nhanh
- Ứng dụng ngữ cảnh dài như phân tích tài liệu
Cách truy cập GLM-5 Turbo API
Bước 1: Đăng ký lấy API Key
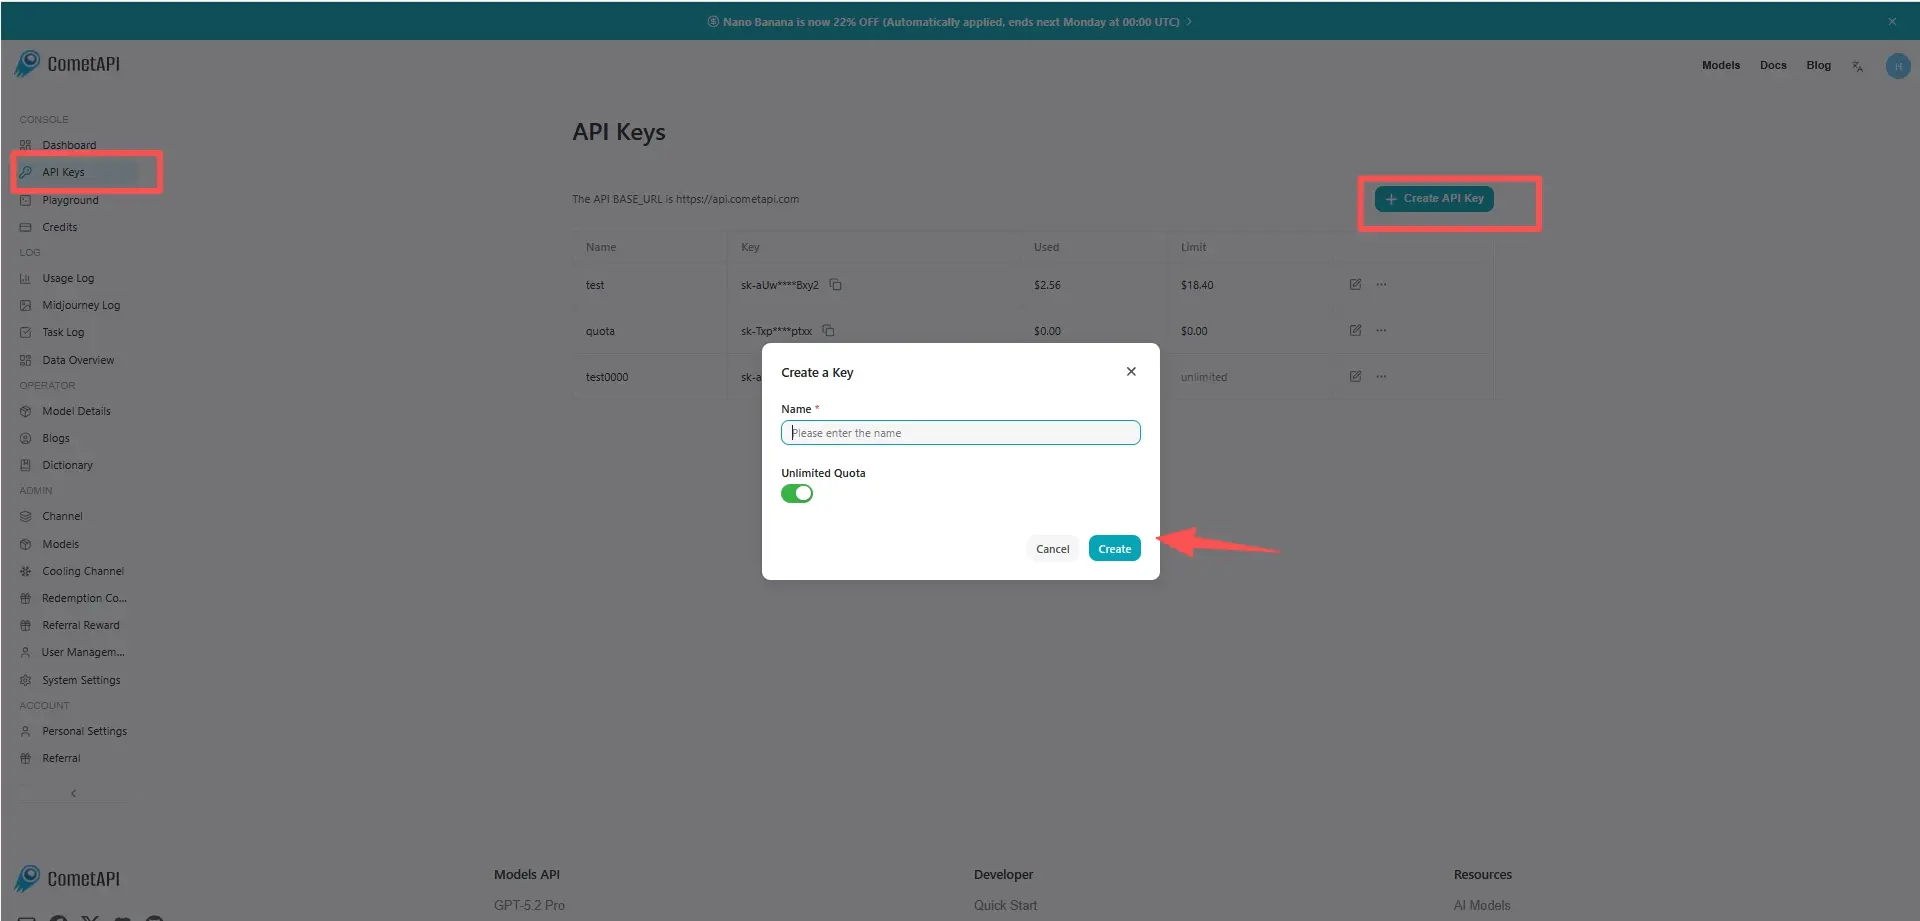
Đăng nhập vào cometapi.com. Nếu bạn chưa là người dùng của chúng tôi, vui lòng đăng ký trước. Đăng nhập vào CometAPI console của bạn tại CometAPI console. Lấy API key thông tin xác thực để truy cập giao diện. Nhấp “Add Token” tại mục API token trong trung tâm cá nhân, lấy khóa token: sk-xxxxx và gửi.
Bước 2: Gửi yêu cầu tới GLM-5 Turbo API
Chọn endpoint “glm-5-turbo” để gửi yêu cầu API và thiết lập phần thân yêu cầu. Phương thức và phần thân yêu cầu được lấy từ tài liệu API trên website của chúng tôi. Website cũng cung cấp bài kiểm thử Apifox để bạn tiện sử dụng. Thay thế <YOUR_API_KEY> bằng CometAPI key thực tế từ tài khoản của bạn. URL cơ sở là Chat Completions
Chèn câu hỏi hoặc yêu cầu của bạn vào trường content — đây là nội dung mà mô hình sẽ phản hồi. Xử lý phản hồi API để lấy câu trả lời được tạo.
Bước 3: Truy xuất và xác minh kết quả
Xử lý phản hồi API để lấy câu trả lời được tạo. Sau khi xử lý, API sẽ phản hồi trạng thái tác vụ và dữ liệu đầu ra.