📊 Tekniske specifikationer
| Specifikation | Detaljer |
|---|---|
| Modelfamilie | Gemini 3 (Flash-Lite) |
| Kontekstvindue | Op til 1 million tokens (multimodal tekst, billeder, lyd, video) |
| Grænse for outputtokens | Op til 64 K tokens |
| Inputtyper | Tekst, billeder, lyd, video |
| Kernearkitekturbasis | Baseret på Gemini 3 Pro |
| Udrulningskanaler | Gemini API (Google AI Studio), Vertex AI |
| Prissætning (preview) | ~$0.25 pr. 1M inputtokens, ~$1.50 pr. 1M outputtokens |
| Ræsonnementskontroller | Justerbare “tænkeniveauer” (fx minimalt til højt) |
🔍 Hvad er Gemini 3.1 Flash-Lite?
Gemini 3.1 Flash-Lite er den omkostningseffektive footprint-variant af Googles Gemini 3-serie, optimeret til massive AI-arbejdsbelastninger i stor skala—især hvor reduceret latens, lavere omkostning pr. token og høj gennemstrømning er prioriteter. Den bevarer den centrale multimodale ræsonnementsrygrad fra Gemini 3 Pro og målretter bulkbehandlings-scenarier som oversættelse, klassificering, indholdsmoderation, UI-generering og syntese af strukturerede data.
✨ Hovedfunktioner
- Ultrastort kontekstvindue: Håndterer op til 1 M tokens af multimodal input, hvilket muliggør ræsonnement over lange dokumenter og video-/lyd-kontekst.
- Omkostningseffektiv udførelse: Betydeligt lavere omkostning pr. token sammenlignet med tidligere Flash-Lite-modeller og konkurrenter, hvilket muliggør brug i høj volumen.
- Høj gennemstrømning og lav latens: ~2.5× hurtigere tid til første token og ~45 % hurtigere outputgennemstrømning end Gemini 2.5 Flash.
- Dynamiske ræsonnementskontroller: “Tænkeniveauer” lader udviklere afveje ydeevne versus dybere ræsonnement pr. forespørgsel.
- Multimodal understøttelse: Indbygget behandling af billeder, lyd, video og tekst i et samlet kontekstområde.
- Fleksibel API-adgang: Tilgængelig via Gemini API i Google AI Studio og enterprise Vertex AI-arbejdsgange.
📈 Benchmark-ydeevne
Følgende metrikker viser Gemini 3.1 Flash-Lites effektivitet og kapabilitet sammenlignet med tidligere Flash/Lite-varianter og andre modeller (rapporteret marts 2026):
| Benchmark | Gemini 3.1 Flash-Lite | Gemini 2.5 Flash Dynamic | GPT-5 Mini |
|---|---|---|---|
| GPQA Diamond (videnskabelig viden) | 86.9 % | 66.7 % | 82.3 % |
| MMMU-Pro (multimodal ræsonnement) | 76.8 % | 51.0 % | 74.1 % |
| CharXiv (komplekst diagramræsonnement) | 73.2 % | 55.5 % | 75.5 % (+python) |
| Video-MMMU | 84.8 % | 60.7 % | 82.5 % |
| LiveCodeBench (kode-ræsonnement) | 72.0 % | 34.3 % | 80.4 % |
| 1M Long-Context | 12.3 % | 5.4 % | Not supported |
Disse resultater indikerer, at Flash-Lite opretholder konkurrencedygtigt ræsonnement og multimodal forståelse, selv med et effektivitetsorienteret design, og overgår ofte ældre Flash-varianter på nøglebenchmarks.
⚖️ Sammenligning med relaterede modeller
| Funktion | Gemini 3.1 Flash-Lite | Gemini 3.1 Pro |
|---|---|---|
| Omkostning pr. token | Lavere (indgangsniveau) | Højere (premium) |
| Latens / gennemstrømning | Optimeret til hastighed | Balanceret med dybde |
| Ræsonnementsdybde | Justerbar, men mere overfladisk | Stærkere dybt ræsonnement |
| Fokus på anvendelse | Bulk-pipelines, moderation, oversættelse | Missionkritiske ræsonnementopgaver |
| Kontekstvindue | 1 M tokens | 1 M tokens (samme) |
Flash-Lite er skræddersyet til skala og omkostninger; Pro er til højpræcision og dybt ræsonnement.
🧠 Enterprise-anvendelser
- Oversættelse og moderation i høj volumen: Sprog- og indholdspipelines i realtid med lav latens.
- Bulkdataekstraktion og klassificering: Behandling af store korpora med effektiv tokonomik.
- UI/UX-generering: Struktureret JSON, dashboard-skabeloner og front-end-grundstrukturer.
- Simulationsprompting: Logisk tilstandssporing på tværs af udvidede interaktioner.
- Multimodale applikationer: Video-, lyd- og billedinformeret ræsonnement i et samlet kontekstområde.
🧪 Begrænsninger
- Dybden af ræsonnement og analytisk præcision kan halte efter Gemini 3.1 Pro i komplekse, missionkritiske opgaver. :
- Benchmark-resultater som long-context-fusion viser plads til forbedring relativt til flagskibsmodeller.
- Dynamiske ræsonnementskontroller afvejer hastighed mod grundighed; ikke alle niveauer garanterer samme outputkvalitet.
GPT-5.3 Chat (Alias: gpt-5.3-chat-latest) — Oversigt
GPT-5.3 Chat er den nyeste produktions-chatmodel fra OpenAI, tilbudt som gpt-5.3-chat-latest endpoint i den officielle API og driver ChatGPTs daglige samtaleoplevelse. Den fokuserer på at forbedre kvaliteten af hverdagsinteraktioner—gøre svarene mere glatte, mere præcise og bedre kontekstualiserede—samtidig med at den bevarer stærke tekniske kapabiliteter fra den bredere GPT-5-familie. :contentReference[oaicite:1]{index=1}
📊 Tekniske specifikationer
| Specifikation | Detaljer |
|---|---|
| Modelnavn/alias | GPT-5.3 Chat / gpt-5.3-chat-latest |
| Udbyder | OpenAI |
| Kontekstvindue | 128,000 tokens |
| Maks. outputtokens pr. forespørgsel | 16,384 tokens |
| Videnscutoff | 31. august 2025 |
| Inputmodaliteter | Tekst og billedinput (kun vision) |
| Outputmodaliteter | Tekst |
| Funktionskald | Understøttet |
| Strukturerede uddata | Understøttet |
| Streaming-svar | Understøttet |
| Finjustering | Ikke understøttet |
| Destillation / indlejringer | Destillation ikke understøttet; indlejringer understøttet |
| Typiske anvendelses-endpoints | Chat completions, Responses, Assistants, Batch, Realtime |
| Funktionskald og værktøjer | Funktionskald aktiveret; understøtter web- og filsøgning via Responses API |
🧠 Hvad gør GPT-5.3 Chat unik
GPT-5.3 Chat repræsenterer en trinvis forfinelse af chat-orienterede kapabiliteter i GPT-5-linjen. Det centrale mål for denne variant er at levere mere naturlige, kontekstuelt sammenhængende og brugervenlige samtalesvar end tidligere modeller som GPT-5.2 Instant. Forbedringerne er orienteret mod:
- Dynamisk, naturlig tone med færre unødige forbehold og mere direkte svar.
- Bedre kontekstforståelse og relevans i almindelige chatscenarier.
- Glattere integration med rige chatbrugstilfælde, inklusive fleromgangsdialog, opsummering og samtalebaseret assistance.
GPT-5.3 Chat anbefales til udviklere og interaktive applikationer, der har brug for de nyeste samtalemæssige forbedringer uden den specialiserede ræsonnementsdybde fra kommende “Thinking”- eller “Pro”-varianter af GPT-5.3 (som er på vej).
🚀 Nøglefunktioner
- Stort chatkontekstvindue: 128K tokens muliggør rige samtalehistorikker og lang kontekstsporing. :contentReference[oaicite:17]{index=17}
- Forbedret svarkvalitet: Forfinet samtaleflow med færre unødige forbehold eller overdrevent forsigtige afslag. :contentReference[oaicite:18]{index=18}
- Officiel API-understøttelse: Fuldt understøttede endpoints til chat, batchbehandling, strukturerede uddata og realtidsarbejdsgange.
- Alsidig inputunderstøttelse: Accepterer og kontekstualiserer tekst- og billedinput, velegnet til multimodale chatbrugstilfælde.
- Funktionskald og struktureret output: Muliggør strukturerede og interaktive applikationsmønstre via API’et. :contentReference[oaicite:21]{index=21}
- Bred økosystemkompatibilitet: Virker med v1/chat/completions, v1/responses, Assistants og andre moderne OpenAI API-grænseflader.
📈 Typiske benchmarks og adfærd
📈 Benchmark-ydeevne
OpenAI og uafhængige rapporter viser forbedret ydeevne i virkeligheden:
| Metrik | GPT-5.3 Instant vs GPT-5.2 Instant |
|---|---|
| Hallucinationsrate med websøgning | −26.8% |
| Hallucinationsrate uden søgning | −19.7% |
| Bruger-markerede faktuelle fejl (web) | ~−22.5% |
| Bruger-markerede faktuelle fejl (internt) | ~−9.6% |
Bemærk, at GPT-5.3’s fokus på samtalekvalitet i virkeligheden betyder, at forbedringer i benchmarkscorer (som standardiserede NLP-metrikker) er mindre fremtrædende ved lancering — forbedringerne viser sig klarest i brugeroplevelsesmetrikker frem for rå testscorer.
I branche-sammenligninger er chatvarianter i GPT-5-familien kendt for at overgå tidligere GPT-4-moduler i hverdagsrelevans og kontekstsporing, selvom specialiserede ræsonnementsopgaver stadig kan favorisere dedikerede “Pro”-varianter eller endpoints optimeret til ræsonnement.
🤖 Anvendelsestilfælde
GPT-5.3 Chat egner sig godt til:
- Kundesupport-bots og samtaleassistenter
- Interaktive tutorials eller uddannelsesagenter
- Opsummering og samtalebaseret søgning
- Interne vidensagenter og teamchat-hjælpere
- Multimodal Q&A (tekst + billeder)
Dens balance mellem samtalekvalitet og API-alsidighed gør den ideel til interaktive applikationer, der kombinerer naturlig dialog med strukturerede datauddata.
🔍 Begrænsninger
- Ikke den mest dybtgående ræsonnementsvariant: Til missionkritisk, dyb analytisk præcision kan kommende GPT-5.3 Thinking eller Pro-modeller være mere passende.
- Multimodale uddata er begrænsede: Selvom inputbilleder understøttes, er fuld billed-/videogenerering eller rige multimodale output-arbejdsgange ikke modelens primære fokus.
- Finjustering understøttes ikke: Du kan ikke finjustere denne model, men du kan styre adfærd via systemprompter.
How to access Gemini 3.1 flash lite API
Trin 1: Tilmeld dig for at få API-nøgle
Log ind på cometapi.com. Hvis du ikke er bruger endnu, skal du først registrere dig. Log ind på din CometAPI-konsol. Hent adgangslegitimationens API-nøgle til interfacet. Klik på “Add Token” under API token i personligt center, hent token-nøglen: sk-xxxxx og indsend.
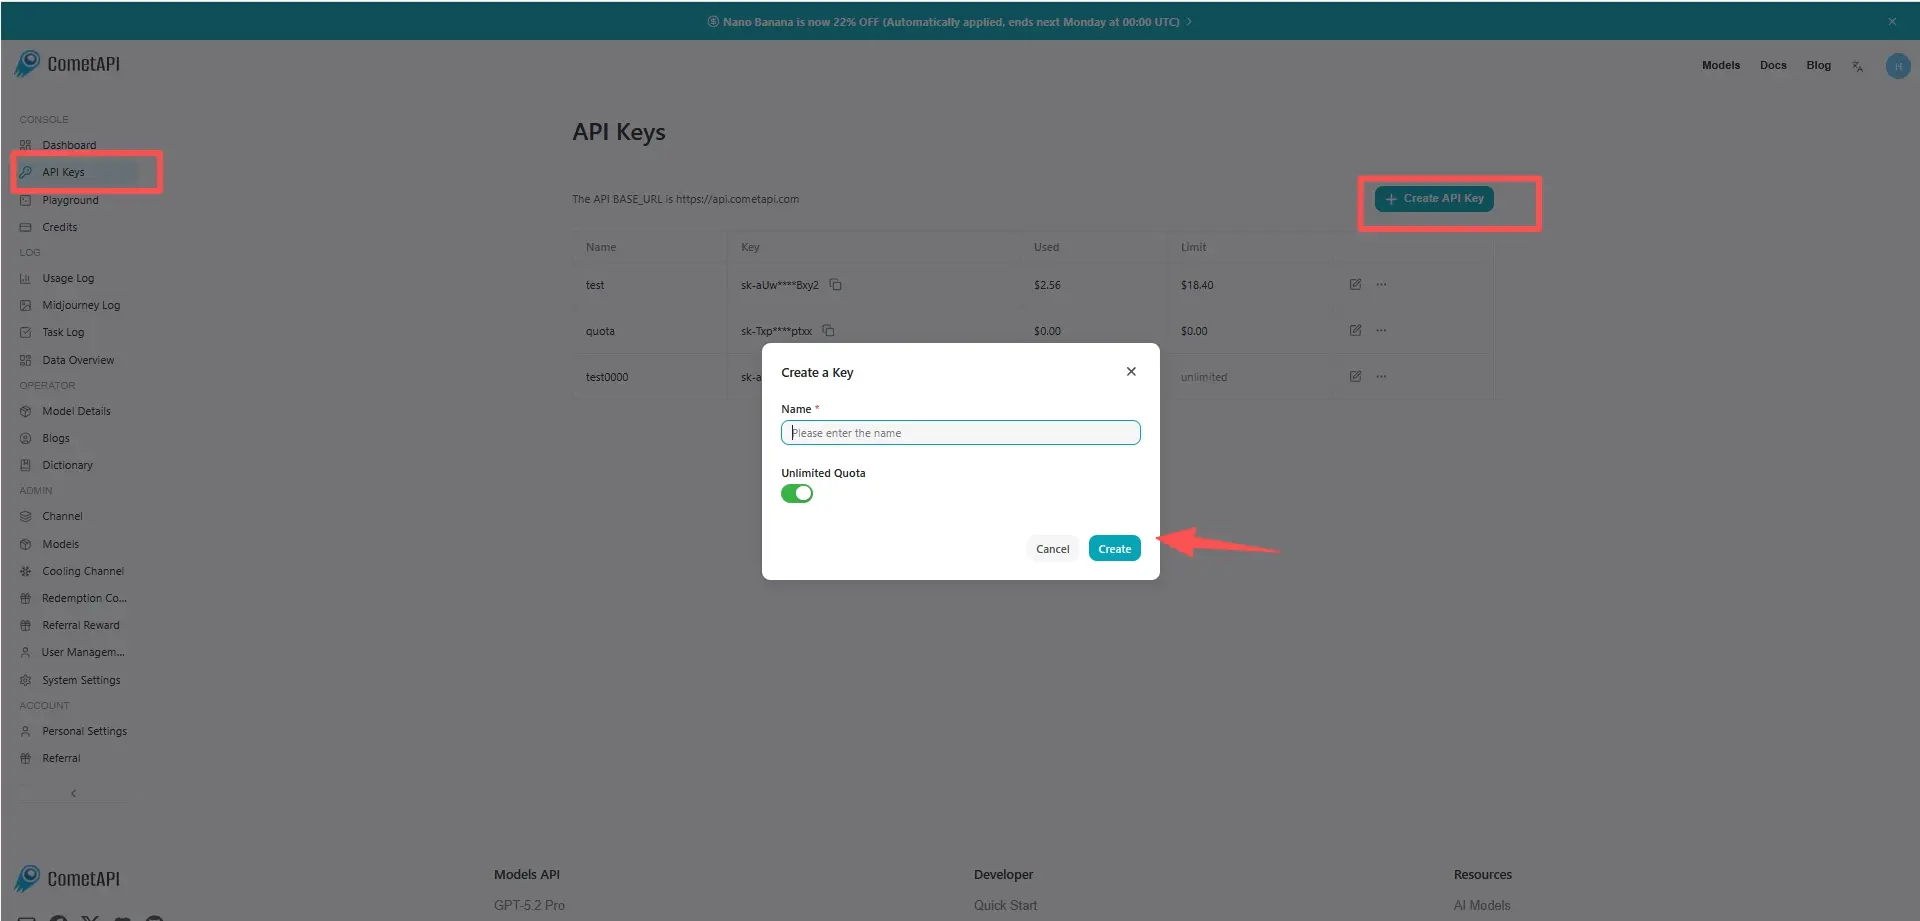
Trin 2: Send forespørgsler til Gemini 3.1 flash lite API
Vælg “` gemini-3.1-flash-lite” endpoint for at sende API-forespørgslen og angiv request body. Request-metoden og request body fås fra vores websteds API-dokumentation. Vores websted tilbyder også Apifox-test for din bekvemmelighed. Erstat <YOUR_API_KEY> med din faktiske CometAPI-nøgle fra din konto. basis-URL er Gemini Generating Content
Indsæt dit spørgsmål eller din anmodning i content-feltet—det er dette, modellen svarer på . Behandl API-svaret for at få det genererede svar.
Trin 3: Hent og verificer resultater
Behandl API-svaret for at få det genererede svar. Efter behandlingen svarer API’et med opgavestatus og outputdata.