Especificações técnicas do GPT-5.4 Mini
| Item | GPT-5.4 Mini (estimado a partir de fontes oficiais + validação cruzada) |
|---|---|
| Model family | Série GPT-5.4 (variante “mini” custo-eficiente) |
| Provider | OpenAI |
| Input types | Texto, Imagem |
| Output types | Texto |
| Context window | 400,000 tokens |
| Max output tokens | 128,000 tokens |
| Knowledge cutoff | ~31 de maio de 2024 (herda a linhagem mini) |
| Reasoning support | Sim (mais leve em comparação com o GPT-5.4 completo) |
| Tool support | Chamadas de função, pesquisa na web, busca de arquivos, agentes (inferido da família GPT-5) |
| Positioning | Modelo de alta velocidade, custo-eficiente e próximo da fronteira |
O que é o GPT-5.4 Mini?
O GPT-5.4 Mini é uma variante do GPT-5.4 de custo eficiente e alta velocidade, projetada para cargas de trabalho sensíveis à latência e de alto volume. Ele incorpora uma parcela significativa do raciocínio, codificação e capacidades multimodais do GPT-5.4 em um modelo menor e mais rápido, otimizado para sistemas em escala de produção.
Em comparação com modelos “mini” anteriores, o GPT-5.4 Mini é posicionado como um modelo pequeno quase de fronteira, o que significa que se aproxima do desempenho do carro-chefe enquanto reduz dramaticamente o custo e o tempo de resposta.
Principais recursos do GPT-5.4 Mini
- Inferência de alta velocidade: Otimizado para aplicações de baixa latência, como chatbots, copilotos e sistemas em tempo real
- Janela de contexto grande (400K): Suporta documentos longos, fluxos de trabalho de múltiplas etapas e memória de agentes
- Suporte sólido a código e agentes: Projetado para uso de ferramentas, raciocínio em múltiplas etapas e tarefas delegadas a subagentes
- Entrada multimodal: Aceita entradas de texto e imagem para fluxos de trabalho mais ricos
- Escalonamento custo-eficiente: Significativamente mais barato que o GPT-5.4, mantendo forte capacidade de raciocínio
- Otimização de pipelines de agentes: Ideal para arquiteturas multimodelo nas quais modelos grandes planejam e modelos mini executam
Desempenho em benchmarks do GPT-5.4 Mini
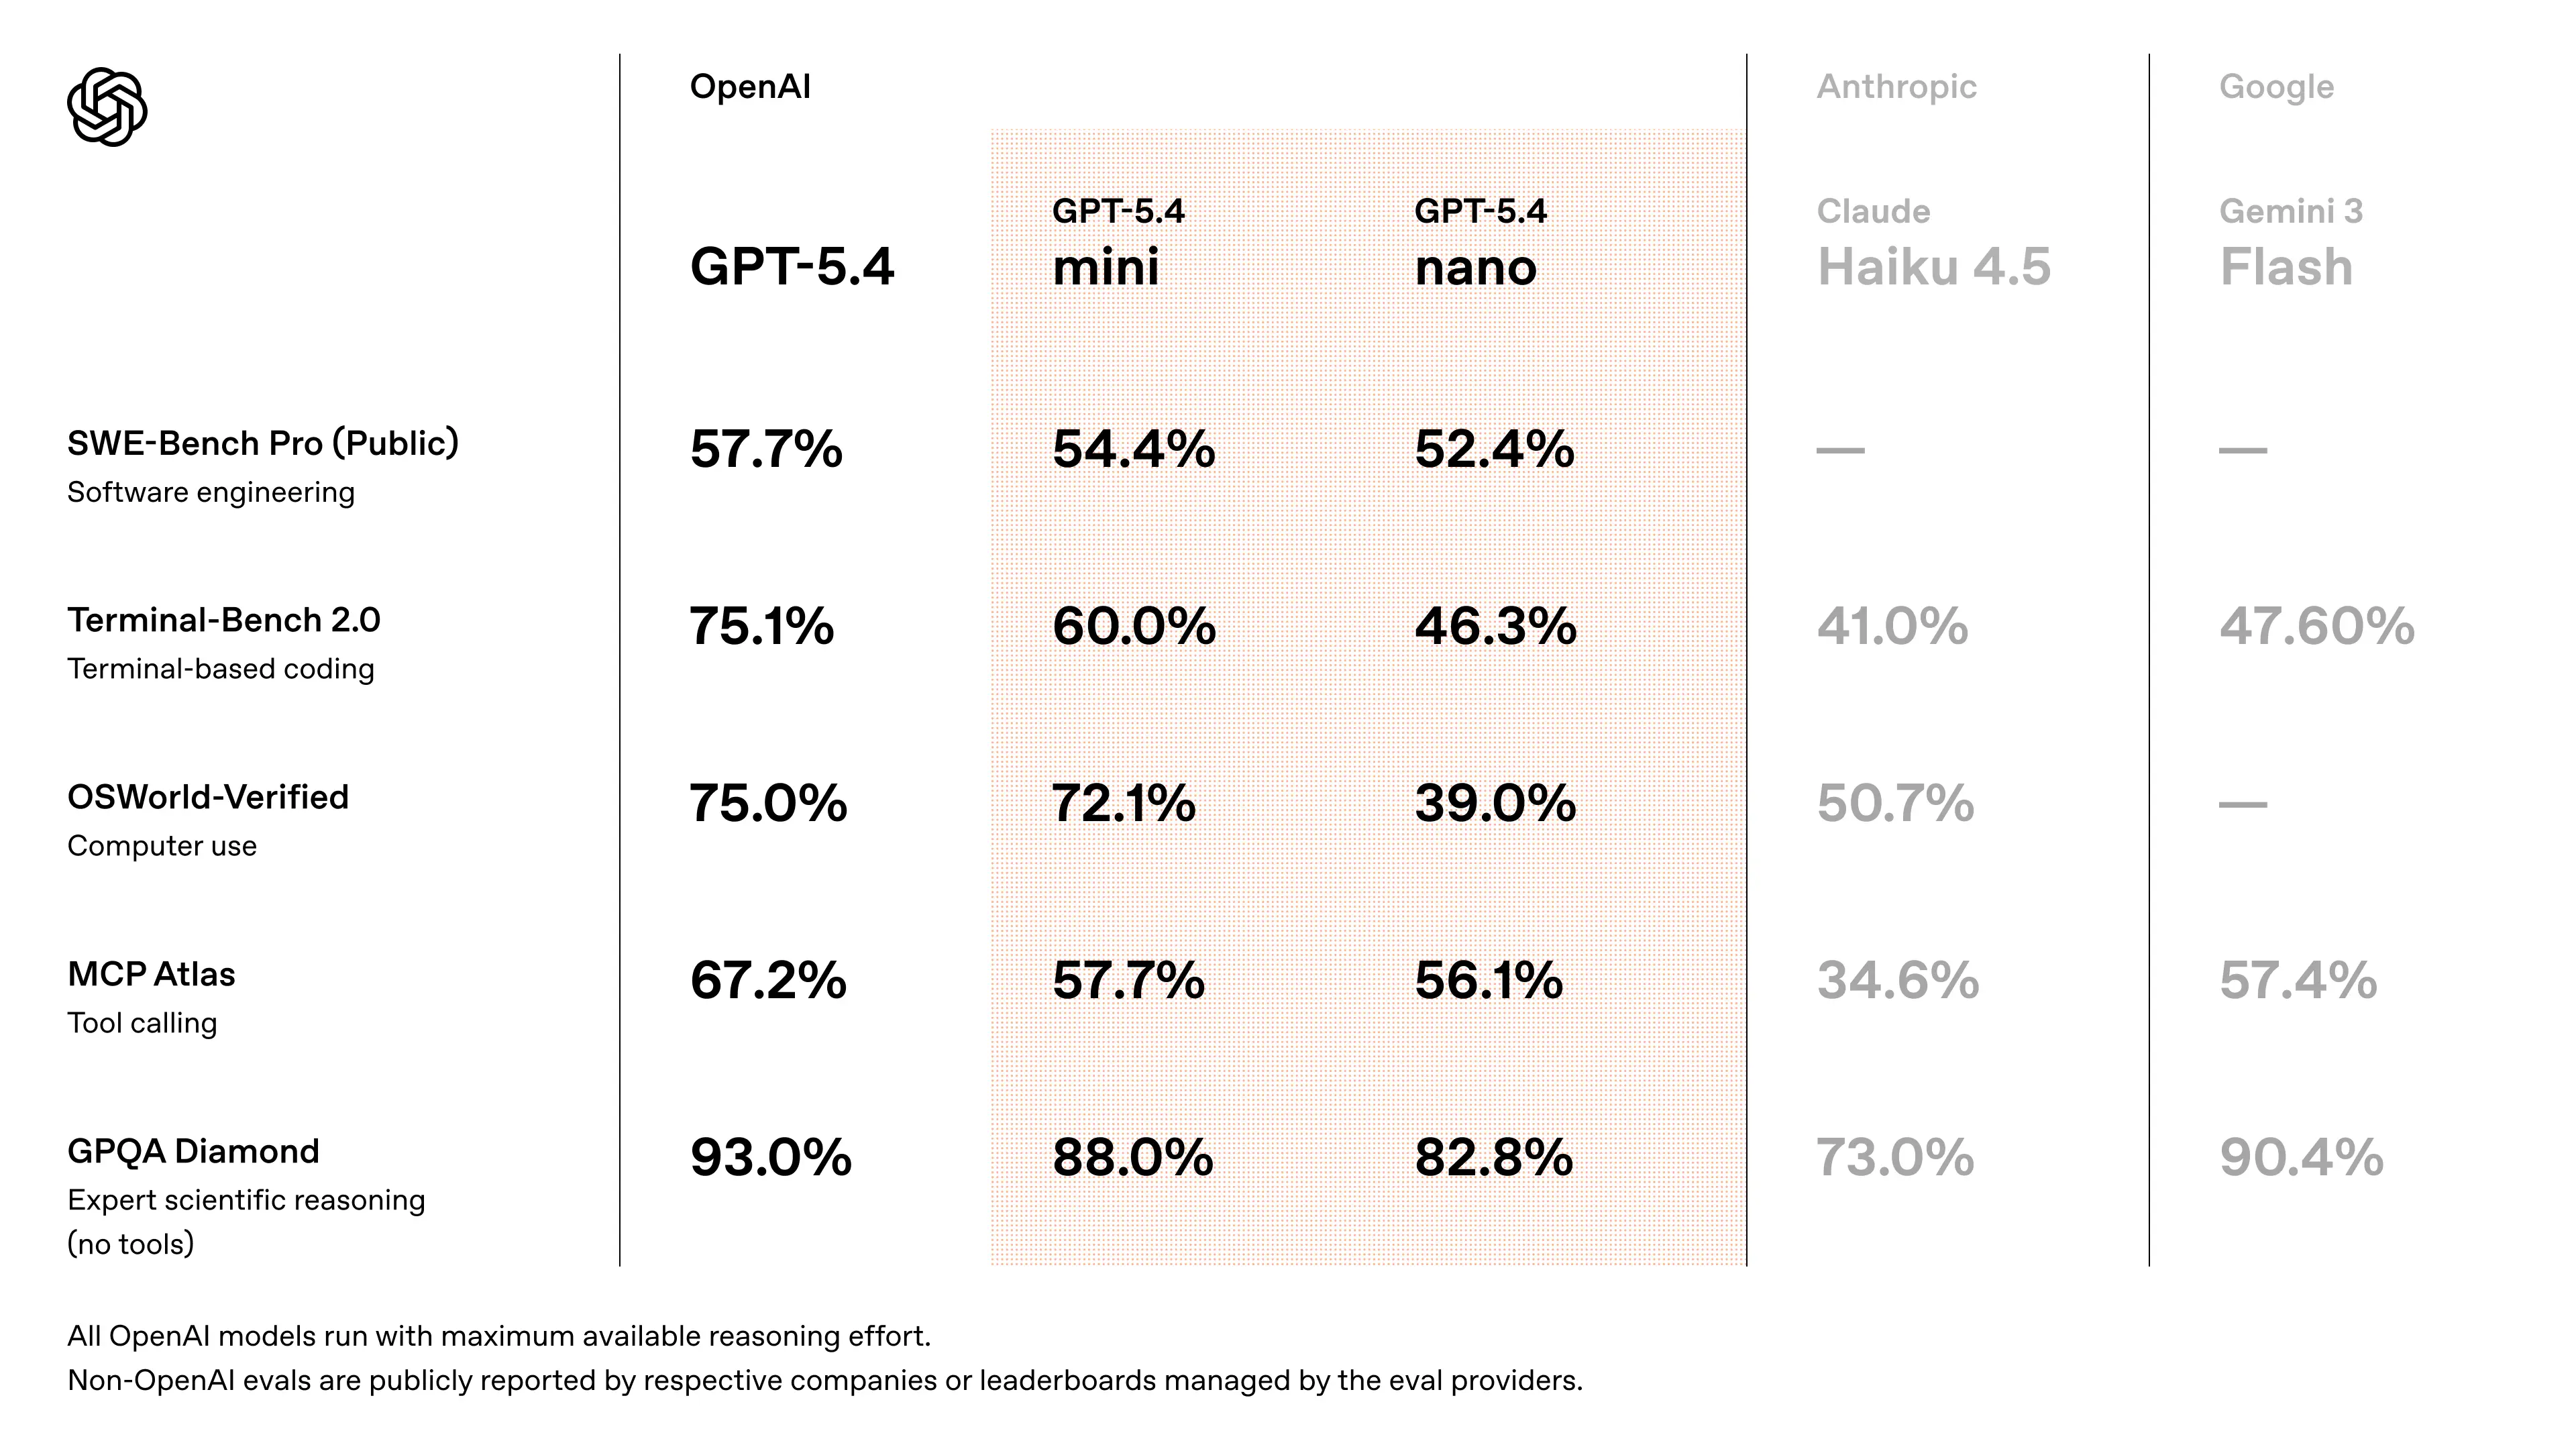
- Aproxima-se do desempenho do GPT-5.4 em tarefas de codificação no estilo SWE-Bench (~94–95% do desempenho do modelo principal) (estimativa com validação cruzada proveniente de discussões de lançamento)
- Melhorias significativas em relação ao GPT-5 Mini em:
- precisão de raciocínio
- confiabilidade no uso de ferramentas
- compreensão multimodal
- Projetado para superar gerações “mini” anteriores em fluxos de trabalho de agentes e benchmarks de codificação
- medições de velocidade: testadores iniciais da API relatam ~180–190 tokens/sec no GPT-5.4 Mini (vs ~55–120 t/s para variantes antigas do GPT-5 mini, dependendo dos modos de prioridade).
👉 Conclusão principal: o GPT-5.4 Mini oferece desempenho quase de fronteira por uma fração do custo e da latência, tornando-o ideal para sistemas escaláveis.
Casos de uso representativos
- Assistentes de codificação e editores (plugins de IDE, Copilot): análise rápida de contexto, exploração de bases de código e completações ágeis tornam o GPT-5.4 Mini ideal para sugestões no editor em que o tempo até o primeiro token é importante. O GitHub Copilot é uma integração inicial.
- Subagentes / trabalhadores delegados: em que um agente mestre delega tarefas curtas e rápidas (formatação, pequenos passos de raciocínio, buscas ao estilo grep) a um trabalhador barato e veloz. A OpenAI posiciona os modelos mini/nano para esses papéis.
- Automação de API em alto volume: geração de código em lote, triagem automatizada de tickets, sumarização de logs em escala, onde o custo por chamada e a latência são as principais restrições. Números de throughput da comunidade indicam vantagens operacionais materiais para o mini.
- Encapsulamento de ferramentas e cadeias de ferramentas: chamadas de ferramentas rápidas em que o modelo orquestra chamadas a ferramentas externas (search, grep, run tests) e retorna saídas compactas e acionáveis. A família GPT-5.4 inclui recursos aprimorados de “computer use”.
Como acessar a API do GPT-5.4 Mini
Etapa 1: Cadastre-se para obter a chave de API
Faça login em cometapi.com. Se você ainda não é nosso usuário, registre-se primeiro. Acesse seu console do CometAPI. Obtenha a chave de API de credenciais de acesso da interface. Clique em “Add Token” no token de API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.

Etapa 2: Envie solicitações para a API do GPT-5.4 Mini
Selecione o endpoint “gpt-5.4-mini” para enviar a solicitação de API e defina o corpo da solicitação. O método da solicitação e o corpo da solicitação são obtidos na documentação da API em nosso site. Nosso site também oferece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave real do CometAPI da sua conta. A URL base é Chat Completions e Responses.
Insira sua pergunta ou solicitação no campo content — é a isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Recupere e verifique os resultados
Processe a resposta da API para obter a resposta gerada. Após o processamento, a API responde com o status da tarefa e os dados de saída.