المواصفات التقنية لـ GLM-5-Turbo
| العنصر | GLM-5-Turbo (تقديري / إصدار مبكّر) |
|---|---|
| عائلة النموذج | GLM-5 (إصدار Turbo – مُحسّن لخفض الكمون) |
| المزوّد | Zhipu AI (Z.ai) |
| البنية المعمارية | مزيج الخبراء (MoE) مع انتباه متناثر |
| أنواع المُدخلات | نص |
| أنواع المخرجات | نص |
| نافذة السياق | ~200,000 رموز |
| الحد الأقصى لرموز الإخراج | حتى ~128,000 (تقارير مبكرة) |
| التركيز الأساسي | سير عمل الوكلاء، استخدام الأدوات، استدلال سريع |
| حالة الإصدار | تجريبي / مغلق المصدر جزئيًا |
ما هو GLM-5-Turbo
GLM-5-Turbo هو إصدار مُحسّن للكمون من عائلة نماذج GLM-5، مصمم تحديدًا لـ سير عمل الوكلاء بمستوى الإنتاج والتطبيقات الفورية. يستند إلى بنية MoE واسعة النطاق في GLM-5 (~745B معاملات) ويحوّل التركيز نحو السرعة، والاستجابة، وموثوقية تنسيق الأدوات بدلًا من أقصى عمق في الاستدلال.
على خلاف GLM-5 الأساسي (الذي يستهدف الاستدلال على مستوى الريادة ومعايير الترميز)، فإن إصدار Turbo مضبوط لـ الأنظمة التفاعلية، وخطوط أتمتة العمل، وتنفيذ الأدوات متعدد المراحل.
الميزات الرئيسية لـ GLM-5-Turbo
- استدلال منخفض الكمون: مُحسّن لأزمنة استجابة أسرع مقارنةً بـ GLM-5 القياسي، مما يجعله مناسبًا للتطبيقات الفورية.
- تدريب موجّه للوكلاء: مُصمّم حول استخدام الأدوات وسير العمل متعدد المراحل منذ مرحلة التدريب، وليس مجرد تحسين لاحق للتدريب.
- نافذة سياق كبيرة (200K): يتعامل مع المستندات الطويلة، ومستودعات الشيفرة، وسلاسل الاستدلال متعددة المراحل في جلسة واحدة.
- موثوقية عالية في استدعاء الأدوات: تحسين تنفيذ الدوال وربط سير العمل لأنظمة الوكلاء.
- بنية MoE فعّالة: تُفعّل فقط مجموعة فرعية من المعاملات لكل رمز، ما يوازن بين التكلفة والأداء.
- تصميم موجّه للإنتاج: يُعطي الأولوية للاستقرار ومعدل الإنتاجية على حساب أقصى درجات المعايير القياسية.
المعايير القياسية ورؤى الأداء
رغم أن المعايير الخاصة بـ GLM-5-Turbo غير مكشوفة بالكامل، فإنه يرث خصائص الأداء من GLM-5:
- ~77.8% على SWE-bench Verified (GLM-5 الأساسي)
- أداء قوي في الترميز المعتمد على الوكلاء والمهام بعيدة المدى
- تنافسي مقارنةً بنماذج مثل Claude Opus وأنظمة فئة GPT في الاستدلال والترميز
👉 يتنازل Turbo عن بعض دقة الذروة مقابل استدلال أسرع وقابلية استخدام أفضل في الوقت الحقيقي.
GLM-5-Turbo مقارنةً بالنماذج المماثلة
| النموذج | نقاط القوة | نقاط الضعف | أفضل حالة استخدام |
|---|---|---|---|
| GLM-5-Turbo | سريع، موجّه للوكلاء، سياق طويل | استدلال ذروي أقل مقارنةً بالرائد | وكلاء الوقت الحقيقي، الأتمتة |
| GLM-5 (الأساسي) | استدلال قوي، معايير مرتفعة | استدلال أبطأ | بحث، ترميز معقّد |
| نماذج فئة GPT-5 | استدلال من الدرجة الأولى، متعدد الوسائط | تكلفة أعلى، مغلق | ذكاء اصطناعي بمستوى المؤسسات |
| Claude Opus (الأحدث) | استدلال موثوق، أمان | أبطأ في حلقات الوكلاء | استدلال مطوّل |
أفضل حالات الاستخدام
- وكلاء الذكاء الاصطناعي وخطوط أتمتة العمل (سير عمل متعدد المراحل)
- أنظمة الدردشة في الوقت الحقيقي التي تتطلب كمونًا منخفضًا
- تطبيقات مدمجة بالأدوات (APIs، الاسترجاع، استدعاءات الدوال)
- مساعدو المطورين مع حلقات تغذية راجعة سريعة
- تطبيقات السياق الطويل مثل تحليل المستندات
كيفية الوصول إلى GLM-5 Turbo API
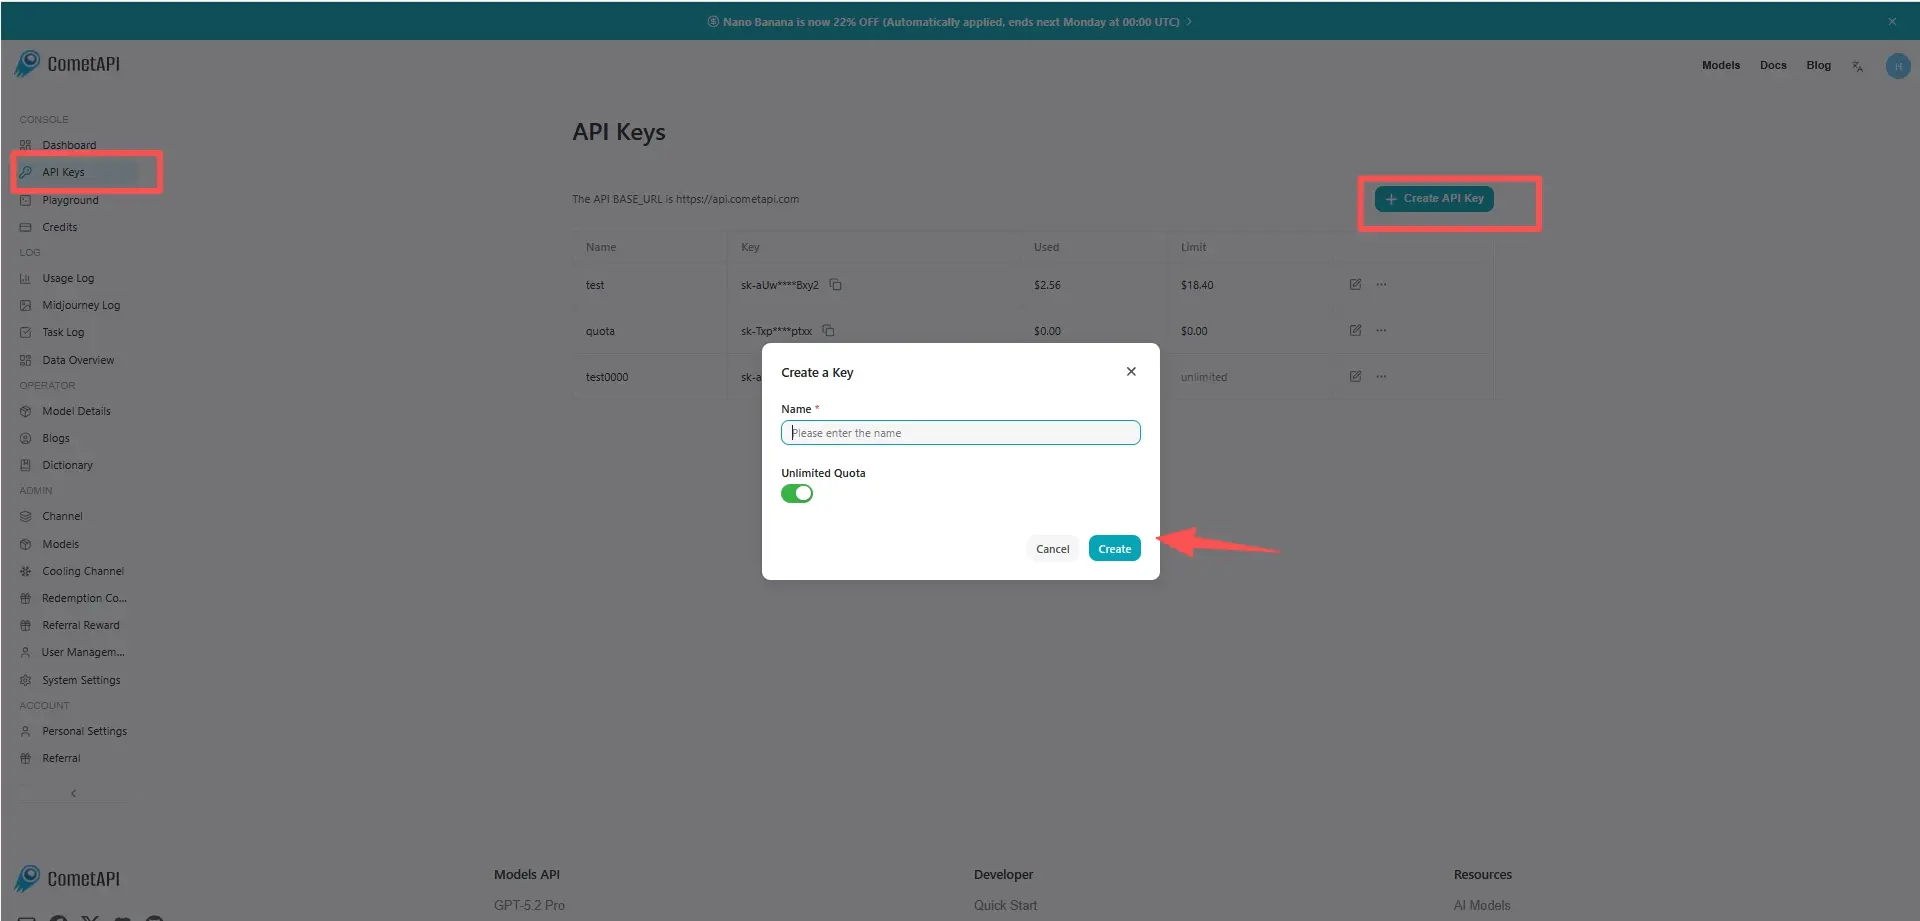
الخطوة 1: التسجيل للحصول على مفتاح API
سجّل الدخول إلى cometapi.com. إذا لم تكن مستخدمًا لدينا بعد، يُرجى التسجيل أولًا. سجّل الدخول إلى لوحة تحكم CometAPI. احصل على مفتاح API لاعتماد الوصول إلى الواجهة. انقر “Add Token” عند رمز API في المركز الشخصي، واحصل على مفتاح الرمز: sk-xxxxx ثم أرسِل.
الخطوة 2: إرسال الطلبات إلى GLM-5 Turbo API
اختر نقطة النهاية “glm-5-turbo” لإرسال طلب API واضبط جسم الطلب. يتم الحصول على طريقة الطلب وجسمه من وثائق API على موقعنا. يوفّر موقعنا أيضًا اختبار Apifox لراحتك. استبدل <YOUR_API_KEY> بمفتاح CometAPI الفعلي من حسابك. عنوان الأساس هو إكمالات الدردشة
أدرج سؤالك أو طلبك في حقل المحتوى—هذا ما سيرد عليه النموذج. عالج استجابة API للحصول على الإجابة المُولَّدة.
الخطوة 3: استرجاع النتائج والتحقق منها
عالج استجابة API للحصول على الإجابة المُولَّدة. بعد المعالجة، تستجيب API بحالة المهمة وبيانات الإخراج.