
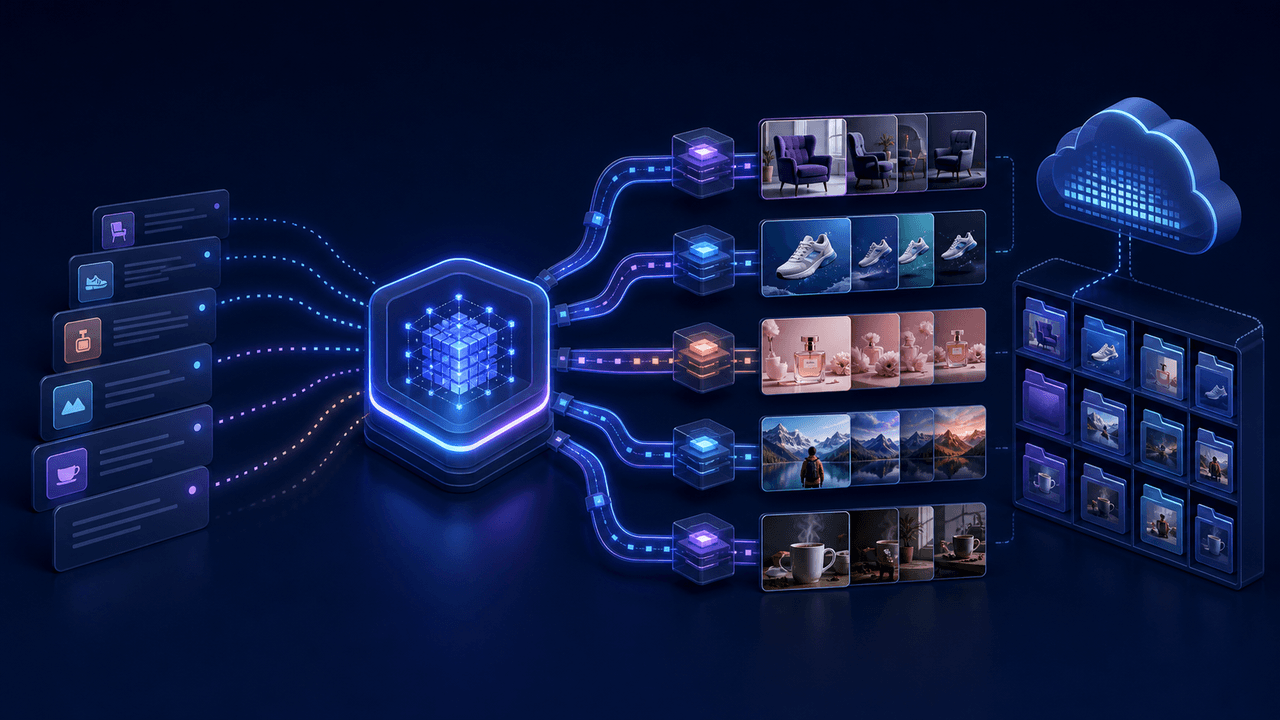
Den nemmeste måde at automatisere billedgenerering i stor skala uden at skulle håndtere flere forskellige API’er er at adskille arbejdsgangen fra modeludbyderen. Læg hver billedeanmodning i én kø, rout hver opgave til et aktuelt model-ID, og send kompatible anmodninger gennem én CometAPI-nøgle og den OpenAI-kompatible basis-URL https://api.cometapi.com/v1.
Denne vejledning bygger den pipeline i Python. Den accepterer produkt-, annonce- og indholdsopgaver fra en JSON Lines-kø; vælger en model; begrænser samtidighed; forsøger igen ved midlertidige fejl; gemmer enten URL- eller base64-baserede resultater; og registrerer forbrugsdata pr. opgave samt estimeret omkostning. Eksemplet samler disse produktionsnødvendigheder i én kompakt blok, så du kan teste arbejdsgangen uden at gøre artiklen til en kodereference.
Hvordan en samlet billed-API forenkler batchgenerering
Til sidst vil arbejdsgangen se sådan ud:
jobs.jsonl → bounded worker pool → CometAPI /v1/images/generations → object storage → manifest.jsonl
Kø- og lagringslaget forbliver dit. At skifte billedmodeller ændrer model-værdien, ikke autentificeringssystemet eller hovedruten for anmodninger. Det er den praktiske fordel ved en samlet billed-API: modelvalg bliver en routingbeslutning i én pipeline i stedet for en separat integration pr. udbyder.
Hvad skal der til for at automatisere billedgenerering?
Du skal bruge Python 3.10 eller nyere, pakken requests, en CometAPI-nøgle, en skrivbar outputplacering og mindst ét aktuelt billedmodel-ID.
Installer den eneste afhængighed:
pip install requests
Sæt din nøgle på serveren, aldrig i browserkode eller et repository:
export COMETAPI_KEY="your-key"
Basis-URL’en er https://api.cometapi.com/v1, og kompatible tekst-til-billede-opgaver bruger POST /images/generations. Før en udrulning bør du verificere hver model i den live modelkatalog; kataloget returnerer det aktuelle ID, understøttet endpoint, funktioner og prismetadata uden krav om en autorisationsheader.
Pr. 20. august 2026 listede det live katalog disse to nyttige ruter:
| Arbejdsopgave | Model-ID | Hvorfor den passer |
|---|---|---|
| Produktbilleder med kontrollerede outputindstillinger | gpt-image-2 | Returnerer forbrugsdata og base64-billedeindhold på den dokumenterede OpenAI-kompatible rute |
| Stort volumen af annonce- og indholdskoncepter | doubao-seedream-4-5-251128 | Bruger samme genereringsrute og er listet med pris pr. anmodning |
Tabellen er et udgangspunkt, ikke en påstand om, at modellerne har identiske kapaciteter. Størrelse, kvalitet, format, referencebillede-understøttelse og responsadfærd forbliver modelspecifik. Tjek modelposten og dens linkede dokumentation, før du sender valgfrie parametre.
Sådan bygger du en batch-arbejdsgang til billedgenerering i Python
1. Giv hver opgave et holdbart ID
Brug ét JSON-objekt pr. linje, så en kø, databaseeksport eller regnearksopgave kan fodre den samme worker:
{"id":"sku-1001","kind":"product","prompt":"Studio product photo of a ceramic coffee dripper on a warm neutral background"}
{"id":"campaign-204","kind":"ad","prompt":"Editorial summer travel image, vivid natural light, wide composition, no text"}
{"id":"blog-088","kind":"content","prompt":"Minimal illustration of a developer automating a creative workflow, no text"}
ID’et bliver outputfilnavnet og manifestnøglen. I produktion bruges det som idempotency key, og du springer ID’er over, der allerede er markeret som succesfulde, før du genbehandler en kø.
2. Routér efter opgavetype, og valider derefter mod det live katalog
Eksemplet mapper produktarbejde til gpt-image-2 og annonce- eller indholdsarbejde til doubao-seedream-4-5-251128. En opgave kan tilsidesætte det valg med sit eget model-felt. Ved opstart downloader workeren det offentlige katalog og afviser et ID, der ikke længere er listet.
Dette er sikrere end at hardkode en udbyderspecifik SDK gennem hele applikationen. Du kan ændre en rute i én mapping efter at have evalueret kvalitet, latenstid og pris for dine egne prompts.
3. Begræns samtidighed i stedet for at starte hele batchen
Workeren starter med fire samtidige anmodninger. Det tal er en konservativ applikationsindstilling, ikke en universel servicelimit. Mål latenstid og 429-svar for din konto, og hæv eller sænk MAX_WORKERS bevidst.
Kun 408, 429 og 5xx-svar forsøges igen med eksponentiel backoff og jitter. Autentificeringsfejl, ugyldige model-ID’er og ikke-understøttede parametre fejler straks, fordi gentagne forsøg med den samme ugyldige anmodning kun tilføjer forsinkelse.
4. Normalisér resultatet før lagring
Billedmodeller returnerer ikke altid den samme container. Den dokumenterede GPT Image-respons indeholder data[0].b64_json; andre kompatible modeller kan returnere data[0].url. Workeren håndterer begge, skriver billedet til en midlertidig fil og omdøber den først, når download eller dekodning er lykkedes.
I produktion bør du erstatte den lokale output/-mappe med S3, R2, GCS eller anden objektlagring. Behandl ikke en udbyderhostet URL som permanent lagring, medmindre dens opbevaringspolitik eksplicit siger det.
5. Registrér forbrug, forsøg og estimeret omkostning
Hvert resultat bliver en kompakt manifestrække med opgave-ID, model, gemt sti, status og estimeret USD-omkostning, når livekataloget leverer tilstrækkelige prisdata. Fejlede opgaver bevarer fejlen i stedet for at forsvinde fra batchen.
Komplet Python-script til batch-billedgenerering
Gem følgende som batch_image_pipeline.py, læg køen ved siden af som jobs.jsonl, og kør python3 batch_image_pipeline.py.
import base64, json, os, random, time
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
import requests

BASE_URL = "https://api.cometapi.com/v1"
KEY = os.environ["COMETAPI_KEY"]
WORKERS = int(os.getenv("MAX_WORKERS", "4"))
OUT = Path("output")
ROUTES = {
    "product": "gpt-image-2",
    "ad": "doubao-seedream-4-5-251128",
    "content": "doubao-seedream-4-5-251128",
}

catalog = requests.get("https://api.cometapi.com/api/models", timeout=30)
catalog.raise_for_status()
CATALOG = {model["id"]: model for model in catalog.json()["data"]}

def generate(job):
    model = job.get("model", ROUTES[job["kind"]])
    if model not in CATALOG:
        raise ValueError(f"Unknown model: {model}")
    payload = {"model": model, "prompt": job["prompt"], "n": 1}
    if model == "gpt-image-2":
        payload.update(quality="low", size="1024x1024", output_format="jpeg")

    for attempt in range(4):
        response = requests.post(
            f"{BASE_URL}/images/generations",
            headers={"Authorization": f"Bearer {KEY}"},
            json=payload,
            timeout=180,
        )
        if response.status_code not in {408, 429} and response.status_code < 500:
            break
        time.sleep(2**attempt + random.random())
    response.raise_for_status()
    body = response.json()
    item = body["data"][0]

    if item.get("b64_json"):
        data = base64.b64decode(item["b64_json"])
        extension = body.get("output_format", "png")
    else:
        download = requests.get(item["url"], timeout=120)
        download.raise_for_status()
        data = download.content
        extension = {"image/png": "png", "image/webp": "webp"}.get(
            download.headers.get("content-type"), "jpg"
        )
    path = OUT / f"{job['id']}.{extension}"
    path.write_bytes(data)

    price, usage = CATALOG[model].get("pricing") or {}, body.get("usage", {})
    cost = price.get("per_request")
    if cost is None and price.get("input") is not None:
        cost = (usage.get("input_tokens", 0) * price["input"] +
                usage.get("output_tokens", 0) * price["output"]) / 1_000_000
    return {"id": job["id"], "model": model, "path": str(path),
            "estimated_usd": cost * price.get("ratio", 1) if cost is not None else None}

def safe_generate(job):
    try:
        return {"status": "success", **generate(job)}
    except Exception as error:
        return {"id": job["id"], "status": "failed", "error": str(error)}

OUT.mkdir(exist_ok=True)
jobs = [json.loads(line) for line in Path("jobs.jsonl").read_text().splitlines() if line]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:
    results = list(pool.map(safe_generate, jobs))
with (OUT / "manifest.jsonl").open("w") as manifest:
    manifest.writelines(json.dumps(result) + "\n" for result in results)
Scriptet bruger det aktuelle katalog ved runtime, mens de to fallback-mappinger er eksempler, der blev verificeret den 20. august 2026. Tjek dem igen, før du publicerer eller udruller koden på en anden dato.
Sådan tester du arbejdsgangen for batch-billedgenerering
Start med én opgave og én worker:
MAX_WORKERS=1 python3 batch_image_pipeline.py
En succesfuld GPT Image-respons følger denne struktur:
{
  "created": 1776841943,
  "output_format": "jpeg",
  "quality": "low",
  "size": "1024x1024",
  "usage": {
    "input_tokens": 16,
    "output_tokens": 208,
    "total_tokens": 224
  },
  "data": [{"b64_json": "<base64-image-data>"}]
}
Workeren dekoder billedet, skriver output/<job-id>.jpeg, og tilføjer en succesrække til output/manifest.jsonl. Hvis en model returnerer en URL i stedet, downloader workeren den og gemmer den lokale sti i samme manifestformat.
Koden er syntakstjekket lokalt. Et live genereringskald kræver stadig din CometAPI-nøgle, så kør røgsignaltesten med én opgave, før du øger samtidigheden.
Hvor meget koster batch-billedgenerering?
Priser skal tidsstemples, fordi modelrater ændrer sig. Pr. 20. august 2026 returnerede det live CometAPI-modelkatalog følgende basisprisfelter og en 0.8-faktureringsratio:
gpt-image-2: $5 pr. 1M inputtokens og $30 pr. 1M outputtokens; anvendes den listede ratio, giver det effektive satser på $4 og $24 pr. 1M tokens.doubao-seedream-4-5-251128: $0.04 pr. anmodning; anvendes den listede ratio, giver det $0.032 pr. anmodning.
CometAPI’s prisguide forklarer tokenbaseret fakturering for modeller med officiel prissætning og kald-baseret fakturering for modeller prissat pr. anmodning. Scriptet læser kataloget, når det kører, og bruger den samme regel:
token cost = ratio × (input tokens × input rate + output tokens × output rate) / 1,000,000
request cost = ratio × per-request price
For eksempel rapporterer den dokumenterede GPT Image-respons ovenfor 16 inputtokens og 208 outputtokens. Ved brug af værdierne fra kataloget den 20. august estimeres det illustrative resultat til cirka $0.005056. Den reelle total ændrer sig med model, kvalitet, størrelse, prompt, genforsøg og responsens forbrug. Behandl API-responsen og kontobrugerfladens forbrugsdashboard som faktureringsgrundlag, ikke en fast antagelse pr. billede.
Budgettér også for ikke-succesfuldt arbejde. Et nyt forsøg efter en ubekræftet timeout kan producere et andet fakturerbart resultat, og et teknisk succesfuldt billede, der ikke består review, bruger stadig budget. Spor både API-omkostning og acceptgrad:
effective cost per accepted image = total batch spend / approved images
Almindelige fejl i billedgenererings-API’er og hvordan man løser dem
| Symptom | Sandsynlig årsag | Løsning |
|---|---|---|
| 401 | Manglende eller ugyldig nøgle | Tjek serverens COMETAPI_KEY |
| 400 | Ugyldig model eller ikke-understøttet option | Tjek det live katalog igen, og fjern modelspecifikke felter |
| 429 | For høj samtidighed | Sænk MAX_WORKERS og behold eksponentiel backoff |
| Gentagne 5xx | Midlertidig upstream-fejl | Forsøg igen med en grænse, flyt derefter opgaven til en dead-letter-kø |
| Intet gemt billede | Respons brugte en anden container | Inspicér data[0], og understøt både b64_json og url |
| Dobbelt forbrug | Opgaven blev afspillet efter en delvis fejl | Brug holdbare ID’er, og kvitter først efter, at lagring er lykkedes |
Forsøg ikke alle fejl igen. En permanent 400-anmodning forbliver ugyldig, mens en ubegrænset 429-retry-løkke kan forvandle en trafikspids til en backlog.
Best practices for produktionel billedgenerering i skala
Skift fra JSON Lines til en holdbar kø, når flere workers er involveret. Sæt en visibility-timeout, der er længere end den maksimale genereringstid, kvitter en opgave først efter, at billede og manifest er gemt, og send udtømte opgaver til en dead-letter-kø til gennemgang.
Hold valgfrie kontroller i modelspecifik konfiguration. En delt payload bør kun indeholde fælles felter som model, prompt og n: 1; tilføj quality, size eller output_format først efter, at den valgte modeldokumentation bekræfter dem. Hvis du tilføjer fallback-routing, vælg en model, der understøtter den samme opgave, og genopbyg payloaden til den model i stedet for blindt at gensende udbyderspecifikke options.
Opbevar API-nøglen i en secret manager, begræns promptinput, scan genererede aktiver i henhold til din politik, og hold udbyder-URL’er ude af langsigtede produktregistre. Log opgave-ID, model-ID, latenstid, forsøg, forbrug, lagringssti, reviewresultat og katalogets snapshotdato. Disse felter lader dig sammenligne modeller på omkostning pr. accepteret billede i stedet for blot listepriser.
Sæt endelig budgetværn: en maksimal batchstørrelse, en retry-grænse pr. opgave, en daglig forbrugsadvarsel og en stopbetingelse, når godkendelsesraten falder. At skalere en dårlig prompt hurtigere er ikke en optimering.
FAQ om automatisering af billedgenerering i skala
Hvad er den nemmeste måde at automatisere billedgenerering i skala uden at håndtere flere API’er?
Brug én kø og lagringsarbejdsgang, og send derefter kompatible billedanmodninger gennem én CometAPI-nøgle og https://api.cometapi.com/v1/images/generations. Skift model-ID i din routinglag i stedet for at vedligeholde separate autentificeringer og udbyder-SDK’er.
Kan jeg sende én anmodning og bede flere billedmodeller om at generere på én gang?
Eksemplet sender én model pr. opgave. Fan-out er en applikationsarbejdsgang: dupliker en opgave med forskellige ID’er og modelværdier, og sammenlign derefter de gemte output. Dette holder omkostning og reviewstatus attribuerbar til hver model.
Hvilken samtidighed bør jeg bruge?
Der findes ikke ét universelt tal for alle konti og modeller. Start med en lille begrænset pool som fire workers, overvåg latenstid og 429-svar, og justér på baggrund af evidens.
Skal jeg gemme den returnerede URL eller selve billedet?
Gem billedet i din egen objektlagring. En returneret URL kan være midlertidig, mens GPT Image-modeller kan returnere base64-indhold i stedet for en URL.
Hvordan vælger jeg den billigste model?
Beregn omkostning pr. accepteret billede, ikke kun pris pr. kald. Medtag token- eller anmodningsgebyrer, retries, mislykkede downloads, afviste aktiver, efterbehandling og menneskelig review. Tjek det live modelkatalog på den dag, du publicerer eller udruller.
Hvor bør jeg verificere endpoint og responsformat?
Brug CometAPI Quick Start, modelkatalogdokumentation, reference for billedgenerering og prisguide.