
TL;DR: Hvilket GPT-6 Astra API-alternativ bør du vælge?
Vælg modellen efter arbejdsbelastningen: Claude Opus 5 som den mest nærliggende premium-erstatning, Claude Fable 5.1 til den hårdeste vedvarende ræsonnering, GPT-5.6 Sol til OpenAI-migrering med lavest friktion, Claude Sonnet 5 til højvolumen-produktion, Gemini 3.8 Flash til lavpris multimodalt arbejde, og DeepSeek V4.1 Flash når tokenomkostning er den primære begrænsning.
Behold GPT-6 Astra til arbejdsbelastninger, hvor dets stærkere computerbrug, autonome eksekvering, videnskabelig ræsonnering eller cybersikkerhedspræstation materielt reducerer genforsøg og menneskelig indgriben.
Vigtigste pointer: Hvad betyder mest, når du erstatter GPT-6 Astra?
- GPT-6 Astra er svær at erstatte på sine stærkeste agentiske opgaver. Den officielle GPT-6 Astra-benchmarktabel registrerer 57.9% på Terminal-Bench 4.0, 97.6% på FrontierMath Tier 4 og 96.0% på GPQA Diamond.
- Claude Opus 5 er den mest balancerede direkte alternative kandidat at teste først. Anthropic prissætter Opus 5 til $5/$25 per million input-/output-tokens, halvdelen af Astras grundlæggende tokenrater.
- Claude Fable 5.1 er ikke et budgetalternativ. Dets $10/$50 input-/output-priser matcher Astras overskriftsrate, mens udvalgte videns- og langhorisont-ræsonneringsevalueringer favoriserer Fable 5.1.
- GPT-5.6 Sol er den letteste nedgradering frem for et egentligt platformsskifte. Kontekstvinduet på 1.05M, 128K maksimal output og $4/$20-priser reducerer migrationsfriktion for OpenAI-applikationer.
- Gemini 3.8 Flash tilbyder en stærk hostet pris/ydelses-case. Dens introduktionspris i 2026 er $0.75/$3.75 per million input-/output-tokens.
- DeepSeek V4 Flash er i en anden prisklasse. Dens officielle peak- og off-peak-rater ligger langt under premium-modellernes priser, men lavere tokenpris etablerer ikke tilsvarende agentsuccesrater.
- Den bedste produktionsmetric er som regel omkostning per accepteret fuldført opgave. Medtag genforsøg, værktøjsfejl, latenstid, output-tokenforbrug og menneskelig rework.
Hvad er GPT-6 Astra API?
OpenAI positionerer GPT-6 Astra som deres flagskibsmodel til komplekst end-to-end-arbejde. API-specifikationen inkluderer et 1,050,000-token kontekstvindue og 128,000-token maksimal output, input af tekst og billeder, reasoning-token support og fem indstillinger for reasoning-effort: low, medium, high, xhigh og max.
Astra adskiller sig fra en konventionel chatbot, fordi den er designet til langvarig eksekvering. Den officielle kapabilitetsoversigt fremhæver computerbrug og professionelt arbejde, sammen med software engineering, browsing, videnskab, cybersikkerhed og kompleks ræsonnering.
| GPT-6 Astra specification | Value |
|---|---|
| API model ID | gpt-6-astra |
| Provider | OpenAI |
| Context window | 1,050,000 tokens |
| Maximum output | 128,000 tokens |
| Input | Text, images |
| Output | Text |
| Knowledge cutoff | April 30, 2026 |
| Reasoning effort | Low, medium, high, xhigh, max |
| Standard input price | $10 / 1M tokens |
| Cached input | $1 / 1M tokens |
| Standard output price | $50 / 1M tokens |
| Long-context threshold | More than 272K input tokens |
Bemærkning om lang-kontekst-priser:
forespørgsler over 272K input-tokens
bliver omprissat for hele forespørgslen til $20/M input og $75/M output. Budgettér disse forespørgsler separat.
Hvorfor teams ser ud over GPT-6 Astra
Astra er mest overbevisende, når dens ekstra kapabilitet eliminerer mislykkede forsøg, værktøjsfejl, manuel indgriben eller gentagne kald til svagere modeller. Dens premiumpris er sværere at retfærdiggøre for summarisering, ekstraktion, klassificering, rutinemæssig RAG, almindelig chat og standard kodegenerering.
Teams evaluerer derfor alternativer for at reducere omkostninger, forblive inden for et eksisterende providermiljø, forbedre cache-økonomi, tilføje multimodal support eller bruge en hurtigere model til rutinetrafik, mens Astra reserveres til eskalation.
Benchmark-sammenligning og begrænsninger
Evidensnote: tabellen bruger OpenAIs offentliggjorte sammenligningsramme til at placere flere alternativer under en fælles opsætning. Disse leverandørrapporterede scores kan ændre sig med modelsnapshots, prompts, værktøjer og evalueringsmetodologi; brug dem til at shortlist’e kandidater og validér finalisterne på repræsentative produktionsopgaver.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
Resultaterne viser, hvorfor det er misvisende at kalde en hvilken som helst model en universel “Astra-erstatning”. Astra har et klart forspring på flere agentiske og videnskabelige evalueringer, mens Fable 5.1 klarer sig bedre på Humanity’s Last Exam, og flere alternativer ligger meget tæt på DeepSWE.
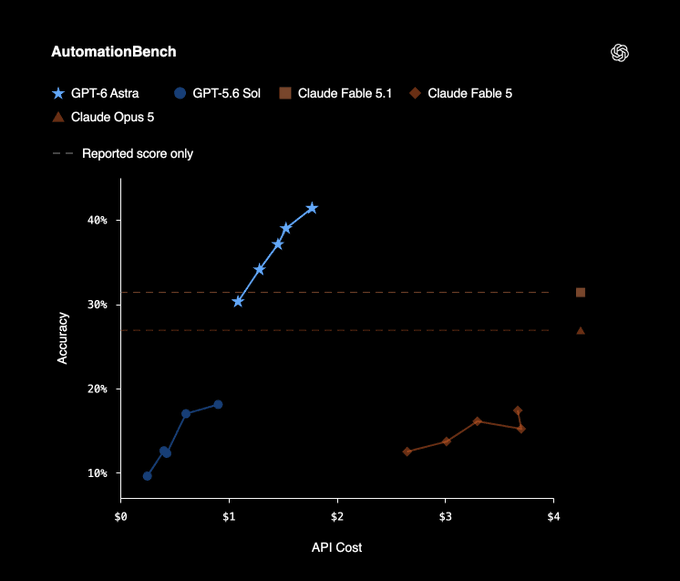
Officiel OpenAI AutomationBench-benchmarkgrafik.
Offentlige benchmarkindeks kan også ændre sig, efterhånden som metodologi og modelsnapshots revideres. Brug dem til at shortlist’e kandidater, ikke som en erstatning for arbejdsbelastningsspecifik evaluering.
GPT-6 Astra-alternativer
Ingen enkelt model erstatter Astra på tværs af alle arbejdsbelastninger. Det mest praktiske valg afhænger af den kapabilitet, du har brug for, det providermiljø du allerede bruger, og omkostningen ved mislykkede eller gentagne kørseler.
| Alternative | Official input / output price per 1M tokens | Context | Best reason to choose it |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Tætteste overordnede premium-erstatning |
| Claude Fable 5.1 | $10 / $50 | 1M | Hårdeste ræsonnering og langvarige agenter |
| GPT-5.6 Sol | $4 / $20 | 1.05M | OpenAI-migrering med lavest friktion |
| Claude Sonnet 5 | $2 / $10 | 1M | Produktion i høj volumen |
| Gemini 3.8 Flash | $0.75 / $3.75 promotional | 1M | Lavpris multimodalt og batch-arbejde |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Laveste tokenomkostning og højvolumenbehandling |
Claude Opus 5
Hvorfor overveje den
Claude Opus 5 er den første alternative kandidat at teste, når et produkt har brug for premium-ræsonnering, -kodning eller -præstation i professionelt arbejde til en lavere listepris end Astra.
Pris, kontekst og cache
Anthropic oplyser Claude Opus 5 til $5/M input og $25/M output med et kontekstvindue på 1M tokens. Bekræft de aktuelle cache-vilkår før produktionsbudgettering.
Hvor den klarer sig godt
Den er konkurrencedygtig inden for kodning, analyse, professionel skrivning og agent-workflows; den citerede benchmarktabel placerer den tæt på Astra på DeepSWE og FrontierCode.
Begrænsninger
Den overgår ikke konsekvent Astra. Astra forbliver den stærkere kandidat, når computerbetjening, avanceret autonom eksekvering, cybersikkerhed eller OpenAI-native værktøjer er centrale for produktet.
Bedst til / Undgå når
Bedst til: premium-kodingsagenter, kompleks analyse og professionel skrivning. Undgå når: workflowet er stærkt afhængigt af Astra-specifikke værktøjer eller computerbrugskapabiliteter.
Claude Fable 5.1
Hvorfor overveje den
Claude Fable 5.1 er et konkurrerende flagskib til den hårdeste ræsonnering, forskning, kodning og langvarige agentopgaver frem for en lavpris-erstatning.
Pris, kontekst og cache
Dens $10/M input- og $50/M outputrater matcher Astras overskriftspriser. Kontekstvinduet på 1M tokens og $0.25/M cache-read pris kan forbedre økonomien, når store prompts genbruges ofte.
Hvor den klarer sig godt
Den er særligt attraktiv til vedvarende ræsonnering og cache-tunge agenter; i den citerede sammenligning fører den Astra på Humanity’s Last Exam med værktøjer.
Begrænsninger
Den reducerer ikke overskrifts-tokenraten, og Astra bevarer fordele på flere agentiske og videnskabelige benchmarks samt OpenAI-native tooling.
Bedst til / Undgå når
Bedst til: maksimal ræsonneringskvalitet og gentagne langkontekst-workflows. Undgå når: det primære mål er en stor reduktion i standard tokenpriser.
GPT-5.6 Sol
Hvorfor overveje den
GPT-5.6 Sol tilbyder den migration med lavest friktion for applikationer, der allerede er bygget omkring OpenAI-kompatibel adfærd og tooling.
Pris, kontekst og cache
Den citerede modelspecifikation oplyser $4/M input og $20/M output, et kontekstvindue på 1.05M tokens og 128K maksimal output. Verificér aktuelle cachede input-vilkår før endelig budgettering.
Hvor den klarer sig godt
Den ligger tæt på Astra på DeepSWE og GPQA Diamond, mens den koster væsentligt mindre under standard kort-kontekst-intervallet.
Begrænsninger
Gabet øges på opgaver repræsenteret af Terminal-Bench og FrontierMath, så besparelser kan forsvinde, hvis svagere opgavefuldførelse skaber genforsøg eller manuel reparation.
Bedst til / Undgå når
Bedst til: eksisterende OpenAI-applikationer og generelle arbejdsbelastninger, der ikke kræver Astras stærkeste agentiske kapabiliteter. Undgå når: arbejdsbelastningen gentagne gange drager fordel af Astras store benchmarkgevinster.
Claude Sonnet 5
Hvorfor overveje den
Claude Sonnet 5 er en praktisk produktionsstandard for kompetent, gentageligt vidensarbejde, der ikke kræver et frontier-flagskib ved hver forespørgsel.
Pris, kontekst og cache
Dens permanente, citerede rate er $2/M input og $10/M output med et kontekstvindue på 1M tokens. Bekræft aktuelle cache-vilkår for deployments med tungt prompt-genbrug.
Hvor den klarer sig godt
Den passer til billetklassificering, dokumentekstraktion, standard RAG, indholdstransformation, kodeforklaring, rutinemæssige funktionskald og struktureret generering.
Begrænsninger
Den kan ikke pålideligt erstatte Astra på enhver langhorisont- eller frontier-ræsonneringsopgave.
Bedst til / Undgå når
Bedst til: højvolumen-produktionstrafik og rutinepræget forretningsautomatisering. Undgå når: fejl på en vanskelig agentisk opgave er dyrere end premiumprisen for en flagskibsmodel.
Gemini 3.8 Flash
Hvorfor overveje den
Gemini 3.8 Flash kombinerer multimodalt input, stor kontekst og lav hostet-API-omkostning til dokumenter, medier, kodning og batch-pipelines.
Pris, kontekst og cache
Den citerede introduktionspris er $0.75/M input og $3.75/M output frem til 31. december 2026, med et kontekstvindue på 1M tokens og rabatteret caching i kampagneperioden.
Hvor den klarer sig godt
Den egner sig til multimodal ekstraktion, PDF’er, lyd, video, billeder, store dokumentsamlinger, batchanalyse og omkostningsfølsomme kodningsarbejdsbelastninger.
Begrænsninger
Kampagnepriserne er tidsbegrænsede, og de sværeste autonome agent- eller computerbrugsopgaver kræver stadig arbejdsbelastningsspecifik validering mod Astra.
Bedst til / Undgå når
Bedst til: lavpris multimodalt og højvolumen batch-behandling. Undgå når: applikationen kræver den stærkeste autonome eksekvering uanset tokenomkostning.
DeepSeek V4.1 Flash
Hvorfor overveje den
DeepSeek V4.1 Flash er det omkostningsførste valg til høj-gennemløbs ræsonnering, kodning, summarisering, ekstraktion, klassificering og offline-behandling.
Pris, kontekst og cache
Den citerede peak- og off-peak-plan oplyser cache-hit input til $0.007–$0.014/M, cache-miss input til $0.22–$0.44/M og output til $0.66–$1.32/M, med et kontekstvindue på 1M tokens. Tjek den aktuelle V4.1-prisside før publicering.
Hvor den klarer sig godt
Den er attraktiv, når tokenomkostning dominerer, og applikationen kan bruge routing, validering eller offline kvalitetskontroller til at håndtere variabilitet.
Begrænsninger
En meget lavere tokenpris etablerer ikke tilsvarende autonom opgavesucces. Pålidelighed, værktøjsadfærd, latenstid og accept-rate skal måles på mål-arbejdsbelastningen.
Bedst til / Undgå når
Bedst til: storskala, omkostningsfølsom behandling med validering. Undgå når: en mislykket højværdi-autonom kørsel ville opveje tokenbesparelserne.
GPT-6 Astra vs. alternativer: Hvilken model vinder i hver kategori?
Ved at sammenholde pris, arkitektur, kontekst og benchmark-evidens fås en mere nyttig beslutningstabel end blot at rangere modeller fra første til sjette.
| Category | Best choice | Why |
|---|---|---|
| Overall Astra alternative | Claude Opus 5 | Stærk nær-frontier-ydelse til halve Astras listepris |
| Maximum reasoning | Claude Fable 5.1 | Flagskibs-ræsonnering og stærk langhorisont-ydelse |
| Stay inside OpenAI | GPT-5.6 Sol | Lignende API-økosystem med 60% lavere tokenpriser |
| High-volume production | Claude Sonnet 5 | Stærk kvalitet til $2/$10 |
| Multimodal price/performance | Gemini 3.8 Flash | 1M kontekst plus meget lav introduktionspris i 2026 |
| Lowest API cost | DeepSeek V4.1 Flash | $0.22–$0.44 input og $0.66–$1.32 output |
| Computer-use-heavy agents | GPT-6 Astra | En af Astras tydeligste differentieringspunkter |
| Scientific and difficult mathematical workflows | GPT-6 Astra | Meget stærke FrontierMath- og science-agent-resultater |
| Cache-heavy long agents | Claude Fable 5.1 | $0.25/M cache-reads |
Den vigtigste konklusion er, at GPT-6 Astra stadig vinder nogle kategorier. En artikel om alternativer bør ikke antyde, at en billigere model universelt erstatter den. Astra bliver dyr, når den bruges overalt; den kan stadig være økonomisk, når dens højere opgavefuldførelsesrate erstatter flere forsøg med svagere modeller.
Hvor meget kan du faktisk spare ved at erstatte GPT-6 Astra API?
Overvej en arbejdsbelastning, der forbruger 1 million ikke-cachede input-tokens og 200,000 output-tokens. Uden at medregne cache-rabatter, værktøjsgebyrer, genforsøg, batchpriser og lang-kontekst-tillæg:
| Model | Approximate API cost |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Gemini 3.8 Flash promotional rate | $1.50 |
| DeepSeek V4.1 Flash off-peak | $0.35 |
Den grundlæggende beregning er:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Dette enkle eksempel demonstrerer også, hvorfor tokenpriser ikke kan være den eneste metric. Hvis en $20 Astra-forespørgsel lykkes én gang, mens en $4-model kræver seks forsøg, flere værktøjsgenkald og menneskelig reparation, var Astra faktisk billigere.
En bedre produktionsmetric er:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Spor dette tal sammen med latenstid, opgavesucces, genforsøgsrate, værktøjskaldsfejl og eskalerings-til-menneske-rate.
Hvordan kan du teste GPT-6 Astra-alternativer via CometAPI?
En praktisk fordel ved et multimodel-API-lag er, at evaluering ikke behøver at blive et providerintegrationsprojekt. CometAPI leverer GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash og DeepSeek V4.1 Flash gennem én modelkatalog.
Med en OpenAI-kompatibel klient kan modellen gøres konfigurerbar frem for hardkodet:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Du kan køre det samme evalueringssæt igen ved at bruge model-ID’er såsom:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Dette er generelt mere informativt end at vælge et alternativ udelukkende ud fra en benchmark-leaderboard. Tag 100–500 repræsentative produktionsprompter, og registrér opgavesucces, menneskelig accept, genforsøg, værktøjsfejl, samlede tokens, latenstid og samlede API-omkostninger.
Bør du erstatte GPT-6 Astra med én model eller bruge modelrouting?
For mange applikationer er det forkert optimering at erstatte Astra med én universel model. En mere effektiv arkitektur ser sådan ud:
- Routine-trafik → Claude Sonnet 5, Gemini 3.8 Flash eller DeepSeek V4.1 Flash
- Svær ræsonnering → Claude Opus 5 eller GPT-5.6 Sol
- Meget svære langhorisont-opgaver → Claude Fable 5.1 eller GPT-6 Astra
- Computerbrug eller Astra-specifikke agent-workflows → GPT-6 Astra
Dette gør Astra til en eskalationsmodel frem for standardmodellen. Hvis kun 10% af forespørgslerne reelt kræver frontier-agent-ydelse, betyder routing af 100% af trafikken gennem Astra, at man betaler dens premium for de andre 90% også.
Hvilket GPT-6 Astra API-alternativ bør du vælge?
Vælg Claude Opus 5 hvis du vil have den tætteste overordnede balance mellem kvalitet og pris.
Vælg Claude Fable 5.1 hvis maksimal ræsonnering er vigtigere end at reducere overskrifts-tokenrater.
Vælg GPT-5.6 Sol hvis du allerede bruger OpenAI og vil have den mindste integrationsændring.
Vælg Claude Sonnet 5 hvis størstedelen af din produktionstrafik er kompetent men ordinært vidensarbejde.
Vælg Gemini 3.8 Flash hvis multimodalitet, skala og lav hostet-API-omkostning er vigtige.
Vælg DeepSeek V4.1 Flash hvis tokenomkostning er den dominerende begrænsning, og din arbejdsbelastning kan tåle mere evaluering og validering.
Og vælg GPT-6 Astra selv når din applikation reelt drager fordel af stærkere computerbrug, vanskelig autonom softwarearbejde, videnskabelig ræsonnering eller andre agentiske kapabiliteter.
Den største fejl er ikke at vælge den “forkerte” frontier-model. Det er at betale frontier-modelpriser for forespørgsler, der aldrig havde brug for en frontier-model til at begynde med.
FAQ
Hvad er det bedste overordnede alternativ til GPT-6 Astra API?
Claude Opus 5 er en af de stærkeste generalpurpose-erstatninger. Den tilbyder et 1M kontekstvindue, stærke kodnings- og agentkapabiliteter og $5/$25 listepriser—halvdelen af Astras standard tokenrater.
Hvad er det billigste GPT-6 Astra-alternativ?
Blandt de modeller, der er dækket her, har DeepSeek V4.1 Flash den laveste førsteparts tokenpris. Dens nuværende off-peak-rate er $0.22/M ikke-cachet input og $0.66/M output. Man bør dog ikke antage, at den matcher Astras autonome opgavesucces alene fordi den er billigere.
Er Claude Fable 5.1 bedre end GPT-6 Astra?
Ingen af modellerne vinder hver arbejdsbelastning. OpenAIs sammenligning giver Astra betydelige fordele på FrontierMath Tier 4 og Terminal-Bench 4.0, mens Fable 5.1 scorer højere på Humanity’s Last Exam med værktøjer.
Er GPT-5.6 Sol stadig værd at bruge efter GPT-6 Astra?
Ja. Dens $4/$20 standard API-priser ligger væsentligt under Astras $10/$50, mens den bevarer et 1.05M kontekstvindue. Den kan derfor være et bedre standardvalg til arbejdsbelastninger, hvor Astras gevinster ikke materielt forbedrer opgavefuldførelse.
Er Gemini 3.8 Flash god nok til at erstatte GPT-6 Astra?
For nogle kodnings-, multimodale, dokument- og batch-behandlingsarbejdsbelastninger, ja. Den er dramatisk billigere og har et 1M kontekstvindue. Til de sværeste autonome agent- og computerbrugsopgaver forbliver Astra det stærkere valg.
Har GPT-6 Astra en prisulempe for meget lange prompts?
Ja. OpenAI anvender et højere prisniveau, når input overstiger 272K tokens, så lang-kontekst-forespørgsler bør budgetteres separat.
Bør jeg sammenligne modeller med tokenpris eller benchmark-scores?
Brug begge kun som screeningsmetrics. Den produktionsmetric, der oftest betyder mest, er omkostning per accepteret fuldført opgave, inklusive reasoning-tokens, genforsøg, værktøjskald, latenstid og menneskelig rework.
Kan jeg bruge flere GPT-6 Astra-alternativer i den samme applikation?
Ja. I mange applikationer er modelrouting at foretrække frem for at binde hver forespørgsel til én model. En lavpris-model kan håndtere rutineforespørgsler, mens stærkere modeller håndterer stigende sværhedsgrader ved eskalation.
