Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Claude Haiku 5.5 vs GPT-6 Luna: benchmarkresultater, priser, hastighed
Sammenlign Claude Haiku 5.5 og GPT-6 Luna på benchmark-resultater, API-prissætning, logisk ræsonnement, kodning, hastighed og agent-ydeevne. Find ud af, hvilken AI-model der vinder.
Claude Haiku 5.5 og GPT-6 Luna er lavpris-ræsonneringsmodeller til API-arbejdsbelastninger i stor skala. Begge starter ved $0.10 pr. million inputtokens og $0.50 pr. million outputtokens. Haiku scorer højere på de seks sammenligninger, der er offentliggjort i Anthropics lanceringsmateriale. Luna bevarer sine basistakster for prompts op til 272K inputtokens, sammenlignet med Haikus 100K-tærskel. For udviklere er de vigtigste mål akceptsats, end-to-end-latens, API-kompatibilitet og omkostning pr. accepteret resultat—den samlede omkostning af alle forsøg divideret med antallet af outputs, der består foruddefinerede tjek.
Key Takeaways
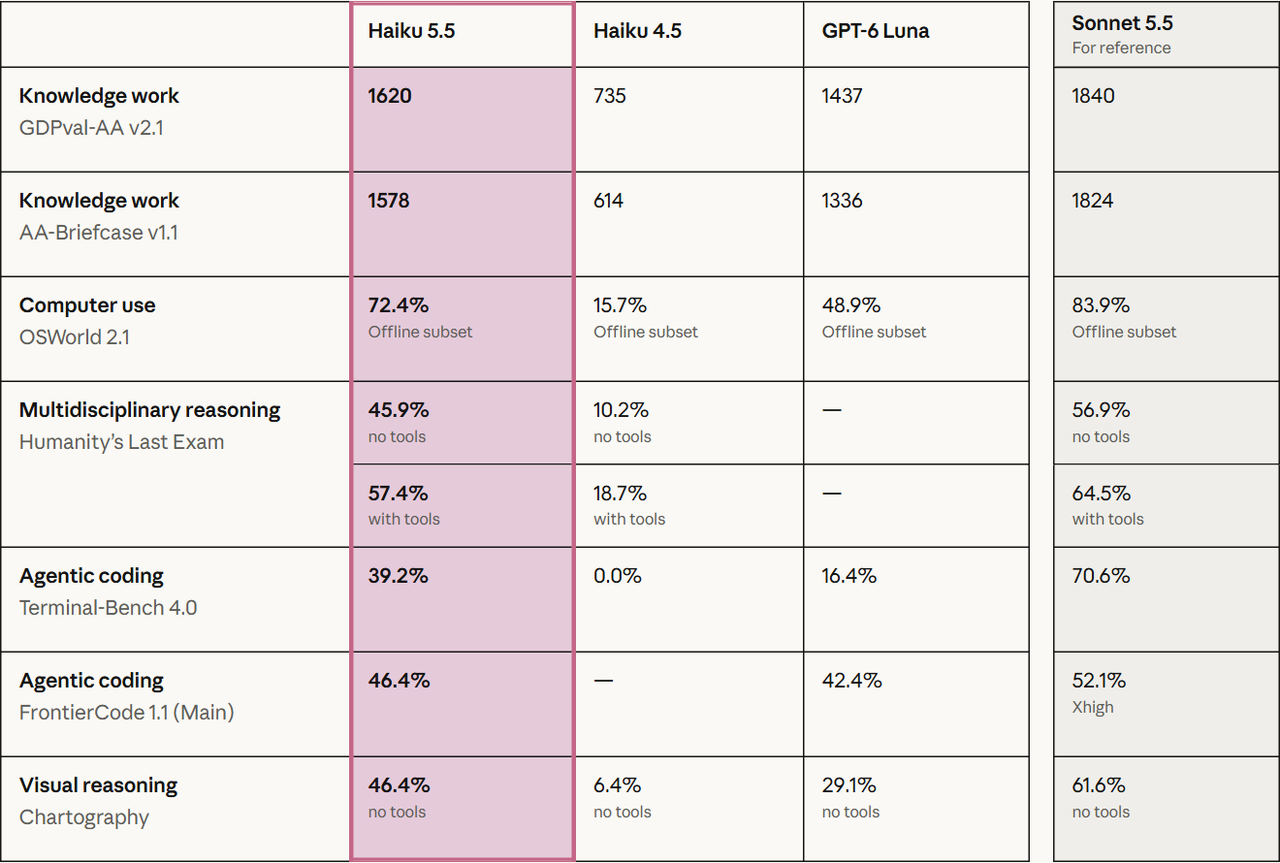
Haiku 5.5 fører den citerede OSWorld 2.1-computerbrugs-sammenligning, 72.4% mod Lunas 48.9%.
På Terminal-Bench 4.0 er de citerede resultater 39.2% for Haiku og 16.4% for Luna.
Begge starter med identiske kortkontekstpriser, men Haikus højere pristrin begynder efter 100K prompttokens, mod Lunas 272K-tærskel.
Artificial Analysis’ max-effort-modelsider, kontrolleret 9. oktober 2026, viser outputhastigheder på 240.6 tokens/s for Haiku og 123.0 tokens/s for Luna; gennemstrømning udelukker ventetid til første token.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Start med Haiku til computerbrug og terminalopgaver, som afspejles i de delte benchmarks; overvej Luna til store prompts. Behold din nuværende model, indtil et repræsentativt pilotforløb demonstrerer en nyttig forbedring.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 blev lanceret den 7. oktober 2026. Den kombinerer billig inferens med justerbar ræsonnering, værktøjsbrug, lang kontekst samt tekst- og billedinput. Typiske anvendelser omfatter dokumentekstraktion, databaseforespørgsler, kundesupport og letvægts-subagenter.
GPT-6 Luna: Overview
GPT-6 Luna blev lanceret den 22. september 2026. Den er positioneret til fokuserede opgaver i skala, herunder klassificering, informationsudtræk, struktureret output, programmeringsassistance og behandling af lang dokumentation. Dens fleksible ræsonneringsindstillinger inkluderer en uden-ræsonnering-konfiguration til enklere arbejde.
De seks rækker ovenfor gengiver Anthropics offentliggjorte lancerings-sammenligningsresultater, kontrolleret 9. oktober 2026. De er sammenligninger offentliggjort af Anthropic, inklusive uafhængige resultater, der er gengivet dér, snarere end nye tests kørt til denne artikel. GDPval-AA og AA-Briefcase er Elo-scorer; procentuelle forskelle er procentpoint. Disse benchmarkfamilier måler forskellige opgaver og bør ikke gennemsnitsberegnes til en universel vinder.
Haikus stærkeste relative resultater i denne lanceringstabel fremstår i visuel computerinteraktion og terminalbaserede opgaver. Dets mindre føring i FrontierCode advarer mod at ekstrapolere et 20-points gab til alle kodningssituationer. Brug disse resultater til at vælge pilotkandidater, og valider derefter dine prompts og værktøjsstak.
Reasoning Effort and Evaluation Limits
Ræsonneringsindsats ændrer nøjagtighed–omkostnings-afvejningen. Sammenlign tilgængelige indstillinger med den samme arbejdsbyrde og det samme testharness; enslydende leverandørnavne garanterer ikke ens ræsonnerings-tokenbudgetter. Lanceringstabellen rapporterer OSWorlds offline delmængde og Chartography uden værktøjer. Harness, opgavevalg, retries og værktøjsadgang kan ændre udfald. Anthropics systemkort dokumenterer benchmarkspecifikke betingelser. Read the benchmark methods in Anthropic's system card.
OSWorld bruger offline-undergruppen med 82 opgaver, en Ubuntu-virtuel maskine, 1080p-skærmbilleder, en grænse på 500 handlinger, maksimal indsats og fem forsøg pr. opgave. Sammenligningen 72.4%/48.9% er delvis kreditering, ikke andelen af opgaver, der er løst perfekt; Haikus strenge beståelsesrate er 37.1%. Anthropic kørte Luna på den samme opgaveundergruppe via OpenAIs API.
Terminal-Bench bruger 66 containeriserede opgaver; Haiku kørte med maksimal indsats i Claude Code bare mode, uden internetudgående trafik eller en fallback-model, i gennemsnit ti forsøg pr. opgave.
FrontierCode Main indeholder 100 opgaver med fem kørsler pr. opgave; Claude-modeller brugte Claude Code, og GPT-modeller brugte Codex.
GDPval-AA og AA-Briefcase blev uafhængigt evalueret af Artificial Analysis og gengivet i lanceringsmaterialet. Det er separate evalueringspipelines, ikke én delt produktionsharness.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Haikus stærkeste fordel er i de delte lanceringstests, der kræver interaktion med en grafisk computer eller arbejde i en terminal. OSWorlds delscore-gab er 23.5 procentpoint, mens Terminal-Bench adskiller sig med 22.8 point. FrontierCodes mindre forskel på 4.0 point viser, hvorfor den bredere kategorien “kodning” ikke bør behandles som én enkelt arbejdsbelastning.
Til browserautomatisering: test sidenavigation, formularudfyldning, genopretning fra værktøjsfejl og end-to-end-fuldførelse. For kodning: test om en patch består jeres repositories funktionskontroller og holder sig inden for scope. Disse accepttjek er mere nyttige end at vælge en model ud fra den største overskriftforskel.
Long Context and Document Processing
Forskellen på 5% i den nominelle kontekstkapacitet er mindre vigtig end pålideligheden og prisen ved at behandle store prompts. Ingen af modellerne er i sig selv bedre til at hente information, blot fordi kontekstvinduet er større.
Den afgørende forskel er, hvornår højere takster gælder: en prompt på 150K tokens krydser Haikus tærskel, men forbliver inden for Lunas basistrin. Luna er derfor det billigere udgangspunkt for den tokenarbejdsbyrde. Om den er den bedre dokumentanalytiker afhænger stadig af udtræksnøjagtighed, citater og de retries, der kræves for at opnå et acceptabelt svar.
Reasoning Controls
Begge modeller eksponerer justerbar ræsonneringsindsats, med medium som standard i den citerede dokumentation. Luna eksponerer også en none-indstilling. Brug disse kontroller til at passe opgaven: udtræk og routing kan kræve mindre ræsonnering end et usikkert flertrins værktøjsworkflow. Den samme indsatslabel indebærer ikke det samme compute-budget på tværs af leverandører.
Multimodal Input and Structured Workflows
Begge accepterer tekst og billeder og producerer tekst. Det gør dem til kandidater til skærmbilleder, dokumentbillede-udtræk og strukturerede downstream-arbejdsgange. Deres inputunderstøttelse i sig selv etablerer ikke ens nøjagtighed på lille tekst, diagrammer eller visuelle grænseflader; mål disse tilfælde separat.
Speed and Task Economics
Independent metric (max effort)
Haiku 5.5 — Artificial Analysis
GPT-6 Luna — Artificial Analysis
Intelligence Index v4.3.2
43
38
Output speed
240.6 tokens/s
123.0 tokens/s
Weighted cost per Intelligence Index task
$0.21
$0.07
Artificial Analysis er den uafhængige testudgiver. Tabellen er et øjebliksbillede af deres max-effort-modelsider kontrolleret 9. oktober 2026, frem for officiel leverandørperformance. Outputhastighed måler tokens modtaget efter, at genereringen begynder; den er adskilt fra tid til første token og den fulde opgavelatens. Omkostning pr. opgave er en vægtet Intelligence Index-metrik, ikke et tilbud for din produktion eller en omkostning pr. succesfuldt udfald.
Haikus øjebliksbillede af outputgennemstrømning er cirka 1.96 gange Lunas, mens Lunas vægtede evalueringsopgave-omkostning er lavere. Dette etablerer ikke en 1.96-dobbel fordel i fuld opgavefærdiggørelsestid. Produktionstest bør registrere tid til første token, færdiggørelsestid, outputlængde, ræsonneringsforbrug og værktøjseksekveringstid separat.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
USD per 1M tokens
Haiku ≤100K
Haiku >100K
Luna ≤272K
Luna >272K
Input
$0.10
$0.50
$0.10
$0.20
Cached read
$0.01
$0.05
$0.01
$0.02
Cache write (Haiku: 5-minute TTL)
$0.125
$0.625
$0.125
$0.25
Output
$0.50
$2.50
$0.50
$0.75
USD pr. million tokens ved standard behandlingstakster, kontrolleret 9. oktober 2026. Tabellen bruger Haikus standard- og 5-minutters cache-skrivningssatser og Lunas kort- og langkontekstsatser. Værktøjsgebyrer, skatter, regionale tillæg og valgfrie justeringer af behandlingsniveau er udeladt. Over inputtærsklen gælder de højere satser for anmodningen frem for kun de overskydende tokens.
Haiku tilbyder også cache-skrivninger på 1 time til $0.20/$1.00 pr. million tokens for korte/lange prompts. Cachepersistens og prismekanismer adskiller sig mellem leverandører, så sammenlign genbrugs mønstre frem for at betragte begge cache-skrivningsrækker som identiske produkter. Haikus 128K-outputgrænse er standard API-grænsen; dets Message Batches API kan understøtte 300K output med et beta-header.
Illustrative Costs at Fixed Token Budgets
Workload
Input / Output
Haiku 5.5
GPT-6 Luna
Ticket classification
2K / 200
$0.0003
$0.0003
Short report
40K / 4K
$0.006
$0.006
Repository analysis
150K / 5K
$0.0875
$0.0175
Large document review
300K / 10K
$0.175
$0.0675
Massive context analysis
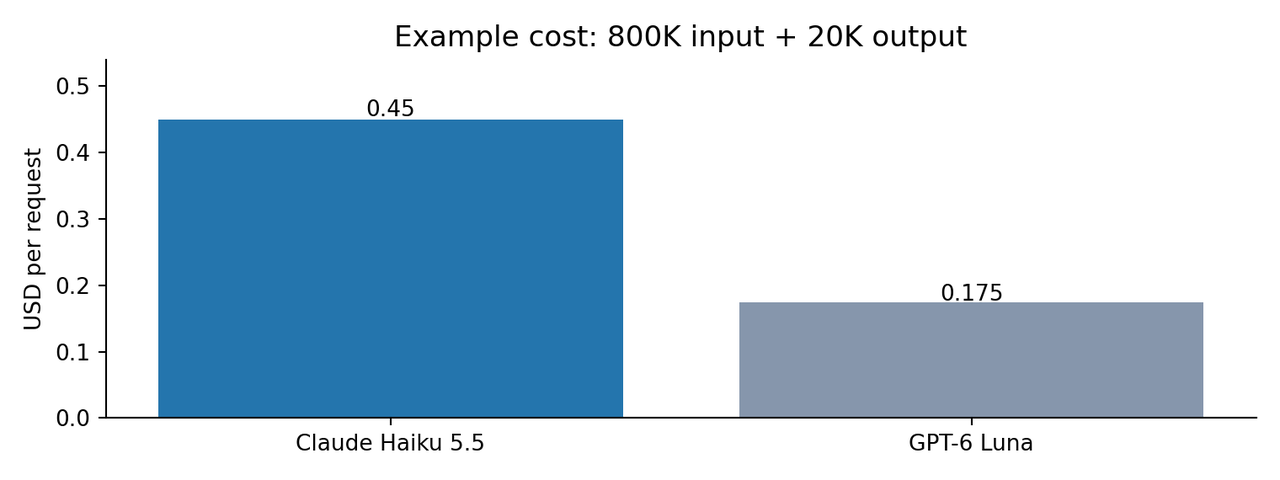
800K / 20K
$0.45
$0.175
Forfatterberegnet ikke-cachet standardprisestimat: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Output” betyder samlet faktureret output for dette estimat, inklusive ræsonneringstokens, hvor der opkræves som output; det er ikke nødvendigvis synlig svarlængde. De samme rapporterede tokentællinger bruges for begge modeller, selv om tokenizers kan variere.
En billig token er ikke nødvendigvis et billigt succesfuldt udfald. Teams bør indregne gentagne forsøg, mislykkede værktøjskald, forbrug af ræsonneringstokens og forskellig tokenizer-adfærd.
CometAPI Access and Integration Constraints
CometAPI leverer adgangsmuligheder for begge modeller. Før du sammenligner eller deployer dem via gatewayen, verificér model-ID’er, understøttede endpoints, forespørgselsparametre, værktøjsadfærd og faktureringsregler for hver rute. Disse leverandørlinks dokumenterer adgangsmuligheder; de erstatter ikke leverandørernes tekniske eller standardprissætningskilder.
For direkte OpenAI-integrationer understøtter Luna indbyggede værktøjer via Responses API; Chat Completions function calling kræver none-ræsonneringsindsats. Haiku bruger Anthropics Messages API og adaptiv tænkning. En gateway gør ikke de underliggende skemaer udskiftelige: valider værktøjsdefinitioner, struktureret-output-adfærd, streaming-hændelser og afregning med præcis den rute, du agter at bruge.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
En praktisk sammenligning kan bruge et leverandør-kontraktbundt, der indeholder ikrafttrædelsesdatoer, fornyelsesvilkår, varslingsperioder og undtagelser. Hold dokumentbundtet, udtræksinstruktionerne, forventede felter og valideringsregler identiske. Det følgende er et evalueringsdesign, ikke et nyt målt modelresultat.
Eksempelprompt: Ekstrahér hver kontrakts leverandørnavn, ikrafttrædelsesdato, fornyelsesdato, opsigelsesvarsel og prisundtagelser. For hver udtrukket værdi skal du anføre dokumenttitel og den præcise understøttende passage. Returner null, når et felt mangler; udled ikke manglende datoer. Marker modstridende klausuler og hold det endelige svar inden for 1,000 ord.
Check
Acceptance criterion
What to record
Extraction accuracy
Required fields match an independently checked answer key
Korrekte, forkerte og manglende værdier
Grounding
Every non-null field has a valid supporting passage
Uunderstøttede påstande og forkerte dokumenthenvisninger
Instruction following
No invented dates; absent fields return null
Skemafejl og brud på begrænsninger
Economics
Calculate spend per accepted extraction
Faktureret input, output, ræsonnering, retries og fallback-omkostning
Latency
Compare full job completion under the same tool policy
Tid til første token og end-to-end-tid
Kør mere end ét repræsentativt bundt og gentag de tilfælde, hvor resultaterne varierer. Begynd med det samme tilgængelige indsatsniveau, og test derefter en billigere konfiguration for hver model. Rapportér stikprøvestørrelse, indstillinger, rute, dato og antal fejl, før du præsenterer en vinder.
Identiske basissatser; sammenlign faktureret forbrug og retries
Prompts above 100K tokens
GPT-6 Luna on standard rates
Luna bevarer basistrin længere; nøjagtighed kan ændre samlede omkostninger
Streamed token throughput
Claude Haiku 5.5 in the dated snapshot
Gennemstrømning adskiller sig fra fuld færdiggørelseslatens
Simple repeated extraction
Test Luna with low or no reasoning
Vælg efter gyldigt accepteret output frem for pris alene
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
Start med Haiku, når din applikation minder om de offentliggjorte opgaver med grafisk computer, terminalkodning eller professionelt arbejde, og en højere fuldførelsesrate vil opveje ekstra forbrug af ræsonnering eller lang kontekst. Bekræft fordelen på din egen værktøjsstak, før du router produktionstrafik.
Choose GPT-6 Luna for Large-Prompt Cost Control
Start med Luna, når prompts ofte overstiger 100K tokens, og standard tokenomkostninger i væsentlig grad påvirker dit budget. Den er også en kandidat til gentaget udtræk eller routing, der kan lykkes med lav eller ingen ræsonnering. Hold anbefalingen betinget af accepteret-resultat-rater og faktisk fakturering.
Use Both When Workloads Have Different Needs
Et pilotforløb kan route langdokument-udtræk til Luna og GUI- eller terminalopgaver til Haiku, og derefter validere hvert valg mod accepttjek. Udløs en fallback, når et output fejler skemavalidering, mangler krævet evidens, eller fejler et opgavespecifikt tjek, og inkludér fallback-omkostninger og latens i sammenligningen.
Validate Before Switching
Medtag din nuværende model som baseline. Skift kun, når kandidaten opfylder et foruddefineret korrekthedsmål og forbedrer omkostning pr. accepteret resultat eller end-to-end-latens nok til at dække migration og vedligeholdelse. Sæt udrulning på pause, hvis kritiske værktøjsfejl stiger. Anbefalingen ændrer sig, hvis dit pilotforløb viser, at Lunas lavere sats opvejes af retries, eller at Haikus højere benchmark-scorer ikke forbedrer din opgavesucces.
Brug en repræsentativ arbejdsbyrdeprøve, og score korrekte, forkerte og ufuldstændige resultater.
Mål tid til første token, end-to-end-opgavetid og værktøjspålidelighed.
Spor input-, cachet-, output- og ræsonneringstokentællinger separat.
Beregn omkostning pr. succesfuldt resultat, inkl. retries og fallbacks.
Sammenlign medium og høj ræsonneringsindsats, før du aktiverer maksimum som standard.
Conclusion
Claude Haiku 5.5 har stærkere head-to-head-lanceringsbeviser på tværs af de professionelle arbejds-, computerbrugs- og agent-kodningsbenchmarks, der sammenlignes her. Den har også højere outputgennemstrømning i det uafhængige øjebliksbillede. GPT-6 Luna har en klar standardrate-fordel for prompts over Haikus 100K-tærskel og en lavere vægtet evalueringsopgave-omkostning. Ingen af observationerne bestemmer alene produktionspålidelighed eller omkostning pr. succesfuldt resultat.
Den praktiske vinder er den model, der leverer et acceptabelt resultat til den laveste fuldt målte driftsomkostning. Kør begge mod dine egne prompts, værktøjer og retry-regler i stedet for at betragte et enkelt benchmark som svaret.
FAQ
Why can task costs differ when both models have the same base token prices?
Den samme basipris betyder ikke den samme samlede regning. Modeller kan bruge forskellige mængder input-, output- og ræsonneringstokens og kan have brug for forskellige antal retries eller værktøjskald for at producere et acceptabelt resultat. Langkontekstsatser og cache-brug påvirker også totalen. Sammenlign den samlede omkostning af alle forsøg divideret med antallet af accepterede resultater, frem for tokenpriser alene.
Do higher long-context rates apply only to tokens above the threshold?
Nej. Under den standardprissætning, der er beskrevet i denne artikel, anvendes de højere satser på anmodningen, når inputtærsklen krydses—ikke kun på de overskydende tokens. For eksempel krydser en anmodning med 150K inputtokens Haikus 100K-tærskel, men forbliver inden for Lunas 272K basistrin. Brug de gældende input- og outputsatser for hele anmodningen, når du estimerer omkostninger.
Can Claude Haiku 5.5 and GPT-6 Luna share a prompt cache?
Antag ikke, at cache-poster overføres mellem modeller eller udbydere. Design separate genbrugsstrategier, og mål hitrater og faktureret forbrug på hver rute. Gateway-understøttelse, retention-regler og forespørgselsstruktur kan påvirke, om gentaget input er berettiget til caching; verificér disse, før du forudsiger besparelser.
What should a Haiku-to-Luna migration test cover?
Test repræsentative tekst- og billedinput, krævede strukturerede felter, værktøjsargumenter, streamede svar og fejlgenopretning. Etabler din nuværende systems akceptsats før migration, og sammenlign derefter begge kandidater under de samme retry- og værktøjspolitikker. Lignende tokenpriser eller modelkategorier etablerer ikke kompatibilitet.
Should benchmark scores drive a Haiku or Luna fallback?
Brug scorer til at vælge kandidater, og udløs derefter fallbacks ved observerede fejl såsom ugyldige værktøjsargumenter, manglende krævede felter eller uopfyldte opgavetjek. Spor fallback-frekvens og samlet faktureret omkostning. En anden model kan tilføje latens og udgift, så verificér, at den forbedrer accepterede udfald frem for blot at producere et andet svar.
Can sensitive data be routed through both APIs?
Gennemgå de præcise leverandører og gateway, der er involveret, deres aktuelle retention-indstillinger, behandlingslokationer, kontraktvilkår og din organisations datapolitik, før du sender følsomme input. Modelkapabilitet og pristabeller fastslår ikke en routes egnethed til regulerede eller fortrolige data. Brug den godkendte rute, når disse krav er afgørende.