

TL;DR
Claude Opus 5.5 er en stærk startkandidat, fordi den tilbyder markant lavere tokenpriser samtidig med, at den matcher eller overgår Fable 5.1 på flere offentliggjorte evalueringer, mens den opkræver $4 pr. million input-tokens og $20 pr. million output-tokens, sammenlignet med Fable 5.1 på henholdsvis $10 og $50.
Fable 5.1 har stadig en rolle, når en opgave er usædvanligt vanskelig, langvarig, dyr at gentage eller forventes at køre uden tæt supervision. Den praktiske regel er enkel: start med Opus 5.5, og eskaler kun, når repræsentative produktionstests viser, at Fable 5.1 reducerer fejl-, korrektions- eller genkørselsomkostninger nok til at retfærdiggøre sin premiumpris.
Claude Opus 5.5 vs Claude Fable 5.1 i korte træk
| Dimension | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Release date | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-to-Rust migration | 9.5 hours; 51% lower task cost | 12 hours; baseline task cost |
| Speed option | Fast mode, up to 2.5× normal speed | No equivalent launch mode |
| Effort starting point | Mellemniveau-orienteret | Høj |
| Best default use | Daglig frontier-kodning, agenter, overvåget produktion og API-trafik i stor volumen | Højst-værdifuldt, vanskeligt, langvarigt eller uovervåget autonomt arbejde |
| API access | Anthropic API and compatible providers including CometAPI | Anthropic API and compatible providers including CometAPI |
Læsenote: Benchmarktal er rapporteret af Anthropic og afhænger af indsatsniveau, harness, sikkerhedsforanstaltninger, task release, antal forsøg og standardfejl. De bør kun sammenlignes under matchede evalueringsbetingelser.
Vigtige pointer
- Opus 5.5’s standardpriser for input og output ligger 60% under Fable 5.1.
- Begge modeller understøtter et kontekstvindue på 1M tokens og op til 128K output, så pris, indsatsindstillinger og arbejdsbelastningspasform betyder mere end den nominelle kontekststørrelse.
- Anthropics offentliggjorte resultater favoriserer Opus 5.5 på mange kodnings- og agentiske evalueringer, men benchmarkindstillinger påvirker resultatet væsentligt.
- Uafhængig evaluering understøtter Opus 5.5’s frontier-position, men rapporterer andre absolutte scorer, hvilket understreger behovet for matchede tests.
- For de fleste overvågede produktionsopgaver er Opus 5.5 det stærkere udgangspunkt. Fable 5.1 er et eskalationstrin, ikke det automatiske standardvalg.
Hvad er Claude Opus 5.5?
Claude Opus 5.5 er Anthropics første Claude 5.5-model. Den er positioneret til agentisk kodning, langvarige agenter, professionelt vidensarbejde, virksomheds-workflows, finansiel analyse, vision og computerbrug.
Dens API-model-ID er claude-opus-5-5. Adaptiv tænkning er altid aktiveret, mens udviklere styrer ræsonneringsintensitet via indstillingerne low, medium, high, xhigh og max. Anthropic tilbyder også Fast mode, som kan køre med op til 2.5 gange normal hastighed for $8/M input og $40/M output.
Hvad er Claude Fable 5.1?
Claude Fable 5.1 er positioneret til krævende, langvarige projekter såsom fler-timers kodning, kompleks research, browserinteraktion, autonome agenter og workflows, der spænder over flere applikationer.
Dens API-model-ID er claude-fable-5-1. Den bruger adaptiv tænkning, starter fra et højere API-indsatsniveau og bør behandles som premium-valget, når den forventede omkostning ved fejl eller gentagne forsøg overstiger den ekstra inferensomkostning.
En forenklet læsning ville være, at Opus 5.5 tilbyder næsten samme ramme til 40% af Fables standard-tokenpris. Men det er netop her, en simpel specifikationstabel bliver misvisende.
Sammenligning af kode og benchmarks
Anthropic rapporterer Opus 5.5 foran Fable 5.1 på Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam med værktøjer, Terminal-Bench-Science, OSWorld 2.0 og Chartography.
Sådan læses benchmarkresultaterne
Anthropic rapporterer Opus 5.5 foran Fable 5.1 på Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam med værktøjer, Terminal-Bench-Science, OSWorld 2.0 og Chartography. Disse tal er evalueringsresultater, ikke konfigurationsuafhængige modelkonstanter.
De fleste Opus 5.5-overskriftsresultater brugte max-indsats, mens Terminal-Bench 4.0 brugte xhigh-indsats. Harness-design, værktøjskonfiguration, sikkerhedsforanstaltninger, antal forsøg, standardfejl, fallback-adfærd og omkostningslofter kan alle ændre resultatet. Anthropic påpeger selv, at benchmarkmargener kan overdrive den praktiske forskel mellem frontier-modeller.
Kodningsydelse
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Fortolkning |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 10,6-point rapporteret føring for terminalbaserede agentopgaver |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Medium-indsats i Opus 5.5 er fortsat konkurrencedygtig økonomisk |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Medium-indsats ligger lidt over det rapporterede Fable-resultat |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Rapporteret fordel på professionelt agentisk arbejde |
Disse tal er Anthropics rapporterede benchmarkresultater. Tabellen bør læses sammen med forbeholdene om evalueringsindstillinger i de følgende afsnit og den officielle Claude Opus-modelside.
De første tre resultater springer i øjnene, fordi de dækker den arbejdsbyrde, hvor Claude bliver stadig vigtigere kommercielt: software-engineering-agenter. Terminal-Bench 4.0 viser en absolut forskel på 10,6 procentpoint; FrontierCode viser 4,1 point; CursorBench 4.0 viser 6 point.
GDPval-AA, som måler professionelt agentisk arbejde, rapporterer også 1846 Elo for Opus 5.5 mod 1735 for Fable 5.1. Hvis disse tal var hele historien, ville produkthierarkiet synes omvendt. Så enkelt er det ikke.
Uafhængig evaluering
Artificial Analysis placerede Opus 5.5 Max på 58 på sin Intelligence Index og rapporterede stærke resultater på tværs af AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode og Humanity's Last Exam. Deres Terminal-Bench 4.0-resultat var 59,6%, under Anthropics 66,4%, hvilket viser, hvorfor teams bør dokumentere modelversion, indsatsindstilling, harness, værktøjer, antal forsøg og omkostningsloft, når scorer ikke stemmer overens.
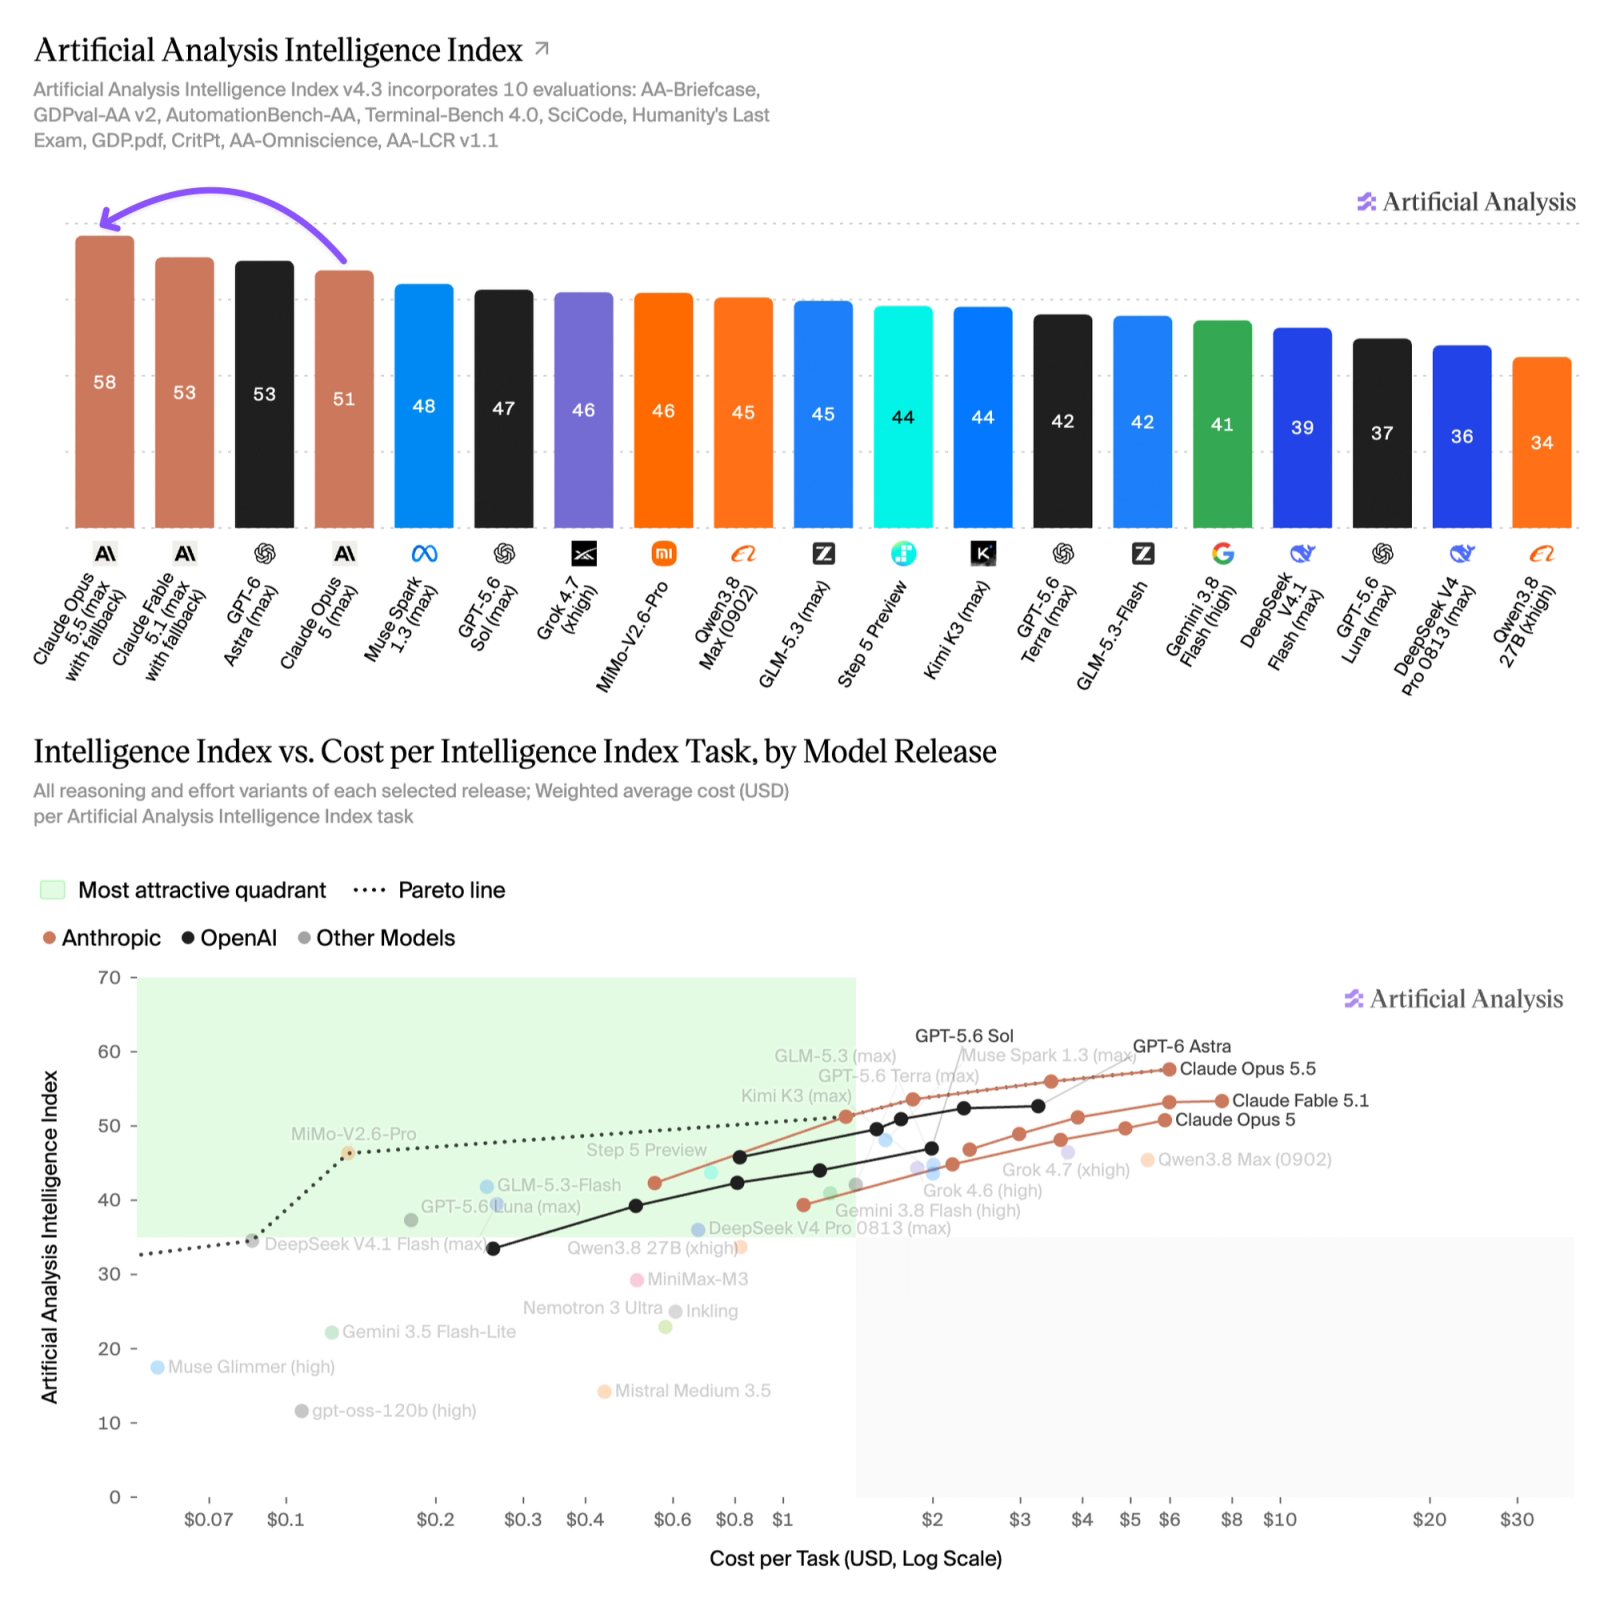
Pris- og omkostningssammenligning pr. fuldført opgave
CometAPI tilbyder tokenpriser under de officielle takster, så udviklere kan opnå samme ydeevne som den officielle API ved at bruge standardformatet for beskedforespørgsler.
Token-priser
| Priser | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache write | $5 | $12.50 |
| 1-hour cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch input/output | 50% discount | 50% discount |
Antag, at en arbejdsbyrde forbruger 10 millioner friske input-tokens og 2 millioner output-tokens. Uden cache-effekter:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Under disse antagelser koster Opus 5.5 60% mindre. Dette tal må dog ikke forveksles med Anthropics udsagn om, at Opus 5.5 koster cirka 40% mindre at køre end Opus 5.
Det er to helt forskellige sammenligninger. 40%-tallet omfatter Opus 5.5’s lavere Opus-tier-priser og reduceret tokenforbrug pr. opgave i forhold til Opus 5. 60%-tallet kommer direkte fra en sammenligning af standardlistepriserne for Opus 5.5 og Fable 5.1.
Omkostning pr. fuldført opgave
En model-API sælger i virkeligheden ikke tokens. Udviklere køber færdiggjort arbejde.
Et kodeteam er ligeglad med, at en model brugte 6.2 millioner tokens. Det er vigtigt, om modellen rettede buggen, gennemførte migreringen, bestod testpakken eller færdiggjorde researchopgaven.
Anthropic gør dette punkt tydeligt i sin analyse Hvad en opgave koster på Opus 5.5: To modeller med lignende priser kan have meget forskellige opgaveomkostninger, hvis den ene behøver flere omgange, genlæser mere kontekst, fejler oftere og må forsøge igen, eller genererer flere thinking-tokens.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Det sidste punkt overses ofte. En billigere model, der fejler to gange, kan blive dyrere end en dyrere model, der gennemfører opgaven i ét run. Ligeledes kan en høj-indsats-indstilling, der undgår ti genforsøg, faktisk sænke de samlede omkostninger.
Økonomi ved prompt-caching
Cache-tunge agenter genbruger gentagne gange værktøjsdefinitioner, repository-kontekst, systeminstruktioner, samtalehistorik og testoutput. Fordi cache-read-prisen er $0.20/M for Opus 5.5 og $0.25/M for Fable 5.1, er forskellen langt mindre end de $6/M i prisforskel på friske input. Teams bør derfor spore friske input, cache-reads, cache-writes, output, værktøjsomgange og genforsøg separat.
Økonomi ved indsatsniveauer
Potentielt ja. Artificial Analysis testede fem Opus 5.5-indsatsindstillinger og fandt en tydelig kurve mellem kapabilitet og omkostning.
| Opus 5.5-indsats | Artificial Analysis Intelligence Index | Omkostning pr. indeksopgave |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium-indsats er et fornuftigt udgangspunkt for rutinemæssige kodeændringer, kendte refaktoriseringer og overvåget fejlfinding. High eller xhigh kan være berettiget til tvetydige systemfejl, natlige migreringer eller opgaver, hvor en forkert plan skaber væsentligt efterarbejde.
Sikkerheds- og pålidelighedssammenligning
Ingen af modellerne bør kaldes sikrere alene på baggrund af kapabilitetsbenchmarks. En forsvarlig sammenligning kræver matchede prompts, værktøjer, tilladelser, indsatsindstillinger, grænser for genforsøg og acceptkriterier. Højere kapabilitet kan reducere utilsigtede fejl, men større autonomi og længere kørsel øger også påvirkningen af en dårlig plan, prompt-injektion, usikkert værktøjskald eller upåagtet drift.
| Sikkerhedsdimension | Praktisk sammenligning | Produktionskontrol |
|---|---|---|
| Ræsonnering og indsats | Opus 5.5 eksponerer flere indsatsniveauer, mens Fable 5.1 starter fra en højere indsatsprofil. Mere ræsonnering er ikke en erstatning for politik-håndhævelse. | Fastlås indsatsreglen pr. arbejdsbyrde og retest sikkerhedsadfærden, når den ændres. |
| Langvarig autonomi | Fable 5.1 er positioneret til vanskeligt, uovervåget arbejde; Opus 5.5 understøtter også agentiske workflows. Risikoen vokser med varighed, tilladelser og irreversible handlinger. | Brug checkpoints, godkendelsesporte, tids- og omkostningslofter samt automatiske rollback- eller nedlukningsbetingelser. |
| Værktøjs- og computerbrug | Begge modeller kan bruge værktøjer, så modelvalg alene styrer ikke dataeksponering eller destruktive handlinger. | Anvend mindst nødvendige privilegier, allowlister, sandboxing, isolering af hemmeligheder og bekræftelse før eksterne eller irreversible handlinger. |
| Evaluering og revisionsmulighed | Offentlige benchmarkscorer fastslår ikke kvalitetsniveau for afslag, modstand mod prompt-injektion eller produktionshændelsesrater. | Log værktøjskald og politiske beslutninger; mål usikker-accept-rate, falske afslag, injektionssucces, læk af hemmeligheder, destruktive forsøg og genopretningskvalitet. |
Praktisk sikkerhedsregel: Start med den mindst privilegerede Opus 5.5-konfiguration, der opfylder opgaven, og eskaler til Fable 5.1 først efter at samme sikkerhedssuite består. For workflows med stor påvirkning kræv menneskelig godkendelse uanset hvilken model scorer højest i kapabilitetstests.
- Kør fjendtlige tests for prompt-injektion og dataeksfiltration med det reelle produktionsværktøjssæt.
- Adskil læse-, skrive-, publicerings-, slette- og finansielle tilladelser i stedet for at give én bred værktøjsrolle.
- Definér rollback-udløsere for politikovertrædelser, gentagne værktøjsfejl, uventet scope-udvidelse og omkostningsoverskridelser.
- Revurder efter ændringer i model, systemprompt, indsats, værktøj, tilladelse eller routing.
Sådan vælger du mellem Opus 5.5 og Fable 5.1
| Arbejdstype | Anbefalet udgangspunkt | Eskalationsbetingelse |
|---|---|---|
| Daglig kodning og code review | Opus 5.5, medium-indsats | Eskalér kun ved usædvanligt svære eller højrisiko-sager |
| Multifil-funktionsarbejde | Opus 5.5, medium eller high | Brug Fable, når gentagne planlægningsfejl dominerer omkostningen |
| Repository-omspændende migrering | Test Opus 5.5 high eller xhigh først | Eskalér for de sværeste uovervågede projekter |
| Natlige autonome kørsler | Opus 5.5 med stramme checkpoints | Foretræk Fable, når prisen for en forkert retning er ekstrem |
| API-trafik i høj volumen | Opus 5.5 | Eskalér kun den fejlbehæftede minoritet af opgaver |
| Eksisterende valideret Fable-udrulning | Behold den nuværende udrulning under test | Skift først, når Opus opfylder de samme accepttærskler |
En praktisk produktionstest
Kør de samme repræsentative opgaver, prompts, værktøjer, indsatspolitik, acceptkriterier og grænser for genforsøg gennem begge modeller. Registrér rate for accepterede opgaver, latenstid, friske og cachede input, output- og thinking-tokens, værktøjskald, genforsøg, menneskelige rettelser og totalomkostning pr. accepteret resultat. Medtag rutineopgaver og vanskelige fejlsager.
Migreringsvejledning for eksisterende Claude Opus 5-brugere
Eksisterende Opus 5-brugere bør teste Opus 5.5 som en efterfølger i stedet for at antage, at et model-ID-swap er risikofrit. Sammenlign planlægningsdybde, mønstre for værktøjskald, svargængde, formatoverholdelse, latenstid, prompt-cache-adfærd, recovery fra mislykkede værktøjskald, sikkerhedsrutning og omkostning pr. fuldført opgave. Behold rollback-kriterier og den eksisterende model, indtil Opus 5.5 består accepttests, der ligner produktion.
Eksisterende Fable 5.1-brugere behøver ikke en generisk migreringssektion. De bør i stedet behandle Opus 5.5 som en mulig optimering og evaluere den under de samme produktions-acceptkriterier, før de ændrer en valideret udrulning.
Adgang via CometAPI
Udviklere, der evaluerer en af modellerne, kan gennemgå de relaterede CometAPI-guides for Claude Opus 5.5 og Claude Fable 5.1. Ved integration via en kompatibel API-udbyder, bekræft det præcise model-ID, understøttede indsatsparametre, cache-adfærd, ratelimits, regional tilgængelighed og aktuel pris før produktion.
Brug claude-opus-5-5 for Opus 5.5 og claude-fable-5-1 for Fable 5.1, hvor disse identifikatorer understøttes. Undgå lydløst at rute begge arbejdsbyrdeklasser gennem ét fast indsatsniveau; modelvalg og indsatspolitik bør konfigureres uafhængigt.
Python — Anthropic Messages API via CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Konklusion
Claude Opus 5.5 ændrer den praktiske grænse mellem Anthropics daglige frontier-model og dens premium-eskalationstrin. Den er væsentligt billigere til standardtokenpriser, fører mange offentliggjorte kodnings- og agentiske benchmarks og tilbyder nok fleksibilitet i indsats til at dække et bredt produktionsspektrum.
Claude Fable 5.1 forbliver relevant, når opgaven er vanskelig, højværdi, langvarig eller uovervåget, og prisen for fejl overstiger den højere inferensregning. For de fleste teams er den bedste politik at starte med Opus 5.5, måle fuldførte opgaveudfald og eskalere selektivt.
FAQ
Hvordan bør teams designe en produktions A/B-test for Opus 5.5 og Fable 5.1?
Brug de samme repræsentative opgaver, prompts, værktøjer, indsatspolitik, acceptkriterier og grænser for genforsøg for begge modeller. Registrér rate for accepterede opgaver, latenstid, friske og cachede input, output- og thinking-tokens, værktøjskald, genforsøg, menneskelige rettelser og totalomkostning pr. accepteret resultat. Kør nok opgaver til at indfange både rutinearbejde og vanskelige fejlsager.
Hvornår kan lavere tokenpriser undlade at reducere den samlede opgaveomkostning?
En billigere model kan stadig koste mere, hvis den kræver flere omgange, genlæser mere kontekst, producerer flere thinking-tokens eller behøver gentagne genforsøg. Cache-adfærd betyder også noget: prisforskellen på input indsnævres i lange sessioner domineret af cache-reads. Sammenlign omkostning pr. fuldført opgave frem for blot listepris.
Hvad bør dokumenteres, når benchmarkresultater er uenige?
Registrér modelversion, indsatsniveau, harness, fallback- og sikkerhedsindstillinger, antal forsøg, task release, standardfejl og omkostningsloft. Mærk hvert resultat som officielt eller uafhængigt, og undgå at kombinere scorer fra umatchede konfigurationer i en enkelt rangering.
Hvilke migrationsrisici bør eksisterende Fable 5.1-brugere overvåge?
Hold øje med ændringer i planlægningsdybde, mønstre for værktøjskald, svargængde, formatoverholdelse, latenstid, prompt-cache-adfærd, fejlgenopretning og sikkerhedsrutning. Behold den eksisterende udrulning tilgængelig under evalueringen, etablér rollback-kriterier og migrér først efter, at Opus 5.5 opfylder de samme accepttærskler på opgaver, der ligner produktion.
SEO-metadata
Meta title:Claude Opus 5.5 vs Fable 5.1: Kode, omkostninger og benchmarks
Meta description:Compare Claude Opus 5.5 og Claude Fable 5.1 på tværs af kodningsbenchmarks, API-priser, hastighed, caching, indsatsindstillinger, omkostning pr. fuldført opgave og arbejdsbelastningspasform.
Keywords:Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude-kodningsbenchmarks, Claude API-priser, CometAPI, AI-kodningsmodeller
URL slug:claude-opus-5-5-vs-claude-fable-5-1