
DeepSeek V4.1 Flash erstatter den kortlivede beta med en produktionsudgivelse bygget omkring asymmetrisk beregning, native multimodalitet, stærkere agent-benchmarks og markant lavere API-priser.
TL;DR
DeepSeek V4.1 Flash er nu en officiel API og en model med åbne vægte, ikke et udløbende beta-endpoint. DeepSeek siger, at det er en 552B-parameter Mixture-of-Experts-model, der bruger en ny Causal-Encoder-Decoder-arkitektur. Kun 8B parametre aktiveres under inputbehandling, mens 16B aktiveres under outputgenerering. Det asymmetriske design skal bruge mindre compute på lange prompts uden at svække den autoregressive generationsfase.
Produktionsmodellens API-navn er deepseek-flash. Den understøtter et 1M-token kontekstvindue, op til 384K outputtokens, thinking- og non-thinking-tilstande, JSON-output, tool calls, Responses API, den Anthropic-kompatible API og native vision-input. DeepSeeks officielle benchmarktabel viser væsentlige forbedringer i forhold til både V4 Flash 0731 og V4 Pro 0813 inden for kode, agenter, cybersikkerhed og multimodale opgaver.
Prisændringen er lige så vigtig. På spidsbelastningstidspunkt koster V4.1 Flash $0.006 pr. million cache-hit inputtokens, $0.30 pr. million cache-miss inputtokens og $1.20 pr. million outputtokens. Off-peak-taksterne er det halve af disse beløb.
Key Takeaways
- DeepSeek V4.1 Flash er en frigivet model med åbne vægte; den midlertidige
deepseek-v4.1-flash-expires-on-0910-betegnelse er ikke længere den korrekte produktionsreference. - Dens 552B MoE-design aktiverer 8B parametre for input og 16B for output, hvilket giver en anden effektivitetsprofil end V4 Flashs 284B-total/13B-aktiv-arkitektur.
- Native multimodalitet er en del af hovedmodellen i stedet for en separat Vision Exp-gren.
- Den officielle sammenligning viser V4.1 Flash foran V4 Pro 0813 på de fleste udvalgte agent- og kode-benchmarks, selvom den ikke fører alle knowledge- eller terminal-benchmarks mod alle frontmodstandere.
- Global KV-cache falder til 890 bytes pr. token, cirka 3,9 gange mindre end V4 Flash og omtrent en fjerdedel af dens tidligere fodaftryk.
- Spidsbelastningspriserne er $0.006 for cache-hit-input, $0.30 for cache-miss-input og $1.20 for output pr. million tokens; off-peak-priserne er 50% lavere.
What Is DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash er DeepSeeks effektivitetsfokuserede foundation-model fra september 2026 til ræsonnering, kodning, agenter og multimodal forståelse. Den officielle annoncering beskriver den som en 552B-parameter MoE-model, der forbedrer kapacitet, samtidig med at den reducerer den mængde compute og hukommelse, der kræves til inputbehandling.
Den vigtigste ændring er arkitektonisk. Tidligere V4 Flash brugte et budget for aktive parametre gennem hele inferencen. V4.1 Flash adskiller input- og outputarbejdslaster: 8B parametre er aktive ved kodning af prompten, og 16B er aktive, mens svaret genereres. DeepSeek kalder dette design Causal-Encoder-Decoder.
| Dato | Status | Model-ID |
|---|---|---|
| Sep 8 | Begrænset beta | deepseek-v4.1-flash-expires-on-0910 |
| Sep 10 | Produktionsudgivelse | deepseek-flash |
DeepSeek V4.1 Flash Specification:
| Specifikation | DeepSeek V4.1 Flash |
|---|---|
| Release-status | Officiel API-udgivelse og model med åbne vægte |
| Arkitektur | Mixture-of-Experts med Causal-Encoder-Decoder-struktur |
| Samlede parametre | 552B |
| Aktiverede parametre | 8B for input; 16B for output |
| Kontekstvindue | 1M tokens |
| Maksimalt output | 384K tokens |
| Inputmodaliteter | Tekst og billeder |
| Outputmodalitet | Tekst |
| Produktions-API-modelnavn | deepseek-flash |
| Thinking-tilstande | Thinking og non-thinking |
| API-funktioner | JSON-output, tool calls, Responses API, Anthropic API, prefix completion, FIM completion |
| Åbne vægte | Udgivet på Hugging Face |
How Does the DeepSeek V4.1 Flash Work: Causal-Encoder-Decoder
Traditionelle, kun-dekoder-sprogmodeller bruger i det væsentlige den samme store stak til promptbehandling og tokengenerering. DeepSeek V4.1 Flash tildeler forskellig aktiv kapacitet til disse faser.
Under inputfasen behandler modellen prompten med et aktivt fodaftryk på 8B. Denne fase kan effektivt undersøge den leverede tekst- eller billedkontekst, fordi det fulde svar endnu ikke er genereret. Under outputfasen aktiverer modellen 16B parametre og fortsætter kausal token-for-token-generering. Designet sparer derfor compute på promptkodning, mens det bevarer mere aktiv kapacitet til ræsonnering og svargenerering.
DeepSeek har ikke offentliggjort alle implementeringsdetaljer i annonceringen, så den sikreste beskrivelse er funktionel: arkitekturen er asymmetrisk, input- og outputfaserne bruger forskellige budgetter for aktive parametre, og det resulterende system reducerer inferenshukommelse og -omkostninger.
KV Cache Reduction
Resultatet for hukommelse er målbart. DeepSeek rapporterer 890 bytes global KV-cache pr. token for V4.1 Flash, sammenlignet med 3.514 bytes for V4 Flash, 48.068 bytes for V3.2 og 389.120 bytes for V1. V4.1-tallet er cirka 3,9 gange mindre end V4 Flash.
For langkontekst-agenter rækker dette ud over en enkelt benchmark. Mindre KV-cache reducerer presset på high-bandwidth-memory, mens en forespørgsel er aktiv, og sænker mængden af tilstand, der skal flyttes til langsommere lager. DeepSeek siger, at V4.1 Flash har brug for cirka en fjerdedel af HBM og en ottendedel af SSD-kapaciteten i forhold til den forrige model til sammenlignelige cache-arbejdslaster.
DeepSeek V4.1 Flash Features
Native Multimodal Input
V4.1 Flash accepterer billeder som en del af hovedmodellens API. Dette erstatter den tidligere opdeling mellem den tekst-only V4 Flash og det eksperimentelle V4 Flash Vision-endpoint. Udviklere kan nu bygge dokumentforståelse, diagramanalyse, skærmbilledefortolkning og visual-agent-workflows mod den samme produktionsmodelfamilie.
Long-Context Reasoning
Den officielle API-specifikation bevarer et 1M-token kontekstvindue og tillader op til 384K outputtokens. Det gør modellen velegnet til repository-skala kodning, multi-dokumentanalyse, langvarige agentsessioner og workflows, der skal bevare en stor værktøjshistorik.
Production API Features
Modellen understøtter thinking- og non-thinking-tilstande, struktureret JSON-output, tool calls, Responses API, en Anthropic-kompatibel grænseflade, chat-prefix completion og FIM completion i non-thinking-tilstand. Disse evner gør V4.1 Flash til en direkte produktions-erstatning for mange V4 Flash agent- og kode-arbejdslaster.
Open Weights
DeepSeek har udgivet V4.1 Flash-vægtene og en teknisk rapport. Udgivelsen forbedrer reproducerbarhed, men modellen er stadig ekstremt stor: DeepSeeks annoncering beder organisationer, der er interesserede i store udrulninger, om at planlægge for cirka 2,000 GPU'er plus en lagringsklynge.
DeepSeek V4.1 Flash Benchmark Performance
De officielle resultater ændrer den tidligere vurdering af, at V4.1 ikke havde benchmarkbeviser. DeepSeek leverer nu en bred tabel, der dækker knowledge, matematik, kodning, terminalagenter, cybersikkerhed, automation og multimodale agentopgaver.
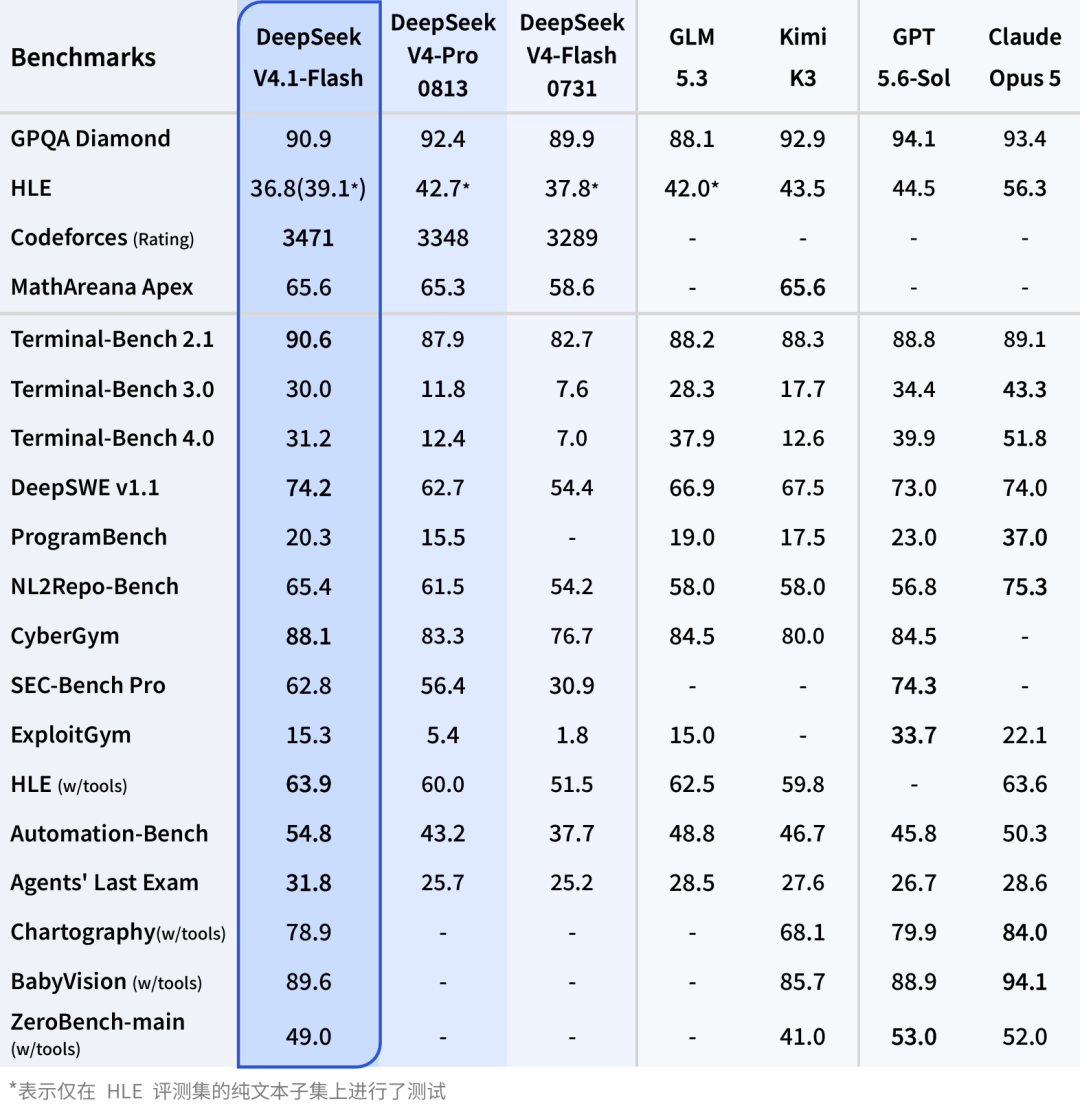
| Benchmark | DeepSeek V4.1 Flash | V4 Pro 0813 | V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
På tværs af dette udvalgte overblik med otte benchmarks slår V4.1 Flash V4 Pro 0813 på syv tests og slår V4 Flash 0731 på alle otte. De største gevinster ses i software engineering og agenter: DeepSWE stiger med 11,5 point over V4 Pro og 19,8 over V4 Flash, mens Automation-Bench forbedres med henholdsvis 11,6 og 17,1 point.
Resultaterne skal stadig fortolkes med omtanke. V4.1 Flash scorer under V4 Pro på GPQA Diamond, og den fulde officielle graf viser, at Claude Opus 5 og GPT-5.6 Sol stadig ligger foran på Terminal-Bench 3.0. En nyttig konklusion er, at V4.1 Flash væsentligt forbedrer DeepSeeks balance mellem effektivitet og kapabilitet; tabellen beviser ikke universel førerposition på hver opgave.
DeepSeek V4.1 Flash API Pricing
DeepSeek bruger peak- og off-peak-fakturering. Spidsbelastningstimer er 01:00–04:00 og 06:00–10:00 UTC, mandag til fredag; alle andre perioder, inklusive weekender, bruger off-peak-taksten. Den aktuelle prisdokumentation angiver, at off-peak-priser er halvdelen af spidsbelastningspriserne.
| Pris pr. 1M tokens | V4.1 Flash off-peak | V4.1 Flash peak | V4 Pro 0813 off-peak | V4 Pro 0813 peak |
|---|---|---|---|---|
| Cache-hit input | $0.003 | $0.006 | $0.022 | $0.044 |
| Cache-miss input | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
Besparelserne er betydelige. For en arbejdslast, der bruger 100 millioner cache-miss inputtokens og 10 millioner outputtokens, koster V4.1 Flash cirka $21 off-peak eller $42 i spidsbelastningstid. Den samme tokenfordeling til de offentliggjorte V4 Pro 0813-takster koster cirka $85.80 off-peak eller $171.60 i spidsbelastningstid. V4.1 Flash er cirka 75,5% billigere i dette eksempel.
Prompt-caching styrker fordelen for agenter, der gentagne gange genbruger systeminstruktioner, repository-kontekst eller dokumenter. V4.1 cache-hit-taksten er 50 gange lavere end cache-miss-taksten i begge faktureringsperioder.
DeepSeek V4.1 Flash vs V4 Flash vs V4 Pro
| Dimension | DeepSeek V4.1 Flash | DeepSeek V4 Flash | DeepSeek V4 Pro |
|---|---|---|---|
| Samlede parametre | 552B | 284B | 1.6T |
| Aktiverede parametre | 8B input / 16B output | 13B | 49B |
| Arkitekturfokus | Asymmetrisk input/output-effektivitet | Letvægts V4 MoE | Maksimal V4-kapacitet |
| Native vision | Ja | Separat Vision Exp-variant | Nej |
| Kontekstvindue | 1M | 1M | 1M |
| Maksimalt output | 384K | 384K | 384K |
| API-status hos DeepSeek | Nuværende produktionsmodel | Pensioneret; legacy-navn ruter til V4.1 Flash | Planlagt til at rute til V4.1 Flash fra 14. september 2026 |
| Bedste anvendelse | Generelle agenter, kodning, vision, høj throughput | Kun migrationskompatibilitet | Eksisterende Pro-arbejdslaster under transition |
V4.1 Flash er større i samlede parametre end V4 Flash, men kan være billigere at serve, fordi dens inputfase kun aktiverer 8B parametre og bruger en meget mindre KV-cache. Sammenlignet med V4 Pro aktiverer den langt færre parametre, samtidig med at den overgår Pro på de fleste af de ovenfor udvalgte agent- og kode-benchmarks.
API Access and Migration
DeepSeeks produktionsmodelnavn er deepseek-flash. Eksisterende applikationer kan beholde den OpenAI-kompatible base-URL https://api.deepseek.com eller den Anthropic-kompatible base-URL https://api.deepseek.com/anthropic.
- Opdater modelnavnet til
deepseek-flash. - Behold den eksisterende DeepSeek base-URL og autentificeringsmetode.
- Gentest thinking-tilstand, tool calls, vision-inputs, latens og tokenforbrug med produktionsprompter.
- Overvåg legacy-aliaser:
deepseek-v4-flashogdeepseek-v4-flash-vision-expruter nu til V4.1 Flash, mensdeepseek-v4-proer planlagt til at rute til V4.1 Flash fra 14. september 2026, indtil en fremtidig V4.1 Pro-udgivelse.
For CometAPI-brugere er DeepSeek V4.1 API i CometAPI nu live sammen med den eksisterende DeepSeek V4 Flash API. Før du skifter produktionstrafik, skal du bekræfte det endelige modelnavn, priser og aliasmapping i CometAPI-dashboardet, da tredjepartsudbydere kan afvige fra DeepSeeks officielle API-navngivning og takster.
Who Should Use DeepSeek V4.1 Flash?
V4.1 Flash passer stærkt til kodeagenter, repository-analyse, terminalautomation, multimodale dokument-workflows, langkontekst-assistenter og højvolumen systemer med værktøjsbrug. Dets benchmarkgevinster er koncentreret i de samme arbejdslaster, der har størst fordel af lavere cache-hukommelse og lavere tokenpriser.
Teams, der allerede bruger V4 Flash, bør betragte den som en direkte migrationskandidat. Teams, der bruger V4 Pro, bør teste omhyggeligt, men DeepSeeks egne benchmark- og prisdata gør nu V4.1 Flash til det mere økonomiske standardvalg for mange Pro-klasses arbejdslaster.
Self-hosting er en anden beslutning. Åbne vægte gør ikke en 552B-model letvægts. Organisationer bør sammenligne omkostningen ved en stor GPU- og lagerudrulning med hosted API-brug, før de forpligter sig til lokal inferens.
Limitations and Open Questions
- Benchmarkresultaterne stammer fra DeepSeeks officielle evalueringssetup; uafhængige repliker vil være nødvendige for at måle ydeevne på tværs af forskellige harnesses og miljøer for værktøjer.
- Native multimodal støtte er bekræftet, men applikationsteams bør validere understøttede billedformater, tokenopgørelse og vision-adfærd mod den live API.
- Legacy-modelaliaser ændrer nu modellen bag et eksisterende navn, hvilket kan ændre outputs uden en ændring i applikationskoden.
- V4.1 Flash reducerer infrastrukturkravene i forhold til tidligere DeepSeek-modeller, men dens open-weight-udrulning kræver stadig betydelig compute og lager.
- CometAPIs dedikerede V4.1-endpoint og endelige priser bør bekræftes i den live konsol før produktion.
Final Verdict
DeepSeek V4.1 Flash er en større arkitektur- og produktopdatering. MoE-modellen med 552B kombinerer en 8B-aktiv inputfase, en 16B-aktiv outputfase, native vision, et 1M-token kontekstvindue og en kraftigt komprimeret KV-cache. Disse designvalg omsættes til stærkere officielle kode- og agent-benchmarks til langt lavere API-priser end V4 Pro 0813.
Den mest praktiske ændring er konsolidering. V4.1 Flash samler tekst, vision, ræsonnering, værktøjsbrug og langkontekstdrift i ét produktionsmodelnavn. For de fleste nye DeepSeek-integrationer er deepseek-flash nu det logiske udgangspunkt; V4 Pro bliver en migrationssammenligning frem for det automatiske valg til vanskeligt arbejde.
FAQ
Is DeepSeek V4.1 Flash officially released?
Ja. Den er tilgængelig via DeepSeeks API under modelnavnet deepseek-flash, og DeepSeek har udgivet åbne vægte og en teknisk rapport.
Is the temporary V4.1 beta model ID still required?
Nej. deepseek-v4.1-flash-expires-on-0910 var en kortlivet beta-betegnelse. Produktionsapplikationer bør bruge deepseek-flash.
How many parameters does DeepSeek V4.1 Flash have?
Modellen har 552B samlede parametre. Den aktiverer 8B parametre under inputbehandling og 16B under outputgenerering.
Does DeepSeek V4.1 Flash support images?
Ja. Vision-input er native i produktionsmodellen, så et separat V4 Flash Vision Exp-endpoint er ikke længere nødvendigt.
Is V4.1 Flash better than V4 Pro?
Den fører V4 Pro 0813 på de fleste af DeepSeeks offentliggjorte sammenligninger inden for kodning, agenter, automation og cybersikkerhed, men V4 Pro ligger fortsat foran på GPQA Diamond. Teams bør evaluere begge mod deres egne prompts før migration.
How much does the API cost?
På spidsbelastningstidspunkt er taksterne pr. million tokens $0.006 for cache-hit input, $0.30 for cache-miss input og $1.20 for output. Off-peak-taksterne er det halve af disse priser.
What happens to the old V4 model names?
Legacy-navnene deepseek-v4-flash og deepseek-v4-flash-vision-exp ruter til V4.1 Flash. DeepSeek siger, at deepseek-v4-pro også vil rute til V4.1 Flash fra 14. september 2026, indtil V4.1 Pro udgives.
Can I use DeepSeek V4.1 Flash through CometAPI?
Ja. CometAPI tilbyder nu et live DeepSeek V4.1 API-endpoint. Før produktionstrafik sendes, skal du bekræfte det præcise modelnavn, priser og understøttede funktioner i CometAPI-konsollen, da tredjepartsudbydere kan bruge andre navngivningskonventioner eller takster end DeepSeeks officielle API.