Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
DeepSeek-V4.1-Flash er den nuværende multimodale Flash-model, som DeepSeek API leverer under model-ID'et deepseek-flash. Den understøtter 1M-token-kontekst, op til 384K output og billedinput; ifølge den aktuelle Vision-vejledning bruger hvert billede højst 1024 tokens efter automatisk resizing.
Modellens stærkeste positionering er fortsat agentorienteret vision: inspektion af skærmbilleder, diagrammer, interfaces og billedbaserede dokumenter før videre arbejde med kode eller værktøjer. Benchmark-resultaterne senere i denne artikel hører til det udfasede Vision-Exp-lanceringstrin og bør læses som historisk, leverandør-rapporteret evidens—ikke som en ny benchmark af DeepSeek-V4.1-Flash.
CometAPI beholder i øjeblikket som sit katalog-model-ID, mens DeepSeeks direkte API anbefaler og betjener forespørgslen med DeepSeek-V4.1-Flash. Start med en tekst-plus-billede-forespørgsel, og evaluer den præcise rute på dine egne skærmbilleder og visuelle opgaver.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
deepseek-v4-flash-vision-exp
deepseek-flash
Nøglepointer
Aktuel rute: DeepSeek-V4.1-Flash er den aktive multimodale Flash-model. Det udfasede navn deepseek-v4-flash-vision-exp accepteres kun som en kompatibilitetsalias på DeepSeeks API.
Stort tekstworkspace: 1M-token-kontekst og op til 384K output understøtter lange dokumenter, koderepositorier, værktøjshistorikker og billeder i én samtale.
Aktuel billedopgørelse: DeepSeek resizer automatisk hvert billede og begrænser det til 1024 inputtokens. Billeder under cirka 544×544 samlede pixels skaleres op; større billeder skaleres mod cirka 1300×1300 samlede pixels.
Agentfokuseret vision: den officielle sammenligning lægger vægt på skærmbilleder, diagrammer, browser, kodning og visuelle værktøjs-workflows frem for billedgenerering.
Bred interface-understøttelse: DeepSeek dokumenterer de understøttede API-grænseflader: Chat Completions, Anthropic-kompatible Messages og Responses API. CometAPI-eksemplerne nedenfor bruger Chat Completions.
Forsigtighed i produktion: rutealiaser, automatisk billedresizing og benchmarks, der er følsomme for testrigge, gør workloadspecifik testning essentiel.
Hvad er DeepSeek-V4-Flash-Vision?
DeepSeeks aktuelle dokumentation identificerer deepseek-flash som DeepSeek-V4.1-Flash, med tekst- og billedinput og tekstoutput. Den tidligere Vision-Exp-model er udfaset; dens ældre modelnavne er kompatibilitetsaliaser, der rutes til den aktuelle Flash-model.
Målcasen er multimodal agentdrift. En visuel agent kan inspicere en renderet applikation, identificere en knap eller layoutfejl, ræsonnere om næste handling, kalde et værktøj og derefter undersøge det næste skærmbillede. Det samme mønster gælder for diagramanalyse, visuel kvalitetssikring, dokumentudtræk, browserautomatisering og kodningsagenter, der skal sammenligne et designreference med en renderet side.
Navngivningsnote: brug deepseek-flash til DeepSeeks direkte API; det mapper i øjeblikket til DeepSeek-V4.1-Flash. De ældre navne deepseek-v4-flash og deepseek-v4-flash-vision-exp accepteres stadig af DeepSeek, men de tilsvarende modeller er udfasede, og forespørgsler betjenes af DeepSeek-V4.1-Flash. CometAPI eksponerer fortsat deepseek-v4-flash-vision-exp som sin egen katalogrute.
Tekniske specifikationer
Specifikation (officielle docs)
Aktuel værdi
Officielt model-ID
deepseek-flash
Status
Aktiv multimodal Flash API-rute; ældre Vision-Exp-model udfaset
Input / output
Tekst + billede input; tekstoutput
Kontekstvindue
1.048.576 tokens (1M)
Maksimalt output
Op til 384K tokens
Legacy Vision-Exp checkpoint-listing
305B parametre på det officielle Hugging Face-repository
Thinking og non-thinking; indsatsniveauer low, high, max
Licens
MIT for det officielle model-repository
Arkitekturfelterne ovenfor kommer fra den officielle konfiguration. Repository-grænsefladen viser et checkpoint på 305B parametre, men DeepSeek offentliggør ikke separat et aktiveret-parameterantal for den komplette visionmodel. Det er sikrere at rapportere repository-værdien end at antage, at den tekst-only V4-Flashs aktive antal overføres uændret efter tilføjelse af den visuelle stak.
Sådan fungerer DeepSeek-V4-Flash-Vision-Exp’s legacy-arkitektur
V4-Flash tekst-backbone
Sprog-siden bevarer V4-designtemaerne, der gør langkontekst-agentarbejde praktisk. Det officielle repository dokumenterer V4-arkitekturkomponenterne: sparsom Mixture-of-Experts-routing, DFlash attention, Hyper-Connections og DSpark. Dette gør udgivelsen mere inspicerbar end en ren API-model, selvom lokal udrulning forbliver krævende i denne skala.
Vision-encoder og aligner
For det udfasede Vision-Exp-checkpoint anvendte den publicerede konfiguration en 32-lags visuel encoder, patch-størrelse 14, vision-bredde 1.024, 16 visuelle attention-heads og en 384-token billedrepræsentation. Disse arkitekturoplysninger beskriver det historiske checkpoint og bør ikke antages at dokumentere den nuværende DeepSeek-V4.1-Flash serving-stack.
Aktuelt 1024-token-billedloft
DeepSeeks aktuelle vision-tokeniseringsregler skalerer billeder under cirka 544×544 samlede pixels op og større billeder ned, mens billedformatet bevares. Store input resizes mod cirka det pixelareal, en 1300×1300-billedstørrelse svarer til, hvilket giver en øvre grænse på 1024 tokens pr. billede. Et 2000×2000-billede og et 5000×5000-billede bruger derfor det samme antal billedtokens efter resizing.
Praktisk konsekvens: beskær det område, der indeholder små labels, kode eller UI-kontroller, før du sender billedet. Højere kilderesolution alene omgår ikke det aktuelle loft på 1024 tokens.
Legacy Vision-Exp benchmark-ydelse
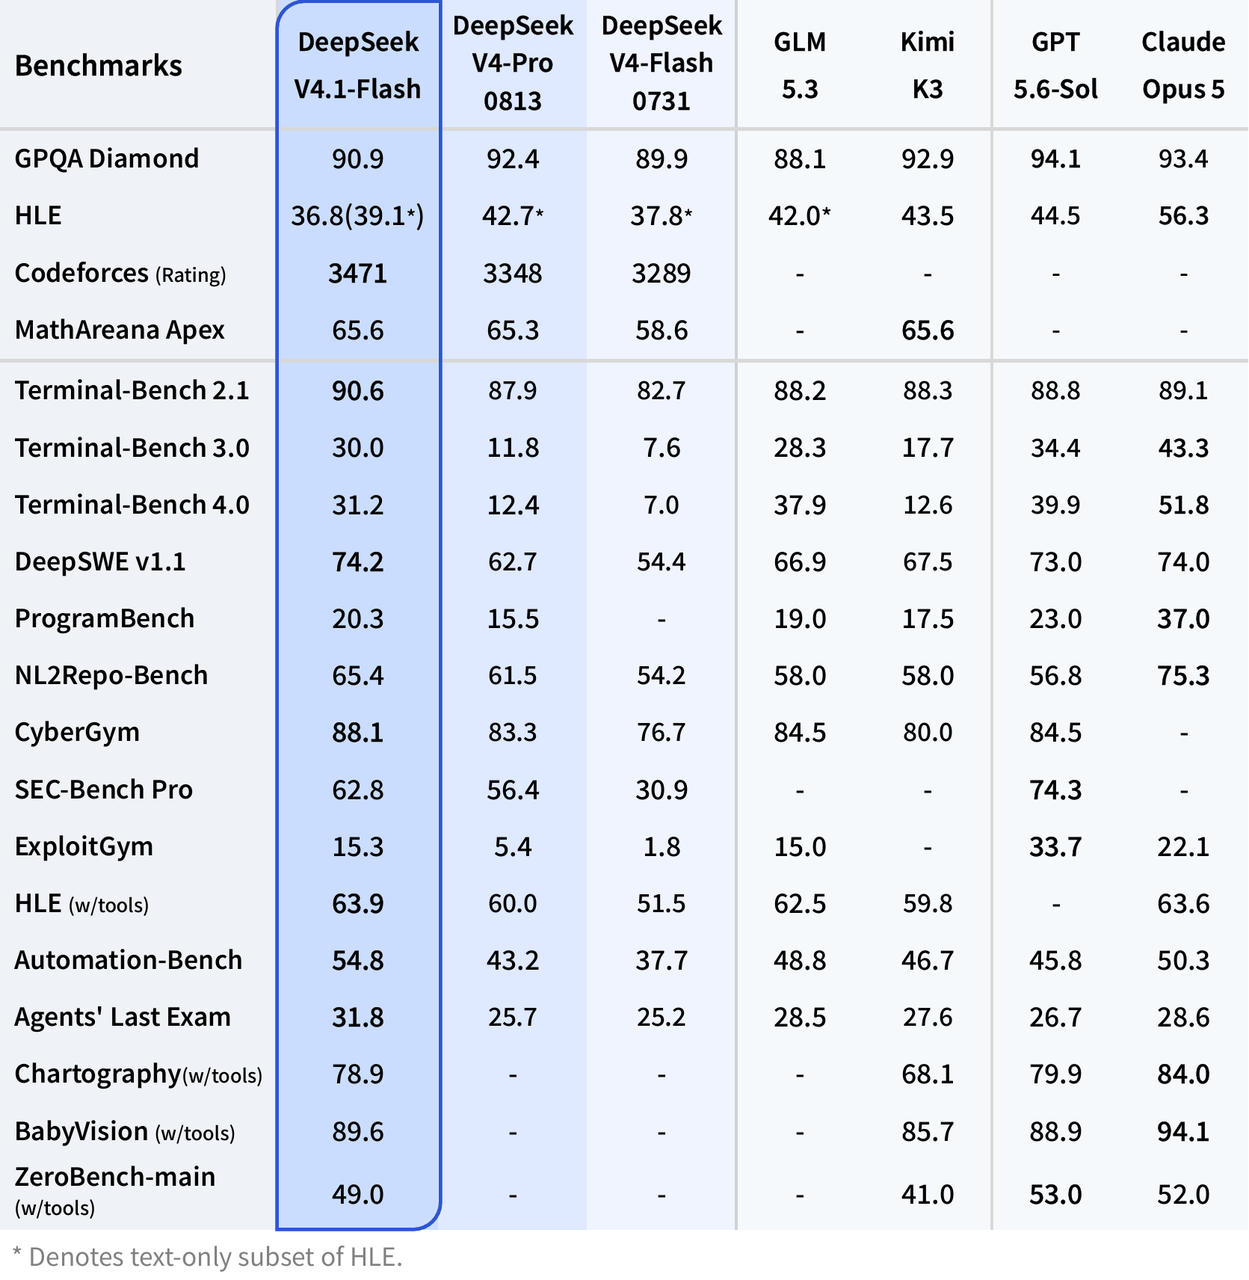
DeepSeeks officielle modelkort-evaluering sammenligner visionmodellen med DeepSeek-V4-Flash-0731 og Claude Opus 4.8 på tværs af tekst- og multimodale agentopgaver. Visionmodellen forbedrer generelt den tekst-only Flash-model, samtidig med at den forbliver konkurrencedygtig med, men ikke konsekvent foran, konkurrenten med førstefokus på kapacitet.
* I ApexBench og Agents' Last Exam ignorerede den tekst-only V4-Flash de multimodale elementer i input. DeepSeek evaluerede sine tekst-agentopgaver med DeepSeek Harness minimal mode, maksimal ræsonneringsindsats, temperature 1.0 og top_p 0.95.
Benchmark-note: dette er DeepSeek-rapporterede lanceringsresultater, ikke en uafhængig reproduktion. Agent-scorer er især følsomme over for testrig, værktøjsdefinitioner, tokenbudget og retry-politik, så de bør behandles som retningsgivende evidens.
Hvad benchmark-resultaterne betyder
Det mest klare resultat er forbedringen over tekst-only V4-Flash, når visuel evidens betyder noget. ApexBench stiger fra 26.2 til 36.5, og visionmodellen tilføjer konkurrencedygtige Chartography- og ZeroBench-resultater, som den tekst-only model ikke rapporterer. Modellen forbedrer også flere tekst-agentopgaver, herunder Terminal Bench 2.1, NL2Repo, DeepSWE, Toolathlon-Verified og DSBench-Hard, selvom Cybergym er en smule lavere.
Sammenlignet med Opus 4.8 er resultatet blandet. Vision-Exp ligger højere på DeepSWE, Agents' Last Exam og ZeroBench i denne tabel, mens den konkurrerende model ligger højere på Terminal Bench, NL2Repo, Cybergym, Toolathlon, DSBench-Hard, ApexBench og Chartography. DeepSeeks multimodale benchmark-udsagn er derfor retningsgivende snarere end bevis for generel ækvivalens på alle dimensioner af vision, ræsonnering eller pålidelighed.
DeepSeek-V4.1-Flash vs DeepSeek-V4-Flash-Vision-Exp vs Claude Opus 4.8 vs Gemini 3.7 Flash
Dimension
DeepSeek Vision-Exp
DeepSeek V4 Flash
Claude Opus 4.8
Gemini 3.7 Flash
Status
Eksperimentel
Public beta / aktuel Flash-rute
Generelt tilgængelig
Generelt tilgængelig
Inputmodaliteter
Tekst, billede
Tekst
Tekst, billede, dokumenter
Tekst, billede, video, audio, PDF
Output
Tekst
Tekst
Tekst / strukturerede data / kode
Tekst
Kontekst
1M
1M
Op til 1M afhængigt af platform
1.048.576
Maks output
384K
384K
128K
65.536
Hovedstyrke
Lavpris visuelle agenter
Høj-throughput tekstagenter
Højt-autonome komplekse agenter
Bred multimodal arbejdshest
Bedste første test
Skærmbilleder, diagrammer, UI, visuel kodning
Kodning og tekstautomatisering
De sværeste langhorisont-opgaver
Rig multimodalitet og Google-værktøjer
Vælg Vision-Exp, når billedperception skal tilføjes til en omkostningseffektiv agentløkke. Vælg V4 Flash, når hvert input er tekst, og throughput er vigtigere end visuel forståelse. Opus 4.8 forbliver kapacitetsførst-optionen i DeepSeeks egen sammenligning, mens Gemini 3.7 Flash er det bredere multimodale alternativ, når video, audio, PDF'er og Google-native værktøjer er vigtige.
Hvad kan DeepSeek-V4-Flash-Vision?
Skærmbillede-til-kode og UI-review – sammenlign en renderet side med et design, identificér layout- eller tilgængelighedsproblemer, og generér implementeringsvejledning.
Visuelle browseragenter – brug skærmbilleder som observationer, når DOM eller accessibility-tree-data er ufuldstændige, og vælg derefter den næste værktøjshandling.
Diagram- og dashboardanalyse – forklar trends, identificér anomalier, og forbind synlige metrics til en større tekst- eller værktøjsworkflow.
Billedbaseret dokumentforståelse – udtræk information fra scannede formularer, diagrammer, slides, tabeller og skærmbilleder før struktureret behandling.
Multimodale kodningsagenter – kombiner kildekode, fejlbilleder, IDE-tilstande og renderede outputs i en enkelt debugging-løkke.
Visuel kvalitetssikring – sammenlign produktskærmbilleder på tværs af enheder, find manglende elementer, og generér strukturerede fejlrapporter.
Multi-billede-sammenligning – evaluer en sekvens af skærmbilleder eller alternative designs i én forespørgsel, underlagt begrænsninger på forespørgselsstørrelse og antal billeder.
DeepSeek fakturerer billedtokens sammen med tekstinputtokens. Dets officielle pristabel bruger peak- og off-peak-satser, mens CometAPI-modelsiden offentliggør en enkelt, aktuel rutepris. Tallene bør ikke slås sammen til én generisk pris, fordi den billigste rute ændrer sig med DeepSeeks tidsvindue.
Rute / kilde
Cache-hit input
Cache-miss input
Output
Betingelse
DeepSeek officiel - off-peak
$0.003
$0.15
$0.60
Alle timer uden for peak-vinduer, inkl. weekender og kinesiske helligdage
DeepSeek officiel - peak
$0.006
$0.30
$1.20
01:00-04:00 og 06:00-10:00 UTC, man-fre, ekskl. kinesiske helligdage
CometAPI aktuel rute
Ikke listet separat
$0.352
$1.056
Aktuel samlet rutepris
Alle priser er USD pr. 1M tokens. DeepSeeks aktuelle Flash-satser er $0.003/$0.15/$0.60 off-peak og $0.006/$0.30/$1.20 peak for henholdsvis cache-hit input, cache-miss input og output. CometAPI viser i øjeblikket $0.352 pr. 1M inputtokens og cirka $1.06 pr. 1M outputtokens for sin kompatibilitetsrute. Billeder bruger højst 1024 inputtokens hver på DeepSeeks aktuelle API; tjek altid live rutepriser igen før produktion.
Prisnote: modelpriser kan ændre sig. Hold prisfigurer linket til live-prissider, og dobbelttjek dem umiddelbart før publicering eller produktionsudrulning.
Sådan bruges DeepSeek-V4-Flash-Vision med CometAPI
CometAPI viser i øjeblikket deepseek-v4-flash-vision-exp via sin OpenAI-kompatible /v1/chat/completions-endpoint, så CometAPI-eksemplerne bevarer dette katalog-ID. Til DeepSeeks direkte API skal du bruge deepseek-flash i stedet.
Gem den i miljøvariablen COMETAPI_KEY. Placer aldrig en produktionsnøgle i client-side-kode eller commit den til source control.
export COMETAPI_KEY="your-cometapi-key"
Trin 2: Send et Base64-billede med cURL
Base64 er nyttigt til lokale filer og server-side-jobs, hvor billedet allerede er i hukommelsen. Erstat pladsholderen med de kodede billedbytes uden at tilføje mellemrum eller linjeskift.
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4-flash-vision-exp",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "Read this dashboard and return the three most important findings."
          },
          {
            "type": "image_url",
            "image_url": {
              "url": "data:image/png;base64,<BASE64_DATA>"
            }
          }
        ]
      }
    ],
    "max_tokens": 1200
  }'
Trin 3: Analyser et lokalt billede med Python
OpenAI Python SDK kan kalde CometAPI ved at ændre base-URL. Brug extra_body til DeepSeek-specifikke thinking-kontroller, når dit SDK ikke eksponerer dem direkte.
Trin 4: Brug en offentlig billed-URL med JavaScript
En billed-URL holder JSON-forespørgslen lille, men URL'en skal være offentligt tilgængelig for upstream-modellen. Undgå midlertidige, private eller autentifikationsbeskyttede links, medmindre din applikation først konverterer billedet til Base64.
Placer flere image_url-blokke i den samme user-besked, og fortæl modellen, hvordan de skal mærkes. Eksplicitte labels reducerer utilsigtede krydsreferencer mellem billeder.
{
  "model": "deepseek-v4-flash-vision-exp",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "Compare Image A and Image B. List every visible regression."
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-a.png"}
        },
        {
          "type": "image_url",
          "image_url": {"url": "https://example.com/image-b.png"}
        }
      ]
    }
  ],
  "max_tokens": 1800
}
Inputmetoder og -grænser
Grænse
Officiel DeepSeek-værdi
Understøttede formater
JPEG, PNG, GIF, WebP
Ekstern URL-længde
Op til 8.192 tegn
Forespørgselskrop
48 MiB
Enkeltbillede via Base64 / URL
32 MiB
Enkeltbillede via DeepSeek Files API
64 MiB
Maksimalt antal billeder pr. forespørgsel
600
Samlet billedstørrelse
64 MiB uden file_id; op til 200 MiB inkl. file_id
Maksimal dimension
8.192 px pr. side; 4.096 px når forespørgslen har 15+ billeder
Billedmeddelelsens rolle
Kun brugermeddelelser
Det officielle DeepSeek API understøtter også genbrugelige file_id-billedreferencer via dets Files API. CometAPI-genvejen, der dokumenteres her, bruger image_url-blokke med enten en offentlig URL eller en Base64 data-URL. Verificér udbyderspecifik filupload og file_id-passthrough, før du baserer dig på det workflow via en aggregatorrute.
Sådan promptes modellen effektivt
En pålidelig visuel agent-prompt bør angive, hvad billedet er, hvilken evidens der skal inspiceres, hvilken handling der skal tages, og hvilken outputkontrakt der skal følges. Vage prompts såsom describe this image giver for meget frihed og gør resultater sværere at validere.
Kontekst – identificér skærmbilledet, diagrammet, dokumentet eller interfacet og dets rolle i workflowet.
Opgave – specificér beslutningen, diagnosen, sammenligningen eller udtrækket, der betyder noget.
Begrænsninger – forbyd ikke-understøttede antagelser, og fortæl modellen, hvordan utydelige detaljer skal håndteres.
Output – definér JSON-nøgler, en tjekliste, alvorlighedsniveauer eller en anden maskin-tjekbar struktur.
You are reviewing a web application screenshot.

Task: identify layout, accessibility, and state-consistency defects.
Evidence: cite the visible element, label, position, or color that supports each finding.
Constraints: do not infer hidden DOM state; mark unreadable text as uncertain.
Output: return JSON with arrays named critical, major, minor, and follow_up_checks.
Bedste praksis i produktion
Beskær før upload, når små tekster eller kontroller er vigtige; billedtoken-loftet betyder, at irrelevant baggrund forbruger knap visuel opløsning.
Test reasoning-indsats i stedet for at aktivere max for hver forespørgsel. Simpel OCR eller klassifikation kræver typisk mindre ræsonnering end flertrins UI-diagnoser.
Kræv evidens i hver struktureret fund. Dette gør hallucinerede visuelle påstande lettere at afvise automatisk.
Adskil perception fra handling i højrisko-automation. Lad modellen beskrive tilstanden, validér den, og lad derefter et kontrolleret værktøjslag handle.
Beskyt billed-URL'er, fordi en offentlig URL kan eksponere følsomme skærmbilleder. Foretræk server-side Base64 til private data, og anvend din egen retention-politik.
Benchmark end-to-end med samme skærmbillede-capture, prompt, værktøjer, retries og succeskriterier som i produktion.
Spor eksperimentelle ændringer ved at låse prompts og evalueringsdata. En -exp endpoint kan ændre adfærd hurtigere end en moden GA-model.
Log request-ID'er og fejl, så leverandørfejl, modelfejl og applikationsparse-fejl kan skelnes.
Begrænsninger
Den vigtigste begrænsning er rutetransparens: det ældre Vision-Exp-navn kan stadig accepteres, selvom forespørgslen betjenes af DeepSeek-V4.1-Flash. Log leverandør, anmodet model-ID, returnerede modelmetadata og request-ID; brug eksplicitte evalueringsporte, før autonome handlinger tillades. Historiske lanceringsscorer er ikke en erstatning for reproducerbar test på den tilsigtede rute.
Den anden begrænsning er visuel detaljegrad. Automatisk resizing og det aktuelle loft på 1024 billedtokens gør omkostninger forudsigelige, men kan stadig undertrykke bittesmå tekster, fine diagrammarkeringer eller tætte interfaceelementer. Beskær, tile eller zoom det relevante område, og bevar originalbilledet til menneskelig gennemgang.
Modellen returnerer kun tekst. Den kan analysere et billede og foreslå kode eller strukturerede handlinger, men den genererer eller redigerer ikke billeder. Den accepterer også billeder kun i user-beskeder, og den officielle dokumentation angiver, at billedindhold i system- eller assistant-beskeder returnerer en 400-fejl.
Endelig er lokal udrulning infrastrukturtung. Det officielle repository viser en model på 305B parametre og leverer reference-inferencekode frem for en turnkey letvægtsruntime. For de fleste teams er managed API-evaluering det praktiske udgangspunkt.
Almindelige fejl og løsninger
Symptom
Sandsynlig årsag
Anbefalet løsning
400: model does not support image
Forkert model-ID
Brug deepseek-v4-flash-vision-exp
400 for message content
Billede placeret i system- eller assistant-besked
Flyt billedblokke til en user-besked
Billeddownload mislykkes
Privat, udløbet eller langsom URL
Brug Base64 eller en stabil offentlig URL
Fine detaljer overses
Automatisk nedskalering / 384-token-loft
Beskær eller tile det relevante område
Uventet høj omkostning
Langt output, retries eller gentagne ture
Begræns max_tokens og log forbrug pr. tur
Inkonsekvent agentresultat
Variation i testrig eller værktøjstilstand
Fiks prompt, værktøjer, retries og evalueringsrubrik
FAQ
Er DeepSeek-V4-Flash-Vision det samme som DeepSeek-V4-Flash?
Nej. Vision-Exp tilføjer native billedinput og multimodal træning. Den tekst-only Flash-rute leverer ikke den samme visuelle perceptionskapacitet.
Hvilket model-ID skal jeg bruge?
Brug deepseek-flash på DeepSeeks direkte API. På CometAPI skal du bruge katalog-ID'et deepseek-v4-flash-vision-exp, så længe denne rute er tilgængelig.
Kan den analysere flere billeder?
Ja. DeepSeek dokumenterer op til 600 billeder pr. forespørgsel, underlagt grænser for forespørgselsstørrelse og dimensioner. Praktiske grænser kan være lavere i en applikation, fordi latenstid og promptklarhed forringes, når billedsættet vokser.
Hvor mange tokens bruger et billede?
På DeepSeeks aktuelle API resizes billeder og konverteres til tokens med et maksimum på 1024 tokens pr. billede. Flere billeder tælles uafhængigt.
Understøtter den billedgenerering?
Nej. Den accepterer tekst og billeder og returnerer tekst.
Er den klar til produktion?
Ja, men kun efter rutespecifik evaluering. Brug overvågning, fallbacks, opgavespecifikke accepttests og model-/rutelogning, fordi legacy-aliasser kan løses til DeepSeek-V4.1-Flash.
Skal jeg bruge CometAPI eller DeepSeeks direkte API?
CometAPI er nyttig, når én nøgle, ét billinglag og nem modelswitching er vigtige. DeepSeek direkte adgang kan være at foretrække, når du har brug for udbyderspecifikke funktioner såsom officielle Files API-semantikker eller off-peak-priser. Test begge ruter mod den samme workload.
Konklusion
DeepSeek-V4.1-Flash er nu den aktive multimodale Flash-rute på DeepSeeks API. Dens 1M-kontekst, 384K outputloft, multi-interface-understøttelse og loftet på 1024 tokens pr. billede gør den attraktiv til skærmbilledeforståelse, diagramanalyse, visuel kodning og browser- eller GUI-automation. Vision-Exp-arkitekturen og lanceringsbenchmarks i denne artikel er bevaret som historisk kontekst.
Beslutningen bør forblive workload-drevet. Offentlig benchmark-evidens for den udfasede Vision-Exp-model er primært leverandør-rapporteret, aktuelle rutealiaser kan skjule, hvilken model der betjener forespørgslen, og billedresizing kan stadig begrænse opgaver med fine detaljer. Test den præcise udbyderrute på repræsentative billeder, mål omkostninger pr. succesfuld opgave i stedet for alene tokenpris, og hold en fallback, indtil ruten har bevist sig pålidelig i din produktionsrig.