Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Google annoncerede Gemini 4 Argon den 30. september 2026 som en frontiermodel til komplekse, langvarige arbejdsgange. De offentliggjorte resultater viser et klart mønster: stærk ydeevne i professionelt vidensarbejde, langkontekst-opgaver og udvalgte software-engineering-evalueringer, med svagere resultater på nogle terminal- og computerbrugs-benchmarks. Google introducerer modellen gennem en faseopdelt udrulning. Uafhængigt heraf rapporterer CometAPI katalogtilgængelighed pr. 1. oktober; kontoberettigelse og en vellykket testrforespørgsel bør verificeres før implementering. Den mest nyttige præstationshistorie er, hvor dens gevinster viser sig.
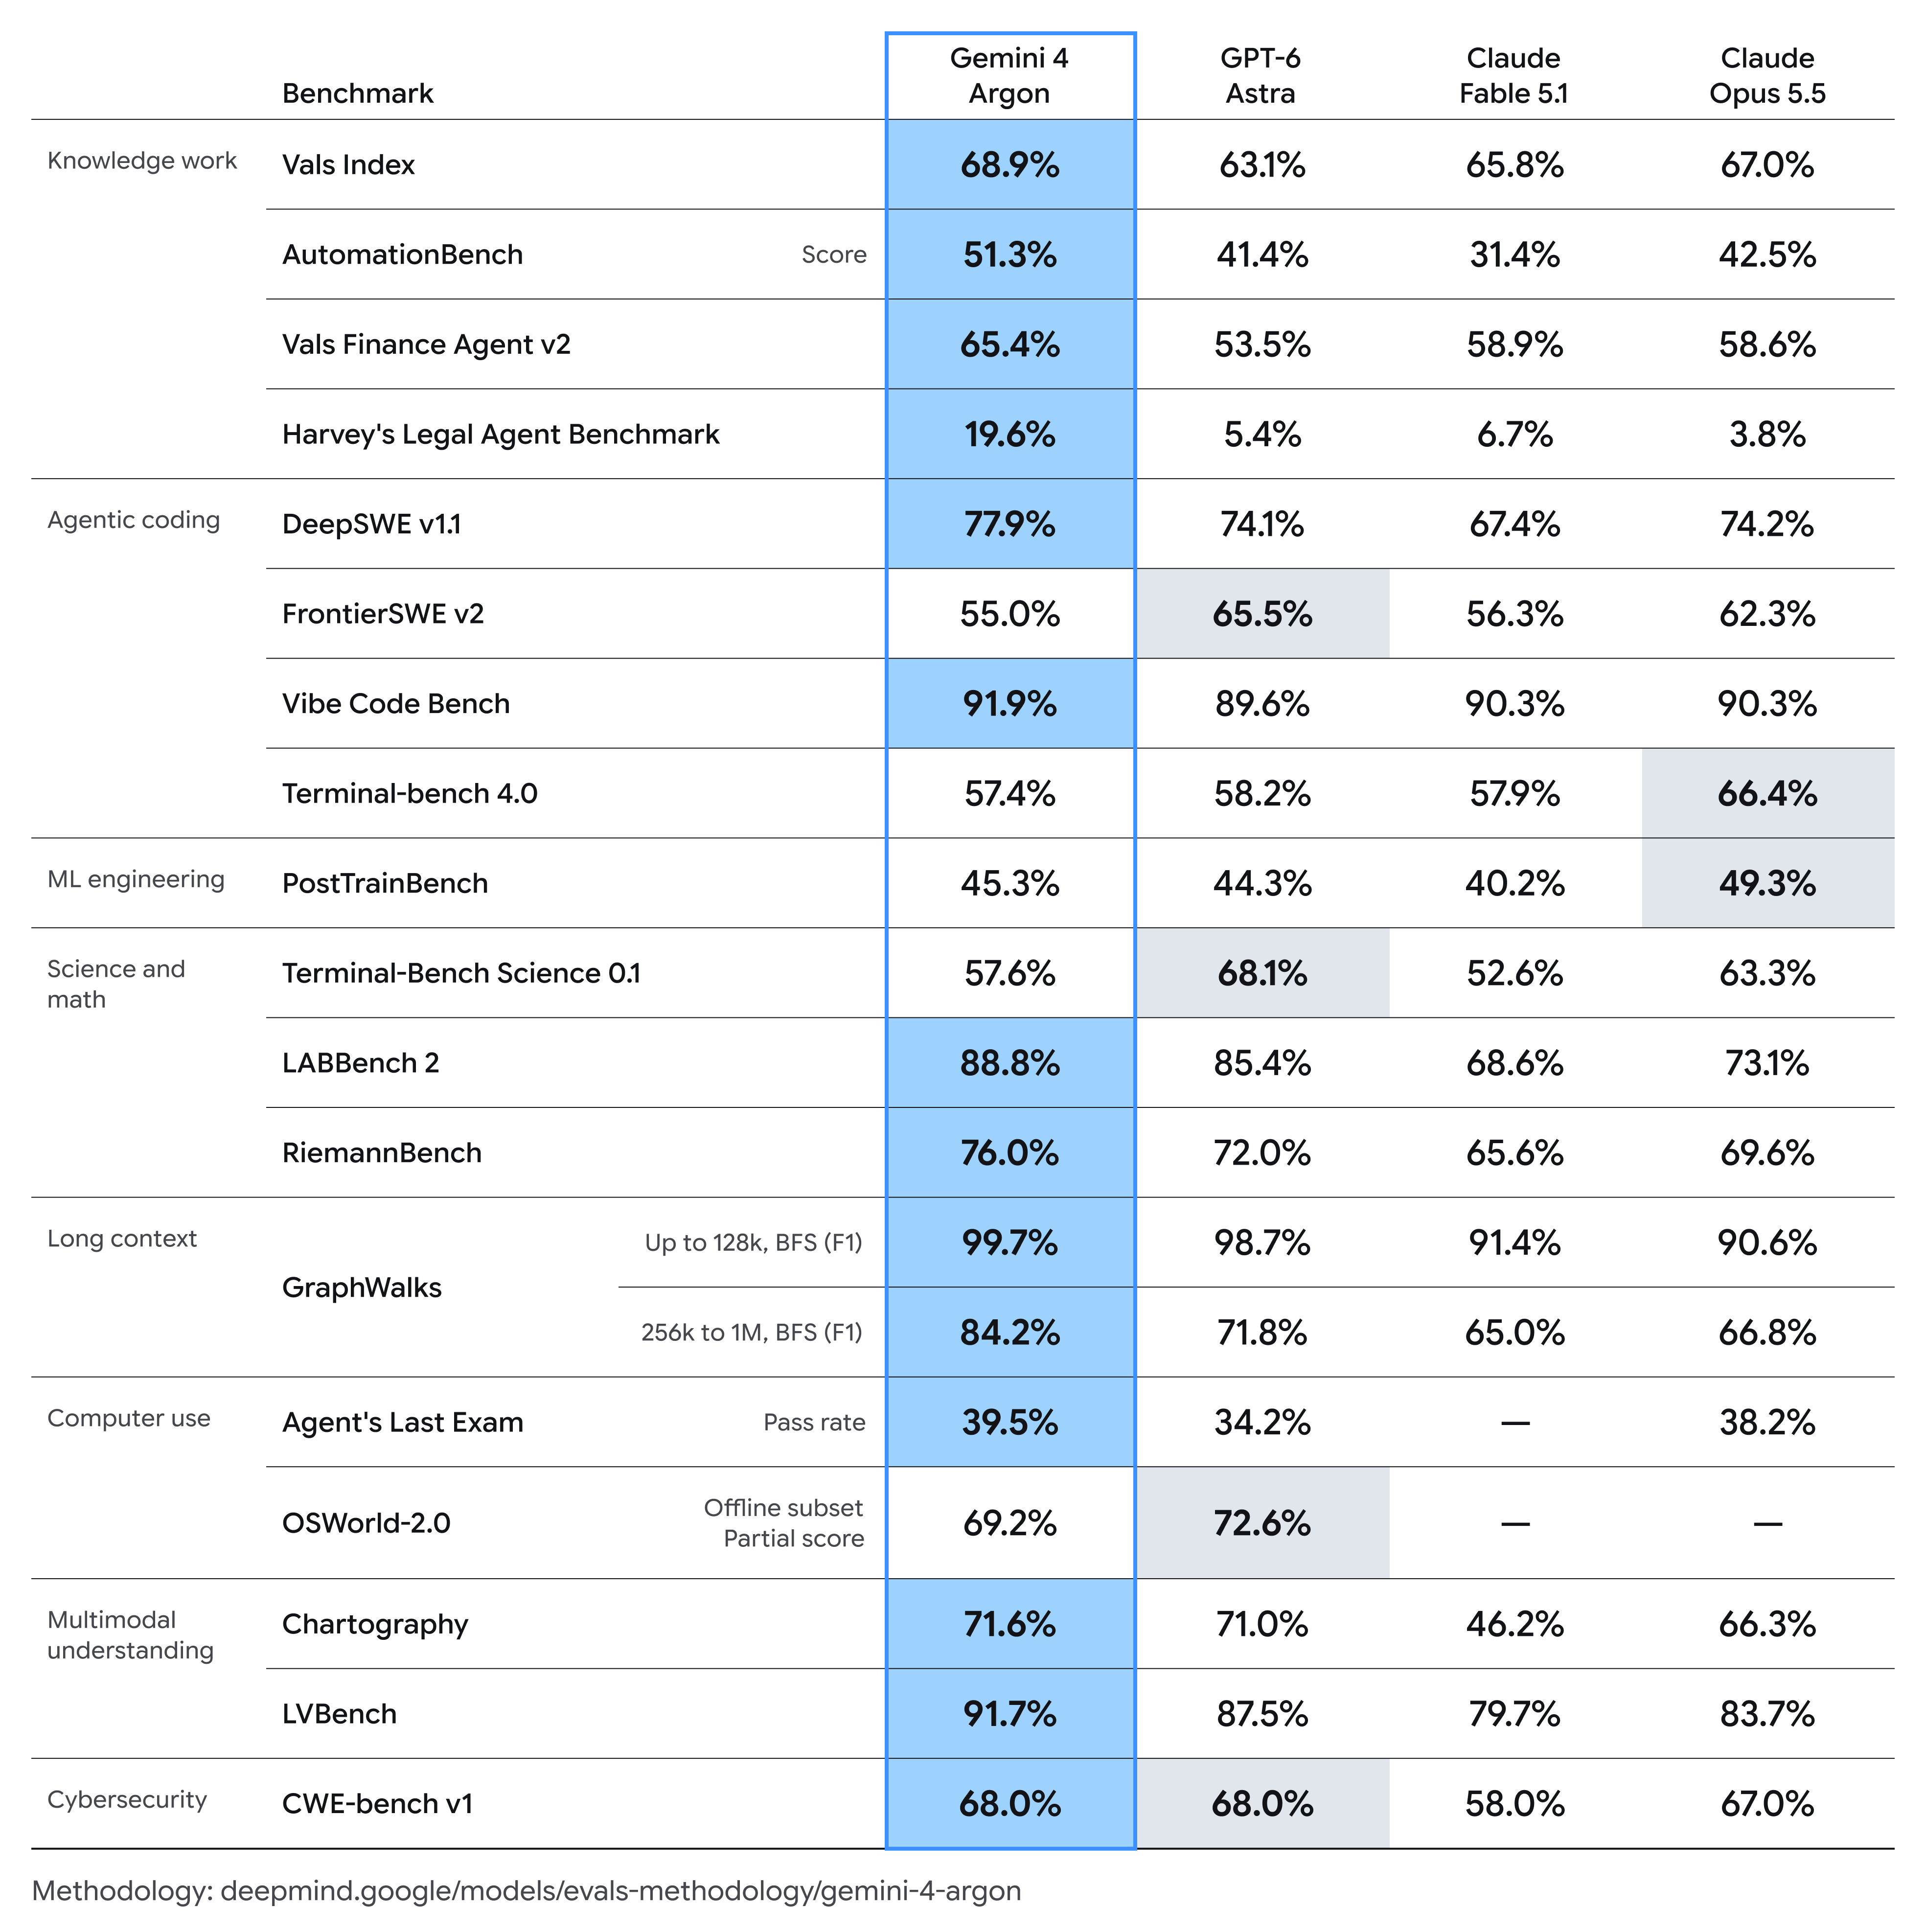
Argon scorer 68,9% på Vals Index, 65,4% på Vals Finance Agent v2, 77,9% på DeepSWE v1.1, 91,7% på LVBench og 84,2% på GraphWalks ved 256K–1M kontekst. Samtidig halter den efter konkurrerende frontiermodeller på FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science og OSWorld-2.0.
Resultaterne taler for en arbejdsbelastningsspecifik vurdering af Argon. Dens stærkeste scorer klumper sig omkring professionelt vidensarbejde, meget lang kontekst og udvalgte multimodale og software-engineering-evalueringer. Andre modeller bevarer fordele på flere terminal- og computerbrugs-tests.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Key Takeaways
Gemini 4 Argon er stærkest i enterprise-vidensarbejde, langkontekst-reasoning, multimodal forståelse og flere langhorisont-kodnings-evalueringer.
Dens maksimum for output på 1 million tokens giver mere plads til generering ved lange ræsonneringsforløb; den fastlægger ikke en offentlig specifikation for inputkontekst.
Argon fører flere offentliggjorte resultater inden for vidensarbejde og langkontekst, men GPT-6 Astra og Claude Opus 5.5 ligger foran på udvalgte kodnings- og computerbrugs-evalueringer.
Benchmark-scorer beskriver bestemte model- og agentkonfigurationer. Målemetrikker, inputbetingelser og evalueringsindstillinger betyder lige så meget som procenttal i overskrifterne.
Googles udrulning og CometAPI-adgang er separate tilgængelighedspåstande. Verificér aktiv rute, modelidentifikator og kontoberettigelse, før du migrerer trafik.
What Is Gemini 4 Argon?
Gemini 4 Argon er Google DeepMinds nye frontier-Gemini-model, bygget til vanskelige arbejdsgange, som kræver ræsonnering over mange trin snarere end svar på en kort prompt.
Googles officielle positionering fremhæver software-engineering i den virkelige verden, enterprise-vidensarbejde såsom jura og finans, defensiv cybersikkerhed, multimodal forståelse og langvarige agentiske opgaver.
Dette er en vigtig forskel fra de nylige Flash-udgivelser. Gemini 3.8 Flash API i CometAPI er designet som en billigere arbejdshest til agentiske workloads i stor skala. Argon repræsenterer i stedet frontier-enden af Googles stack og prioriterer dybde og vedvarende udførelse.
Model Specifications
Specification
Gemini 4 Argon
Developer
Google DeepMind
Announced
September 30, 2026
Model family
Gemini 4
Positioning
Frontier-reasoning og langhorisont-model
Maximum output
1,000,000 tokens
Long-context evaluation
Testet gennem 256K–1M på GraphWalks
Public input context limit
Ikke formelt specificeret i en standard offentlig API-spec ved lancering
Multimodal understanding
Ja; inkluderer diagrammer, dokumenter og evaluering af lange videoer
Agentic coding
Ja
Computer use
Evalueret
Cybersecurity
Specialiserede defensive kapabiliteter
Google public API model ID
Ikke annonceret i Googles første offentlige dokumentation; CometAPI bruger gemini-4-argon som katalog-id.
Output Budget and Trade-offs
Google annoncerer en maksimum-outputgrænse på 1 million tokens for Argon, op fra den tidligere 64K-grænse nævnt i lanceringen. Dette giver plads til længere ræsonneringsforløb. Det bør ikke tolkes som en garanteret samlet budgetramme for en hel agent-session med flere kald eller som bevis for, at hver opgave forbedres.
Maksimum output er ikke det samme som intelligens. At give en model flere outputtokens gør den ikke automatisk mere kapabel; det fjerner én potentiel flaskehals. Modellen skal stadig bruge det budget produktivt.
Der er også en omkostnings- og latensafvejning. En model, der faktisk genererer hundredtusinder af tokens, kan være dyr og langsom, selv når den nominelle pris pr. token ser attraktiv ud.
Udvalgte benchmark-resultater gengivet fra artiklen. Sammenlign modeller inden for hver række; metrikker og evalueringsbetingelser er forskellige. Dette diagram erstatter det dekorative gradientkunstværk og repræsenterer ikke uafhængig testning.
En maksimum-outputgrænse og et inputkontekst-vindue beskriver forskellige kapaciteter. GraphWalks’ evalueringsområde er evidens om de testede input, ikke en erstatning for en offentlig API-specifikation.
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMinds præstationstabel dækker agent-arbejdsgange, professionelt vidensarbejde og multimodale opgaver. Værdierne nedenfor gengiver den offentliggjorte sammenligning. De måler opgavepræstation, ikke token-gennemløb eller svartid; “—” betyder, at et resultat ikke er rapporteret i denne sammenligning.
Medmindre andet er angivet, bruger Argon en enkelt forsøg og den højeste “thinking”-indstilling. Andre modellernes resultater stammer generelt fra udbyderrapporter, med benchmark-specifikke undtagelser. LVBench bruger 1 FPS for Gemini, 800 frames for GPT-6 Astra, 300 for Fable 5.1 og 600 for Opus 5.5. Disse input er ikke identiske, så sammenlign de rapporterede konfigurationer frem for at betragte hver række som en kontrolleret gentagelse.
Evaluation Conditions and Limitations
Tabellen er nyttig, men den bør ikke tolkes som en uafhængig universel leaderboard.
Den officielle metode identificerer udbyder-rapporterede konkurrentresultater som standard, med benchmark-specifikke leaderboard- og selvberegnede undtagelser.
Den højeste benchmark-indstilling afspejler ikke nødvendigvis en standard produktionsinference-konfiguration.
Et benchmarktal alene afslører ikke tokenforbrug, værktøjskald, retries, forløbet tid eller menneskelig intervention.
For produktionssystemer er en bedre metrik ofte omkostning pr. vellykket fuldført opgave frem for pris pr. token eller ét benchmark-procenttal.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Det klareste mønster i Argons resultater ses i professionelt, multitrins vidensarbejde.
På Vals Index når Argon 68,9%, sammenlignet med 67,0% for Claude Opus 5.5. Den numeriske forskel er beskeden, men mønsteret bliver tydeligere i specialiserede arbejdsgange.
Vals Finance Agent v2: 65,4%, 6,5 point over den stærkeste konkurrent vist i Googles tabel.
AutomationBench: 51,3%, 8,8 point over Claude Opus 5.5.
Harvey's Legal Agent Benchmark: 19,6%, sammenlignet med 6,7% for den næsthøjeste rapporterede model.
Præstationsprofilen antyder, at Argon har størst fordel, når modellen skal indsamle information, bevare state, ræsonnere over flere trin og producere et professionelt artefakt frem for blot at besvare et lukket spørgsmål.
Den lave absolutte score for juridisk agent er også vigtig. En score på 19,6% alene afslører ikke, hvor mange kriterier eller komplette arbejdsgange, der fejlede. Den nyttige konklusion er, at Argon viser en stor relativ forbedring på denne evaluering, mens resultatet ikke etablerer pålidelig automatisering af juridisk arbejde.
Long-Context Reasoning
Argons mest iøjnefaldende fordel kan være 256K–1M-versionen af GraphWalks.
Gemini 4 Argon: 84,2%
GPT-6 Astra: 71,8%
Claude Opus 5.5: 66,8%
Claude Fable 5.1: 65,0%
Det er en fordel på 12,4 point over den nærmeste model i den offentliggjorte sammenligning.
Forskellen er langt mindre ved kortere kontekstlængder: på GraphWalks op til 128K scorer Argon 99,7% og GPT-6 Astra 98,7%. Dette antyder, at Argon degraderer mindre skarpt end de sammenlignede modeller på denne særlige meget langkontekst-evaluering.
Hvad Google ikke har offentliggjort, er tilstrækkelig arkitektonisk information til at tilskrive denne forskel en specifik attention-mekanisme, retrieval-system, træningsopskrift eller strategi ved inferenstid. Påstande såsom “Gemini 4 introducerer en ny attention-arkitektur” ville derfor gå ud over de offentligt tilgængelige beviser.
Coding Performance
Den officielle benchmark-tabel understøtter ikke et enkelt “ja”.
Argon præsterer ekstremt godt på nogle former for kodning og taber tydeligt på andre. På DeepSWE v1.1 når den 77,9%, mod 74,2% for Claude Opus 5.5 og 74,1% for GPT-6 Astra. Dens Vibe Code Bench-score er også stærk med 91,9%.
FrontierSWE v2: 55,0% for Argon mod 65,5% for GPT-6 Astra.
Terminal-Bench 4.0: 57,4% for Argon mod 66,4% for Claude Opus 5.5.
Terminal-Bench Science 0.1: 57,6% for Argon mod 68,1% for GPT-6 Astra.
Denne split er vigtig for udviklere. Argon ser særligt stærk ud, når kodning bliver en lang engineering-arbejdsgang med væsentlig kontekst og planlægning, mens terminaltung udførelse forbliver mere konkurrencepræget. En repository-migrations-benchmark og en interaktiv terminal-benchmark bør ikke behandles som udskiftelige mål for “kodningsevne”.
Defensive Cybersecurity
Cybersikkerhed er et kerneområde for implementering. Googles defensive cybersikkerhedspositionering inkluderer autonom sårbarhedsopdagelse, validering og patching. Dette er en udbyderkapabilitetspåstand; resultatet nedenfor for CWE-bench måler sårbarhedsafhjælpning på sin egen evaluering.
På CWE-bench v1 scorer Argon 68%, lige med GPT-6 Astra og en smule foran Claude Opus 5.5 med 67%.
Google fremhæver også stærkere værn mod misbrug, indirekte prompt-injektion, risikabel agentadfærd og kompromittering af eksekveringsmiljøer. Det gør Argon lige så meget til en agent-sikkerhedsudgivelse som en konventionel modelopgradering.
Multimodal Understanding
Argon scorer 71,6% på Chartography og 91,7% på LVBench for forståelse af lange videoer. LVBench-resultatet ligger 4,2 procentpoint over GPT-6 Astra i Googles tabel. Da modellerne modtager forskellige sampling-konfigurationer for frames, er dette en sammenligning af de rapporterede opsætninger snarere end en ren model-only fordel.
Dette er vigtigt, fordi mange professionelle arbejdsgange ikke er rent tekstuelle. En finansiel forskningsagent kan have behov for at inspicere et diagram; en enterprise-assistent kan kombinere rapporter, PDF'er og screenshots; et videoanalysesystem kan skulle bevare hændelser over en lang sekvens frem for at behandle individuelle frames uafhængigt.
Argons kombination af multimodal perception og vedvarende ræsonnering er derfor mere relevant end multimodal støtte alene.
Science and Mathematics Performance
Resultaterne er blandede men generelt stærke. Argon når 88,8% på LABBench 2 og 76,0% på RiemannBench, foran de sammenlignede modeller i Googles tabel. Dog når GPT-6 Astra 68,1% på Terminal-Bench Science 0.1 sammenlignet med 57,6% for Argon.
Den forskel peger mod et bredere mønster: Argon synes stærkere til at ræsonnere over videnskabelig information end til enhver form for værktøjsdrevet videnskabelig udførelse.
Computer-Use Performance
På Agent's Last Exam scorer Argon en binær beståelsesrate på 39,5%, foran GPT-6 Astra med 34,2% og Claude Opus 5.5 med 38,2%. På OSWorld-2.0's offline-subset er dens delscore 69,2%, under GPT-6 Astras 72,6%. OSWorld-værdien er ikke en fuld opgavesuccesrate, og manglende Claude-poster implicerer ikke nul kapabilitet.
Så de aktuelle data viser ikke en på tværs af brugsområderne fordel i computerbrug. Til produktionsimplementering bør benchmark-scorer suppleres med opgaveniveau-tests af navigationsnøjagtighed, fejlkliks, retry-frekvens, utilsigtede handlinger, tid til fuldførelse og graden af menneskelig korrektion.
Gemini 4 Argon vs GPT-6 Astra and Claude
Dimension
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
Claude Fable 5.1
Knowledge work
Meget stærk
Stærk
Meget stærk
Stærk
Long-context benchmark
Stærkeste offentliggjorte
Stærk
Moderat–stærk
Moderat
Long-horizon coding
Meget stærk
Meget stærk
Meget stærk
Stærk
Terminal coding
Konkurrencedygtig
Stærk
Stærkest i udvalgte test
Konkurrencedygtig
Scientific terminal agents
Konkurrencedygtig
Stærkest i udvalgte test
Stærk
Konkurrencedygtig
Multimodal understanding
Meget stærk
Meget stærk
Stærk
Konkurrencedygtig
Computer use
Konkurrencedygtig
Stærk
Blandet / begrænset sammenligning
Begrænset sammenligning
Cybersecurity
Delt top på CWE-bench v1
Delt top
Meget tæt
Lavere
Argon skiller sig ud i denne sammenligning for langkontekst, dokumenttunge og professionelle agent-arbejder. Udviklere kan sammenligne den med GPT-6 Astra, Claude Opus 5.5 og Claude Fable 5.1 via CometAPI.
Performance-based selection
De kvalitative labels ovenfor opsummerer den udvalgte benchmark-tabel, ikke en universel rangliste. Foretræk Argon til et pilotprojekt, når arbejdet ligner dens førende evalueringer; test Astra og Opus på terminaltunge workloads, før du vælger en standard.
Specifications and deployment constraints
Denne præstationssammenligning fastslår ikke en arkitekturfordel eller en generel pris-ydelsesvinder. Argons parametertælling og arkitektur er ikke specificeret i de gennemgåede Google-lanceringsmaterialer. Dens offentlige inputkontekstgrænse kræver officiel API-dokumentation. CometAPI rapporterer en gemini-4-argon-route; bekræft dens understøttede parametre og kontoadgang uafhængigt af Googles bredere udrulning. Sammenlign hver routes grænser og faktiske opgaveomkostninger før implementering.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI rapporterer modellen som tilgængelig under gemini-4-argon. Brug konto-dashboardet til at oprette en API-nøgle, vælg den identifikator i playgrounden, og kør en testforespørgsel før integration. Dens OpenAI-kompatible eksempel bruger base-URL'en https://api.cometapi.com/v1. Bekræft modellens understøttede endpoint og parametre i kontodokumentationen; et katalognålemærke er ikke i sig selv en bekræftelse på et vellykket kald.
Opret en CometAPI-konto og generér en API-nøgle i dashboardet.
Vælg gemini-4-argon og valider en repræsentativ forespørgsel i playgrounden.
Konfigurér den kompatible klient med CometAPI-base-URL, din nøgle og modelidentifikatoren; bekræft det understøttede forespørgselsskema og fakturering før implementering.
CometAPI and official pricing
Google annoncerede introduktionspriser på $2 per million input tokens og $10 per million output tokens, med cachet input prissat til 95% rabat på inputraten. Efter introduktionsperioden er de annoncerede satser $4 for input og $20 for output per million tokens. Dette er Googles annoncerede satser, ikke CometAPI-priser eller bekræftelse af øjeblikkelig generel API-adgang.
Billing basis
Gemini 4 Argon API in CometAPI
Google official announcement
Comparison
Input / 1M tokens
$3.20
$4.00 after introductory period
20% under annonceret post-intro
Output / 1M tokens
$16.00
$20.00 after introductory period
20% under annonceret post-intro
Conclusion
Gemini 4 Argons benchmark-profil er mere interessant end en simpel leaderboard-påstand.
De stærkeste resultater i denne sammenligning klumper sig omkring professionelt vidensarbejde, lang kontekst og vedvarende agent-udførelse. Dette mønster er nyttigt til workload-udvælgelse, men identificerer ikke den underliggende arkitektur eller beviser, hvilken mekanisme der forårsagede gevinsterne.
De rapporterede resultater for finans, jura, lange videoer og software-engineering understøtter et fokuseret pilotprojekt for disse workloads. Om den samme fordel består i produktion afhænger af inputmix, agent-framework, inferensindstillinger og krav til verifikation.
Samtidig viser resultaterne, at frontier-modellers præstation bliver stadig mere specialiseret. Argon kan føre DeepSWE og samtidig ligge efter på FrontierSWE; føre Agent's Last Exam og ligge efter på OSWorld; og føre LABBench og ligge efter på Terminal-Bench Science. Disse benchmarks belaster forskellige dele af et agentsystem.
For udviklere er den vigtigste lektie, at modeludvælgelse i stigende grad skal ske på workload-niveau frem for på brand- eller familieniveau.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Byg et repræsentativt opgavesæt med eksplicitte acceptkriterier. Hold værktøjer, tidsgrænser, inputforberedelse og retry-politikker sammenlignelige på tværs af modeller. Registrér fuldførte opgaver, samlede tokens, forløbet tid og menneskelig korrektion. Start med et lille pilotprojekt og undersøg fejlsager, før du dirigerer produktionstrafik.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Nej. Tabellen kombinerer forskellige metrikker, herunder F1, beståelsesrater og delscorer. Brug opgavespecifikke kriterier frem for at gennemsnitliggøre alle procenttal.
Should a Gemini 4 Argon agent always use its full output budget?
Nej. Vælg det mindste testede budget, der opfylder dine kvalitets- og pålidelighedskrav. Maksimum-outputgrænsen er et loft, ikke et mål.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Start med en tilgængelighedstjek på kontoniveau og en lille forespørgsel ved hjælp af den dokumenterede CometAPI-route. Mål svartkvalitet, latens, grænser og fakturerede tokens, og anvend derefter de samme accepttests som for alternative modeller. Behandl CometAPIs adgangspåstand separat fra Googles bredere udrulning, og hold routing konfigurerbar, indtil ruten opfylder dine krav.