
TL;DR
Gemini 4 Argon er ikke inkluderet i Gemini API Free tier, og et Google AI Pro-abonnement alene giver ikke Argon API-adgang. Google AI Ultra kan give adgang via udvalgte Gemini-produkter, mens betalt API-forbrug fortsat faktureres separat. CometAPI tilbyder en uafhængig API-vej uden krav om, at hver slutbruger har et Google AI Pro- eller Ultra-abonnement. Dets offentliggjorte priser for ikke-cachet input og output er $1.60 og $8 pr. million tokens sammenlignet med Googles introduktionspriser på $2 og $10.
Adgang og udbyderes listepriser kontrolleret den 16. oktober 2026.
Vigtigste pointer
- Introduktionspris: $2 / 1M input-tokens og $10 / 1M output-tokens; fra 1. december fordobles priserne.
- Cachet input: 95% implicit-cache-rabat på berettigede træffere; cacheminimum er 4,096 prompt-tokens.
- Outputfakturering inkluderer tænkning; input, tænkning og synligt output deler et budget på 1,048,576 tokens.
- Adskil Gemini-app-abonnementer fra Antigravity-rettigheder og betalt API-adgang. Et manglende modelnavn i ét produkt beviser ikke, at alle adgangsveje er utilgængelige.
- CometAPI giver en uafhængig API-vej med lavere offentliggjorte ikke-cachede input- og outputpriser. Applikationer kan betjene flere slutbrugere gennem én CometAPI-konto uden at kræve, at hver bruger har et Google AI Pro- eller Ultra-abonnement; grænser for kvote, saldo, rate og samtidighed på kontoniveau gælder stadig.
Hvad er Googles aktuelle adgangsbegrænsninger for Gemini 4 Argon?
Den første beslutning er, hvor du har brug for Argon: i en interaktiv app, et lokalt kodemiljø eller en API-integration. Googles meddelelse om udvikleradgang skelner mellem betalt Gemini API-adgang og Ultra-abonnentadgang i AI Studio og Antigravity. Tolket ikke en Antigravity-abonnementsbegrænsning som et krav om at købe Ultra for enhver betalt API-arbejdsgang.
Til en API-applikation giver CometAPI en alternativ konto- og faktureringsvej. Dette kan være nyttigt, når du vil evaluere Argon sammen med andre modeller uden at købe et Google-forbrugerabonnement til det formål. Det ændrer ikke adgangsrettigheder i Googles egne apps og bør ikke beskrives som ubegrænset brug.
Hvad koster Gemini 4 Argon API?
Googles Standard Gemini 4 Argon-priser gælder til og med 30. november 2026, med højere priser fra 1. december. Alle beløb nedenfor er USD pr. million tokens, medmindre andet er angivet. Batch, Flex og Priority har separate priser.
| Fakturakategori (USD / 1M tokens) | Google Standard: til og med 30. november 2026 | Google Standard: fra 1. december 2026 | Gemini 4 Argon API i CometAPI: til og med 30. november 2026 |
|---|---|---|---|
| Input | $2.00 | $4.00 | $1.60 |
| Cachet input | $0.10 | $0.20 | $0.08 |
| Output, inkl. tænkning | $10.00 | $20.00 | $8.00 |
CometAPI-priser blev kontrolleret den 14. oktober 2026. Dets offentliggjorte input- og outputpriser ligger 20% under Googles introduktions-Standardpriser. Tallet for cachet input stammer fra CometAPI’s omkostningsberegner; bekræft den aktive kontopris og cache-berettigelse, før du baserer dig på den. Googles prisændring i december vil afgøre CometAPI’s fremtidige priser; tjek de priser, der vises i din CometAPI-konto, når du lægger budget.
På disse priser koster 200,000 ikke-cachede input-tokens plus 60,000 fakturerbare output-tokens $0.80 via CometAPI sammenlignet med $1.00 via Google i introduktionsperioden. Dette beregnede eksempel udelader tools og retries.
Hvad koster Gemini 4 Argon på realistiske workloads?
Følgende scenarier er beregnede eksempler, ikke målt modelbrug. Input er ikke-cachet; output inkluderer både tænkning og synlig tekst. En kodeagent-forespørgsel med 200,000 input-tokens og 60,000 fakturerbare output-tokens koster $1.00 i introduktionsperioden og $2.00 bagefter. Den samme workload gentaget 1,000 gange koster $1,000 eller $2,000 før retries, tools og skatter.
| Eksempelforespørgsel | Ikke-cachelagrede input-tokens | Fakturerbare output-tokens | Introduktionspris | Standardpris |
|---|---|---|---|---|
| Kort assistentsvar | 5K | 1K | $0.02 | $0.04 |
| Dokumentanalyse | 100K | 10K | $0.30 | $0.60 |
| Komplekse kodeagent | 200K | 60K | $1.00 | $2.00 |
| Forsknings-arbejdsgang | 500K | 100K | $2.00 | $4.00 |
| Anmodning med lang dekodning | 100K | 500K | $5.20 | $10.40 |
Formel: Cost = (uncached input tokens × input rate + cached input tokens × cached rate + billable output tokens × output rate) / 1,000,000. Eksemplerne ovenfor er illustrative og antager ingen caching.
Hvordan kan du reducere Gemini 4 Argon API-omkostninger?
Implicit cachelagring og genbrugte prompt-præfikser
Cachelagring reducerer udgifter til genbrugt input, ikke hele forespørgselsprisen. For eksemplet med 200K input / 60K output reducerer et fuldt berettiget input-cache-hit introduktions-udgiften til input fra $0.40 til $0.02. Den samlede token-omkostning bliver $0.62 i stedet for $1.00: en reduktion på 38%, selvom input-rabatten er 95%. Hvis 50% af input-tokens leveres fra cache, koster den samme forespørgsel $0.81: 100,000 cachelagrede input-tokens × $0.10 / 1M + 100,000 ikke-cachede input-tokens × $2 / 1M + 60,000 fakturerbare output-tokens × $10 / 1M = $0.01 + $0.20 + $0.60. Her refererer 50% specifikt til input-token-volumen. Betragt dette som scenarier og brug observeret cachet-token-forbrug til prognoser.
Google aktiverer implicit caching for prompts på mindst 4,096 tokens og understøtter ikke eksplicit cacheoprettelse for Argon. Bevar genbrugelige prompt-præfikser, men budgetter for ikke-cachet input, indtil observerede cache-træffere retfærdiggør et lavere estimat.
Tænkeniveauer og outputforbrug
Et kort synligt svar kan stadig medføre betydelige output-omkostninger, fordi tænkning er fakturerbar. Start med middel tænkning, og test derefter lavere og højere niveauer på repræsentative opgaver. Spor både kvalitet og samlet outputforbrug; vælg det laveste ræsonneringsniveau, der opfylder dine acceptkriterier.
Fordi tænkning og synligt output deler svargrænsen, kan en lav værdi for max_output_tokens efterlade utilstrækkelig plads til det endelige svar. Sammenlign succesfuld opgaveløsning ved hvert tænkningstrin, før du reducerer output-loftet.
Driftskontroller for Gemini 4 Argon-omkostninger
- Brug realistiske outputgrænser og undgå unødigt lange genereringer.
- Genbrug delte prompt-præfikser, når de er berettigede til implicit caching.
- Rut simple opgaver til billigere modeller og reserver Argon til de svære sager.
- Log samlede fakturerbare tokens, fejl, retries og omkostning pr. succesfuld opgave.
- Vurder økonomien ved standardpriser efter kampagneperioden, før du forpligter dig til en stor udrulning.
Hvordan får du adgang til Gemini 4 Argon?
Vælg Gemini-app-adgang til personligt interaktivt arbejde og en betalt API-vej til applikationer og automatiserede agenter. Argon er udelukket fra Gemini API Free tier; et Google AI Pro-abonnement alene giver ikke Argon API-adgang. Pro- og Ultra-app-rettigheder er adskilt fra API-token-fakturering, og Ultra er ikke påkrævet for den betalte Gemini API.
| Adgangsvej | Argon-adgang | Fakturering / rettighed |
|---|---|---|
| Gemini-app | Berettigede Pro- og Ultra-abonnenter | Abonnement og app-grænser |
| Google AI Studio | Berettigede Ultra-abonnenter eller betalte API-brugere | Afhænger af adgangsvej |
| Gemini API | Berettigede betalte projekter | Forbrugsbaseret API-fakturering |
| Google Antigravity | Berettigede Ultra-abonnenter | Produktspecifik rettighed |
| CometAPI | Understøttede CometAPI-konti | CometAPI-priser og -betingelser |
Direkte Gemini 4 Argon API-integration
Udviklere kan integrere Gemini 4 Argon direkte via et berettiget betalt Gemini API-projekt. Model-ID’et er gemini-4-argon. Denne vej er tiltænkt applikationer, automatiserede agenter og produktionsarbejdsgange, der kræver direkte adgang til Googles API, forbrugsbaseret fakturering og officielle API-funktioner.
Gemini API Free tier inkluderer ikke Argon. Google AI Pro-app-adgang giver heller ikke automatisk API-adgang eller API-kreditter. Udviklere bør konfigurere fakturering og berettigelse for projektet, der er knyttet til deres API-legitimationsoplysninger.
Fejl i godkendelse, fakturering eller berettigelse skal løses for det projekt, der ejer nøglen, før der forsøges igen; at ændre et forbrugerabonnement i sig selv konfigurerer ikke API-fakturering.
CometAPI-adgang til Gemini 4 Argon
Udviklere kan få adgang til Gemini 4 Argon API i CometAPI via en separat konto og API-nøgle. De praktiske fordele er uafhængig API-fakturering, adgang til flere modeller gennem én udbyder og de offentliggjorte input/output-priser sammenlignet ovenfor. Denne vej kræver ikke køb af Google AI Pro eller Ultra som forbrugerabonnement.
Kontobaseret adgang er ikke et løfte om ubegrænset kapacitet. Bekræft modeltilgængelighed, saldo, rate- og samtidighedsgrænser, understøttede regioner, caching, kontroller for tænkning og forbrugsrapportering for din CometAPI-konto. API-adgang låser heller ikke Argon op i Gemini-appen eller Antigravity.
Start med en lille forespørgsel via den valgte udbyder, verificér de returnerede model- og forbrugsfelter, og sæt derefter en forbrugsgrænse, før du øger trafikken.
Er Gemini 4 Argon prisen værd?
Gemini 4 Argon er en kandidat til krævende ræsonnering, kodning, research og langt kontekst-arbejde. Værdien afhænger af, om den forbedrer succesraten eller reducerer retries nok til at retfærdiggøre token-forbruget. Brug specifikationerne og de offentliggjorte benchmarks nedenfor til at identificere workloads, der skal testes, og vurder derefter kvalitet og omkostninger med dine egne prompts, tools og adgangsvej.
Gemini 4 Argon-specifikationer
| Specifikation | Gemini 4 Argon |
|---|---|
| Model-ID | gemini-4-argon |
| Udvikler | Google DeepMind |
| Modeltype | Ræsonneringsorienteret multimodal model |
| Samlet input + tænkning + output-vindue | Op til 1,048,576 tokens samlet |
| Tænkeniveauer | Lav / medium / høj |
| Standard tænkeniveau | Medium |
| Understøttelse af langt output | Baggrundskørsel; maksimum underlagt delt budget |
| Kontekst-cache | Implicit; berettigede prompts ≥ 4,096 tokens |
| Eksplicit cache | Ikke understøttet |
Million-token-grænsen deles mellem input, tænkning og genereret output. På Interactions API kræver generering af mere end 65,536 tokens både background=True og generation_config.max_output_tokens over 65,536. At sætte background=True alene hæver ikke standard-outputgrænsen. GenerateContent API understøtter også klient-side fortsættelse for lang dekodning
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Offentliggjorte benchmarks
Følgende værdier matcher Googles offentliggjorte evalueringsresultater. Det er leverandør-publicerede resultater samlet fra flere evalueringskilder og ikke en ny kontrolleret sammenligning udarbejdet til denne artikel.
| Offentligt benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Evalueringsbetingelser og sammenlignelighed
Googles evalueringsmetodologi bruger Gemini API på det højeste tænkeniveau, medmindre andet er angivet, generelt med pass@1. DeepSWE bruger mini-swe til Argon; konkurrenttal kommer fra ranglister eller systemkort. GraphWalks 256K–1M bruger 200 problemer. LVBench kører uden tools, med 1 FPS for Gemini, 800 frames for GPT-6 Astra og 600 for Opus 5.5. Vals-resultater kommer fra Vals AI; AutomationBench bruger Zapiers private-sæt-rangliste. Disse forskelle begrænser direkte sammenlignelighed.
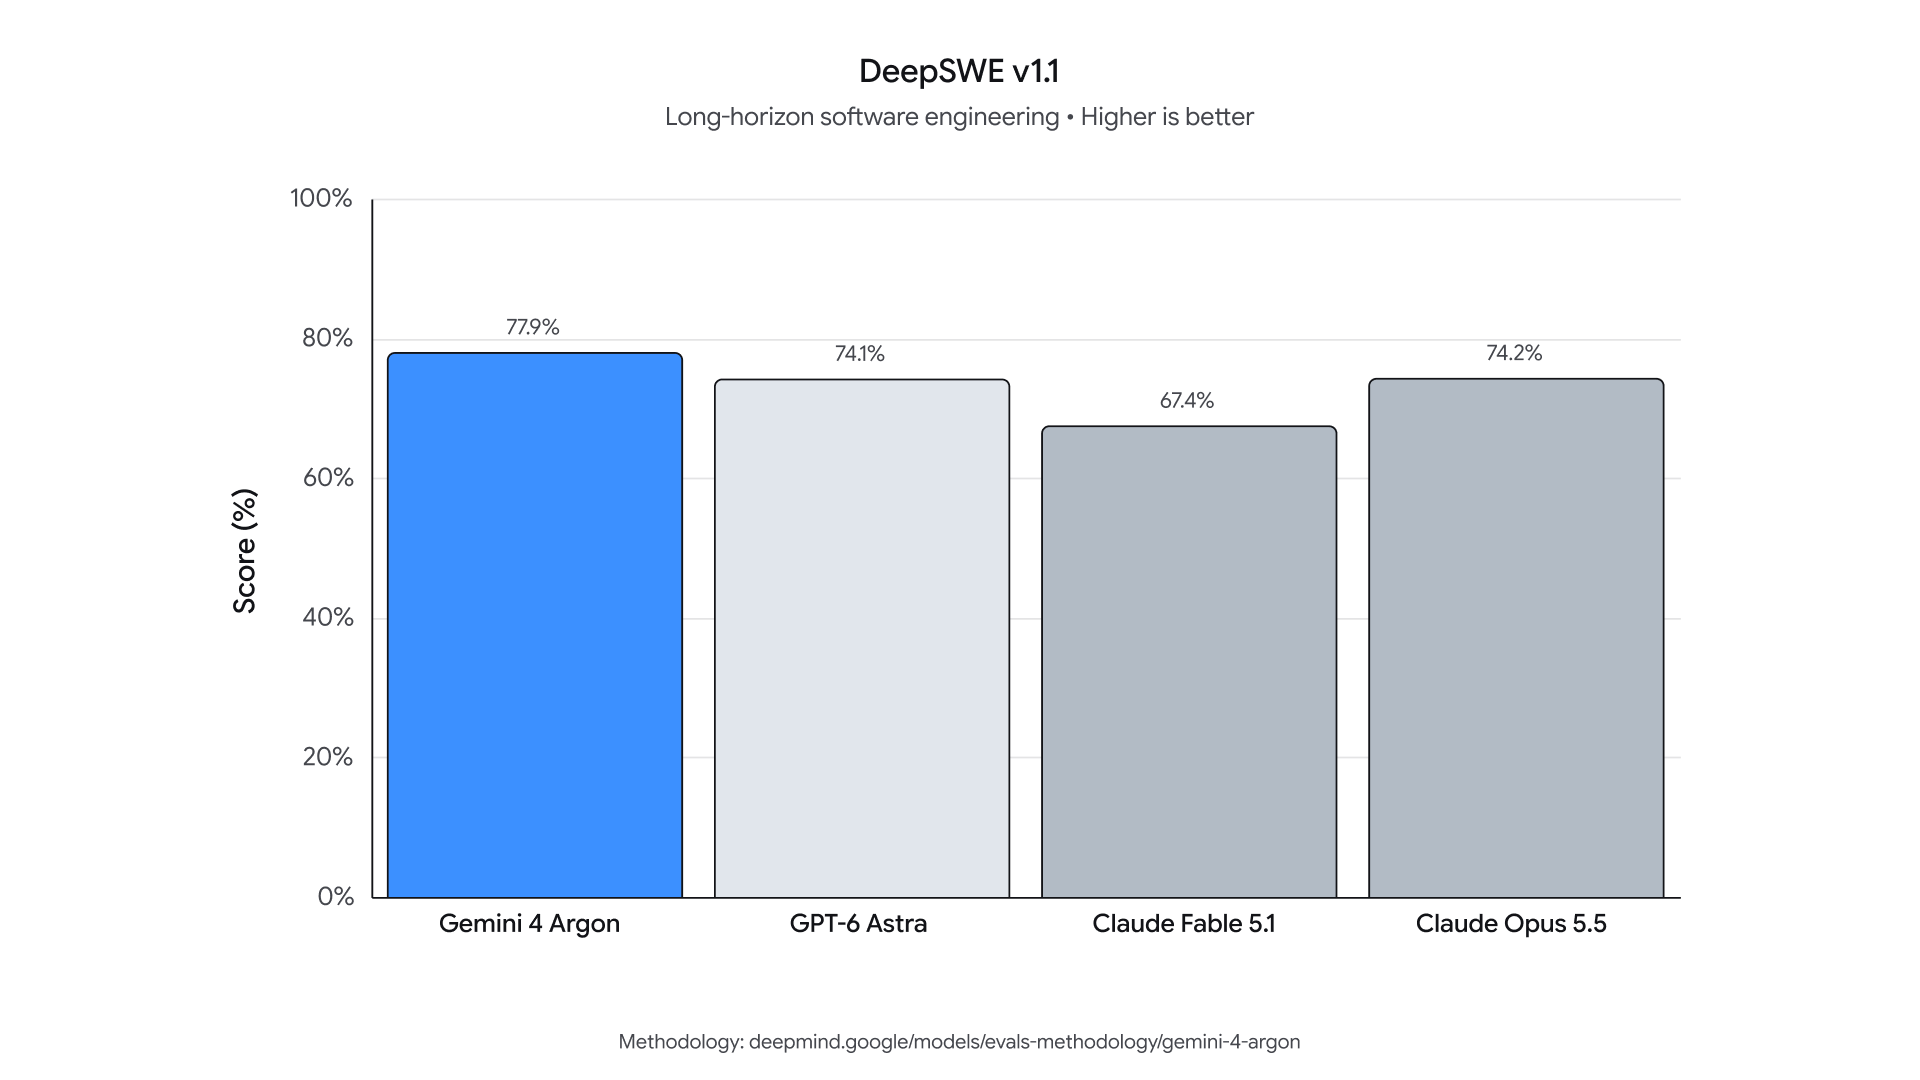
Googles originale DeepSWE v1.1-diagram viser Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) og Claude Opus 5.5 (74.2%), fra venstre mod højre. Tabellen ovenfor vælger tre af disse modeller; det officielle billede inkluderer alle fire.
Implikationer for ydeevne for Gemini 4 Argon-brugere
Fortolkning: Argon fører i de valgte rækker for Vals Index, AutomationBench, finansagent og lang kontekst; den fører ikke i FrontierSWE eller Terminal-bench. Fordi evalueringsrammer og prompts kan variere, bør disse resultater bruges som retningsgivende, og der bør køres arbejdsbelastningsspecifikke tests.
Til indkøb: mål omkostningen ved en succesfuld opgave sammen med nøjagtighed, latenstid, retries og tokenforbrug. En højere offentliggjort score beviser ikke lavere produktionsomkostninger under dine prompts, tools eller adgangsvej.
Vælg Gemini 4 Argon eller billigere model
Test Argon på svære ræsonnerings-, kode- og lang-kontekst-opgaver, hvor færre retries eller højere gennemførsel kan retfærdiggøre større tokenforbrug. Til rutinemæssig klassifikation, ekstraktion og højvolumen-summering bør billigere modeller testes først.
Sammenlign samlede omkostninger pr. succesfuld opgave, inkl. tænkning-tokens, cachebrug, tool-kald og retries. Vælg den model og adgangsvej, der opfylder dine kvalitetskrav til en acceptabel pris.
FAQ
Er Gemini 4 Argon Batch og Flex billigere end Standard?
Googles Argon Batch- og Flex-tokenpriser er $1 input og $5 output pr. million tokens til og med 30. november 2026, stigende til henholdsvis $2 og $10 bagefter. Cachet input er $0.05, stigende til $0.10. Dette er separate behandlingsmuligheder, så valider deres driftsmæssige begrænsninger i forhold til din workload, før du erstatter en Standard-integration.
Estimér Standard-, Batch- og Flex-forbrug separat med hver options gældende priser, og læg derefter subtotalerne sammen til et budget for en blandet workload.
Indeholder Gemini 4 Argon token-estimater søgeomkostninger?
Nej. Token-regnearternik alene udelukker separat fakturerede tjenester. Googles Search grounding charge er $14 pr. 1,000 forespørgsler efter den delte månedlige allowance på 5,000 requests for Gemini 3 og nyere modeller. En indsendt forespørgsel kan udstede mere end én søgeforespørgsel, så spor faktisk grounding-forbrug separat i stedet for at antage, at én brugerprompt er lig med én fakturerbar forespørgsel.
Hvordan bør jeg budgettere for Gemini 4 Argon på tværs af prisændringen?
Opdel forventet tokenforbrug i introduktions- og standardperioden, og anvend derefter hver periodes priser. For eksempel koster 10 millioner ikke-cachede input-tokens plus 1 million output-tokens $30 til introduktions-Standardpriser eller $60 bagefter. Hvis halvdelen af det volumen falder i hver periode, er token-estimatet $45. Læg værktøjer og retry-omkostninger til separat, og brug efter-kampagne-priser til et steady-state-budget.
Hvorfor kan et Gemini 4 Argon-svar stoppe, før det er færdigt?
Output-loftet inkluderer tænkning såvel som synlig tekst. En krævende prompt kan opbruge den ramme, før det endelige svar er færdigt. For lange svar fortsætter baggrundskørsel genereringen i etaper, indtil den er færdig eller når den konfigurerede grænse; der skal stadig være et tilstrækkeligt max_output_tokens. Tjek fuldførelsesstatus og forbrug, og justér derefter ræsonneringsdybde eller loftet i stedet for gentagne gange at sende den samme underbudgetterede forespørgsel.
Konklusion
Vælg adgang til Gemini 4 Argon efter arbejdsgang, og sammenlign derefter omkostningen ved at fuldføre en nyttig opgave. Googles app- og Antigravity-rettigheder adskiller sig fra betalt API-adgang. CometAPI tilbyder en separat API-vej med offentliggjorte input/output-priser 20% under Googles introduktions-Standardpriser, hvilket gør det til en praktisk mulighed for en lille, budgetteret evaluering. Bekræft kontogrænser og påkrævede funktioner, spor tænkning-tokens og retries, og skalér først, når kvalitet og samlede omkostninger opfylder dine behov.
