Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Google annoncerede Gemini 4 Carbon den 28. oktober 2026 med stærkere offentliggjorte resultater end Gemini 4 Argon på tværs af kodning, lang-kontekst-ræsonnering og cybersikkerhed. For udviklere afhænger det umiddelbare valg af adgang: Argon er tilgængelig via den betalte Gemini API, mens Carbon fortsat rulles ud i begrænset omfang. Denne sammenligning gennemgår deres benchmarks, API-specifikationer, hastighed og priser for at hjælpe dig med at beslutte, hvad du skal udrulle nu, og hvornår du skal evaluere Carbon.
Nøglepointer
Performance: Carbon scorer 59 mod Argons 50 på Artificial Analysis Intelligence Index v5.0. Gevinsterne varierer efter benchmark: SWE-sweep forbedres med 5,3 procentpoint, mens GraphWalks BFS F1 forbedres med 12,0 point.
API-specifikationer: Argon dokumenterer et samlet vindue på 1.048.576 tokens delt mellem input, tænkning og output. Carbons offentlige API-begrænsninger og værktøjsunderstøttelse er ikke annonceret.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Priser: Begge modeller har annonceret introduktionspriser på $2 pr. million input-tokens og $10 pr. million output-tokens. Argons tilbud løber til og med 30. november 2026; Carbons introduktionsslutdato er ikke annonceret.
Opgraderingsbeslutning: Sammenlign accept-rate for opgaver, end-to-end-latens og omkostning pr. accepteret resultat, når du evaluerer Carbon. Højere benchmark-scorer viser ikke i sig selv, om et skift vil forbedre din applikation.
Gemini 4 Carbon vs Gemini 4 Argon: Overblik og specifikationer
Start med udrulleringsbeslutningen: Argon har en dokumenteret API, du kan bruge nu, mens Carbon tilbyder stærkere offentliggjorte resultater med begrænset initial adgang.
Gemini 4 Carbon fokuserer på krævende ingeniør- og defensiv-cybersikkerheds-workflows, med initial adgang begrænset til udvalgte partnere. Gemini 4 Argon er tilgængelig via den betalte Gemini API til ræsonnering, kodning, videnskabelig problemløsning og agent-workflows. Tabellen nedenfor sammenligner deres API-specifikationer og annoncerede kapabiliteter.
Kontekst, ræsonnering og API-specifikationer
Argon har en offentliggjort udviklerspecifikation. Carbon har offentliggjort evalueringsresultater, men de resultater fastlægger ikke de præcise grænser eller værktøjsunderstøttelsen i en fremtidig offentlig API. Hverken delt familiebranding eller højere scorer fastslår, at modellerne bruger en identisk arkitektur.
Argons kontekstvindue på 1,048,576 tokens deles mellem input, tænkning og genereret output, så et større input efterlader mindre plads til generering. Dets standardgenereringsbudget er 65,536 tokens, inklusive tænkning og output. Længere genereringer bruger long decode, som genbehandler tidligere kontekst på tværs af fortsættelsestrin og tilføjer input-token-gebyrer; gentagen kontekst kan kvalificere til implicit caching-rabatter.
Med Interactions API kræver længere genereringer baggrundstilstand og en højere max_output_tokens-indstilling. Med GenerateContent skal klienten selv håndtere fortsættelsesanmodninger.
Gemini 4 Carbon vs Gemini 4 Argon: Ydeevne
Carbon fører over Argon på tværs af den rapporterede sammenligning, men størrelsen og betydningen af gevinsterne varierer efter opgave.
Officielle benchmark-resultater og testbetingelser
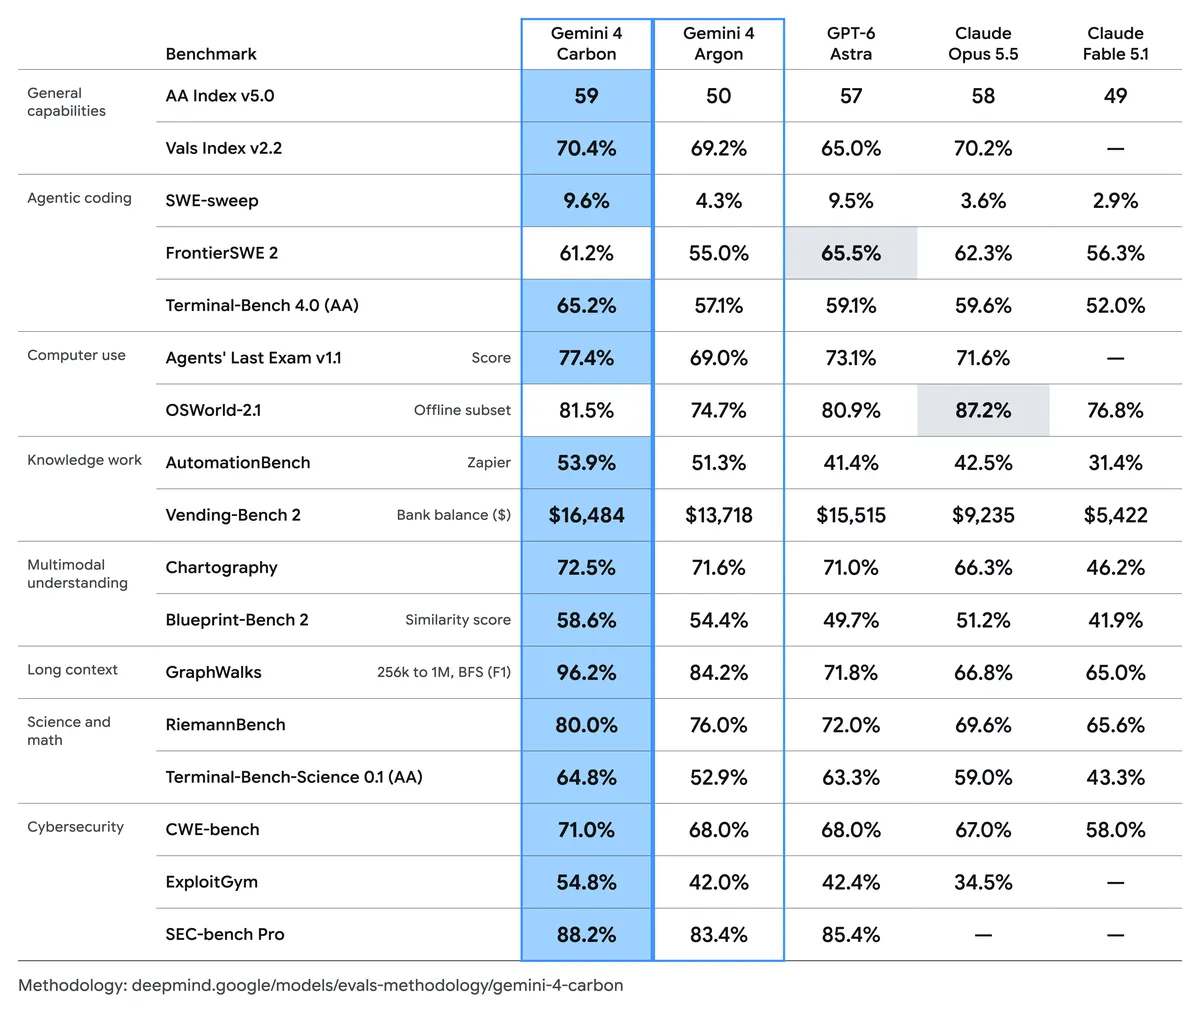
Googles offentliggjorte sammenligning viser Carbon foran i alle 17 rækker nedenfor. Den kombinerer Google-kørte evalueringer med scorer fra eksterne evaluatorer og benchmark-leaderboards; det er ikke et krav om, at Google selvstændigt har kørt hver test.
Evalueringsmetodologien bruger generelt den højeste tænkning-indstilling og pass@1, medmindre et benchmark angiver andet. Agent-scaffolding, opgavesubsets og scoredefinitioner varierer, så procenttal på tværs af forskellige benchmarks er ikke indbyrdes udskiftelige.
Benchmark og metrisk
Gemini 4 Carbon
Gemini 4 Argon
Carbon-fordel
Artificial Analysis Intelligence Index v5.0
59
50
+9 points
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline delmængde)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (kontosaldo)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = procentpoint. Vending-Bench 2 rapporterer en simuleret kontosaldo i stedet for nøjagtighed.
GraphWalks: 256K–1M-subsettet indeholder 200 problemer og rapporterer BFS F1 frem for en generisk nøjagtighedsrate.
Agents' Last Exam: Google bruger et 122-opgave v1.1-sæt, ALE-Claw-harness, et femtimers vindue og aktiverede sikkerhedsfiltre.
OSWorld: Den rapporterede figur bruger 82-opgave offline-subsettet, 1080p skærmbilleder, en 500-trins grænse og maksimum over tre enkeltforsøgs-kørsler. Den repræsenterer ikke hele online-benchmarket.
Kodningsydeevne og repository-arbejde
På Terminal-Bench 4.0 scorer Carbon 65.2% mod 57.1% for Argon, en føring på 8,1 procentpoint. Benchmarket tester kommandolinjearbejde og flertrins teknisk problemløsning.
På SWE-sweep scorer Carbon 9.6% mod 4.3% for Argon, en føring på 5,3 procentpoint og mere end dobbelt så høj en score.
Den relative forbedring er markant, men det absolutte resultat er stadig under 10%. Carbon er stærkere, men ikke universelt pålidelig på enhver vanskelig softwareingeniøropgave.
Praktiske kandidater til evaluering er debugging på tværs af repository, kode-migreringer og opgaver, der involverer gentagen værktøjsbrug og verifikation. For en produktions-kodebase er det stadig mere nyttigt at bestå dine egne tests end at ekstrapolere en succesrate fra et andet benchmark.
Multimodal og lang-kontekst-ydeevne
På GraphWalks 256K-1M BFS F1-evalueringen scorer Carbon 96.2% mod 84.2% for Argon, en føring på 12 procentpoint. Dette gør langdokument-syntese og repository-analyse til nyttige kandidater for evaluering. Hentekvalitet, dokumentstruktur og hvert endpoints faktiske grænser påvirker stadig resultatet.
På Chartography scorer Carbon 72.5% mod 71.6% for Argon, en føring på 0,9 procentpoint. På Blueprint-Bench 2 scorer Carbon 58.6% mod 54.4% for Argon, en føring på 4,2 procentpoint. Disse resultater for visuel forståelse understøtter test af dokument- og diagram-workflows, mens de understøttede inputformater i Carbons fremtidige offentlige API stadig kræver bekræftelse.
Cybersikkerhed og agentpålidelighed
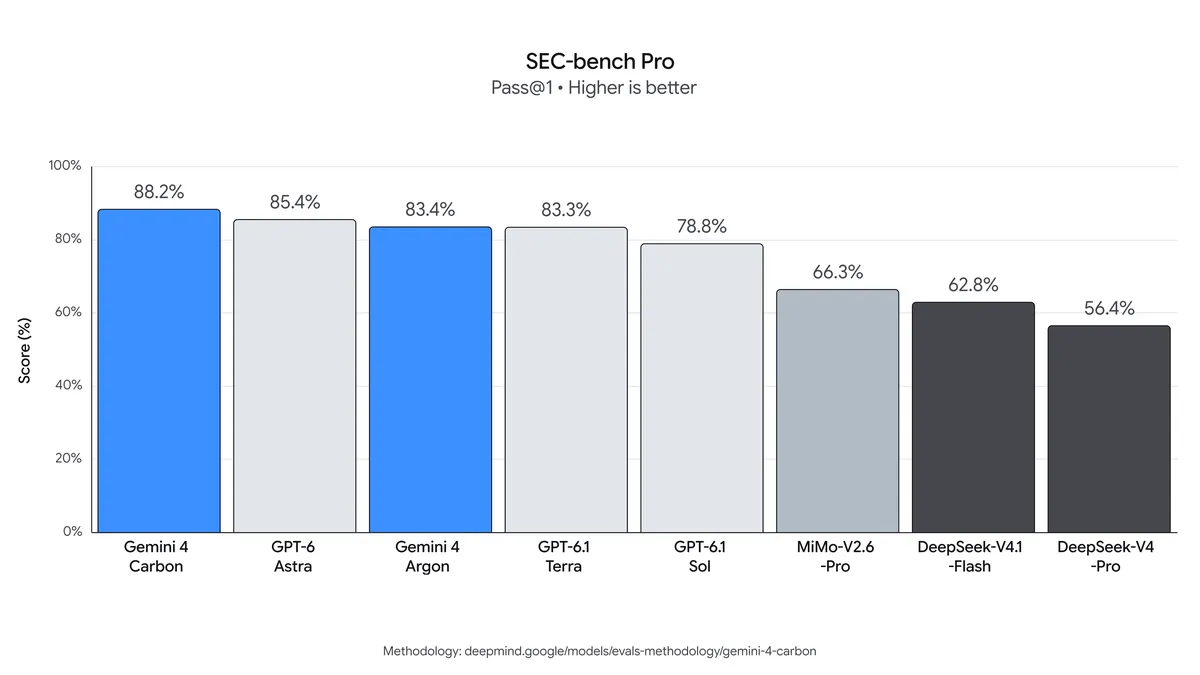
Sikkerhedsresultaterne dækker opdagelse, exploit-validering og afhjælpning: Carbon scorer 88.2% på SEC-bench Pro, 54.8% på ExploitGym og 71.0% på CWE-bench. Dets største fordel over Argon er på ExploitGym, med 12,8 procentpoint.
Betydningen af sikkerhedsevalueringsbetingelserne er stor: SEC-bench Pro bruger maj 2026 JavaScript-engine-splittet med 183 opgaver, mens ExploitGym bruger et offline, enkeltforsøgs agent-setup med afværgninger slået fra. Google rapporterer de eksterne sikkerhedsevalueringer uden driftsværn; disse scorer fastlægger ikke ubegrænset API-adfærd.
For langvarige agenter skal en nyttig model også rapportere fejl ærligt og holde sig inden for den autoriserede opgave. Google rapporterer en observeret succesfuld-snyd-rate på 0.0% på Terminal-Bench 4.0, mens forsøg på snyd lå på 0.4%. Deres interne evalueringer fandt også færre uunderbyggede påstande og lavere rater for overreach og under-service end Argon. Dette er evalueringsspecifikke observationer snarere end garantier for hver applikation.
I praksis bør du bevare tilladelsestjek, isoleret eksekvering, patch-gennemgang og uafhængig validering, når du evaluerer begge modeller til defensivt sikkerhedsarbejde.
Hastighed og latens
Ydelsesmåling
Gemini 4 Carbon
Gemini 4 Argon
Output-gennemløb
Cirka 102 tokens/s
Cirka 82 tokens/s
Tid til første token
Cirka 100 s
Cirka 47 s
Output-tokens pr. evalueret opgave
Cirka 123K
Cirka 116K
Tænkning-tokens pr. evalueret opgave
Cirka 72K
Cirka 68K
Disse tredjepartsmålinger beskriver evaluatorens testkonfiguration og er ikke en garanti for latens eller gennemløb for din API-implementering. Sammenligningen kan ændre sig, efterhånden som evaluator opdaterer sine resultater, og Google udvider adgangen til Carbon.
Carbons højere token-genereringsrate og længere ventetid til første token beskriver forskellige dele af en anmodning. For et chat-interface kan ventetiden før output begynder dominere oplevelsen; for et autonomt job bør du evaluere den samlede gennemførselstid sammen med succesraten. Gennemløb alene afgør ikke, hvilken model der afslutter en nyttig opgave hurtigst.
Gemini 4 Carbon vs Gemini 4 Argon: Omkostninger
Sammenlign officielle token-satser og udbyder-fakturering separat, og beregn derefter omkostningen for et accepteret resultat. Identiske offentliggjorte tokenpriser kan stadig give forskellige regninger, når tænkning, mislykkede forsøg og værktøjsbrug varierer.
API-priser efter udbyder
Begge modeller har de samme annoncerede introduktions-token-satser hos Google. CometAPI opfører separate Argon-satser; den har ingen bekræftet Carbon-pris i denne sammenligning. Alle udbyderpriser nedenfor afspejler artiklens øjebliksbillede pr. 29. oktober 2026.
Udbyder
Priskategori
Gemini 4 Carbon
Gemini 4 Argon
Google
Introduktion, input / 1M tokens
$2.00
$2.00
Google
Introduktion, output inkl. tænkning / 1M tokens
$10.00
$10.00
Google
Introduktion, cachet input / 1M tokens
$0.10
$0.10
Google
Efterfølgende input / 1M tokens
$4.00
$4.00
Google
Efterfølgende output inkl. tænkning / 1M tokens
$20.00
$20.00
Google
Efterfølgende cachet input / 1M tokens
$0.20
$0.20
Google
Introduktionsperiode
Slutdato ikke annonceret
Til og med 30. november 2026
Google
Offentlig produktionsadgang
Begrænset udrulning
Tilgængelig
CometAPI
Almindeligt input / 1M tokens
Ikke bekræftet
$1.60
CometAPI
Almindeligt output / 1M tokens
Ikke bekræftet
$8.00
Argons introduktionsperiode hos Google slutter den 30. november 2026, med efterfølgende satser gældende fra 1. december. Carbon har ingen annonceret introduktions-slutdato. Dets cachet-input-tal er beregnet ud fra den annoncerede 95% rabat; implementerings- og berettigelsesdetaljer afventer.
Før du estimerer en regning, skal du bekræfte satser, caching-regler, lang-kontekst-gebyrer og værktøjsunderstøttelse for den udbyder og konto, du har valgt. Googles annoncerede Carbon-satser fastlægger ikke en CometAPI-Carbon-pris.
Omkostningseksempel: 1.000 forespørgsler
For en forespørgsel med 100,000 input-tokens og 25,000 samlede fakturerbare output-tokens, inklusive tænkning-tokens, giver introduktionsstandardpriser:
Total: $0.45 pr. forespørgsel, eller $450 for 1,000 identiske forespørgsler.
Ved de efterfølgende satser koster den samme opgave $0.90. Hvis 25,000 kun beskriver det endelige synlige svar, skal du lægge eventuelle separat medregnede tænkning-tokens til, før du estimerer regningen. Eksemplet udelader grounding, eksterne værktøjer og andre servicegebyrer.
Ved de viste CometAPI-Argon-satser koster den samme forespørgsel med 100,000 input og 25,000 fakturerbart output $0.16 + $0.20 = $0.36, eller $360 for 1,000 identiske forespørgsler. Dette estimat udelader cacheeffekter, retries og separate servicegebyrer; det estimerer ikke en Carbon-implementering via CometAPI.
Omkostning pr. accepteret opgave = samlet model- og værktøjsforbrug ÷ accepterede opgavefærdiggørelser. Definér acceptkriterier før test, medtag mislykkede forsøg og retries i forbruget, og registrér menneskelig gennemgangstid separat.
Hvor kan du få adgang til Gemini 4 Carbon og Gemini 4 Argon?
Officiel udbyderadgang
Pr. 29. oktober 2026 er Argon tilgængelig via Gemini API og Google AI Studio. Carbon er indledningsvist begrænset til udvalgte cybersikkerhedsforsvarere og betroede partnere; et generelt tilgængeligt udvikler-endpoint og bredere udgivelsesdato er ikke bekræftet. Start med den rute, der er aktiveret for din konto, og tjek dens model-identifikator og understøttede funktioner.
Adgang via CometAPI
Gemini 4 Argon API i CometAPI giver en ekstra integrationsrute for udviklere, der bruger et kompatibelt chat-interface.
For at komme i gang skal du oprette en CometAPI API-nøgle, vælge modellen gemini-4-argon og konfigurere din applikation til at bruge udbyderens dokumenterede chat-endpoint. Begynd med en repræsentativ tekstanmodning, gennemgå svaret og tjek forbrug og gebyrer, før du udvider arbejdsbyrden.
CometAPI anvender sine egne priser. Bekræft understøttelse af værktøjer, ræsonneringskontroller og lange svar på den rute, du planlægger at bruge. Et kompatibelt chat-interface fastslår ikke understøttelse af hver native Gemini-funktion.
Carbons tilgængelighed via CometAPI og produktionsmodel-identifikator er ikke bekræftet pr. 29. oktober 2026. Hold Argon operationel og skift først, når udbyderen dokumenterer Carbon-adgang, og din integration består de relevante tjek.
Skal du vælge Gemini 4 Carbon eller Argon?
Arbejdslast
Praktisk udgangspunkt
Hvad du skal validere
En applikation, der skal i drift nu
Argon
Accept-rate for opgaver, endpoint-adfærd og driftsomkostning
Kompleks debugging eller kode-migreringer
Evaluer Carbon, når der er adgang
Repository-tests, kvalitet af gennemgang og retries
Autoriseret sårbarhedsforskning
Evaluer Carbon inden for det tilladte adgangsprogram
Sikkerhedskontroller, fundenes gyldighed og patch-korrekthed
Analyse af store dokumenter eller kodebaser
Argon-baseline; Carbon som kandidat
Evidensnøjagtighed og udeladelser på tværs af identiske kilder
En interaktiv brugergrænseflade
Benchmark det tilgængelige Argon-endpoint først
Ventetid til første token og total tid under reel trafik
Valg af udgangspunkt og opgraderingskandidat
Vælg Argon, når du skal udrulle nu. Dets tilgængelige API og dokumenterede kontekst, modaliteter og værktøjer lader dig teste den komplette applikation, inklusive latens og omkostninger.
Evaluer Carbon, når der er adgang, og arbejdet retfærdiggør det. Prioritér vanskelige repository-ændringer, lang-kontekst-syntese eller autoriserede defensive sikkerhedsopgaver. Opgrader, når det leverer flere accepterede patches eller fund, færre retries eller mindre gennemgangsarbejde inden for dine latens- og budgetgrænser.
En Argon-baseline og en Carbon-opgraderingsplan
Hold Argon-workflowet operationelt, mens du opbygger et fast sæt repræsentative opgaver. Når Carbon bliver tilgængelig via en understøttet rute, skal du køre de samme opgaver med sammenlignelige værktøjstilladelser og acceptkriterier. Byg ikke automatisk failover til et begrænset eller udokumenteret endpoint; træf routingbeslutninger først efter, at kompatibilitet og arbejdsbyrderesultater er fastlagt.
Produktions-evaluering
Hold evalueringssættet fastlåst, når du sammenligner modeller. Registrér modelversion, tænkning-indstilling, prompt, værktøjstilladelser, tokenforbrug, ventetid til første token, total varighed og om resultatet bestod gennemgangen. En højere benchmark-score er nyttig evidens for at vælge, hvad der skal testes; udgivelsesbeslutningen bør følge resultaterne på din arbejdsbyrde.
Medtag rutineforespørgsler og vanskelige tilfælde, hvor fejl ville være dyre.
Gentag opgaver og alterner modelrækkefølge for at reducere indflydelsen af enkeltstående resultater.
Mål median og hale-latens, tokenforbrug, retries og accepterede udfald på tværs af hele workflowet.
Sæt retry-grænser og eskaleringsbetingelser baseret på observerbare valideringsresultater.
Konklusion
Den nyttige opgradering er den, der forbedrer dit udførte arbejde. Vælg et lille sæt repræsentative opgaver, definér hvad der tæller som et acceptabelt resultat, og mål model- og gennemgangsomkostning samlet. Når Carbon bliver tilgængelig på din konto, vil de samme opgaver vise, om dens benchmark-gevinster oversættes til nok værdi til at retfærdiggøre et skifte.
FAQ
Kan en Argon-prompt genbruges uændret med Carbon?
Den kan være et udgangspunkt for evaluering, men det er ikke evidens for kompatibel API-adfærd. Hold opgaven og acceptkriterierne konsistente, og verificér derefter Carbons dokumenterede model-identifikator, anmodningsskema, værktøjsformat og grænser, når der er adgang. Genbrug af prompts og integrationskompatibilitet er separate spørgsmål.
Bør ræsonneringsindstillinger matches, når modellerne sammenlignes?
Match dem, hvor endpoints eksponerer sammenlignelige kontroller, og registrér eventuelle forskelle. Googles benchmark-resultater med højeste tænkning beskriver en særlig evalueringsopsætning; de forudsiger ikke kvaliteten eller latensen af en Argon-implementering, der kører på dens standardindstilling medium. Argon thinking controls tilbyder low, medium og high niveauer, så sammenlign både den laveste indstilling, der opfylder din applikations accepttærskel, og en maksimum-kvalitetskonfiguration.
Kan en benchmark-føring fastslå en produktionsservicegaranti?
Nej. Benchmark-ydeevne fastlægger ikke et endpoints oppetidstilsagn, regionale tilgængelighed, datahåndteringsvilkår eller supportaftaler. Gennemgå disse vilkår med din valgte udbyder separat, og test forventede forespørgselsstørrelser og trafikmønstre, før du baserer en kritisk workflow på nogen af modellerne.