
TL;DR
GLM-5.3 Flash er det bedre standardvalg til de fleste produktionsarbejdsbelastninger: den tilføjer indbygget visuel input og et kontekstvindue på 1M tokens, mens dens standardlistepris er dramatisk lavere. GLM-5.3 forbliver det stærkere valg, når maksimal kodedybde, svære langsigtede ræsonnementer eller cybersikkerhedsydelse vægter højere end enhedsomkostning.
Dette er ikke en historie om lille model versus stor model. Flash er en 320B total/18B aktiv MoE trænet fra en ny multimodal base med hybrid spars og lineær attention. Flagskibet er en 744B total/40B aktiv MoE, hvor GLM-5.3-forbedringerne kommer fra skaleret eftertræning på GLM-5.2-basen.
Key Takeaways
- Vælg Flash til multimodal kodning, dokumentforståelse, browser- eller GUI-agenter, højvolumen-automation og omkostningsfølsomme applikationer.
- Vælg flagskibet til de sværeste ingeniøropgaver på repository-niveau, dybere værktøjsassisteret ræsonnement og defensiv sikkerhedsforskning.
- Begge modeller understøtter 1M-token kontekst, always-on reasoning, funktionskald, streaming og open-weight-udrulning.
- På matchede Z.ai-rapporterede benchmarks fører flagskibet DeepSWE, NL2Repo, HLE med værktøjer og Agents’ Last Exam; Flash fører AutomationBench, Toolathlon og GDPval-AA v2.
- Uafhængige tests giver flagskibet et højere Intelligence Index og hurtigere output, mens Flash har en lidt bedre tid til første token og langt lavere blandet pris.
GLM-5.3 Flash vs GLM-5.3 ved et overblik
| Dimension | GLM-5.3 Flash | GLM-5.3 | Praktisk resultat |
|---|---|---|---|
| Positionering | Effektiv indfødt-multimodal kodnings- og agentmodel | Flagskibs tekst-ræsonnement, kodning, langsigtede agenter, cybersikkerhed | Afhænger af arbejdsbelastning |
| Modelstørrelse | 320B total / 18B aktiv | 744B total / 40B aktiv | Flash aktiverer 55% færre parametre |
| Basemodel | Nyligt trænet 30T-token multimodal base | Samme base som GLM-5.2; forbedringer fra eftertræning | Forskellige udviklingsveje |
| Input / output | Tekst + visuelle input / tekstoutput | Tekstinput / tekstoutput | Flash til visuelle workflows |
| Kontekst / maks. output | 1M / 128K | 1M / 128K | Uafgjort |
| Ræsonneringsindsats | low, high, max; ræsonnement altid aktiveret | low, high, max; ræsonnement altid aktiveret | Uafgjort |
| Uafhængig Intelligence Index | 57 | 60 ved max indsats | GLM-5.3 |
| Uafhængig outputhastighed | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 i testet API |
| Officiel listepris input/output | $0.15 / $0.50 pr. 1M tokens | $1.40 / $4.40 pr. 1M tokens | Flash |
| Bedste anvendelse | Standardrouting, multimodale agenter, skalering | De mest kritiske komplekse tekst- og sikkerhedsopgaver | Brug selektiv routing |
Kilder: Z.ai modeldokumentation og Artificial Analysis-sammenligning.
Hvad er GLM-5.3 Flash?
Z.ai positionerer Flash som den første indfødte multimodale model i GLM-5-serien. Den har 320B samlede parametre og 18B aktive parametre, men “Flash” skal ikke læses som “lille”. Den fulde checkpoint er stadig en meget stor model; dens effektivitet kommer af at aktivere et mindre ekspertsæt og redesigne attention-stakken.
Dens basemodel blev trænet på et 30 billioner tokens multimodalt korpus. Indfødt vision er integreret i kodningssløjfen, så modellen kan inspicere skærmbilleder, gengivne interfaces, diagrammer, sidelayouts og anden visuel feedback, før den forfiner sin næste handling.
GLM-5.3 Flash-specifikationer
| Specifikation | GLM-5.3 Flash |
|---|---|
| Udvikler | Z.ai / Zhipu AI |
| Model-ID | glm-5.3-flash |
| Modeltype | Indfødt multimodal Mixture-of-Experts |
| Samlede / aktive parametre | 320B / 18B |
| Lag | 45 |
| Arkitektur | Hybrid spars attention + lineær attention; mHC; MTP |
| Træningskorpus | 30T-token multimodal pre-training korpus |
| Inputmodaliteter | Tekst og visuelle input, inkl. billeder og understøttede video-/filworkflows |
| Outputmodalitet | Tekst |
| Kontekst / maks. output | 1M / 128K tokens |
| Ræsonnement | Altid aktiveret; low, high, max indsats |
| Værktøjer | Funktionskald, streaming-værktøjskald, strukturerede workflows |
| Vægte / licens | Åbne vægte; Apache-2.0 i det officielle repository |
Kilder: Z.ai Flash-dokumentation og det officielle GLM-5-repository.
Hvad er GLM-5.3?
Flagskibsmodellen er optimeret til kompleks software engineering, langsigtede agenter og cybersikkerhed. Z.ai siger, at den bruger samme basemodel som GLM-5.2; opgraderingen kommer fra skaleret eftertræning i stedet for et nyt pre-training-run.
Det officielle repository angiver checkpointet til 744B samlede parametre med 40B aktive. Sammenlignet med Flash aktiverer den mere end dobbelt så mange parametre pr. token og allokerer mere kapacitet til svære flertrinsræsonnementer.
GLM-5.3-specifikationer
| Specifikation | GLM-5.3 |
|---|---|
| Udvikler | Z.ai / Zhipu AI |
| Model-ID | glm-5.3 |
| Modeltype | Flagskibs tekst Mixture-of-Experts-model |
| Samlede / aktive parametre | 744B / 40B |
| Basemodel | GLM-5.2-base; alle GLM-5.3-forbedringer fra eftertræning |
| Input / output | Tekst / tekst |
| Kontekst / maks. output | 1M / 128K tokens |
| Ræsonnement | Altid aktiveret; low, high, max indsats |
| Værktøjer | Funktionskald, streaming-værktøjskald, kontekstcaching, struktureret output |
| Primært fokus | Kompleks kodning, langsigtede agenter, engineering, cybersikkerhed |
| Vægte / licens | Åbne vægte under den separate GLM-5.3 License; understøttende repository-kode under Apache-2.0. |
Kilder: Z.ai flagskibsdokumentation og det officielle GLM-5-repository.
Arkitektur: Hvorfor Flash er billigere uden at være lille
Flash skifter mellem lineære attention-blokke og spars-attention-blokke og bruger mHC omkring attention- og MoE-komponenter. Dens IndexPool-mekanisme komprimerer fire indexer key-vektorer til én. Z.ai rapporterer 3.01× lavere attention-beregning pr. lag og en 4.44× mindre KV-cache pr. lag end flagskibet ved en sekvenslængde på 1M tokens.
Dette er arkitekturniveau-sammenligninger, ikke garanterede ende-til-ende latenstidsmultiplikatorer. Reel API-hastighed afhænger også af hardware, kvantisering, batching, længden af ræsonnement, servingsoftware og udbyderbelastning.
GLM-5.3-Flashs hybride attention-arkitektur og sammenligning af beregning/cache ved lang kontekst.
Kilde: Z.ai officiel arkitekturdokumentation
Benchmark-ydelse: Hvor hver model vinder
Den reneste sammenligning adskiller leverandørrapporterede opgavebenchmarks fra uafhængige API-målinger. Selv når benchmarknavne matcher, kan harness-versioner, værktøjskonfigurationer, kontekststyring og ræsonneringsindsats variere. Tabellen nedenfor bruger de tættest matchede værdier i flagskibsevalueringen og Flash-evalueringen og behandler små huller som retningsgivende frem for definitive.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Højere score | Hvad den tester |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Terminal- og agentisk kodning |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Software engineering |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Repositorygenerering |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Værktøjsbrug |
| AutomationBench | 48.8 | 48.2 | Nær uafgjort / Flash | Computerbrugs-automation |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Langsigtet agentræsonnement |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Svært værktøjsassisteret ræsonnement |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Nær uafgjort / Flash | Professionelt vidensarbejde |
Kilder: flagskibsevaluering og Flash-evaluering. Sammenlign retningsgivende, da evalueringsopsætninger kan variere.
Kodning og repository-arbejde
Flagskibet har den højere ydelsesloft. Det ligger 3.5 point foran Flash på DeepSWE og 1.7 point på NL2Repo. På Z.ai Code Bench v1.0, hvor begge modeller evalueres med Claude Code 2.1.207, når flagskibet 34.5% ved max indsats, mens Flash når 29.0% — en fordel på 5.5 point.
Flash er stadig konkurrencedygtig nok til at være den første model, der testes til rutinemæssig repository-vedligeholdelse, testgenerering, debugging, refaktorering og højvolumen kodningsagenter. Eskaler kun de sværeste opgaver eller mislykkede forløb til flagskibet.
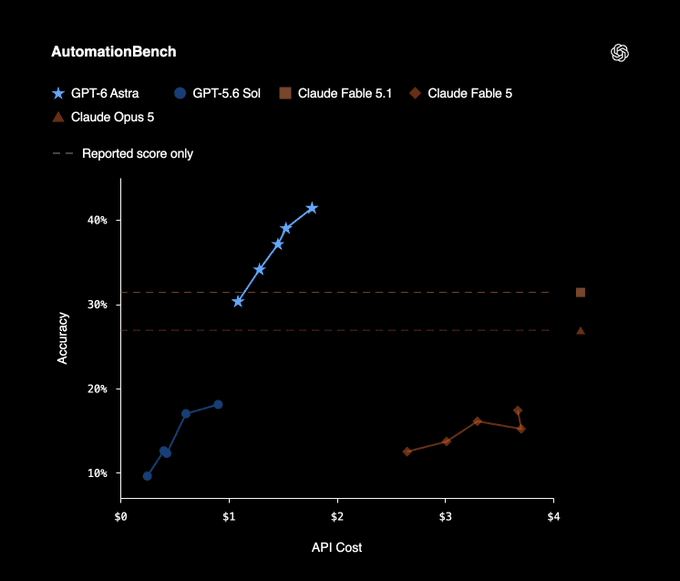
Z.ai’s seks-benchmark-evaluering af GLM-5.3-Flash og andre kodnings-/agentmodeller.
Kilde: Z.ai officiel Flash-dokumentation
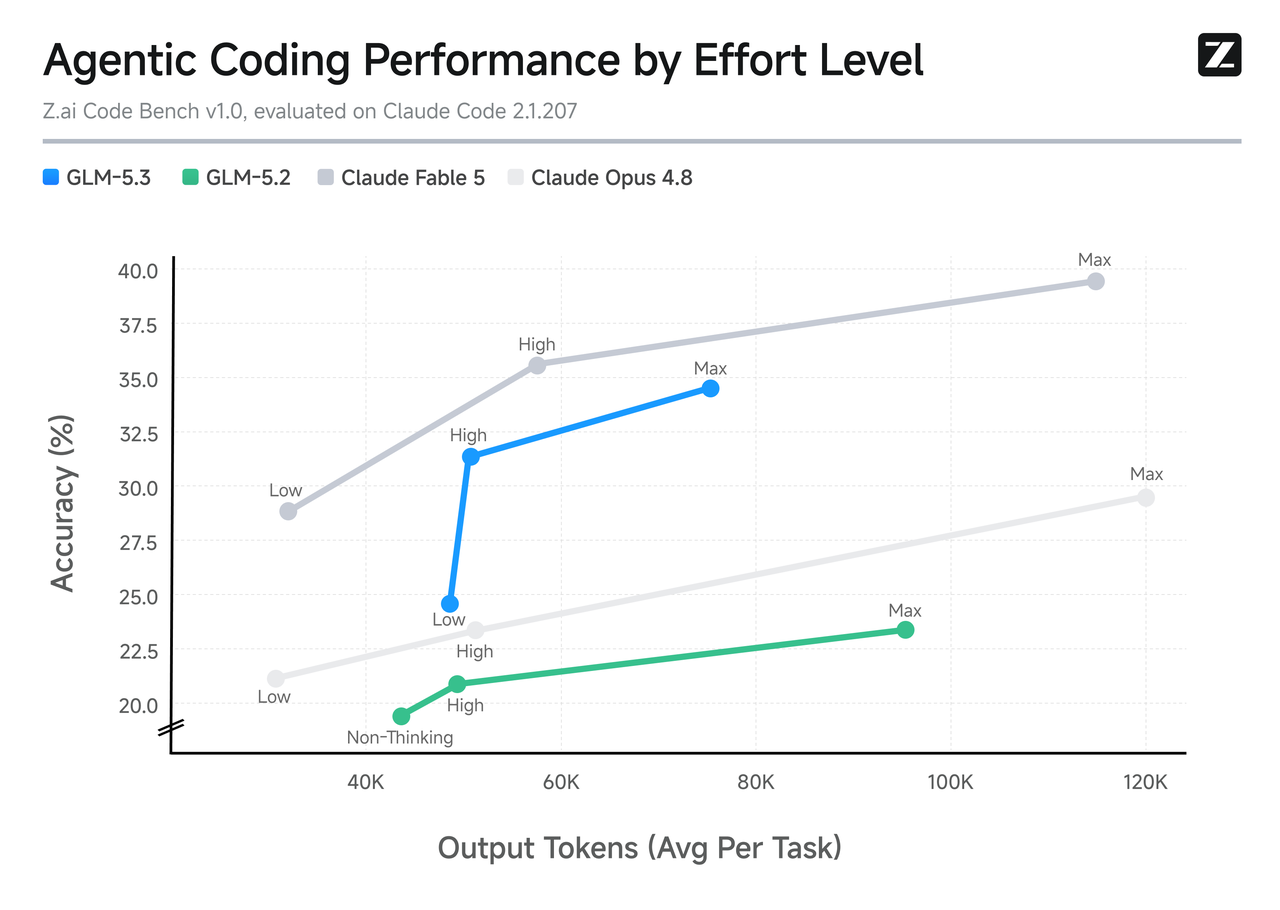
GLM-5.3 agentisk kodningsnøjagtighed og output-tokenforbrug på tværs af ræsonneringsniveauer.
Kilde: Z.ai officiel flagskibsdokumentation
Værktøjsbrug, automation og vidensarbejde
Flash er ikke konsekvent svagere. Den scorer 78.4 på Toolathlon Verified mod 73.0 for flagskibet og snupper AutomationBench 48.8 mod 48.2. Den er reelt uafgjort på GDPval-AA v2. Dette gør Flash særlig attraktiv, når opgaven mindre handler om én ekstremt svær ræsonneringskæde og mere om pålideligt at koordinere værktøjer på tværs af mange billige forespørgsler.
Uafhængig intelligens, hastighed og latenstid
| Uafhængig måling | GLM-5.3 Flash | GLM-5.3 (max) | Resultat |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Outputhastighed | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Tid til første token | 1.49 s | 1.61 s | Flash |
| Kontekstvindue | 1M | 1M | Uafgjort |
| Blandet pris i AA-sammenligning | $0.10 / 1M tokens | $0.90 / 1M tokens | Flash |
Kilde: Artificial Analysis matchet API-sammenligning.
Det uafhængige resultat tilføjer en vigtig korrektion til antagelsen “Flash betyder hurtigere”. Flash svarer en anelse tidligere, men den testede flagskibsendpoint genererer tokens hurtigere, når output først begynder. Behandl disse målinger som udbyderspecifikke øjebliksbilleder, ikke uforanderlige model-egenskaber.
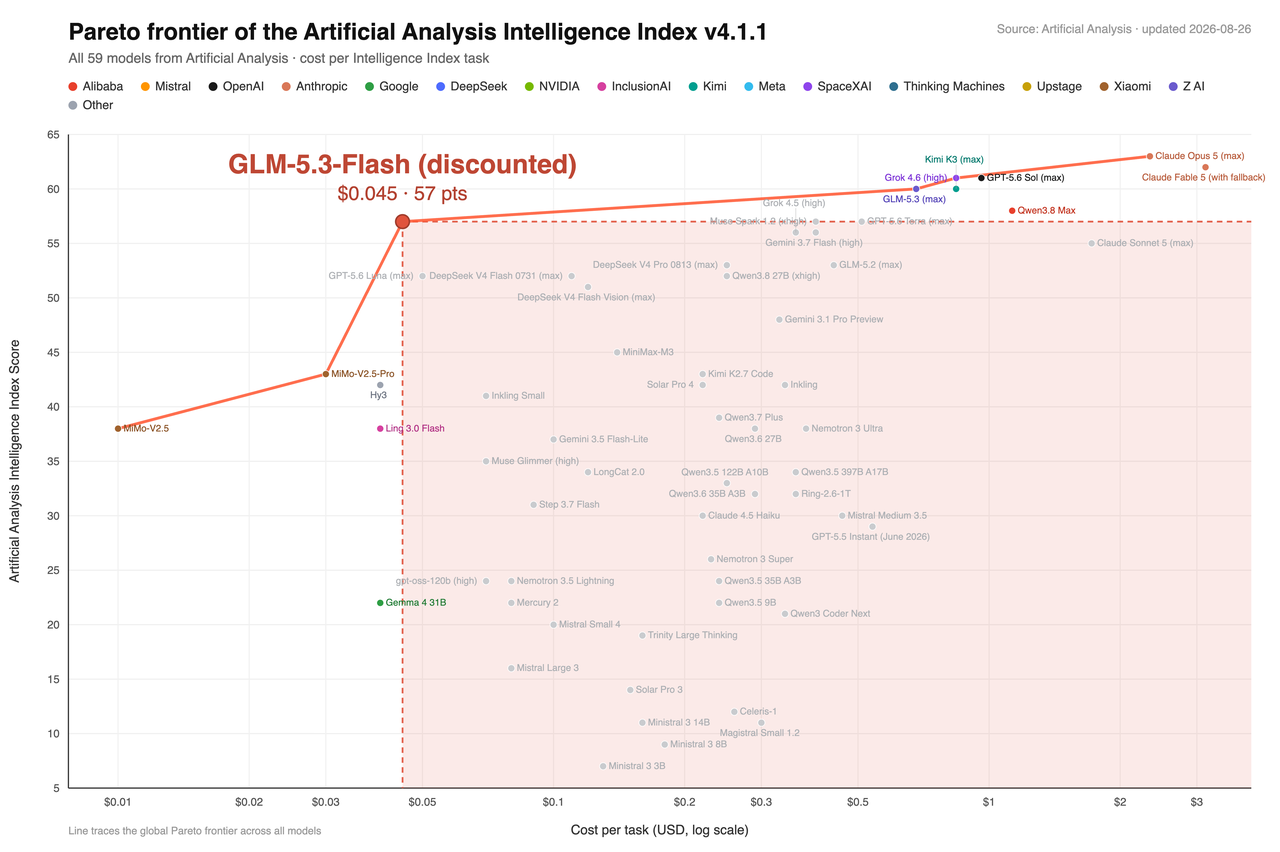
Artificial Analysis’ cost–intelligence frontier gengivet i Z.ai’s officielle Flash-dokumentation.
Kilde: Z.ai officiel Flash-dokumentation
Multimodalitet: Flash har den klare fordel
Flash accepterer visuelle input og integrerer dem i agentiske workflows. Den kan inspicere skærmbilleder, sidebilleder, diagrammer, interfacestater, skærmoptagelser og understøttede filer, og derefter bruge den visuelle evidens under kodning eller værktøjsbrug. Flagskibet understøtter i øjeblikket kun tekstinput.
- Frontend og design-til-kode: Flash kan inspicere et referenceskærmbillede og validere den gengivne implementering.
- Dokument- og Office-workflows: Flash kan ræsonnere om sidelayout, diagrammer, layout og billedplacering.
- Browser- og computerbrug: Flash kan kombinere visuel tilstand med værktøjsopkald og iterative korrektioner.
- Tekst-only repository-arbejde: flagskibet forbliver at foretrække, når input er kode og tekst, og opgaven kræver maksimal ræsonneringsdybde.
Lang kontekst og styring af ræsonnement
GLM-5.3 Flash understøtter et kontekstvindue på 1M tokens og op til 128K outputtokens; GLM-5.3 giver de samme grænser. Begge holder ræsonnement aktiveret og accepterer low, high og max indsatsniveauer. Z.ai anbefaler max til svær kodning og benchmarkreproduktion.
Kontekstkapacitet er derfor ikke den primære differentiering. Forskellen er, hvor økonomisk hver model betjener lange sekvenser, og hvor meget ræsonneringskapacitet den kan bringe til de sværeste opgaver. Flash er arkitektonisk billigere ved lang kontekst; flagskibet har det stærkere kvalitetsloft.
Cybersikkerhed: GLM-5.3 er specialisten
Cybersikkerhed er flagskibets mest markante kapabilitet. Z.ai rapporterer 84.5 på CyberGym og 54.4 på ExploitBench. Under normaliserede budgetter på to og seks timer fuldførte den 105 og 130 ExploitGym-opgaver.
Flash har ikke et tilsvarende lanseringsfokus eller matchet offentlig cybersuite. Til kodegennemgang, sikker udvikling og autoriseret sårbarhedsopdagelse bør flagskibet bruges som primær model, med menneskelig godkendelse, isolerede værktøjer, revisionslog og disclosure-kontrol i workflowet.
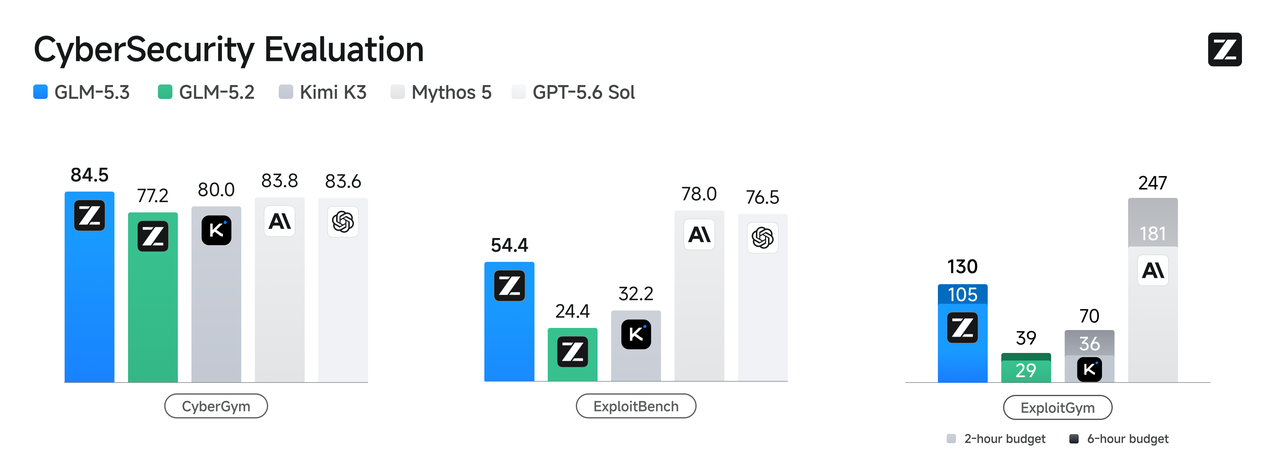
GLM-5.3-ydelse på tværs af benchmarks for sårbarhedsopdagelse og udnyttelseskæder.
Kilde: Z.ai officiel cybersikkerhedsdokumentation
Omkostninger og udrulning
API-prisfastsættelse
Z.ai lister Flash til $0.15 pr. million inputtokens og $0.50 pr. million outputtokens før promotioner, sammenlignet med $1.40 og $4.40 for flagskibet.
| Adgangsvej | Flash input | Flash cached | Flash output | 5.3 input | 5.3 cached | 5.3 output |
|---|---|---|---|---|---|---|
| Z.ai standardliste | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Z.ai promokurs for Flash | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| CometAPI-vej | $0.06 | Check live route | $0.20 | $1.12 | Check live route | $3.528 |
Priser er USD pr. 1M tokens. Kilder: Z.ai-priser, Flash-vej og GLM-5.3-vej. Promotioner kan ændre sig.
Eksempel på månedlig omkostning
For en arbejdsbelastning med 100M inputtokens og 20M outputtokens giver de aktuelle CometAPI-satser en estimeret $10.00 for Flash mod $182.56 for flagskibet, før effekter af cache eller værktøjsomkostninger. Flash reducerer tokenregningen med cirka 94.5% i dette eksempel.
| Omkostningskomponent | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Inputomkostning | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Outputomkostning | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Total | $10.00 | $182.56 |
Åbne vægte og selv-hosting
Begge modeller har downloadbare FP8- og BF16-checkpoints. GLM-5.3 Flash-vægte er udgivet under MIT License. GLM-5.3 bruger den separate GLM-5.3 License, som kræver sikkerhedsreview før kommerciel brug af Model-as-a-Service-operatører, hvis samlede omsætning overstiger US$10 milliarder over enhver sammenhængende 12-måneders periode. Det understøttende GLM-5 GitHub-repository er licenseret under Apache-2.0.
Flash er lettere at serve end flagskibet, men det er ikke en forbruger-GPU-model. Checkpointet på 320B, multimodale komponenter, KV-cache og 1M kontekst kræver stadig seriøs infrastruktur. Selv-hosting er mest attraktivt, når datakontrol, tilpasset serving eller vedvarende høj udnyttelse retfærdiggør driftsomkostningen.
Hvilken model skal du vælge?
Vælg GLM-5.3 Flash hvis?
- Du har brug for forståelse af billeder, skærmbilleder, diagrammer, dokumenter, browser eller GUI.
- Du kører højvolumen kodningsagenter, forskningsworkflows eller forretningsautomation.
- Du vil have stærk værktøjsbrug og vidensarbejdsydelse til lavest mulige tokenomkostning.
- Du har brug for et 1M kontekstvindue, men ønsker ikke flagskibsøkonomi på hver forespørgsel.
- Du planlægger selv-hosting, og 320B/18B er mere praktisk end 744B/40B.
Vælg GLM-5.3 hvis?
- Du løser de sværeste ingeniøropgaver på repository-niveau eller langsigtede engineering-opgaver.
- Din evaluering belønner dybere ræsonnement mere end lave enhedsomkostninger.
- Du har brug for det stærkere resultat på DeepSWE, HLE med værktøjer eller Agents’ Last Exam.
- Du bygger autoriserede forsvars-sikkerheds- eller sårbarhedsopdagelses-workflows.
- En højere succesrate kan opveje en cirka størrelsesordens tokenpremium.
Beslutningsmatrix efter use case
| Arbejdsbelastning | Anbefalet startmodel | Hvorfor |
|---|---|---|
| Højvolumen chat og automation | GLM-5.3 Flash | Meget lavere omkostning; stærk værktøjsbrug |
| Visuel kodning og UI-debugging | GLM-5.3 Flash | Indfødt visuel input |
| Dokument-, diagram- og Office-analyse | GLM-5.3 Flash | Multimodale professionelle workflows |
| Rutinemæssig repository-vedligeholdelse | Start med Flash | Eskalér mislykkede eller usædvanligt svære opgaver |
| Svære opgaver på repository-skala | GLM-5.3 | Højere kodningsloft |
| Langsigtet forskning med værktøjer | GLM-5.3 | Stærkere HLE-with-tools-resultat |
| Defensiv sikkerhed og sårbarhedsopdagelse | GLM-5.3 | Dedikeret cybertræning og benchmarks |
| Omkostningsfølsom selv-hosting | GLM-5.3 Flash | Mindre aktivt og samlet fodaftryk |
| Usikker blandet arbejdsbelastning | Hybrid routing | Flash som standard; flagskibs-eskalering |
En bedre produktionsstrategi: Router, ikke erstat
For de fleste teams er det stærkeste design ikke et eksklusivt valg. Brug Flash som standardrute, og eskalér kun opgaver med høj kompleksitet, mislykket validering, sikkerhedsfølsomhed eller en forventet økonomisk værdi, der retfærdiggør flagskibspremium.
- Send visuelle, rutine- og højvolumenopgaver til Flash.
- Mål acceptgrad, tokens, latenstid, værktøjsfejl og menneskelig indgriben.
- Eskalér mislykkede eller højrisiko tekstopgaver til flagskibet.
- Rout sikkerhedsfølsomt arbejde gennem yderligere autorisation og sandbox-kontrol.
- Optimer for omkostning pr. accepteret resultat frem for benchmarkplacering eller pris alene.
Sådan tester du begge modeller via CometAPI
CometAPI lister GLM-5.3 Flash-vej og GLM-5.3-vej bag den samme OpenAI-kompatible base-URL. Opret en API-nøgle, og kør derefter den samme tekstopgave gennem begge model-ID’er. For en fair test skal du holde prompt, ræsonneringsindsats, værktøjsdefinitioner, maks. output og accepteret rubric fast.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Til multimodal evaluering skal du bruge den live Flash-vejledning til at verificere det understøttede billedindholdsskema. Flagskibssammenligningen bør bruge en tekst-only ækvivalent, da den ikke accepterer visuelle input.
Begrænsninger ved denne sammenligning
- Flere kodnings- og agent-scorer er leverandørrapporterede. Uafhængig reproduktion kan bruge andre værktøjer, prompts og inferensindstillinger.
- Matchede benchmarknavne garanterer ikke altid identiske harness-versioner eller kontekststyringsstrategier.
- Arkitekturniveau-reduktioner i attention-beregning og KV-cache forudsiger ikke direkte API-latenstid.
- Priser, promotioner, modeltilgængelighed, ratelimits og vej-kapabiliteter kan ændre sig; verificér live modelsider før udrulning.
- Åbne vægte gør ikke nogen af checkpoints billige at selv-hosting ved fuld kontekst.
- Cybersikkerhedskapabilitet er dual-use og kræver autorisation, sandboxing, logging, ekspertreview og ansvarlig disclosure.
Konklusion
GLM-5.3 Flash er det praktiske standardvalg. Den bevarer lang kontekst, tilføjer indfødt vision, leverer stærk værktøjsbrug og professionelt arbejde og ændrer økonomien nok til at understøtte langt bredere udrulning. GLM-5.3 er specialistens eskaleringsmodel: dyrere, tekst-only, men stærkere på den hårdeste kodning, ræsonnement og cybersikkerhedsopgaver.
Den endelige dom er derfor arbejdsbelastningsbaseret: Start med Flash, mål reel acceptgrad, og rout kun til flagskibet, når dets ekstra ræsonneringskapacitet giver nok yderligere succesfulde resultater til at retfærdiggøre premium.
Ofte stillede spørgsmål
Er GLM-5.3 Flash bedre end GLM-5.3?
Ikke universelt. Flash er bedre på pris, multimodalitet og flere værktøjs-/automationsbenchmarks. Flagskibet er stærkere på den sværeste kodning, værktøjsassisteret ræsonnement og cybersikkerhedsarbejdsbelastninger.
Er GLM-5.3 Flash en lille model?
Nej. Den har 320B samlede parametre og aktiverer 18B pr. token. Den er mere effektiv end 744B/40B-flagskibet, men kræver stadig betydelig hardware til selv-hosting.
Hvilken model er billigere?
Flash er dramatisk billigere. Z.ai’s standardlistepris er cirka en tiendedel af flagskibets pris, og de aktuelle CometAPI-veje viser et endnu større gab, mens kampagnepriser er aktive.
Hvilken model er hurtigere?
Det afhænger af metric og udbyder. Artificial Analysis målte en lidt lavere tid til første token for Flash, men højere outputhastighed for flagskibet.
Hvilken model understøtter billeder?
Flash understøtter indfødt visuel input. Flagskibet understøtter i øjeblikket kun tekstinput.
Understøtter begge modeller et 1M-token kontekst?
Ja. Flash understøtter 1M kontekst og op til 128K output; flagskibet giver de samme grænser.
Hvilken model er bedre til kodning?
Brug Flash til rutine- og højvolumen kodningsagenter. Brug flagskibet til de sværeste ingeniøropgaver på repository-skala, eller når fejlkostnaden er højere end prisforskellen.
Hvilken model er bedre til cybersikkerhed?
Flagskibet. Z.ai har specifikt trænet og evalueret den til sårbarhedsopdagelse og ræsonnement om udnyttelseskæder. Brug den kun i autoriserede, kontrollerede miljøer.
Kan begge modeller selv-hostes?
Ja. Z.ai’s repository angiver downloadbare checkpoints og understøttede serving-frameworks, men begge er stadig store infrastrukturprojekter.
Hvad er den bedste udrulningsstrategi?
Brug Flash som standardrute og eskalér svære, mislykkede eller sikkerhedsfølsomme tekstopgaver til flagskibet. Mål omkostning pr. accepteret resultat.