

Google DeepMind har i dag annonceret betydelige udvidelser af sin Gemini 2.5-familie og afsløret de stabile versioner af Gemini 2.5 Pro og Gemini 2.5 Flash samt en forhåndsvisning af den helt nye Gemini 2.5 Flash-Lite-model. Disse opdateringer afspejler Googles fortsatte engagement i at tilbyde et spektrum af AI-modeller, der balancerer omkostninger, hastighed og ydeevne til forskellige arbejdsbyrder.
Stabile udgivelser: Gemini 2.5 Pro & Flash
Den 17. juni 2025 annoncerede Google den generelle tilgængelighed af Gemini 2.5 Pro og Gemini 2.5 Flash. Pro-varianten leverer maksimal ræsonnementskraft og er skræddersyet til højkomplekse opgaver såsom avanceret kodegenerering, videnskabelig analyse og storstilet datasyntese. I modsætning hertil tilbyder Gemini 2.5 Flash en mellemklasse-løsning, der er optimeret til daglig brug, der kræver lav latenstid – ideel til chatbots, opsummering og indholdsoprettelse i stor skala.
Oversigt: Tre modeller i Gemini -2.5-familien
| Model | Status | Styrker | Ideel brugssager |
|---|---|---|---|
| Gemini 2.5 Flash-Lite (forhåndsvisning) | Eksempel | Hurtigst og billigst; multimodal; kontrollerbar ræsonnement; værktøjsaktiveret | Opgaver med høj volumen som chatbots, opsummeringer og søgning |
| Gemini 2.5 Flash | Stabil | Balanceret: lav latenstid, god ræsonnement, multimodal | Samtaler i realtid, kundesupport |
| Gemini 2.5 Pro | Stabil | Mest kapabel: dybdegående ræsonnement, omfattende kontekst, multimodal | Research, kompleks kodning, videnskabelige opgaver |
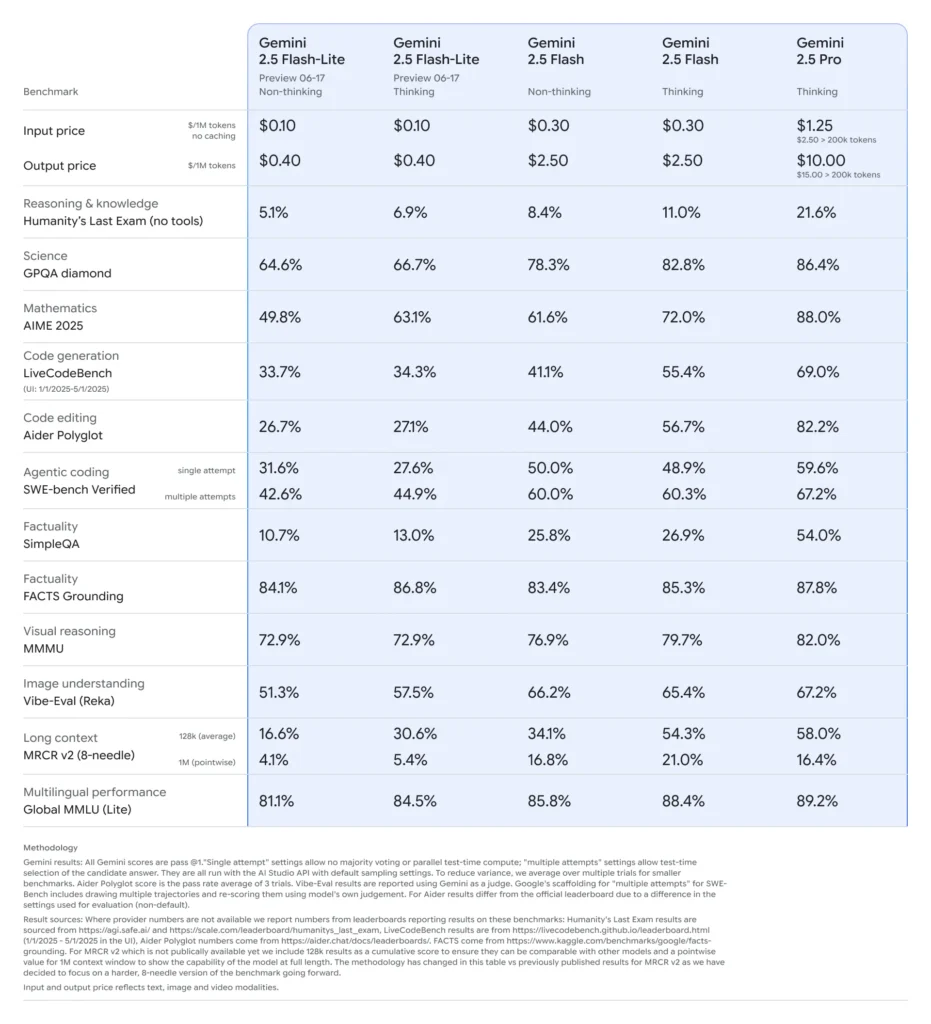
Gemini 2.5 Flash-Lite: Forhåndsvisning af højdepunkter
Ultralav latenstid og omkostningsbesparelserDesignet til realtidsapplikationer med høj volumen, såsom oversættelse, klassificering og opsummering. Har hurtigere inferens og lavere omkostninger pr. opkald sammenlignet med både 2.0 Flash-Lite og den fulde Flash-version.
Forbedret grundlæggende ydeevneOvergår tidligere Flash-Lite-modeller på tværs af benchmarks inden for kodegenerering, logik, matematik, multimodal ræsonnement og naturvidenskab.
Omkostninger og effektivitetFlash-Lite-priser (forhåndsvisning): ~$0.10 pr. 1 million input-tokens og ~$0.40 pr. 1 million output-tokens – betydeligt billigere end Flash ($0.30/$2.50) og Pro ($1.25/$10).
Fuld Gemini -2.5-funktioner:
- Kontrollerbar tænkningBrugere kan indstille "tænkebudgetter" (tokengrænser) for at bytte hastighed for dybde – Flash-Lite kan slå dette til efter behov.
- Multimodal inputUnderstøtter tekst, billede, lyd og video (inklusive timelange klip) med mulighed for at analysere diagrammer, brugergrænseflade, scener og hændelsesresuméer.
- VærktøjsintegrationInkluderer Google-søgning, kodeudførelse og et kontekstvindue med millioner af tokens, der matcher funktionerne i Flash og Pro.
Positionering på pris-ydelseskurven
Google placerer Flash-Lites høje hastighed og lave pris som den bedste Pareto grænse, hvilket betyder, at den er blandt de mest omkostningseffektive, men alligevel effektive modeller på verdensplan (). I sammenlignende evalueringer, Flash-Lite repræsenterer den bedste værdi: smart, men alligevel overkommelig.
Om Flash og Pro
- Gemini 2.5 FlashStabil, multimodal tænkemodel med lav latenstid. Placeret under Pro, men nogenlunde på niveau med GPT-4o i kapacitet, med overlegen hastighed og omkostningseffektivitet ().
- Gemini 2.5 ProGoogles mest avancerede model. Kendt for at håndtere timevis lang video/lyd, kompleks kode og matematik samt ræsonnement med omfattende kontekster. Introducerer også selektive "tænkningsbudgetter" og forbedret kodekvalitet for at fungere som en langsigtet stabil flagskibs-AI.
Implementering og prisfastsættelse
- tilgængelighedAlle tre modeller er tilgængelige via Google AI Studio, Google Cloud Vertex AI, og Gemini app .
- Omkostningsstruktur (Vertex AI-priser fra 16. juni 2025):
- om1.25 USD/1 mio. input, 10 USD/1 mio. output (højere end 200 tokens)
- Blink: $0.15/1M input, $3.50/1M output i "tænketilstand" - og inkluderer 1,500 gratis jordbaserede prompts dagligt ()
- Flash-Lite (forhåndsvisning): ~$0.10/$0.40 pr. 1 million tokens
Kom godt i gang
CometAPI leverer en samlet REST-grænseflade, der samler hundredvis af AI-modeller – under et ensartet slutpunkt med indbygget API-nøglestyring, brugskvoter og faktureringsdashboards. I stedet for at jonglere med flere leverandør-URL'er og legitimationsoplysninger.
Udviklere kan få adgang Gemini 2.5 Flash-Lite (forhåndsvisning) API ved CometAPI, de nyeste modeller, der er anført, er fra artiklens udgivelsesdato. For at begynde, skal du udforske modellens muligheder i Legeplads og konsulter API guide for detaljerede instruktioner. Før du får adgang, skal du sørge for at være logget ind på CometAPI og have fået API-nøglen. CometAPI tilbyde en pris, der er langt lavere end den officielle pris, for at hjælpe dig med at integrere.