Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: benchmarks, funktioner, priser
Sammenlign GPT-6.1 Terra og DeepSeek V4.1 Flash på benchmarks, kodning, vision, kontekst, API-priser og adgang til CometAPI for at finde ud af, hvilken der er bedre.
TL;DR: GPT-6.1 Terra er det stærkere udgangspunkt, når ræsonneringskvalitet og komplekse visuelle arbejdsgange er vigtigst; DeepSeek V4.1 Flash er attraktiv, når token-omkostninger, genereringshastighed eller selv-hosting har prioritet. Denne sammenligning bruger DeepSeeks opdatering fra 17. oktober, Flash-1017.
DeepSeek Flash-1017 har lavere tokenpriser, men omkostningen for en fuldført opgave afhænger også af ræsonneringslængde, genforsøg og værktøjskald.
Sammenligningen nedenfor dækker arkitektur, kontekst, ræsonnering, kodning, vision, hastighed, pris og udrulning. Priser og live-evalueringssider blev tjekket den 28. oktober 2026.
Nøglepointer
Terra fører den citerede uafhængige Intelligence Index-sammenligning og er derfor et logisk førstevalg til krævende ræsonneringsopgaver.
DeepSeek har lavere listede tokenpriser. Sammenlign end-to-end-latenstid og omkostning pr. vellykket opgave, inklusive spidsbelastningssatser, cache-brug, ræsonneringstokens og genforsøg.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Evaluer kodning efter accepterede patches og visuelle arbejdsgange efter fuldførte opgaver. Offentliggjorte benchmark-scorer er nyttig evidens, men testopsætningerne varierer.
Terra er en hostet proprietær model. DeepSeek tilbyder MIT-licenserede, downloadbare vægte til selv-hosting, med hardware- og driftsomkostninger at tage i betragtning.
CometAPI giver en delt tekstgrænseflade til at teste begge modeller. Tjek den faktisk servede modelversion og støtte for værktøjer, ræsonneringskontroller og struktureret output før udrulning.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Overblik og specifikationer
De væsentligste specifikationsforskelle vedrører outputgrænser, ræsonneringskontroller, værktøjskald og udrulning. Tabellen nedenfor sammenfatter de to modeller.
Proprietær arkitektur; antal parametre ikke offentliggjort
552B Causal Encoder–Decoder MoE; cirka 8B aktive parametre til input og 16B til output
Kontekstvindue
1,050,000 tokens
1M tokens
Maksimalt output
128,000 tokens
384K tokens
Inputmodaliteter
Tekst, billeder
Tekst, billeder
Outputmodaliteter
Tekst
Tekst
Ræsonneringskontroller
none, low, medium, high, xhigh, max
Thinking toggle; low, high, max i Chat Completions
Værktøjskald
Understøttes via Responses API
Understøttes; adfærd afhænger af endpoint og thinking-tilstand
Åbne vægte
Nej
Ja, MIT-licens
Arkitektur og modelversioner
Terra bruger en proprietær arkitektur, hvis antal parametre ikke er offentligt kendt. DeepSeek-V4.1-Flash bruger en Causal Encoder–Decoder MoE-arkitektur med forskellige aktive-parameterbudgetter til inputbehandling og outputgenerering.
DeepSeeks V4.1 Flash-udgivelse beskriver et 552B-parameter Causal Encoder–Decoder mixture-of-experts-backbone, med omtrent 8B parametre aktive under inputbehandling og 16B under outputgenerering. Opdateringen den 17. oktober forbedrer de offentliggjorte resultater for kodning, agenter og vision.
I denne artikel betyder Flash-1017 det oktober-checkpoint. Et generisk API-alias kan senere pege på en anden version, så en evalueringsregistrering bør inkludere den faktisk servede modelversion.
KV-cache og udrulningskrav
DeepSeek rapporterer et globalt KV-cache-fodaftryk på cirka 890 byte pr. token, omtrent en fjerdedel af DeepSeek-V4-Flash. Dette forbedrer cache-effektiviteten, selv om selv-hosting stadig kræver betydelige ressourcer til modelvægtene. Terra er tilgængelig via hostede tjenester, mens DeepSeeks downloadbare vægte giver en ekstra mulighed for selv-hosting.
Ræsonneringskontroller og værktøjskald
Begge modeller understøtter agent-arbejdsgange, men ræsonneringskontroller og krav til værktøjskald adskiller sig. Terras dokumenterede understøttelse af værktøjskald bruger Responses API. DeepSeeks modelkort beskriver numerisk ræsonneringsindsats fra 1 til 100; hostede API-kontroller bør tjekkes separat. Når du skifter model, skal ræsonneringsparametre og værktøjsdefinitioner tilpasses det valgte endpoint.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Ydelse
Sammenligningen nedenfor dækker ræsonnering, kodning, vision og langkontekst-opgaver. Uafhængige evalueringer og leverandør-rapporterede benchmarks er identificeret separat, med resultater tolket sammen med deres modelkonfigurationer og agentrammeværk.
Ræsonnering og viden
Artificial Analysis rapporterer en Intelligence Index v5.0-score på 51 for GPT-6.1 Terra (Max) og 32 for DeepSeek Flash-1017 (Max) i de citerede konfigurationer pr. 28. oktober 2026. Indekset kombinerer ni evalueringer.
Terras højere samlede score understøtter at teste den først til krævende ræsonneringsopgaver. For snævrere arbejdsbelastninger kan DeepSeek stadig være det bedre valg, hvis den opfylder den krævede nøjagtighed til en lavere omkostning pr. vellykket opgave.
Officielle kodnings- og agentbenchmarks
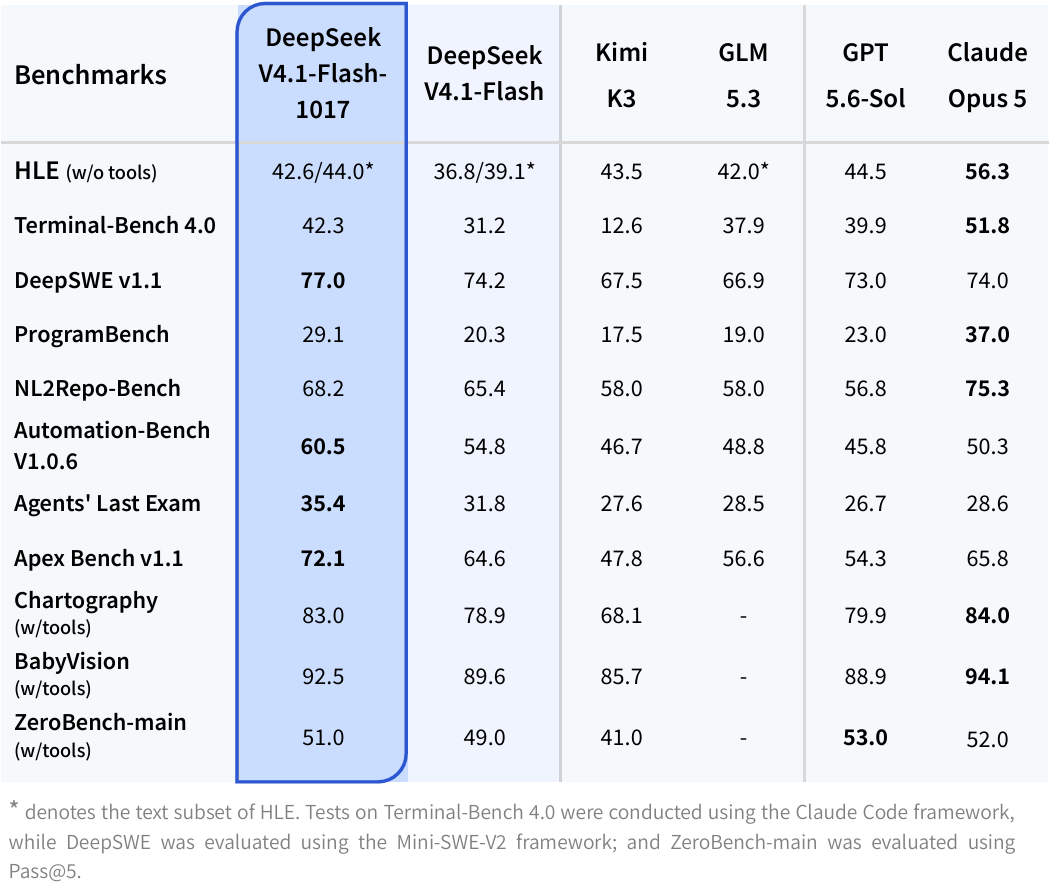
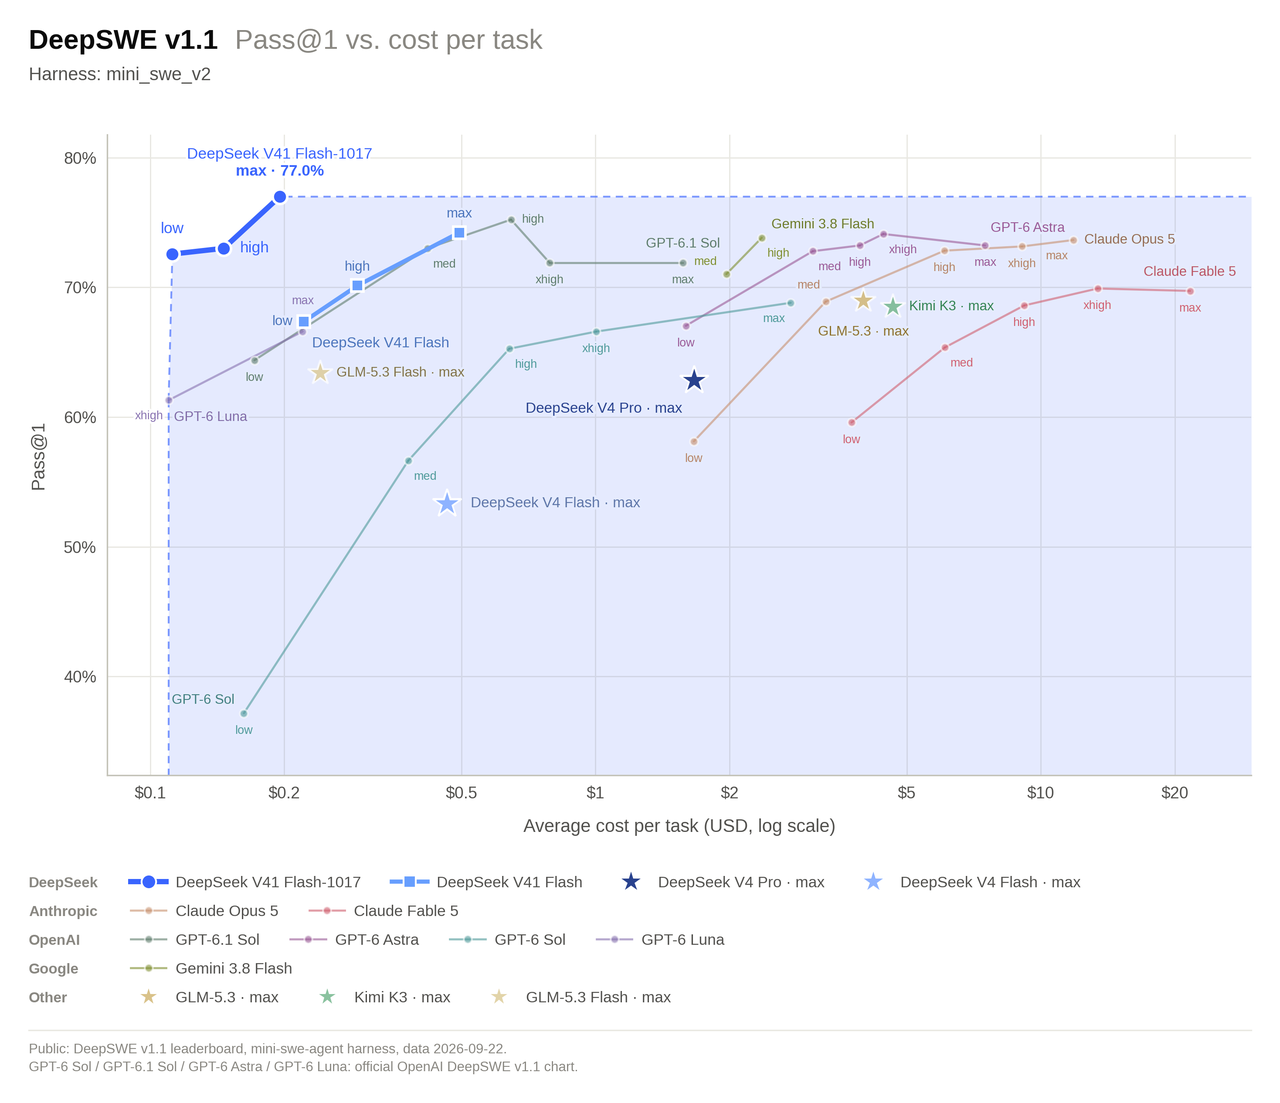
Terminal-Bench 4.0 og DeepSWE v1.1 giver evidens om kodnings- og agentydelse. Når du sammenligner leverandørresultater, identificer den præcise modelversion, ræsonneringsindstilling, agentramme og scoringsmetrik; forskelle i disse indstillinger kan have væsentlig indflydelse på scorerne.
Til praktisk kodningsarbejde bør du sammenligne, om hver model producerer patches, der består eksisterende tests, bevarer offentlige grænseflader, håndterer hjørnetilfælde og undgår uvedkommende ændringer. Pålidelighed af værktøjskald og evne til at komme sig efter kørselsfejl påvirker også, hvor meget arbejde en agent kan fuldføre.
DeepSeeks lavere listede tokenpriser gør den til en nyttig kandidat til gentagen repository-vedligeholdelse med klare accepteringskriterier. For komplekse ændringer bør begge modeller sammenlignes på accepterede patches, samlet opgaveomkostning og menneskelig rettelsestid.
Vision og computerbrug
Begge modeller accepterer billedinput, men billedforståelse og desktop-interaktion kræver forskellige kapabiliteter. OpenAIs Terra-lanceringsmateriale omtaler MMMU-Pro og OSWorld 2.1, mens DeepSeeks modelkort rapporterer visuelle opgaver inklusive Chartography og BabyVision, med værktøjsassisterede indstillinger.
Til dokumentekstraktion bør du sammenligne feltpræcision, overset tekst og tabelstruktur. Til desktop-automatisering bør du sammenligne fuldførte arbejdsgange, forkerte handlinger og genopretning efter grænsefladeændringer. En model, der beskriver et skærmbillede korrekt, kan stadig have svært ved at betjene applikationen, den viser.
Vælg efter arbejdsgangen: Ekstraktionsnøjagtighed er vigtigst til dokumentbehandling, mens pålidelige handlinger og genopretning er vigtigere for computer-brugsagenter. Sammenlign først omkostninger, når begge modeller opfylder den krævede kvalitetsgrænse.
Langkontekst-ræsonnering og hentning
Begge modeller understøtter arbejdsgange med lange dokumenter, men kontekstkapacitet alene bestemmer ikke hentekvaliteten. Sammenlign dem på den samme dokumentsamling, og placer vigtig evidens nær begyndelsen, midten og slutningen.
Evaluer svarnøjagtighed, understøttende passager, konsistens på tværs af dokumenter og svarfuldstændighed. Til research og dokumentanalyse foretrækkes den model, der pålideligt henter og forbinder den relevante evidens inden for dine latenstids- og omkostningskrav.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Hastighed
Outputgennemløb og opgavens gennemførselstid
Latenstid fortjener særskilt behandling fra ræsonneringskvalitet.
På Artificial Analysis-siderne den 28. oktober er Flash-1017 (Max) outputhastighed 173.4 tokens pr. sekund, mens Terra (Max) outputhastighed er 90.9. Disse målinger beskriver evaluatorens servede konfigurationer, ikke garanterede rater hos alle udbydere.
En model, der genererer tokens hurtigere, kan stadig tage længere tid at blive færdig, hvis den producerer mere ræsonnering, venter på værktøjer eller laver genforsøg. Mål tid til første token, samlet gennemførselstid og latenstid for godkendte opgaver separat.
Interaktiv latenstid på din API-rute
Til et interaktivt produkt bør du teste korte og lange prompts ved realistisk samtidighed og registrere median- og 95.-percentil-latenstid. Bevar region, API-rute, prompt-caching, ræsonneringsindstillinger og genforsøgspolitik i resultaterne. Den registrering fortæller mere om brugeroplevelsen end en enkelt figur for tokens pr. sekund.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Omkostning
Prisfastsættelse er en af de tydeligste forskelle mellem disse modeller.
Terras priskort og DeepSeeks prispolitik giver følgende førstegenerationssatser som tjekket den 28. oktober 2026. Alle priser er US-dollar pr. million tokens.
Officielle API-satser
Tokenkategori
GPT-6.1 Terra Standard
DeepSeek Flash uden for spidsbelastning
DeepSeek Flash i spidsbelastning
Input, cache-miss
$1.00
$0.15
$0.30
Input, cache-hit
$0.05
$0.003
$0.006
Output
$5.00
$0.60
$1.20
DeepSeeks spidsbelastningspriser gælder mandag–fredag, 01:00–04:00 og 06:00–10:00 UTC, med undtagelse af kinesiske helligdage. Det svarer til 09:00–12:00 og 14:00–18:00 i China Standard Time (UTC+8). Andre perioder bruger satserne uden for spidsbelastning.
For Terra-forespørgsler over 272,000 inputtokens angiver OpenAI 2× input- og cachet-inputsatser og 1.5× outputsatser for hele forespørgslen. Sammenlign disse betingelser med dine faktiske promptstørrelser, før du betragter basisprisen som den effektive pris.
CometAPI-satser
CometAPI basispris pr. 1M tokens
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Ikke-cachet input
$0.80
$0.12
Output
$4.00
$0.48
Cachet input
Ikke angivet separat
$0.0024
Tidsbaseret multiplikator
Ikke angivet i basispris
2× i de angivne spidsbelastningsvinduer
CometAPI angiver DeepSeeks spidsbelastningsvinduer som mandag–fredag, 01:00–04:00 og 06:00–10:00 UTC. Den angivne plan etablerer ikke den samme helligdagsundtagelse som DeepSeeks førstepartspolitik. Tjek den valgte routes faktureringsvilkår for det ønskede tidsrum.
Eksempel med fast tokenforbrug
Overvej en forespørgsel, der bruger 100,000 ikke-cachede inputtokens og genererer 10,000 outputtokens.
Hvis dette er de fulde fakturerede tokentotaler, er tokenomkostningen $0.150 for Terra, $0.021 for DeepSeek uden for spidsbelastning eller $0.042 for DeepSeek i spidsbelastning. Reduktionen uden for spidsbelastning er 86%. Eksemplet udelader ekstra værktøjsgebyrer, infrastruktur og genforsøg; eventuelle separat opgjorte ræsonneringstokens skal også indgå i beregningen.
Ved CometAPIs listede basispriser koster de samme 100,000 input- og 10,000 outputtokens $0.120 for Terra eller $0.0168 for Flash. Anvendes den listede 2× spidsbelastningsmultiplikator, giver det $0.0336 for Flash. Dette er kun tokenberegninger baseret på de anførte mængder, ikke målinger af en faktisk opgave.
Når ekstra output udligner tokenpris-fordelen
Hold ikke-cachet input på 100,000 tokens og Terras samlede fakturerede output på 10,000 tokens. Terras standard tokenregning er da $0.150. Flash når den samme regning ved 225,000 fakturerede outputtokens uden for spidsbelastning eller 100,000 i spidsbelastning. Denne aritmetik isolerer outputvolumen; caching, gentaget input, værktøjsgebyrer og genforsøg ændrer sammenligningen.
Omkostning pr. vellykket opgave
Evaluer en fast batch af opgaver og divider al faktureret API- og værktøjsforbrug med antallet af opgaver, der består dine accepttjek. Medregn udgifterne til mislykkede forsøg også. Rapporter succesraten ved siden af denne omkostning, så en model ikke belønnes for kun at fuldføre de nemmeste opgaver.
Omkostning pr. vellykket opgave = Samlede API- og værktøjsomkostninger / Vellykkede opgaver
Hvad skal du vælge: GPT-6.1 Terra eller DeepSeek-V4.1-Flash?
Vælg i henhold til opgavens kvalitetskrav, omkostningsmål og udrulningsbehov. Brug benchmarkresultaterne ovenfor til at beslutte, hvilken model du først bør teste.
Anvendelsestilfælde
Startkandidat
Hvad bør afgøre valget
Krævende ræsonnering
GPT-6.1 Terra
Nøjagtighed og korrektivt arbejde på repræsentative, vanskelige opgaver
Kodningsagenter
Test begge
Accepterede patches, regressionskontroller, værktøjsfejl og samlede omkostninger
Komplekse visuelle arbejdsgange
GPT-6.1 Terra
Fuldførte arbejdsgange og genopretning efter grænsefladefejl
Tekst- eller billedekstraktion i høj volumen
DeepSeek Flash-1017
Om ekstraktionsnøjagtigheden opfylder den krævede tærskel
Langdokumenthentning
Test begge
Evidenshentning og svarnøjagtighed på tværs af inputpositioner
Selv-hosting
DeepSeek Flash-1017
Tilgængelig hardware, driftsomkostninger og kontrol over vægte
Interaktive applikationer
Test begge
Median- og hale-latenstid på den valgte leverandørrute
Hvornår du bør vælge GPT-6.1 Terra
Prioritér Terra til evaluering, når kompleks ræsonnering er central for opgaven. Til krævende visuelle eller computerbrugs-arbejdsgange bør den indgå i testsettet, hvor fuldførte opgaver, fejl og genopretning måles.
Det centrale spørgsmål er, om Terra reducerer mislykkede forsøg og manuel korrektion nok til at retfærdiggøre dens højere tokenpris.
Hvornår du bør vælge DeepSeek-V4.1-Flash
Start med DeepSeek-V4.1-Flash til gentagne opgaver i stor skala med klare accepteringskriterier og stramme omkostningsmål. Vælg den, hvis output opfylder dine kvalitetskrav til en lavere omkostning pr. vellykket opgave.
DeepSeeks MIT-licenserede vægte gør den også relevant, når selv-hosting er et krav. Medtag hardware- og driftsomkostninger i den beslutning.
Hvornår du bør teste begge modeller
Test begge, når kodningskvalitet, værktøjspålidelighed, latenstid eller langdokument-nøjagtighed er kritisk. Brug repræsentative opgaver med de samme input, værktøjer, kørselsgrænser og accepteringskriterier.
Sammenlign succesrate, samlet omkostning pr. vellykket opgave, end-to-end-latenstid og menneskelig rettelsestid. Registrer modelversion og ræsonneringsindstillinger, så resultaterne kan reproduceres.
Et hybrid-setup kan starte rutineopgaver med DeepSeek og eskalere udvalgte fejl til Terra. Mål omkostningen og gennemførelsesraten for hele arbejdsgangen for at bekræfte, at det ekstra modelkald er umagen værd.
Hvor kan du få adgang til GPT-6.1 Terra og DeepSeek V4.1 Flash?
Brug OpenAIs hostede API til Terra eller DeepSeeks hostede API til Flash. Bekræft det aktuelle model-id, kontogrænser og understøttet endpoint før integration. Flash-1017s downloadbare vægte giver en separat mulighed for selv-hosting.
Adgang via CometAPI
CometAPI tilbyder en OpenAI-kompatibel grænseflade, der kan forenkle multimodel-applikationsudvikling.
Brug GPT-6.1 Terra API og DeepSeek V4.1 Flash API med en delt tekstklient, og tilføj derefter model-specifikke kontroller først efter at have tjekket rutens understøttelse.
Sammenlign tekstsvar via CometAPI
For at prøve begge modeller gennem én tekstklient kan du bruge OpenAI Python SDK med din CometAPI-nøgle og endpointet https://api.cometapi.com/v1. Opbevar nøglen i en miljøvariabel, send derefter den samme prompt til ruterne gpt-6.1-terra og deepseek-v4.1-flash, og sammenlign de returnerede svar og tokenforbrug.
Bed for eksempel hver model om at gennemgå et betalingsflow, der gentager timeouts uden en idempotency-nøgle og logger fulde forespørgselskroppe. Sammenlign, hvor klart svarene identificerer pålideligheds- og privatlivsrisici og forklarer praktiske rettelser. En delt prompt gør svarene lettere at inspicere, men en standard tekstanmodning ligestiller ikke ræsonneringsbudgetter eller etablerer en præstationsrangering. Bekræft checkpointet, der betjenes af hver rute, før et resultat behandles som evidens om Flash-1017.
Konklusion
GPT-6.1 Terra tilbyder den stærkere aktuelle samlede ræsonneringsresultat, mens DeepSeek Flash-1017 kombinerer lavere tokenpriser, hurtigere målt outputgenerering og open-weight-udrulning. Det nyttige valg er den model, der opfylder dine kvalitets- og latenstidskrav til den laveste samlede omkostning.
Start med en repræsentativ arbejdsbelastning, hold værktøjsmiljø og accepteringskriterier konstante, og sammenlign omkostningen for vellykkede fuldførelser. En delt CometAPI-tekstintegration kan gøre den evaluering nemmere, mens model-specifikke funktioner stadig kræver deres egen konfiguration.
FAQ
Hvorfor kan den samme opgave give forskellige tokenregninger med Terra og Flash-1017?
En tekstanmodning bliver ikke nødvendigvis til det samme antal tokens i to modeller. Genererede svar og ræsonneringslængder kan også variere. Sammenlign forbruget, som hver rute rapporterer for identiske opgaver, inklusive cachede og fakturerbare ræsonneringstokens, hvor det rapporteres, i stedet for at anvende begge prislister på én estimeret tokenmængde.
Kan GPT-6.1 Terra og DeepSeek V4.1 Flash dele en prompt-cache?
Du kan genbruge promptteksten i din applikation, men antag ikke, at en cache oprettet for én model eller udbyder reducerer den andens regning. Cacheberettigelse og -opgørelse er rutespecifik. Tjek hvert svarfelt for forbrug og test gentagne forespørgsler, før du indregner besparelser i et forecast.
Hvordan bør jeg validere struktureret output fra Terra og Flash-1017?
Definér de krævede felter og typer i din applikation, før du vælger en model. Hvis en rute tilbyder JSON eller skemabegrænset output, verificér den præcise tilstand, den understøtter, parsér derefter svaret og valider det mod dit skema. Behandl manglende felter, ugyldige værdier, afkortet output og afslag som separate udfald. Gyldig JSON alene fastslår ikke, at de udtrukne fakta er korrekte.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: benchmarks, funktioner, priser - CometAPI