Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Grok 4.7 er tilgængelig? 2.1T-model, SpaceX-træning, og udgivelsesvinduet
Grok 4.7 blev lanceret den 21. september 2026. Udforsk dets benchmarks for programmering, forbedringer i forhold til Grok 4.6, API-priser og hvordan du får adgang til den frigivne model.
Grok 4.7 udgivelsesopdatering: Fra forudsigelser til officiel tilgængelighed
Oplysninger kontrolleret: 16. oktober 2026.
Grok 4.7 blev officielt udgivet den 21. september 2026. Tidligere henvisninger til en lancering den 12. september var forudgivelsesestimater og bør ikke betragtes som den faktiske udgivelsesdato.
Den officielle lanceringsmeddelelse beskriver forbedringer inden for kodning, vidensarbejde, længerevarende opgaver og verifikation af modellens egne resultater. Den bekræfter tilgængelighed via Grok API, Cursor og Grok Build. For den præcise API-model-ID, understøttede funktioner, kontekstgrænser og aktuelle priser, se den officielle Grok 4.7-dokumentation.
Officielle resultater viser målbar fremgang i forhold til Grok 4.6. For eksempel rapporterer lanceringssammenligningen en Terminal-Bench 4.0-score på 37.6% for Grok 4.7 ved xhigh effort, sammenlignet med 20.3% for Grok 4.6 ved high effort. Dette er udbyder-rapporterede resultater under de angivne evalueringsindstillinger; den faktiske ydelse afhænger af prompts, værktøjer, ræsonnementsindsats og opgavens sværhedsgrad.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
For udviklere er det nyttige spørgsmål nu, om Grok 4.7 fuldfører deres arbejdsbelastninger mere pålideligt og økonomisk. Test den på repository-ændringer, dokumentoprettelse og flertrins værktøjs-workflows, og mål succesfuld gennemførsel, latenstid, genforsøg og den samlede opgaveomkostning.
Den forventede dato 12. september er udledt af Musks ti-dages nedtælling, ikke en særskilt offentliggjort xAI-kalendermeddelelse.
Oplysningerne om 2.1T-skala og SpaceX-data er forudgivelsesudsagn; aktive parametre, routing, arkitektur og træningsmetode er ikke offentliggjort.
Grok 4.6 viser allerede stærke videns- og agentresultater, inklusive 61.3% på FrontierCode v1.1 (Extended), men den ligger efter den stærkeste sammenligningsmodel på flere vanskelige kodnings-evalueringer.
Grok 4.7 bør vurderes på accepteret-opgave-rate, robusthed over lang horisont, tokeneffektivitet, latenstid og omkostning per succesfuldt udfald—ikke alene på antal parametre.
CometAPI vil integrere Grok 4.7, så snart xAI officielt udgiver modellen og produktionsendepunktet er tilgængeligt; udviklere bør stadig validere det live model-ID, prisen og responsadfærden før migrering.
Hvad er Grok 4.7?
Grok 4.7 er den annoncerede efterfølger til Grok 4.6 og forventes at fortsætte xAI’s fokus på kodning, ingeniørarbejde, langvarige agenter og professionelt vidensarbejde. Den offentlige evidens består i øjeblikket af stifterudsagn og en lanceringsnedtælling snarere end en komplet teknisk lanceringspakke.
Den vigtigste skelnen er mellem tre objekter: den annoncerede Grok 4.7-model, forudgivelsessignalerne der beskriver dens mulige skala og træning, og den live Grok 4.6-produktionsbaseline. Udviklere bør behandle Grok 4.7 som en kommende evalueringskandidat, indtil xAI offentliggør endelig dokumentation, og en produktionsanmodning lykkes mod det udgivne endepunkt.
Grok 4.7 udgivelsesdato og tidslinje
Hvornår forventes Grok 4.7 at blive udgivet?
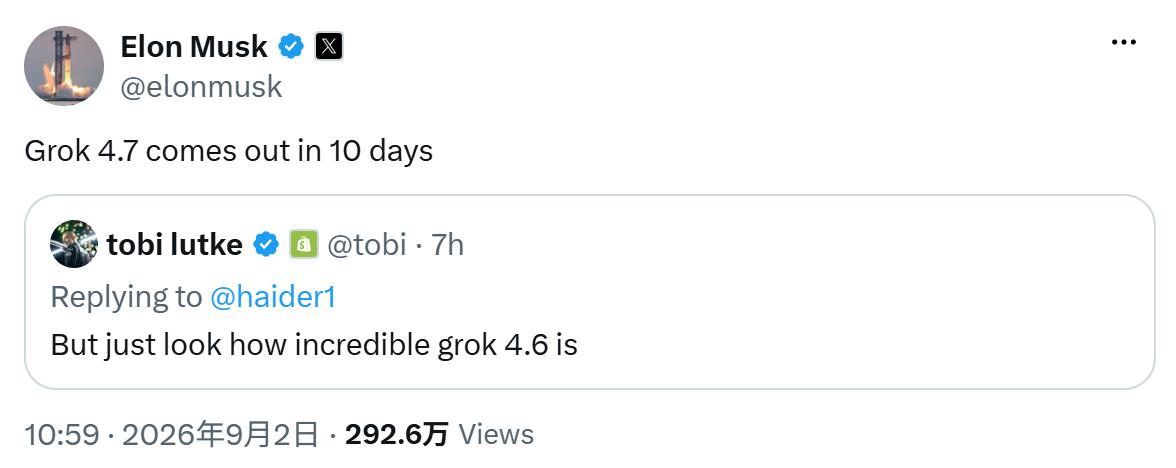
Musks erklæring den 2. september om, at modellen ville komme om ti dage, peger på cirka 12. september 2026
Musk beskrev en cirka 2.1T model, forbedret tokeneffektivitet og noget langsommere betjening.
Stifter-udsagt modelskala og effektivitetsforventninger.
12. august 2026
Den indledende træning blev beskrevet som afsluttet; supplerende træning omfattede angiveligt betydelige SpaceX-data.
En opdatering om træningsfremskridt, ikke en udgivelsesbekræftelse.
2. september 2026
“Grok 4.7 kommer om 10 dage.”
Den hidtil tydeligste offentlige lanceringsnedtælling.
12. september 2026
Kalendardato afledt af nedtællingen.
Forventet mål; endelig tilgængelighed kræver stadig en xAI-udgivelsesmeddelelse og et fungerende endepunkt.
Grok 4.7-specifikationer: Bekræftet vs. ubekræftet information
Den mest nyttige måde at læse de nuværende Grok 4.7-oplysninger på er at adskille direkte stifterudsagn fra specifikationer, som xAI ikke har offentliggjort. Det nye opslag bekræfter kun modelnavnet og en lanceringsnedtælling; det tilføjer ikke tekniske parametre eller benchmarkresultater.
Specifikation
Aktuel Grok 4.7-status
Bevisniveau
Udgivelsestiming
Omkring 12. september, udledt af nedtællingen den 2. september
Af stifter annonceret mål
Modelskala
Cirka 2.1T parametre
Stifter-udsagt
Indledende træning
Beskrevet som afsluttet pr. 12. august
Stifter-udsagt
Supplerende træning
Indeholder betydelige SpaceX-firmadata
Stifter-udsagt
Relativ kvalitet
Påstås at være markant bedre end Grok 4.6
Uverificeret påstand
Tokeneffektivitet
Påstået forbedring i forhold til Grok 4.6
Uverificeret påstand
Betjeningshastighed
Forventes at være noget langsommere
Stifter-udsagt
Kontekstvindue
Ikke offentliggjort af xAI
Ukendt
Input/output-modaliteter
Ikke offentliggjort af xAI
Ukendt
Endelig API-model-ID
Ikke bekræftet i xAI-dokumentation
Ukendt
Officiel prissætning
Ikke offentliggjort af xAI
Ukendt
Officielle benchmarks
Ingen offentliggjort for Grok 4.7
Den cirka 2.1T-parameter-påstand oplyser ikke aktive parametre, sparsitet, ekspertrouting, inferensomkostning eller effektiv træningscompute. Antallet af parametre alene kan ikke fastslå produktionskvalitet.
Hvorfor SpaceX-træningssignalet kan betyde mere end 2.1T
Den mere betydningsfulde oplysning kan være SpaceX-firmadata-tilskuddet. Et teknisk korpus af høj kvalitet kan forbedre teknisk ræsonnement, design, debugging, optimering og agentarbejde over lang horisont, hvor opgavefordeling og post-træningskvalitet ofte betyder mere end ren skala.
Denne retning er i tråd med xAI’s strategi for udgivne modeller. Grok 4.6-træningsrapporten beskriver et længere supplerende træningsforløb med ingeniørdata af høj kvalitet, efterfulgt af superviseret finjustering og reinforcement learning på tværs af kodning, STEM, webudvikling, kernel-optimering og computerstøttet design.
Det gør Grok 4.7-påstanden teknisk plausibel, ikke bevist. En reel fordel bør blive synlig efter udgivelsen i reproducerbare ingeniørtests, opgavegennemførelsesrater, latenstid og omkostning per succesfuldt udfald.
Grok 4.7 vs. Grok 4.6 ydeevne: Hvad baseline viser
Der findes endnu ingen officielle Grok 4.7-scorer. Det ansvarlige sammenligningspunkt er xAI’s udgivne Grok 4.6 evaluering. Den fulde modeloversigt findes i CometAPI’s Grok 4.6 dybdegående gennemgang; tabellen nedenfor bevarer kun de mest beslutningsrelevante benchmarkrækker.
Officiel evaluering
Grok 4.6 High
Grok 4.5 High
GPT-5.6 Sol Max
Claude Fable 5 Max
AA Intelligence Index
61
56
61
62
GDPVal-AA v2
1753
1526
1728
1741
CursorBench v3.2
69.9%
66.7%
67.2%
70.5%
DeepSWE v1.1
65.9%
54.0%
73.0%
70.0%
FrontierCode v1.1 (Extended)
61.3%
56.6%
60.6%
63.6%
Terminal-Bench v3.0
26.0%
15.7%
34.6%
34.1%
Baseline-resultat: Grok 4.6 demonstrerer en reel fordel over Grok 4.5 på hver række vist. Den matcher GPT-5.6 Sol på det overordnede intelligensindeks, fører denne gruppe på GDPVal-AA v2 og er en anelse foran GPT-5.6 Sol på FrontierCode. Dens vigtigste offentliggjorte huller er fortsat DeepSWE og Terminal-Bench.
Disse resultater sætter en konkret standard for Grok 4.7. Hvis den større model og det ingeniørorienterede supplerende træningsmateriale overføres til produktion, vil det forventede gennembrud være stærkere kodning på repository-niveau og terminalopgave-gennemførelse uden at miste Grok 4.6’s styrke i vidensarbejde. Et troværdigt stretch-mål er at blive konkurrencedygtig med den udgivne Claude Fable 5.1 på kodning og langvarige agent-workflows. Det er en prognose, der skal testes, ikke en aktuel benchmarkpåstand.
Grok 4.7 vs. Grok 4.6: Forventede gennembrud og opgraderingsvejledning
De lækkede og stifter-udsagte signaler antyder fem områder, hvor Grok 4.7 kan forbedre sig. Fordi xAI ikke har offentliggjort endelige evalueringsdata, bør hver forventning omsættes til en målbar accepttest.
Kodning på repository-niveau
Grok 4.6 er allerede stærk på CursorBench og FrontierCode, men dens DeepSWE- og Terminal-Bench-resultater efterlader synligt forbedringsrum. Grok 4.7 bør demonstrere højere patch-accept, færre regressioner og bedre kommandolinje-genopretning på de samme repositories, før den erstatter 4.6.
Langsigtet agentpålidelighed
SpaceX-data-signalet og xAI’s eksisterende agent-træningsretning antyder fokus på flertrins ingeniørarbejde. Mål gennemførte workflows, mislykkede værktøjskald, genforsøg, menneskelige interventioner og genopretning efter fejl—ikke kun kvaliteten af den endelige tekst.
Vidensarbejde og teknisk ræsonnement
Grok 4.6 fører allerede sammenligningssættet på GDPVal-AA v2. Grok 4.7 bør bevare den fordel og samtidig forbedre overførsel til designreviews, forskningssyntese, debugging, optimering og andre komplekse tekniske opgaver.
Tokeneffektivitet
En større model kan stadig være billigere per succesfuld opgave, hvis den når korrekte resultater i færre trin. Sammenlign samlede input, cachet input, outputtokens, genforsøg og omkostning for det samme accepterede resultat.
Afvejninger i betjening
Hvis Grok 4.7 er langsommere, skal kvalitetsgevinsterne opveje latenstiden. Registrér tid til første token, vedvarende gennemløb, samlet væg-til-væg tid, fejlrater og omkostning under realistisk samtidighed.
Grok 4.7 benchmarks: 5 tests til at verificere en reel opgradering over Grok 4.6
Succes i softwareingeniørarbejde: Mål løste issues, beståede tests, regressionsrate og patch-accept på repræsentative repositories.
Langsigtet agentpålidelighed: Spor gennemførte workflows, værktøjskaldsfejl, genforsøg, genopretning og menneskelige interventioner på tværs af flertrinskørsler.
Reel ingeniøroverførsel: Test design, debugging, optimering, videnskabeligt ræsonnement og CAD-relaterede opgaver med offentliggjorte bedømmelseskriterier.
Tokeneffektivitet per succesfuld opgave: Sammenlign samlede tokens og forbrug, der kræves for at nå det samme accepterede udfald.
Latenstid og omkostning under produktionsbelastning: Evaluer tid til første token, gennemløb, væg-til-væg tid, fejlrater og omkostning ved realistisk samtidighed.
Hvad udviklere bør gøre før 12. september—og hvordan CometAPI passer ind
Tjekliste for udviklere før lancering
Byg et fast evalueringssæt ud fra reelle kodnings-, forsknings-, ingeniør- og agent-workflows.
Kør det mod Grok 4.6 og registrér succesrate, genforsøg, værktøjskald, latenstid, tokens og samlede omkostninger.
Hold modelvalg konfigurerbart og undgå at hardcode en foreløbig Grok 4.7-identifikator.
Følg xAI release notes og CometAPI-modellsiden for bekræftet tilgængelighed.
Verificér efter lancering kontekst, modaliteter, ræsonneringskontroller, priser, ratelimitter og udrulningsomfang.
Afspil det samme evalueringssæt igen før flytning af produktionstrafik.
CometAPI tilbyder et samlet API-lag for adgang til flere AI-modeludbydere via én konto og integrationsmønster. En Grok 4.7-sporingsside er allerede tilgængelig. CometAPI vil integrere Grok 4.7, så snart xAI officielt udgiver den, og produktionsadgang bliver tilgængelig.
Indtil da bør enhver forudgivelsesidentifikator, pris eller kapabilitetsfelt behandles som foreløbig. Før du sender produktionstrafik, bekræft at ruten er live, at en reel anmodning lykkes, at den returnerede model er den tilsigtede version, og at den aktuelle pris er synlig i konsollen.
Prisudsigter for Grok 4.7 vs. Grok 4.6
Den offentliggjorte standardtakst for Grok 4.6 er $2 per 1 million inputtokens og $6 per 1 million outputtokens under grænsen for lang kontekst. xAI’s udgivelsesnoter angiver højere takster for anmodninger over 200,000 prompttokens. Grok 4.7-priser er endnu ikke officielt annonceret.
Offentliggjort prisgrundlag
Input / 1M
Output / 1M
Status
Grok 4.6, prompt under 200K
$2
$6
Offentliggjort
Grok 4.6, prompt over 200K
$4
$12
Offentliggjort langt-kontekst-niveau
Grok 4.7
Ikke annonceret
Ikke annonceret
Bekræft efter officiel lancering
Tre prisspor er fortsat plausible: paritet med Grok 4.6 for at accelerere adoption, et premium-niveau hvis betjeningsomkostningen er væsentligt højere, eller separate satser efter kontekstkædelængde og hastighed. Dette er planlægningsscenarier, ikke en xAI-prognose.
Tjekliste for udviklere før lancering
Byg et fast evalueringssæt ud fra reelle kodnings-, forsknings-, ingeniør- og agent-workflows.
Kør det mod Grok 4.6 og registrér succesrate, genforsøg, værktøjskald, latenstid, tokens og samlede omkostninger.
Hold modelvalg konfigurerbart og undgå at hardcode en foreløbig Grok 4.7-identifikator.
Følg xAI release notes og CometAPI-modellsiden for bekræftet tilgængelighed.
Verificér efter lancering kontekst, modaliteter, ræsonneringskontroller, priser, ratelimitter og udrulningsomfang.
Afspil det samme evalueringssæt igen før flytning af produktionstrafik.
Grok 4.7: Hvad du bør holde øje med næste
Fire begivenheder vil omdanne den nuværende nedtælling til en verificerbar produktlancering: et officielt xAI-udgivelsesopslag; modeldokumentation, der dækker kontekst, modaliteter og ræsonneringskontroller; endelig API-prissætning og modelidentifikatorer; samt reproducerbare benchmarks eller produktionsevalueringer.
Det mest nyttige lanceringsspørgsmål er ikke, om 2.1T lyder stort. Det er, om Grok 4.7 fuldfører vanskelige ingeniør- og agentopgaver mere pålideligt—og til en bedre omkostning per succesfuldt udfald—end den udgivne baseline.
FAQ
Hvornår forventes Grok 4.7 at blive udgivet?
Musks ti-dages nedtælling fra 2. september peger på cirka 12. september 2026. Dette er et udledt mål, ikke en separat offentliggjort kalenderdato fra xAI.
Er Grok 4.7 allerede lanceret?
Grok 4.7 er blevet offentligt teaset/annonceret, men har endnu ikke modtaget en fuldstændig officiel API-/modeldokumentationsudgivelse.
Er Grok 4.7 en model med 2.1 billioner parametre?
Musk har beskrevet den som cirka 2.1T parametre. xAI har endnu ikke offentliggjort et arkitekturdokument, der bekræfter aktive parametre eller routingdetaljer.
Vil Grok 4.7 være bedre end Grok 4.6?
Musk har hævdet en væsentlig forbedring, men der findes ingen officiel Grok 4.7-benchmarktabel. Behandl påstanden som uverificeret, indtil reproducerbare resultater er tilgængelige.
Vil Grok 4.7 være tilgængelig via CometAPI?
En CometAPI-sporingsside findes allerede, men endelig tilgængelighed, identifikator, prissætning og understøttede formater bør bekræftes efter den officielle lancering.
Konklusion
Historien om Grok 4.7 er gået fra et bredt estimat i begyndelsen af september til en konkret nedtælling. Musks seneste udsagn peger på cirka 12. september 2026, mens tidligere opslag beskriver en cirka 2.1T-model og supplerende træning med betydelige SpaceX-firmadata.
Det er usædvanligt specifikke forudgivelsessignaler, men de er ikke et modelkort, en benchmarkpakke eller en API-kontrakt. Udviklere bør beholde Grok 4.6 som den målbare baseline, forberede en kontrolleret evaluering nu og afvente, at xAI og CometAPI bekræfter produktionsadgang, før der træffes beslutninger om migration eller budget.