
TL;DR
Grok 4.7 og Xiaomi MiMo-V2.6 kom med kun én dags mellemrum, men de repræsenterer to forskellige tilgange til frontier-AI. Grok 4.7 vægter en proprietær, tæt integreret agentstak til kodning og professionelt vidensarbejde, mens MiMo-V2.6-Pro kombinerer åbne vægte, et større kontekstvindue, indbygget multimodal forståelse og aggressiv API-prissætning.
SpaceXAI positionerer Grok 4.7 som sin frontmodellen til kodning, agentopgaver og vidensarbejde med et kontekstvindue på 500K tokens og konfigurerbar ræsonneringsindsats.
Xiaomi positionerer MiMo-V2.6-Pro som et 1M-kontekst multimodalt flagskib med åbne vægte og understøttelse af tekst-, billed-, lyd- og videoforståelse.
Kort sagt: Grok 4.7 er det mere vertikalt integrerede administrerede agentprodukt; MiMo-V2.6-Pro giver udviklere mere kontrol over udrulning og langt lavere rå tokenpriser. Det bedste valg afhænger af arbejdsbelastningen snarere end én benchmarkscore.
Nøgtepunkter
- Grok 4.7 er bygget til langhorizont-kodning og professionelle agenter.In SpaceXAI's leverandørpublicerede evaluering scorer 46,3 % på CursorBench 4.0, 71,0 % på DeepSWE v1.1 ved høj indsats og 1.657 på AA Briefcase v1.1.
- MiMo-V2.6-Pro er usædvanligt konkurrencedygtig for en åben model.Xiaomi offentliggør modelvægtene og rapporterer resultater tæt på proprietære frontier-systemer på flere kodnings- og agentbenchmarks, men tværs-leverandør-scorer er ikke direkte udskiftelige.
- MiMo har kontekst- og multimodal-fordelen. MiMo-V2.6-Pro understøtter et kontekstvindue på 1M tokens samt tekst-, billed-, lyd- og videoforståelse, mod Grok 4.7's 500K kontekst med tekst- og billedinput.
- MiMo er væsentligt billigere på rå API-tokens.Official standardpriser er $0,435/$0,87 per million ikke-cachet input/output tokens for MiMo-V2.6-Pro mod $2/$6 for Grok 4.7.
- Implementeringsarkitektur er den afgørende trade-off.Grok tilbyder den stærkere førsteparts-hostede værktøjsstak; MiMo's åbne vægte muliggør privat udrulning, tilpasset serving og dybere infrastrukturkontrol.
Grok 4.7 vs MiMo-V2.6-Pro i et overblik
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | 21. september 2026 | 22. september 2026 |
| Access and control | Proprietær API og administreret agentesystem | Åbne vægte, selv-hosting-mulighed og API-adgang |
| Performance evidence | Udbyder-rapporteret styrke i kodning og langvarige agentopgaver; validér på den samme opgaveramme | Udbyder-rapporteret styrke på tværs af ræsonnering, kodning og multimodale opgaver; validér på den samme ramme |
| Distinctive strengths | Førstepartsværktøjer, administrerede workflows og web/X-forbundne agenter | Udrulningskontrol, 1M-token kontekst og tekst/billede/lyd/video-forståelse |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Tekst og billede | Tekst, billede, lyd og video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0,435 / $0,87 |
| Reasoning | Low til xHigh | Dyb ræsonnering |
| Open weights | Nej | Nej |
| Best fit | Administrerede kodnings- og agent-workflows | Privat udrulning, multimodalt input og lavere rå tokenomkostning |
Hvad er Grok 4.7?
SpaceXAI udgav officielt Grok 4.7 den 21. september 2026 som deres mest kapable model til kodning og vidensarbejde. Lanceringen er vigtig, fordi før-udgivelsesrapportering blandede bekræftede fakta med lækkede arkitekturpåstande. Den endelige lanceringsdokumentation offentliggør ikke et samlet eller aktivt parameterantal, så før-udgivelses parameterestimater bør ikke behandles som officielle specifikationer.
Ifølge det officielle lanceringsindlæg bruger Grok 4.7 en ny, større basismodel end Grok 4.6 og blev trænet med en længere forstærkningslæringskørsel, vægtet mod problemer, der tager mange timer at fuldføre.
Modellerne optimerer forskellige lag af stakken. Grok 4.7 tilbyder et rigere administreret miljø omkring modellen; MiMo-V2.6-Pro eksponerer mere af model- og udrulningslaget for udviklere.
For prompts over 200K tokens anvender SpaceXAI højere-kontekst-priser. Den offentliggjorte tier er $4 per million inputtokens, $1 per million cachet inputtokens og $12 per million outputtokens.
Ændringer i Grok 4.7
Den mest meningsfulde ændring er træningsmålet, ikke blot et højere benchmarktal. SpaceXAI siger, at deres forstærkningslæringsmix skiftede mod længere, multi-timers opgaver, mens modellen blev trænet til at verificere sit eget arbejde mere omhyggeligt og til at forstå Grok Bot-harnessen naturligt. Den kombination målretter mod reel agenteksekvering: vedligeholde tilstand, bruge værktøjer, tjekke mellemarbejde og forblive sammenhængende gennem lange opgavetræk.
Grok 4.7-ydelse
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| EEBench | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| Harvey Legal Agent Benchmark | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
* SpaceXAI markerer Grok 4.7 DeepSWE som høj indsats. Disse er leverandørpublicerede evalueringer og bør tolkes under den dokumenterede ramme og ræsonneringsindstillinger.
SpaceXAI præsenterer lanceringsdiagrammerne som web-nativt indhold på den officielle annonceside; tabellen ovenfor bevarer de oplyste benchmarkværdier uden at erstatte et omtegnet diagram.
Hvad er Xiaomi MiMo-V2.6?
Xiaomi udgav officielt og open-sourced MiMo-V2.6 den 22. september 2026. Familien inkluderer MiMo-V2.6-Pro og MiMo-V2.6-Flash, med en Pro-UltraSpeed-servingmulighed til latency-følsomme arbejdsbelastninger. Til en direkte Grok 4.7-sammenligning er MiMo-V2.6-Pro den passende flagskibsmodpart.
Xiaomis officielle materialer dokumenterer særskilt åbne vægte, indbygget multimodal input og API-prissætning. Denne kombination gør MiMo-V2.6 relevant ud over benchmark-leaderboards.
MiMo-V2.6 vs MiMo-V2.5: Hvad blev forbedret?
Arkitekturens overskrift er ikke blot et større checkpoint. Xiaomis offentlige release fokuserer tungt på eftertræning og Live RL. Ifølge de officielle udgivelsesnoter gennemførte Pro og Flash hver 30 forstærkningslærings-trin og genererede tilsammen omtrent 750.000 trajektorier; de oplyste RL-stadieomkostninger var cirka $2,62 mio. for Pro og $850.000 for Flash.
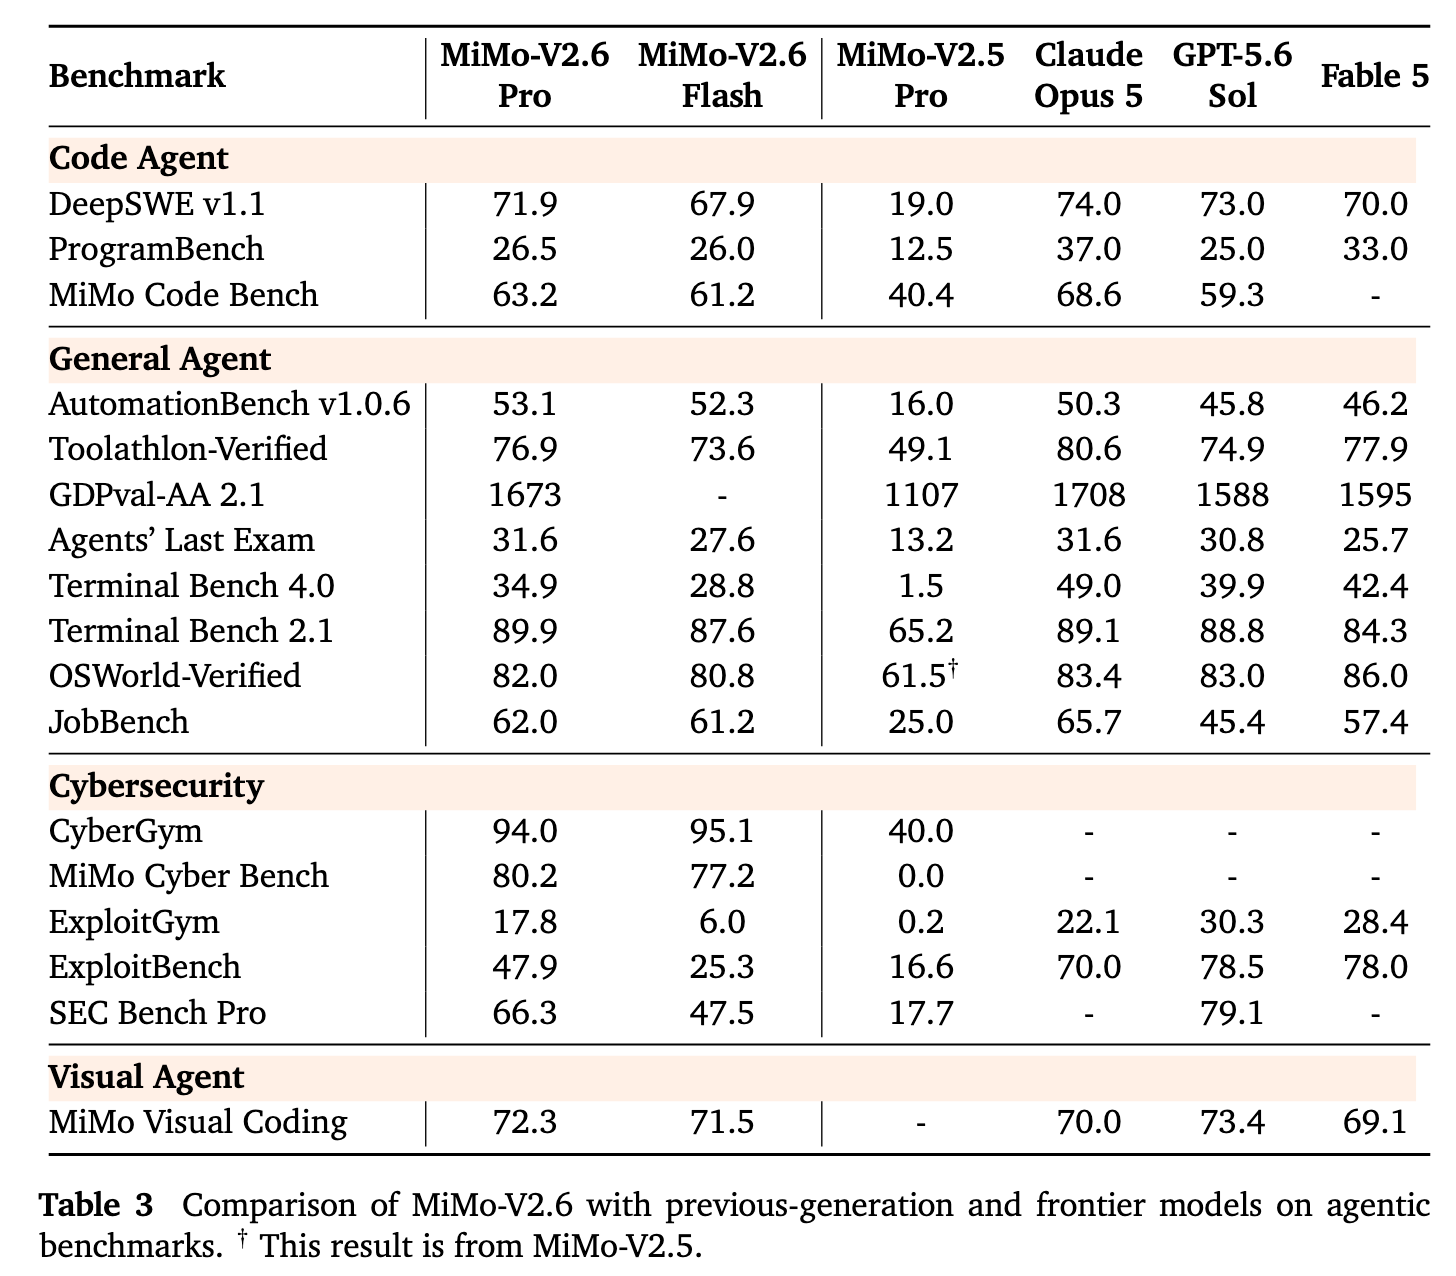
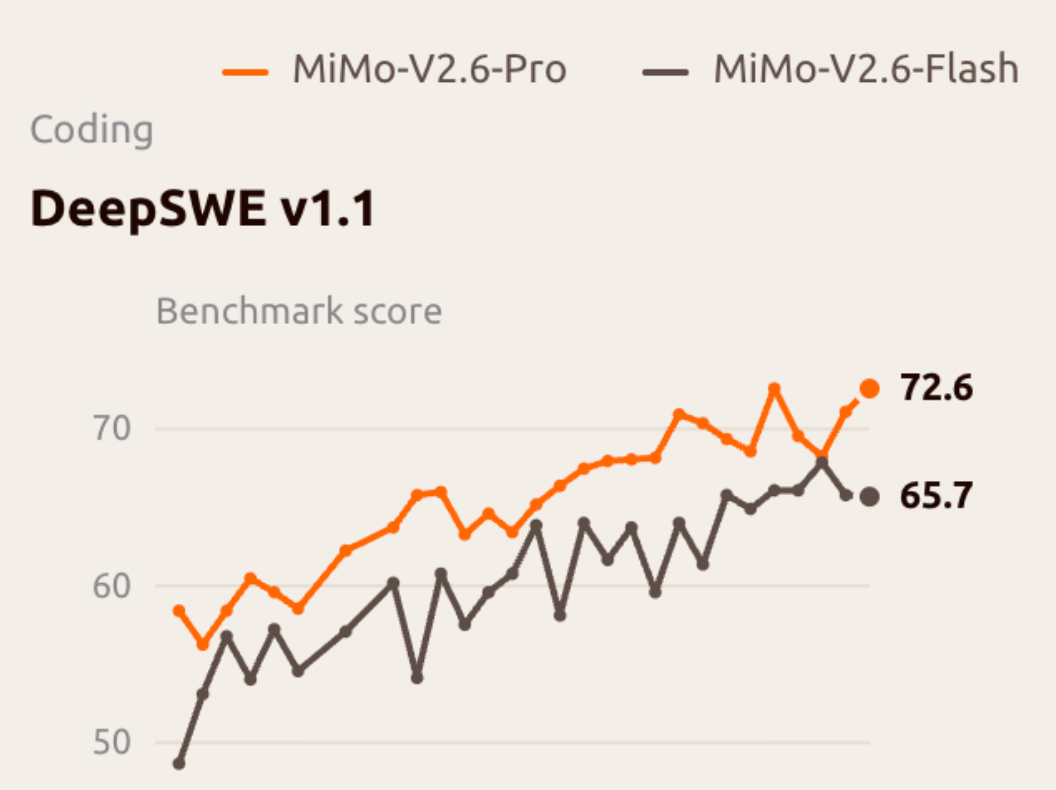
Én benchmarkdetalje kræver omhyggelig håndtering: Xiaomis Live RL-kurve viser MiMo-V2.6-Pro nå omkring 72,6 på DeepSWE v1.1 under træningskørslen, mens den endelige sammenligningstabel rapporterer 71,9. Disse tal refererer til forskellige rapporterede evalueringskontekster og bør ikke fusioneres stille.
Grok 4.7 vs MiMo-V2.6-Pro: Benchmark-sammenligning
Direkte benchmark-sammenligninger kræver forsigtighed. Leverandører bruger ikke altid identiske rammer, ræsonneringsbudgetter, checkpoints eller værktøjskonfigurationer. Selv når benchmarknavne matcher, kan små forskelle i score være mindre meningsfulde, end de ser ud. Den sikreste sammenligning er at adskille reelt afstemte målinger fra retningsgivende evidens.
Artificial Analysis Intelligence Index
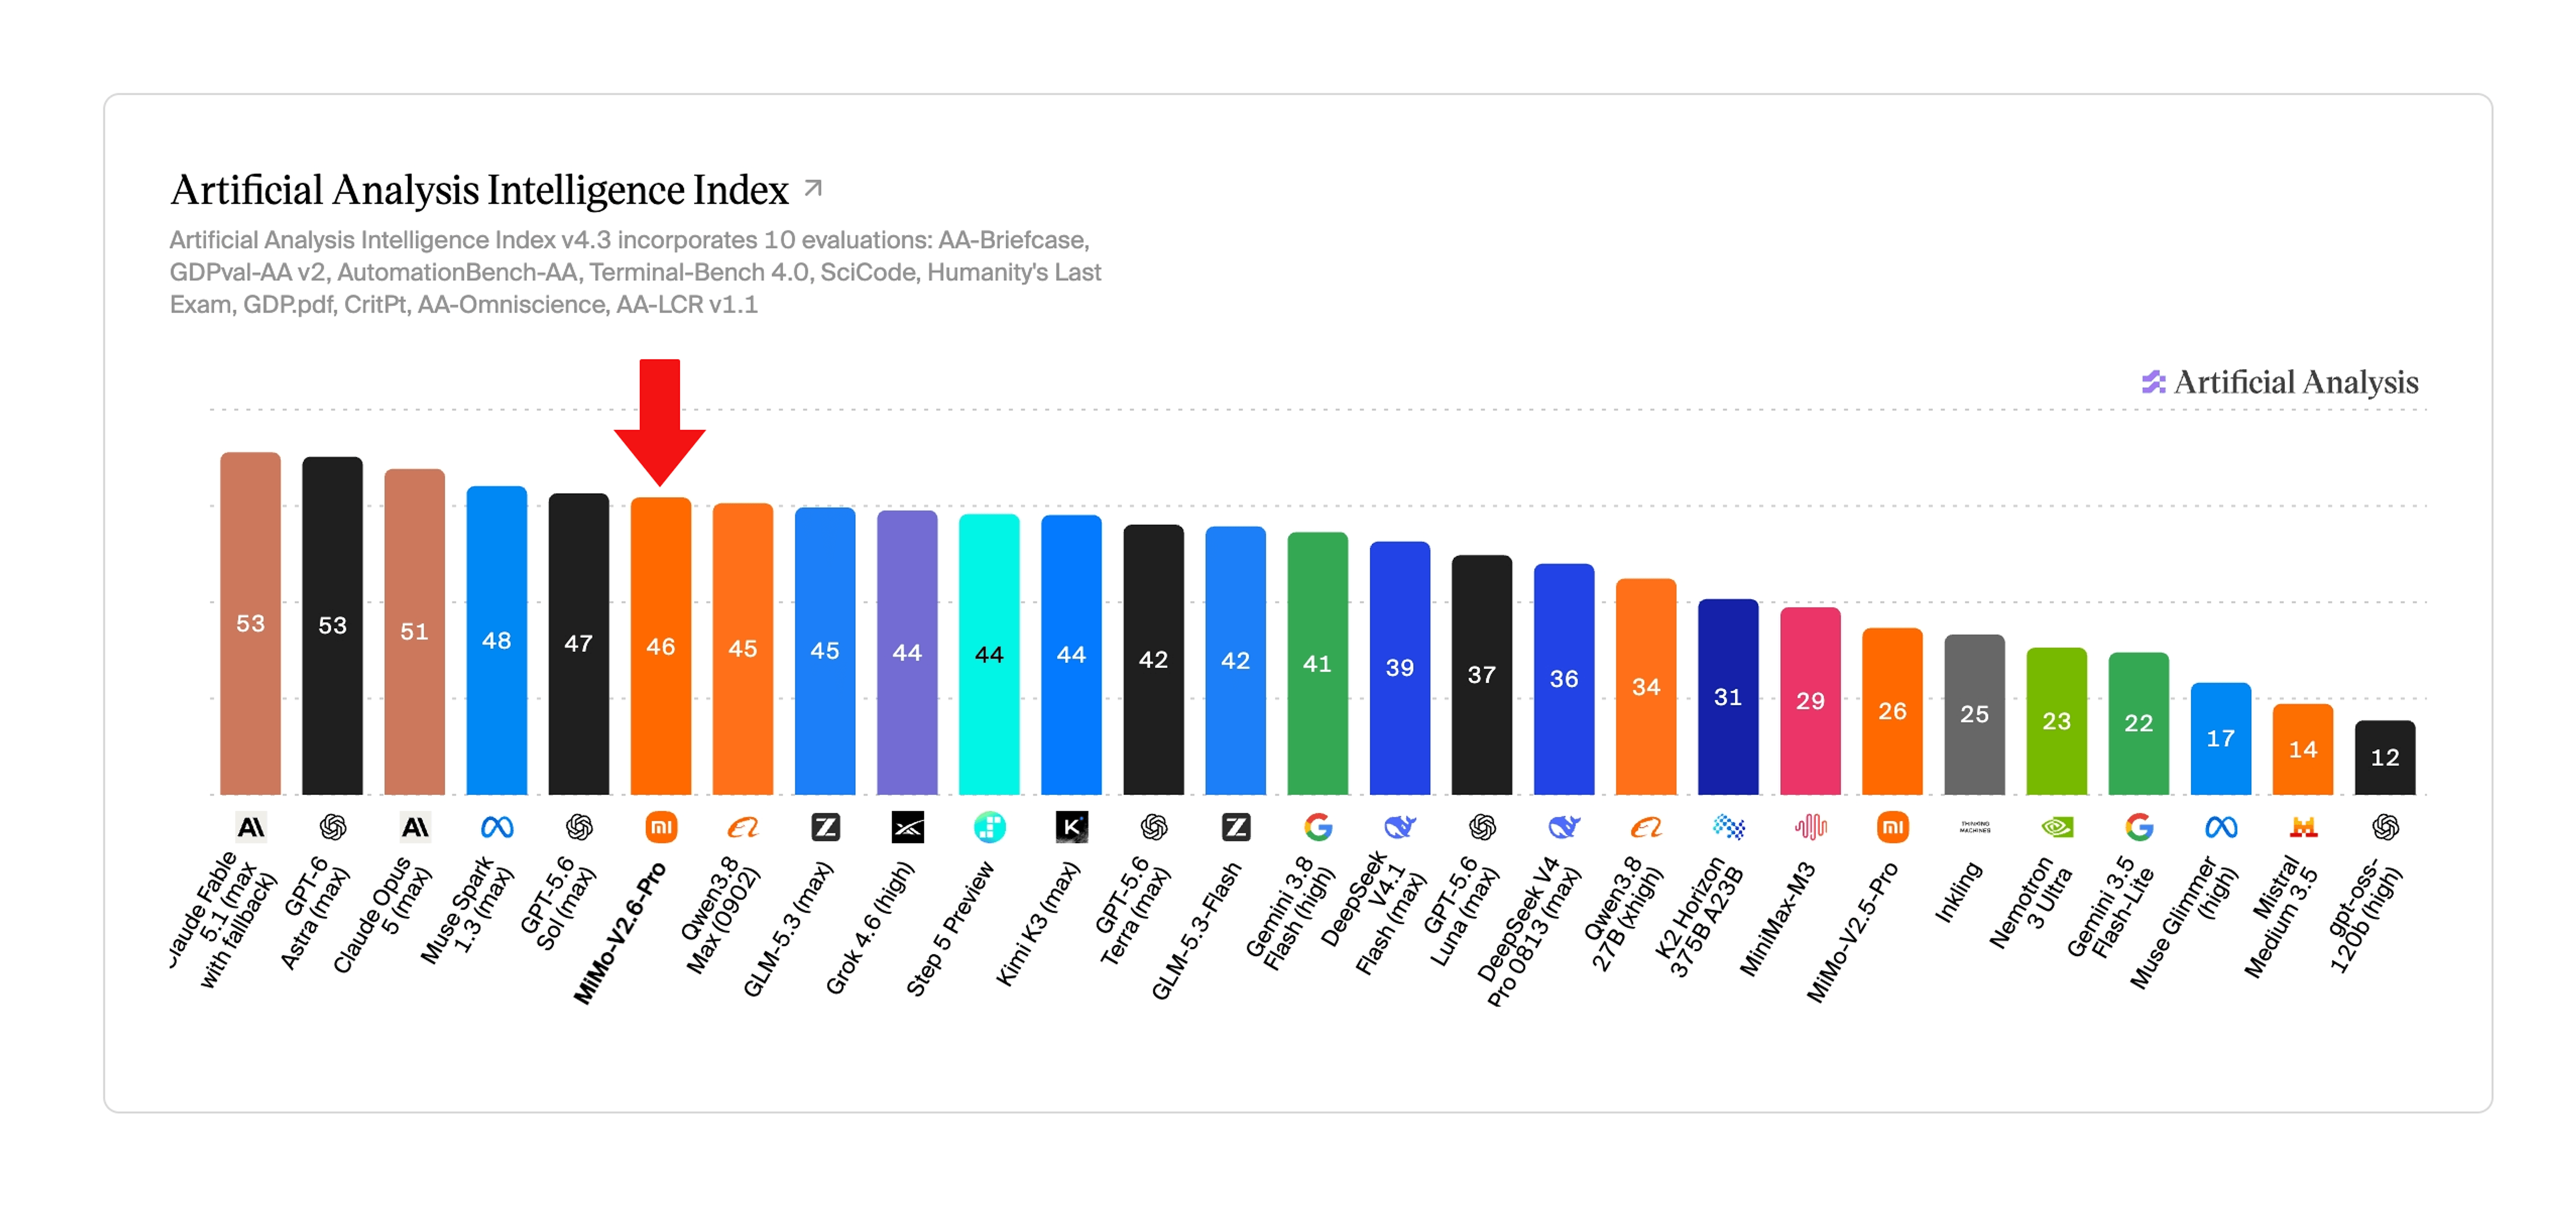
Xiaomi rapporterer 46,32 for MiMo-V2.6-Pro på Artificial Analysis-kompositindekset. Enhver Grok-sammenligning bør knyttes til den nøjagtige Artificial Analysis-snapshot og modelkonfiguration, der er brugt; en afrundet lighedspåstand bør ikke præsenteres uden den kilde.
Kodnings- og agentydelse
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Fortolkning |
|---|---|---|---|
| DeepSWE v1.1 | 71,0* | 71,9** | Tæt numerisk; publicerede kørseler og indstillinger adskiller |
| GDPval-AA | Se SpaceXAI-diagram | 1.673 | Kun retningsgivende, medmindre rammerne er afstemt |
| AA Briefcase | 1.657 | Se Xiaomi-diagram | Brug leverandør-rapporterede værdier med kildekontekst |
| Terminal-Bench 4.0 | 38,0 | 34,9 | Lignende retning; ramme betyder noget |
| Context window | 500K | 1M | MiMo understøtter mere arbejdende kontekst |
* SpaceXAI rapporterer Grok 4.7 DeepSWE ved høj indsats. ** Xiaomis endelige sammenligningstabel rapporterer 71,9; deres Live RL-træningskurve når omtrent 72,6. Disse tal stammer fra forskellige evalueringskontekster.
Kodningsworkflow-tilpasning
For kodning afhænger skelnen af, om “kodning” betyder rå repositories-problemløsning eller en komplet administreret kodningsagent-oplevelse. På DeepSWE v1.1 er de offentliggjorte tal tæt nok på hinanden til, at et under-et-punkt-gap ikke bør afgøre produktionsvalg alene.
Grok 4.7's fordel ligger højere i stakken. Den er integreret med Grok Build, tilgængelig i Cursor, designet til at forstå Grok Bot-harnessen og parret med førsteparts-kodeeksekverings- og søgeværktøjer.
MiMo-V2.6-Pro's fordel ligger lavere i stakken. Åbne vægte gør det praktisk at bygge en privat kodningsassistent, tilpasse serving, håndhæve dataresidens-kontroller eller eksperimentere med en proprietær agent-ramme.
For teams, der vælger mellem dem, vil en produktions A/B-test på repræsentative repositories være mere informativ end en enkelt offentlig kodningsbenchmark.
Grok 4.7 vs MiMo-V2.6-Pro: Forskelle i multimodal kapabilitet
Dette er en af de klareste forskelle. Grok 4.7 accepterer tekst- og billedinput og genererer tekst. Den bredere Grok-platform tilbyder separate medieprodukter, men disse bør ikke forveksles med modality-overfladen af selve grok-4.7-modellen.
MiMo-V2.6-Pro understøtter tekst-, billede-, lyd- og videoforståelse. Kombineret med et kontekstvindue på 1M tokens udvider dette rækken af workflows, der kan håndteres i én modelkontekst.
- Skærmbillede og kodeanalyse i samme opgave
- Videoforståelse med ledsagende instruktioner
- Langformat lydbehandling
- Agenter til computerbrug med visuel feedback
- Multimodale forskningsassistenter
- Storskala multimodal ekstraktion og QA
Grok 4.7 vs MiMo-V2.6-Pro: API-prissammenligning
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2,00 | $0,435 |
| Cached input / 1M | $0,50 | $0,0036 |
| Output / 1M | $6,00 | $0,87 |
| Long-context surcharge | Ja, over 200K prompttokens | Ingen tilsvarende standardtier publiceret |
| Open-weight/self-host option | Nej | Ja |
Ved listepris er MiMo-V2.6-Pro flere gange billigere på både normalt input og genereret output, med en især stor forskel for cachet kontekst. Det kan materielt påvirke økonomien for agenter, der gentagne gange behandler repositories, lange dokumenter eller vedvarende kontekst.
Vigtig prisbemærkning: Grok 4.7's kontekstvindue på 500K betyder ikke, at hele konteksten faktureres til standardraten. Anmodninger over 200K prompttokens faktureres i lang-kontekst-tieren.
Pr. 24. september 2026 lister CometAPI Grok 4.7 til $1,60 input og $4,80 output per 1M tokens, mod de officielle $2,00 og $6,00. Den lister MiMo-V2.6-Pro til $0,348 input og $0,696 output, mod de officielle $0,435 og $0,87. Disse opførte standardrater er 20 % under de tilsvarende officielle rater. Priser og berettigelse kan ændre sig; bekræft de aktuelle modelsider før budgettering.
Tokenpris er ikke identisk med omkostning per fuldført opgave. Ræsonneringsmodeller kan forbruge forskellige tokenvolumener, bruge forskellige antal værktøjskald og kræve forskellige genforsøgsrater. Produktionsevaluering bør derfor spore omkostning per fuldført opgave, latenstid og succesrate sammen.
Grok 4.7 vs MiMo-V2.6-Pro: Adgang og tilgængelighed
Adgangsforskellen er ligetil: Grok 4.7 er tilgængelig via API og administrerede Grok-workflows, mens dens modelvægte ikke tilbydes til selv-hosting. MiMo-V2.6-Pro er tilgængelig via API og som åbne vægte, hvilket giver teams en ekstra selvhostet vej.
Tilgængelighed er separat fra licens eller udrulningsfleksibilitet. Pr. 24. september 2026 har begge modeller også live CometAPI-katalogsider. Teams bør bekræfte endpoint, region, ratelimits og konto-berettigelse før produktionsudrulning; en opført model garanterer ikke identisk tilgængelighed eller serviceniveauer for hver konto.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Tilgængelig via xAI | Tilgængelig via Xiaomi MiMo |
| CometAPI catalog | Listet som tilgængelig | Listet som tilgængelig |
| Self-hosted weights | Ikke tilgængelig | Åben-vægtsmulighed |
| Operational check | Bekræft konto-adgang, region, ratelimits og værktøjs-tilgængelighed | Bekræft konto-adgang, endpoint-parathed og krav til selv-hosting |
Åbne vægte og proprietær adgang
At MiMo-V2.6-Pro er med åbne vægte ændrer sammenligningen mere end et ét-punkts benchmark-gap. Det skaber muligheder for privat udrulning, tuning af inferensmotor, tilpasset eftertræning, dataresidens-kontroller og dybere infrastrukturintegration.
Grok 4.7 tager det modsatte kompromis: mindre kontrol over modelinternals til gengæld for en administreret, kontinuerligt drevet service og et tæt integreret førstepartsøkosystem. For mange organisationer vil styring og infrastrukturkrav afgøre shortlisten før benchmark-ydelse gør.
Sådan bruger du Grok 4.7- og MiMo V2.6-API'er i CometAPI
Udviklere kan få adgang til Grok 4.7 API i CometAPI via en samlet API-workflow, hvilket reducerer behovet for at vedligeholde separate leverandørspecifikke integrationer.
For teams, der benchmarker flere frontier-modeller, er et samlet API-lag især nyttigt, fordi de samme produktionsprompts, test-ramme, tokenregnskab og applikationskode kan afspilles på tværs af modeller med færre integrationsvariabler.
CometAPI lister nu MiMo-V2.6-Pro som tilgængelig, med API-tilgængelighed bekræftet den 22. september 2026. Tjek det live katalog og konto-adgang før produktionsbrug.
Med begge modelsider nu listet som tilgængelige kan en applikationsniveau A/B-test holde prompts, værktøjer, ræsonneringsindstillinger og succeskriterier så konsistente som muligt og derefter sammenligne opgavefuldførelse, latenstid, tokenforbrug og fejlfunktioner.
Grok 4.7 vs MiMo-V2.6-Pro: Modelpasform efter brugssag
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Benchmark begge på repræsentative repositories |
| Professional knowledge agents | Benchmark begge på produktionstasks |
Beslutningen bør derfor indrammes omkring arbejdsbelastningsarkitektur. Grok 4.7 er designet til at gøre en administreret agentstak mere kapabel; MiMo-V2.6-Pro er designet til at gøre højende intelligens billigere, mere multimodal og mere kontrollerbar.
Hvilken skal du vælge?
Vælg Grok 4.7, hvis du vil have en administreret agentoplevelse med førsteparts web- og X-søgning, indbygget kodeeksekvering og mindre infrastruktur at drive. Det er den mere praktiske mulighed for teams, der værdsætter en integreret værktøjsstak og langvarige professionelle eller kodningsworkflows.
Vælg MiMo-V2.6-Pro, hvis du har brug for åbne vægte, privat udrulning, et kontekstvindue på 1M tokens, indbygget lyd- og videoforståelse eller væsentligt lavere rå API-prissætning. Det er den stærkere mulighed, når udrulningskontrol, multimodal dækning og omkostningseffektivitet er de primære begrænsninger.
Hvis valget stadig er uklart, så kør begge modeller på de samme repræsentative opgaver med identiske prompts, værktøjer, ræsonneringsbudgetter, timeouts og genforsøgspolitikker. Vælg den model, der leverer den bedste kombination af fuldførelsesrate, latenstid, total omkostning per succesfuld opgave og menneskelig gennemgangsindsats.
Konklusion
Grok 4.7 vs MiMo V2.6 er afslørende, fordi rå intelligens ikke længere er den eneste meningsfulde differentiant. Begge modeller befinder sig i et lignende højkapabilitetsbånd i aktuelle offentlige evalueringer, men deres produktstrategier divergerer skarpt.
Grok 4.7 kombinerer et kontekstvindue på 500K, konfigurerbar ræsonnering, stærk langhorizon-agenttræning og en moden førsteparts søge- og eksekveringsstak. MiMo-V2.6-Pro kombinerer et 1M-kontekstvindue, indbygget multimodalt input, åbne vægte og API-priser langt under mange proprietære frontier-systemer.
For udviklere er det praktiske spørgsmål derfor mindre “hvilken benchmarkscore er højere?” og mere “hvor skal intelligensen leve?” Et administreret agentesystem og en åben, tilpasningsbar modelstak løser forskellige driftsproblemer. Det rigtige valg er det, der bedst matcher produktionsarbejdsbelastningen, infrastrukturbegrænsningerne og omkostningsmodellen.
Ofte stillede spørgsmål
Er Grok 4.7 en 2,1-billion-parametermodel?
Et cirka 2,1T-tal cirkulerede før udgivelsen, men den endelige SpaceXAI Grok 4.7-dokumentation offentliggør ikke samlede eller aktive parameterantal. Den bekræftede erklæring er, at Grok 4.7 bruger en større basismodel end Grok 4.6.
Er MiMo-V2.6 open source?
Xiaomi udgav MiMo-V2.6 som en åben modelfamilie med downloadbare vægte og tilknyttede forskningsressourcer. I produktionsplanlægning bør teams stadig gennemgå den præcise modellincens og videregivelsesvilkår for deres tiltænkte brug.
Hvor meget koster Grok 4.7 vs MiMo-V2.6-Pro per fuldført agentopgave?
Normaliser opgavesættet, prompts, værktøjstilladelser, genforsøgspolitik og succeskriterier. Spor samlet input, cachet input, ræsonnerings- og outputtokens, værktøjskald, latenstid, genforsøg og tid til menneskelig gennemgang. Rå tokenpris er kun én komponent i omkostning per fuldført opgave.
Hvor pålidelige er Grok 4.7 vs MiMo-V2.6-Pro benchmark-sammenligninger?
Brug det samme repository- eller opgavesæt, agentramme, værktøjer, ræsonneringsbudget, timeout, genforsøgspolitik og scorerubrik. Rapportér konfidensintervaller eller variation ved gentagne kørseler, og hold leverandørpublicerede tal adskilt fra interne resultater.
Opkræver Grok 4.7 mere for lang-kontekst-prompts?
SpaceXAI dokumenterer højere rater, når prompttokens overstiger 200K. Fordi den højere tier gælder for anmodningen, bør teams, der bruger store repositories eller vedvarende agentkontekst, modellere tærsklen eksplicit.