Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Sådan kører du DeepSeek-V4.1-Flash lokalt med vLLM, herunder GPU-krav, 511 GB checkpoint-størrelse, opsætningskommandoer, SGLang, Ollama og API-alternativer.
DeepSeek-V4.1-Flash er open-weight og kan self-hostes, men “lokal” betyder ikke “på en gaming-PC.” DeepSeek beskriver den som en 552B-parameter Mixture-of-Experts-rygrad med en Causal Encoder-Decoder-arkitektur, hvor kun 8B parametre er aktive under promptbehandling og 16B under generering. Den fulde model er stadig et frontier-scale deploymentsmål.
Den nuværende vLLM-deploymentsopskrift placerer checkpointet på cirka 511 GB på disk og omkring 614 GB minimum VRAM, hvilket gør en 8×H200-klasse server eller et tilsvarende højhukommelsessystem langt mere realistisk end en forbrugerarbejdsstation.
For teams der kun har brug for adgang frem for kontrol på vægtniveau, er DeepSeek V4.1 Flash API i CometAPI væsentligt enklere end at vedligeholde en multi-GPU inference-server.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Hvordan kører man DeepSeek-V4.1-Flash lokalt? - CometAPI
Vigtige pointer
DeepSeek-V4.1-Flash bruger en 552B MoE-rygrad med 8B aktive parametre under prefill og 16B under decode; aktive parametre repræsenterer ikke kravet til resident memory.
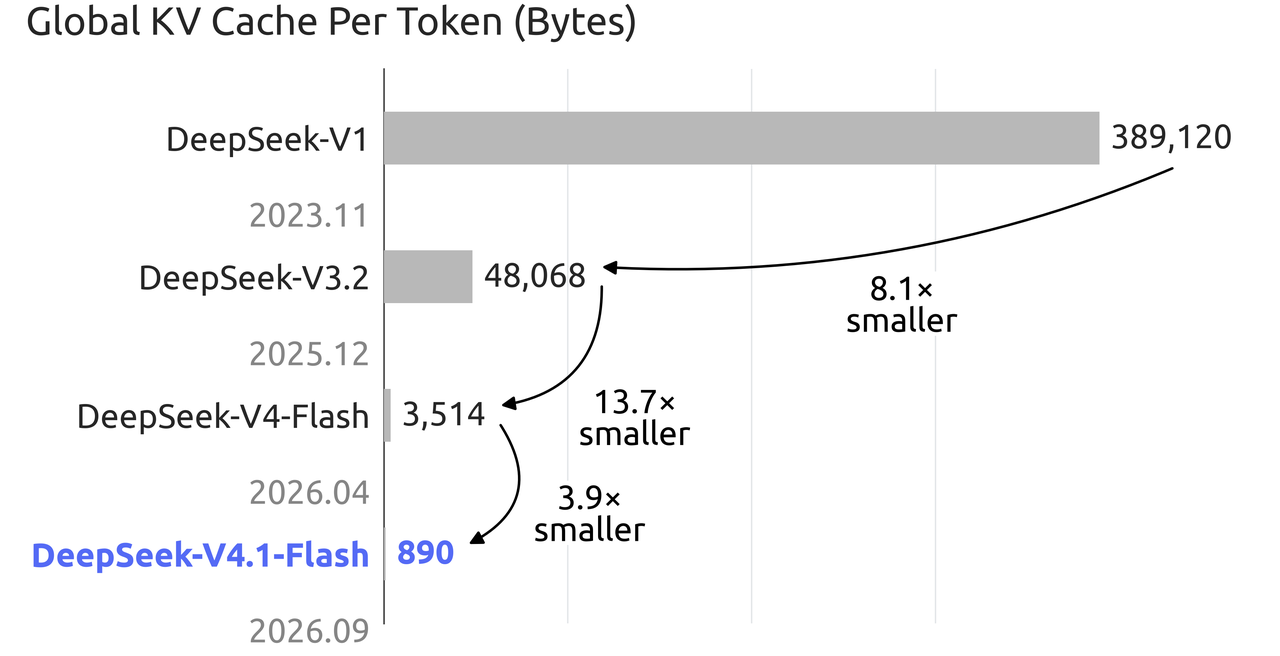
Dets kontekstvindue på 1,048,576 tokens og 890 byte per token i global KV-cache reducerer cache-tryk, men modelvægtene dominerer stadig kapacitetsplanlægningen.
Det officielle checkpoint er omkring 511 GB på disk. vLLM-opskriften anslår omtrent 614 GB samlet brugbar VRAM som minimumsbudget for at loade modellen og dens runtime-overhead; dette er et baselineestimat, ikke en garanti for enhver batchstørrelse, konteksts længde eller multimodal konfiguration.
vLLM er den klareste produktions-serving-vej, mens SGLang sigter mod avanceret distribueret inference; Ollamas nuværende rute er cloud-hostet frem for fuld lokal inference.
Self-hosting er mest overbevisende for privatliv, air-gappet drift, forskning på vægtniveau eller vedvarende klyngeudnyttelse; de fleste udviklere vil finde et hostet API enklere.
Hvad er DeepSeek-V4.1-Flash? Arkitektur, parametre og modelstørrelse
DeepSeek udgav officielt V4.1-Flash den 10. september 2026 som den mindste model i den nye arkitekturfamilie, med indbygget visuel forståelse. På trods af “Flash”-navnet er det ikke en lille tæt model.
Den vigtigste arkitektoniske ændring er Causal Encoder-Decoder (CED)-designet. Modellen deler beregning asymmetrisk mellem promptindtagelse og tokengenerering, hvilket reducerer aktiv compute, mens en meget stor ekspertsum bevares.
Specifikation
DeepSeek-V4.1-Flash
Arkitektur
Multimodal MoE med Causal Encoder-Decoder
Backbone-parametre
552B
Aktive parametre, input
8B
Aktive parametre, output
16B
Transformer-lag
40: 20 encoder + 20 decoder
Kontekstvindue
1,048,576 tokens
Global KV-cache
890 bytes/token
Modaliteter
Tekst + billedinput, tekstoutput
Licens for vægte
MIT
Anbefalet sampling
Temperature 1.0; top_p 0.95 eller 1.0
Officielle vægte
Hugging Face
Primære lokale serving-muligheder
vLLM, SGLang, DeepSeek reference inference
Skelnen mellem aktive parametre og resident parametre er afgørende. MoE-routing reducerer mængden af beregning brugt for et individuelt token, men serveren skal stadig have adgang til de ekspertvægte, der kan blive valgt. Derfor kan en “8B aktiv” model stadig kræve hundredvis af gigabytes lager- og acceleratorhukommelse.
DeepSeeks officielle KV-cache-graf viser, at den globale cache falder fra 3.514 bytes per token i V4 Flash til 890 bytes per token i V4.1 Flash, en reduktion på omkring 3,9×. Det er vigtigt for inference med million-token-kontekst, men det eliminerer ikke det langt større hukommelseskrav skabt af selve modelvægtene.
Hvor god er DeepSeek-V4.1-Flash, før du ruller den ud?
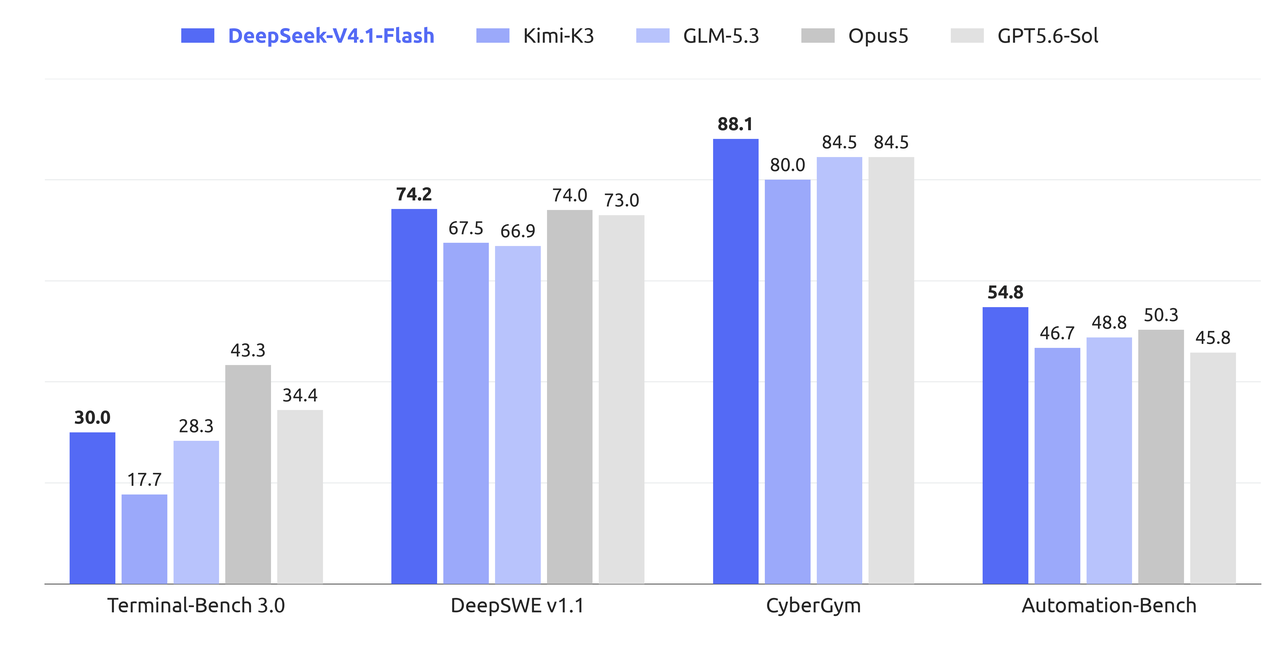
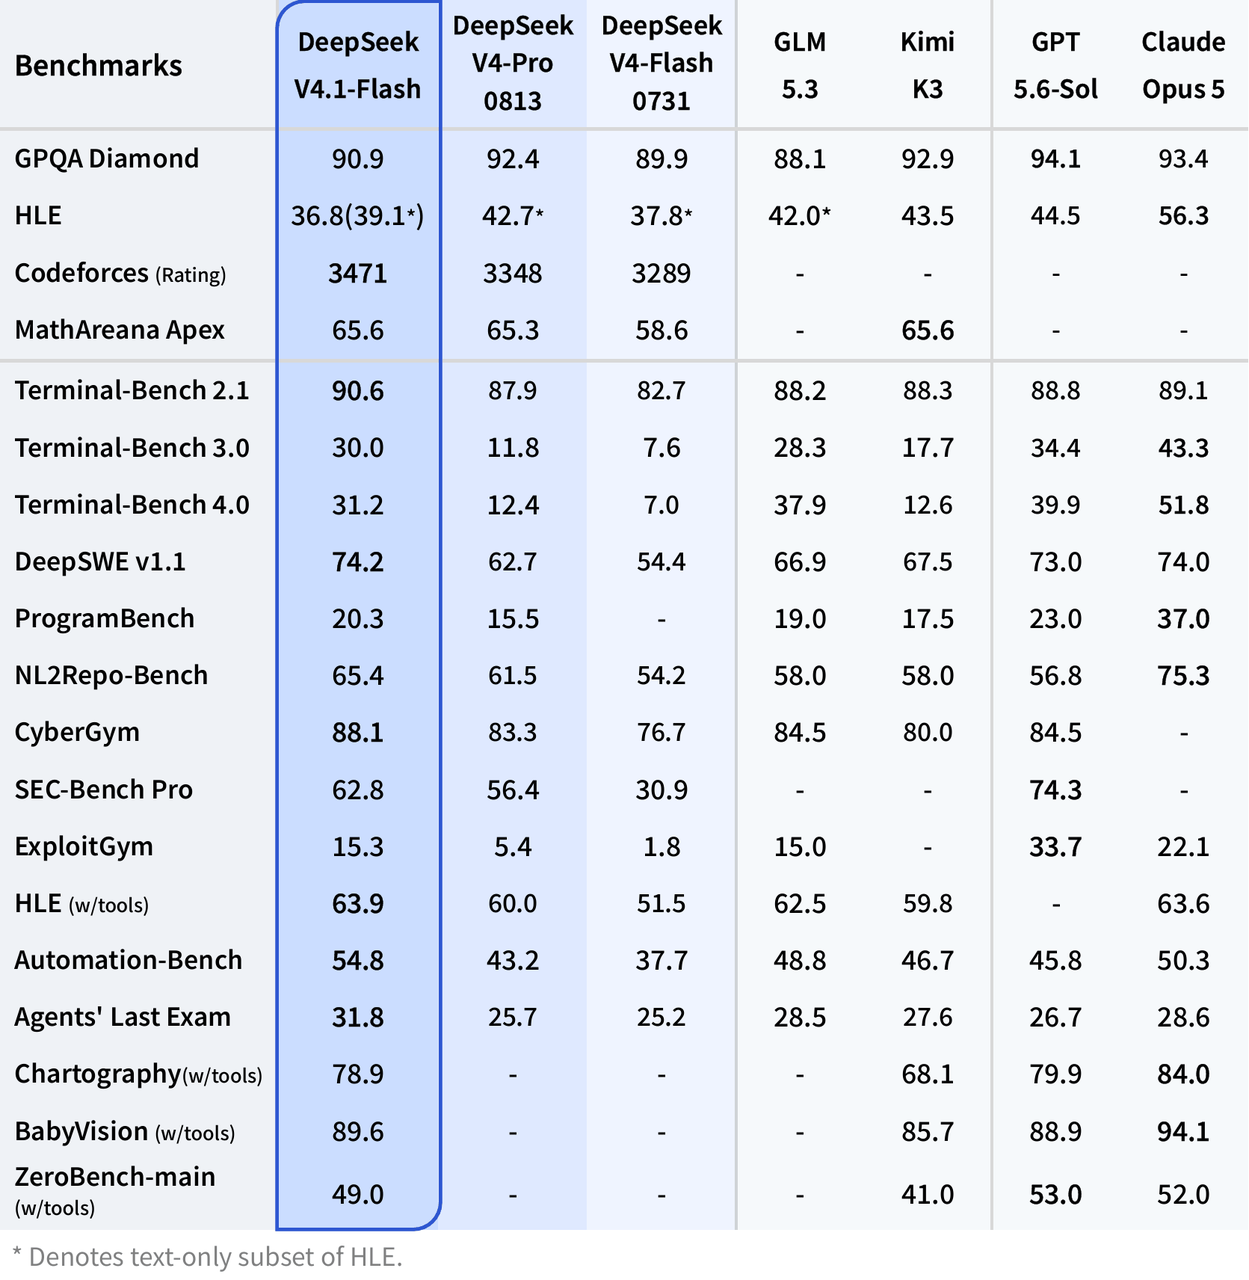
DeepSeeks offentliggjorte benchmark-tabel positionerer V4.1-Flash primært som en stor opgradering inden for agentisk kodning, terminaldrift, automatisering og softwareengineering-arbejdsbelastninger. Dette er leverandørrapporterede benchmarkresultater, så de bør behandles som reference målinger frem for garanteret applikationsperformance.
For reproducerbarhed anbefaler den officielle modelkort temperatur 1.0 og top_p 0.95, mens reasoning-indsats og tokenbudgetter varierer efter evaluering. Tallene nedenfor er leverandørkørte reference-resultater, ikke hardwareneutrale performanceløfter; benchmark-specifikke harness-detaljer bør konsulteres før reproduktion.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro 0813
DeepSeek V4 Flash 0731
GPQA Diamond
90.9
92.4
89.9
Codeforces Rating
3471
3348
3289
MathArena Apex
65.6
65.3
58.6
Terminal-Bench 2.1
90.6
87.9
82.7
Terminal-Bench 3.0
30.0
11.8
7.6
Terminal-Bench 4.0
31.2
12.4
7.0
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
CyberGym
88.1
83.3
76.7
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Mønsteret er vigtigere end en enkelt score. V4.1-Flash fører ikke hver benchmark, men springet fra V4 Flash 0731 er især stort på Terminal-Bench, DeepSWE, automatisering og cybersikkerheds-arbejdsbelastninger. Dette gør lokal deployment særligt relevant for private kodeagenter, repository-skalaanalyse, intern automatisering og air-gappet agentinfrastruktur.
Kan du virkelig køre DeepSeek-V4.1-Flash lokalt?
Ja, men ordet “lokalt” kræver kvalificering. Den seneste vLLM-opskrift for DeepSeek-V4.1-Flash nedbryder checkpointet til cirka et halvt terabyte og anbefaler et meget større VRAM-budget, når runtime-overhead medregnes.
Komponent
Omtrentlig lagret størrelse
Routed + DSpark-eksperter
259.5 GiB
Engram-tabeller
183.1 GiB
Attention, tætte projektioner og routere
6.9 GiB
Embeddings, LM-head og norms
3.9 GiB
UE8M0 block scales
21.9 GiB
Fuldt checkpoint
~476 GiB / ~511 GB
vLLM anbefalet minimum VRAM-budget
~614 GB
Den vigtigste overraskelse er, at V4.1-Flash allerede er stærkt komprimeret internt. Routed ekspertvægte bruger lavpræcisionsformater, så det officielle checkpoint er ikke blot en enorm BF16-model, der venter på en nem 4-bit-konvertering.
Hardwarekrav for DeepSeek-V4.1-Flash
Hardwarekonfiguration
Praktisk status
Kommentarer
1× RTX 4090 / 5090
Nej
Langt under modellens hukommelsesfodaftryk
2–4 forbrugergrafikkort
Nej for det officielle fulde checkpoint
Samlet VRAM er fortsat utilstrækkelig
128 GB workstation
Nej
Aktive parametre bestemmer ikke resident vægthukommelse
256 GB workstation
Nej for officiel serving-vej
Stadig langt under det officielle checkpoints fodaftryk
512 GB system-RAM + GPU-offload
Eksperimentelt
Community/offload-territorium, ikke ækvivalent med verificeret produktions-serving
4× datacenter-GPU’er med stor hukommelse
Hardware-afhængigt
Muligt med tilstrækkeligt store moderne acceleratorer; tjek runtime-opskriften
8× H200
Ja, dokumenteret klasse
Omkring 1.128 GB samlet HBM
GB200 NVL4-klasse system
Ja
vLLM nævner, at et 768 GB-bakke passer til modellen
Vigtigt: 8B aktive parametre betyder ikke 8 GB VRAM. “Aktiv” beskriver, hvor meget af MoE-netværket der deltager i et tokens beregning. Det komplette ekspert-sæt skal stadig lagres et sted, som inference-motoren har adgang til.
Hvilket kørselsmiljø bør du bruge til DeepSeek-V4.1-Flash?
Kørselsmiljø
Aktuel V4.1-Flash-status
Bedst egnet til
vLLM
Nuværende deploymentsopskrift tilgængelig; nyeste image kræves
Produktions-serving kompatibel med OpenAI API
SGLang
Understøttet via nuværende DeepSeek-V4.1-deploymentsbuilds
Højtydende distribueret inference
DeepSeek reference inference
Officiel TP8 reference-implementering
Arkitekturforskning og validering
Transformers
Modelintegration eksponeret på Hugging Face
Udvikling og eksperimenter; hardware kræves stadig
Ollama
Officiel biblioteksrute bruger aktuelt :cloud
Praktisk cloud-kald, ikke ækvivalent med self-hosting
Til produktions-self-hosting er vLLM i øjeblikket det mest oplagte udgangspunkt. SGLang-deploymentsvejledning giver en anden understøttet vej for avanceret distribueret inference.
Sådan kører du DeepSeek-V4.1-Flash lokalt med vLLM
Dette er den praktiske rute for en multi-GPU Linux-server. Alle kommandoeksempler nedenfor er omformateret som sprogspecifikke kodeblokke med korte engelske beskrivelser.
Trin 1: Tjek dit miljø
Linux.
Docker.
NVIDIA Container Toolkit.
Flere hundrede gigabyte ledig SSD-plads.
En understøttet multi-GPU-konfiguration.
Omtrent 614 GB samlet brugbar acceleratorhukommelse for den nuværende officielle vægt-servingprofil.
Et hurtigt netværk, hvis modellen ikke allerede er cachet lokalt.
Trin 2: Download DeepSeek-V4.1-Flash-vægtene
De officielle vægte hostes i DeepSeek-V4.1-Flash Hugging Face-repositoriet under MIT-licensen.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Sørg for, at filsystemet, der indeholder ~/.cache/huggingface, har væsentligt mere end 511 GB ledig plads. Midlertidige filer og yderligere engine-artefakter kan øge peak-diskforbruget.
Trin 3: Start DeepSeek-V4.1-Flash med vLLM
I henhold til den nuværende vLLM-opskrift kræver DeepSeek-V4.1-understøttelse et tilstrækkeligt nyt vLLM-image. En tekst-only otte-GPU startkonfiguration kan se sådan ud:
Der er to bevidste valg her. For det første deaktiverer --language-model-only visions-encoderen for tekst-only workloads. For det andet er det tryggere at starte ved 131.072 tokens end at aktivere det fulde million-token-kontekst med det samme. Når serveren er stabil, kan du øge den:
--max-model-len 1048576
Den passende tensor-parallel-indstilling afhænger af accelerator-topologien, så kopier ikke blindt --tensor-parallel-size 8 til hver server.
Trin 4: Test den lokale DeepSeek-V4.1-Flash-endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Trin 5: Kald din lokale DeepSeek-V4.1-Flash-server med Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Hvordan aktiverer du DeepSeek-V4.1-Flash thinking mode lokalt?
V4.1-Flash understøtter eksplicitte reasoning-kontroller via sin chattemplate. Et eksempel er:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Hvis modellen ser ud til at returnere lidt eller intet endeligt indhold med en lille max_tokens-værdi, så tjek om thinking-mode forbruger genereringsbudgettet, før du antager, at deployment er i stykker.
Hvordan kører du DeepSeek-V4.1-Flash med referencekode?
DeepSeek inkluderer også en minimal TP8 inference-implementering inde i modelrepositoriet. Den er primært tiltænkt som læsbar referencekode frem for en høj-throughput produktionsserver.
cd inference
python -m pip install -r requirements.txt
Denne rute er nyttig til at inspicere CED, MoE-routing, Engram-hukommelse, spekulativ decoding og relaterede implementeringsdetaljer. Til normal produktions-serving er vLLM eller SGLang lettere at drive.
Kan du køre DeepSeek-V4.1-Flash lokalt med Ollama?
Ikke i samme forstand som at køre en normal 7B- eller 32B-Ollama-model. Ollama eksponerer i øjeblikket V4.1-Flash via:
ollama run deepseek-v4.1-flash:cloud
Det vigtige er :cloud. Den aktuelle Ollama-biblioteksindgang bruger en cloud-rute, så denne kommando er ikke det samme som at downloade de komplette vægte og udføre inference udelukkende på din egen maskine.
DeepSeek-V4.1-Flash lokal deployment vs API: Hvad giver mest mening?
Dimension
Lokal DeepSeek-V4.1-Flash
Hostet API
Forudgående hardwareomkostninger
Meget høje
Ingen
Accelerator-hukommelse
~614 GB praktisk officielt mål
Håndteres af udbyder
Modelkontrol
Fuld
Begrænset
Data forbliver on-premises
Ja
Nej
Ændring af vægte
Ja
Nej
Vedligeholdelse
Dit ansvar
Håndteres af udbyder
Opsætningskompleksitet
Høj
Lav
Skalering
Kræver infrastruktur
API-baseret
Bedst til
Air-gappet, privat, forskning, høj udnyttelse af klynger
De fleste udviklere og produktionsapps
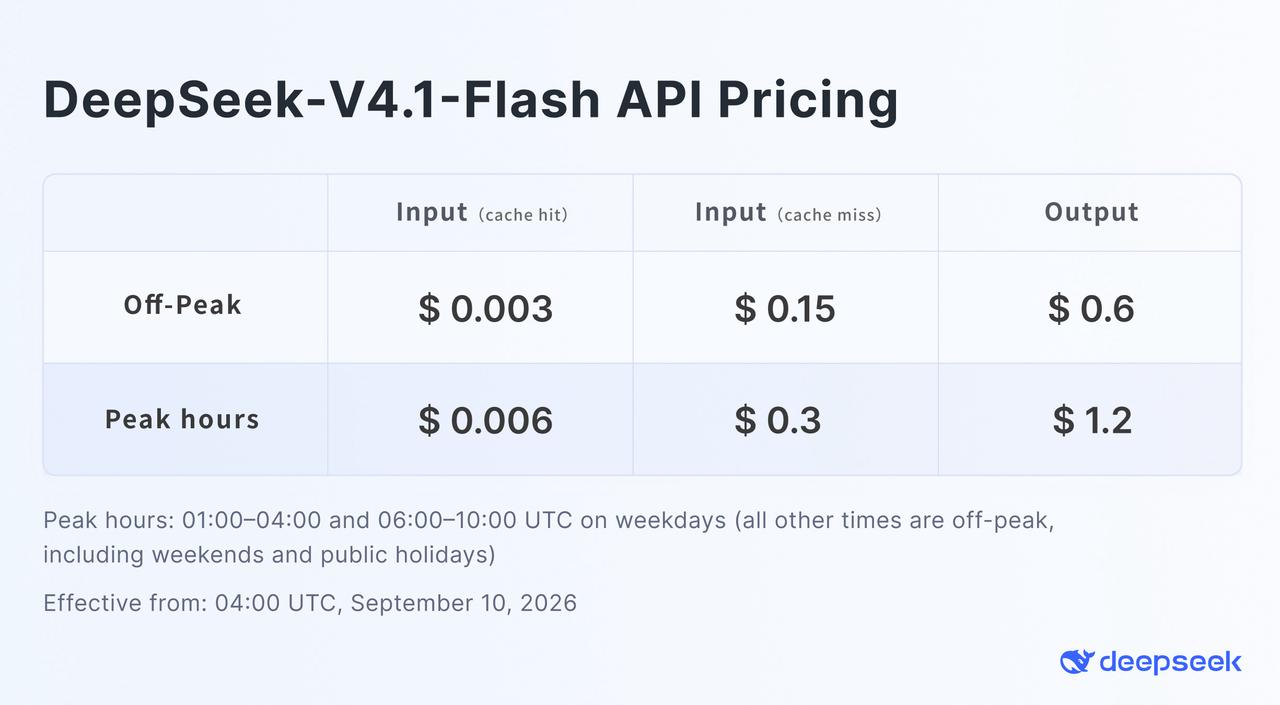
DeepSeeks officielle off-peak-priser vises i deres V4.1-Flash-prisgrafik. For udviklere, der ikke behøver fysisk besiddelse af vægtene, giver DeepSeek V4.1 Flash API i CometAPI et OpenAI-kompatibelt alternativ.
Følgende eksempel bruger CometAPIs modelidentifikator. Det er ikke identifikatoren, der bruges af DeepSeeks officielle API.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Den praktiske beslutning er ligetil: lokal deployment bliver overbevisende, når privatliv, air-gappet drift, eksperimenter på vægtniveau, forudsigelig tung udnyttelse eller regulatoriske krav opvejer infrastrukturudgiften. For almindelig applikationsudvikling undgår en hostet endpoint hundredvis af gigabytes modelhåndtering og multi-GPU-orkestrering.
Hvilke problemer kan du støde på, når du kører DeepSeek-V4.1-Flash lokalt?
Serveren løber tør for hukommelse, før generering starter
Det fulde checkpoint, ikke tallet 8B/16B for aktive parametre, bestemmer størstedelen af hukommelseskravet. Tjek tensor-parallelisme, GPU-hukommelsesudnyttelse, vision-loading og tilgængelig HBM.
DeepSeek-V4.1-Flash tager lang tid at starte
Et halvt terabyte checkpoint tager tid at downloade, mappe, initialisere og shard’e. Lange engine-ready timeouts er normale for denne modelklasse.
Svaret er tomt eller ender med finish_reason=length
Thinking mode kan forbruge genereringsbudgettet. Øg max_tokens, sænk reasoning effort, eller deaktiver thinking for simple forespørgsler.
Værktøjskald parses ikke korrekt
Sørg for, at serveren bruger DeepSeek V4.1-tokenizer, tool-call-parser, reasoning-parser og auto-tool-choice-flags.
Vision-input virker ikke
Hvis du startede med --language-model-only, har du bevidst deaktiveret den visuelle encoder. Genstart med multimodal understøttelse aktiveret, før du tester billeder.
Bør du køre DeepSeek-V4.1-Flash lokalt?
DeepSeek-V4.1-Flash er usædvanligt interessant fra et self-hosting-perspektiv, fordi arkitekturen væsentligt reducerer per-token compute og KV-cache-omkostninger, men den forvandler ikke en frontier-scale open-weight-model til en desktopmodel.
For et forskningslaboratorium, en enterprise AI-platform, en privat kodeagent-stack eller et air-gappet miljø gør vLLM og SGLang self-hosting teknisk realistisk. For en udvikler med en eller to GPU’er er det ikke et praktisk mål for fuld-model-deployment. I det tilfælde giver brug af DeepSeek V4.1 Flash via CometAPI adgang til modellen uden at gøre serving til et stort infrastrukturprojekt.
FAQ
Er DeepSeek-V4.1-Flash open source?
Dets modelvægte og repository er udgivet under MIT-licensen, som tillader bred anvendelse, ændring og redistribution under licensvilkårene.
Kan jeg køre DeepSeek-V4.1-Flash på en RTX 4090 eller RTX 5090?
Ikke den officielle fulde model. Et enkelt forbrugergrafikkort har kun en lille brøkdel af hukommelsen, som det fulde checkpoint kræver.
Betyder 8B aktive parametre, at DeepSeek-V4.1-Flash kun behøver 8 GB VRAM?
Nej. 8B-tallet beskriver de parametre, der deltager under promptbehandling. Det fulde ekspertnetværk og understøttende tilstand skal stadig lagres og være tilgængelig.
Hvor meget VRAM har DeepSeek-V4.1-Flash brug for?
Den nuværende vLLM-opskrift bruger omkring 614 GB som planlægningsgrundlag for det officielle checkpoint plus runtime-overhead. Det faktiske behov varierer med hardware, batchstørrelse, kontekst, visionsunderstøttelse og serving-konfiguration.
Hvor stor er DeepSeek-V4.1-Flash på disk?
Den nuværende vLLM-nedbrydning placerer checkpointet på cirka 476 GiB, eller omkring 511 GB.
Kan DeepSeek-V4.1-Flash køre et 1M-token-kontekst lokalt?
Arkitekturen understøtter op til 1.048.576 tokens, men praktisk hukommelsesforbrug afhænger også af batchstørrelse, runtime-buffere, vision-tilstand og anden overhead.
Kan jeg køre DeepSeek-V4.1-Flash lokalt med Ollama?
Den nuværende Ollama-indgang bruger en :cloud-rute, hvilket ikke er det samme som at køre de komplette vægte udelukkende på din egen maskine.
Er vLLM eller SGLang bedst til DeepSeek-V4.1-Flash?
Begge sigter mod højtydende serving. vLLM har i øjeblikket en særligt detaljeret V4.1-specifik opskrift, mens SGLang også er egnet til avancerede distribuerede deployment-scenarier.
Hvad er den nemmeste måde at bruge DeepSeek-V4.1-Flash uden lokal hardware?
Brug et hostet API. DeepSeek tilbyder sit eget API, mens CometAPI tilbyder et OpenAI-kompatibelt DeepSeek-V4.1-Flash-endpoint sammen med andre AI-modeller.