Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
TLDR Claude Haiku 5.5 kaldes den billigste, hurtigste og mest kapable lille model, de nogensinde har udgivet. Den er designet til højvolumen, latensfølsomme workloads såsom klassifikation, ekstraktion, routing, opsummering og subagent-opgaver, og leverer et kontekstvindue på 1 million tokens, op til 128K outputtokens og adaptiv tænkning med justerbare indsatsniveauer.
I gennemsnit koster den omkring 75% mindre at drive end Haiku 4.5, samtidig med at den leverer store forbedringer på agent- og computerbrugs-benchmarks. Udviklere kan få adgang til den via den officielle Claude API (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry eller omkostningsoptimerede gateways som CometAPI (fra $0.08 / $0.40).
Vigtigste pointer
Udgivelse og positionering: Lancering 7. oktober 2026 som den lille, høj-throughput model i Claude 5.5-familien—ideel til realtidssupport, dokumentbehandling og delegerede agenttrin.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Kernespecifikationer: 1M-token kontekst, 128K maks. output (300K via Batch API beta), adaptiv tænkning (standard medium indsats), tekst + billedinput → tekstoutput, vidensafskæring juni 2026.
Prisfordel: $0.10 input / $0.50 output pr. million tokens for prompts op til 100K (≈90% billigere end Haiku 4.5 på de fleste forespørgsler); højere takst over 100K. Cache-læsninger helt ned til $0.01. CometAPI tilbyder ≈20% lavere Standard-satser.
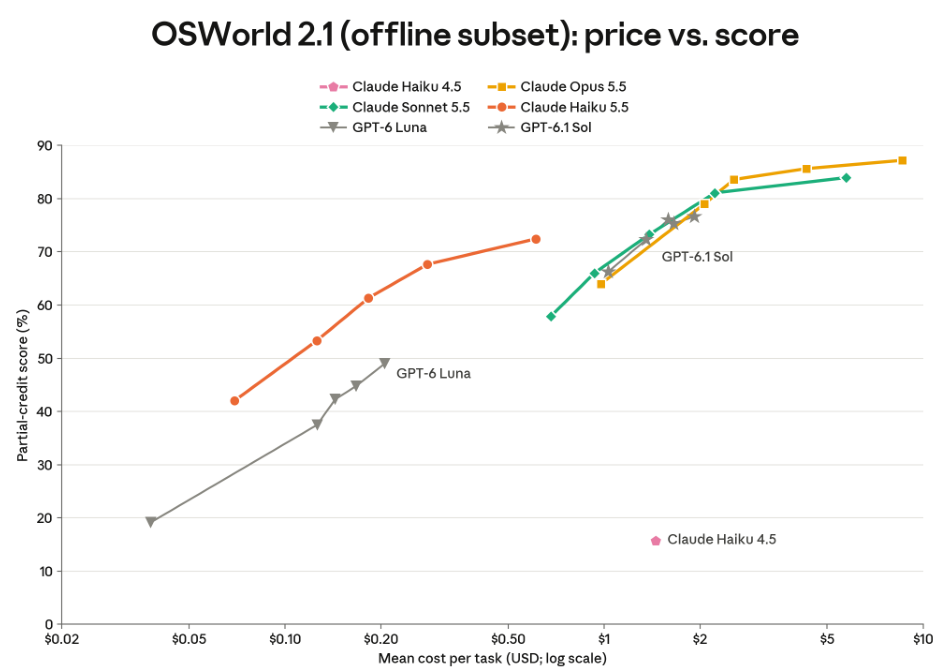
Ydelsesspring: Store gevinster vs. Haiku 4.5 (f.eks. OSWorld 72.4% vs. 15.7%, Terminal-Bench 39.2% vs. 0%, GDPval-AA 1620 vs. 735 Elo) og samtidig konkurrencedygtig med eller foran GPT-6 Luna på mange tests.
Funktioner for udviklere: Effort-parameter (low–max), prompt-caching, Batch API (50% rabat), computer-/browserbrug (beta SDK-understøttelse). Temperature/top_p/top_k skal udelades, ellers opstår en 400-fejl.
Hvad er Claude Haiku 5.5, og hvorfor det er vigtigt i 2026
Claude Haiku 5.5 er Anthropics nyeste model i den letvægtskategori af Claude-familien. I modsætning til de dyrere Opus 5.5 og Sonnet 5.5, der er optimeret til kompleks ræsonnering og langhorisont-agenter, er Haiku 5.5 formålsbygget til høj volumen, omkostningsfølsomme og latenskritiske workloads. Anthropic beskriver den som “den billigste, hurtigste og mest kapable lille model, vi nogensinde har udgivet.”
Typiske produktionsbrugstilfælde omfatter:
Ticket-klassifikation og routing i kundesupport
Feltudtræk og opsummering fra lange dokumenter
Komprimering af samtalehistorik til større modeller
Database-agtige forespørgsler og strukturerede dataopgaver
Hurtige subagenter, der håndterer snæver kodning, værktøjsbrug eller browsertrin, mens en stærkere model orkestrerer
Fordi den er dramatisk billigere og hurtigere end sin forgænger og samtidig lukker en stor del af kvalitetsgabet på praktiske agentopgaver, omstrukturerer mange teams deres pipelines, så Haiku 5.5 håndterer størstedelen af forespørgslerne og kun eskalerer svære sager til Sonnet eller Opus. Tidlige kundefeedback fra Asana, HubSpot, Box og andre fremhæver 30%+ latensreduktioner og målbare præcisionsløft på højvolumen interne evals.
Det større kontekst- og outputloft kombineret med adaptiv tænkning gør Haiku 5.5 langt mere anvendelig i reelle produktionssystemer end tidligere små modeller, der krævede aggressiv trunkering eller faste tænkningsbudgetter.
Svar og færdiggørelseskontrol
Læs indholdsblokke efter type i stedet for at antage, at content[0] er det synlige svar. Inspicer stop_reason, før output accepteres: max_tokens indikerer en afbrudt generering, og afvisning kræver en eksplicit applikationsrespons. For værktøjsaktiverede forespørgsler skal du behandle tool-use-blokke og returnere værktøjsresultater i deres native format i stedet for at behandle dem som en færdig tekstbesvarelse.
Hvad er ændret sammenlignet med Claude Haiku 4.5 API?
Kapacitets-, adfærds- og prisændringer
Dimension
Haiku 4.5
Haiku 5.5
Sonnet 5.5
Kontekstvindue
200K
1M
1M
Maksimalt output
64K
128K
128K
Adaptiv indsats
Nej
Ja
Ja
Anthropic input / MTok
$1.00
$0.10
$2.00
Anthropic output / MTok
$5.00
$0.50
$10.00
Positionering
Ældre hurtig model
Rutinearbejde i skala
Sværere komplekse opgaver
Haiku 5.5-priserne i denne sammenligning gælder for prompts op til 100.000 tokens; større prompts koster mere. Dette er Anthropics Standard-satser, ikke CometAPI-satser. Sammenligningen er et routing-udgangspunkt og ikke en påstand om, at modellerne præsterer identisk.
For Haiku 4.5-integrationer er de vigtigste implementeringsændringer adaptiv tænkning i stedet for et manuelt budget, indsatskontroller, selektiv parsing af indholdsblokke og opdaterede tokenantal. Den samme tekst kan bruge cirka 30% flere inputtokens. Genoptæl repræsentative prompts i stedet for at genbruge Haiku 4.5-tokenestimater. Migrationsafsnittet omsætter disse ændringer til en deploymentsjekliste.
Rapporterede benchmarkforbedringer
Benchmark
Haiku 4.5
Haiku 5.5
Sonnet 5.5
OSWorld 2.1 (offline-subset; delvis kredit)
15.7%
72.4%
83.9%
Terminal-Bench 4.0
0.0%
39.2%
70.6%
Humanity’s Last Exam (uden værktøjer)
10.2%
45.9%
56.9%
Chartography (uden værktøjer)
6.4%
46.4%
61.6%
GDPval-AA v2.1 (Elo)
735
1,620
1,840
Anthropic rapporterer ovenstående scorer i sin lancerings-benchmarkoversigt. De er rapporterede evalueringsresultater, ikke live-tests af CometAPI-eksemplerne i denne guide. OSWorlds 72.4% er delvis kredit, ikke en streng opgavefuldførelsesrate.
Haiku 5.5-systemkortet beskriver evalueringsbetingelserne. Standard Haiku 5.5-evalueringer bruger adaptiv tænkning ved max-indsats og standard sampling, medmindre andet er angivet; produktets standard er medium. OSWorld bruger 82 offlineopgaver, ingen internetadgang, 1080p-opløsning og en 500-handlingsgrænse. Terminal-Bench 4.0 bruger Claude Code i bare mode, ingen internet-egress og 10 forsøg pr. opgave for Haiku 5.5; Sonnet-opsætningen er anderledes. HLE- og Chartography-rækkerne ovenfor er uden værktøjer. GDPval-AA rapporterer en Elo-rating fra Artificial Analysis-evalueringer. Match det relevante harness, indsats- og værktøjsindstillinger, når du sammenligner resultater.
Anthropics originale OSWorld-grafik viser forholdet mellem indsats, omkostning pr. opgave og delvis-kredit-score. Den måler ikke API-latens og garanterer ikke samme ydeevne på din workload.
Scorerne indikerer langt stærkere computerbrug og generel opgaveperformance end Haiku 4.5, men de garanterer ikke samme resultater i din applikation. Kør et repræsentativt evalueringssæt, før du forpligter produktionstrafik.
Benchmarktabellen og den medfølgende grafik er bevaret som model-sammenligninger. De er rapporterede evalueringer snarere end live-tests af CometAPI-eksempler. Brug den samme opgavefordeling, indsats- og værktøjsindstillinger, når du evaluerer en applikation; en benchmarkscore etablerer ikke gateway-latens eller din egen succesrate.
Sådan bruger du Claude Haiku 5.5 API via CometAPI
Opret en nøgle og vælg den native rute
Opret en CometAPI-konto, bekræft adgang til claude-haiku-5-5 og generér en server-side API-nøgle. Sæt COMETAPI_KEY i dit miljø. Hold nøglen uden for kildekontrol og browserkode. Anthropic- og CometAPI-nøgler tilhører forskellige udbydere; brug CometAPI-nøglen til hvert eksempel i denne reviderede guide.
CometAPI understøtter Claudes native Messages- og content-block-format. Brug Anthropic SDK’et med CometAPI’s root base-URL. Native Messages er den foretrukne rute i denne guide til Claude-specifik tænkning og indholdsblokke. Den kompatible Chat Completions-rute er en mulighed for en eksisterende OpenAI-stil-applikation. Bekræft understøttelse af avancerede felter på den præcise gatewayrute.
Send en minimal forespørgsel og verificér resultatet
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Klassificér denne ticket: Jeg kan ikke logge ind."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Gem Python-eksemplet som example.py og kør python example.py. Et vellykket checkpoint er en fuldført respons med synlig tekst og usage-felter. En autentificeringsfejl betyder, at nøglen skal tjekkes; en model-/rute-fejl betyder, at model-ID, endpoint eller kontoadgang skal tjekkes.
Brug det samme native format fra JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Udtræk produkt, antal og pris: 3 bærbare til $900 stykket."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Brug en understøttet Node.js-version. Gem filen som example.mjs, sæt COMETAPI_KEY og kør node example.mjs. Registrér den SDK-version, du validerer til deployment.
Tilpas en eksisterende OpenAI-kompatibel applikation
Hvis din applikation allerede bruger Chat Completions, så installer openai-pakken og konfigurer den separate klient nedenfor. Denne rute returnerer choices i stedet for native indholdsblokke. Hold rutespecifik parsing adskilt, og test tænkning, billeder og værktøjer, før du stoler på gatewayoversættelse.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Vær kortfattet og hjælpsom."},
        {"role": "user", "content": "Forklar API rate limits."},
    ],
)
print(response.choices[0].message.content)
Afsendelse af billeder til Claude Haiku 5.5 API
Brug et billede sammen med en instruktion, der angiver den evidens og det output, du har brug for. Den officielle vision-grænseflade accepterer billedindholdsblokke med base64-data, en billed-URL eller en understøttet uploadet filreference. Dette eksempel læser en lokal PNG, placerer billedet før spørgsmålet og beder om værdier, der kan kontrolleres mod kilden.
Analysér en reel lokal PNG via den native Anthropic Messages API.
import os
import base64
from pathlib import Path
import anthropic

# Erstat dashboard.png med en reel PNG-fil, du er autoriseret til at analysere.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Læs de synlige dashboard-metrics. List anomalier med deres "
                "labels og værdier, og angiv når tekst er ulæselig."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Brug den MIME-type, der matcher den faktiske fil. Tjek læsbarhed, billeddimensioner og grænser for forespørgselsstørrelse før submission; undgå at sende højopløselige medier, som ikke hjælper opgaven. For CometAPI skal du ændre nøglen og root base-URL som vist i Messages-eksemplet, og verificere billedunderstøttelse på den præcise rute.
Kontrol af Claude Haiku 5.5-ræsonnering
Haiku 5.5 bruger adaptiv tænkning som standard. Den officielle tænkningskonfiguration forklarer, hvornår disabled accepteres, og hvordan tænkningsblokke returneres. Sæt indsats via output_config.effort; genbrug ikke det gamle budget_tokens.
Indsats
Godt udgangspunkt
Tradeoff
low
Kort klassifikation, simpel udtræk
Typisk lavere tokenforbrug og latens
medium
Supportbesvarelser, rutine agentarbejde
Balanceret standard
high
Multitrins dokumentanalyse
Potentielt mere ræsonnering
xhigh
Svære evalueringer
Mere behandling og omkostning
max
Ræsonneringsintensive sager
Højest mulig ræsonneringsindsats
Konfigurer adaptiv tænkning med lav indsats.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Klassificér som billing, technical eller account: kan ikke logge ind."}],)for block in response.content: if block.type == "text": print(block.text)
Udviklere kan deaktivere tænkning ved low, medium og high indsats, men ikke ved xhigh eller max. Tænkning forbruger fakturerede outputtokens og max_tokens-budgettet, selv når dens tekst er skjult. Et tomt tænkningsfelt kan stadig bære en signatur; det beviser ikke, at der ikke forekom ræsonnering. Hold returnerede indholdsblokke uændrede, når du fortsætter værktøjssamtaler.
Eksempel på forespørgsel med tænkning deaktiveret
Send en native request-body med tænkning deaktiveret.
Streaming leverer synlig tekst inkrementelt og forbedrer responsiviteten i interaktive applikationer. Behandl streamet tekst som foreløbig, indtil forespørgslen fuldføres med succes.
Stream synlig tekst med Anthropic Python SDK.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Forklar API-caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Claude Haiku 5.5 API-priser
Sammenlign tokenrater og promptlængde-bånd
Rater tjekket 8. oktober 2026. Tabellen sammenligner Anthropic Standard-priser med offentliggjorte CometAPI-rater, i USD pr. million tokens. Båndet bestemmes af promptlængde: op til 100.000 tokens versus mere end 100.000. Længere forespørgsler bruger de gældende højere båndrater og ikke blot et tillæg på overskydende tokens. Kontoafregning, cachet brug og valgfrie værktøjer skal afstemmes separat.
Tokencategory
Anthropic ≤100K
CometAPI ≤100K
Anthropic >100K
CometAPI >100K
Input
$0.10
$0.08
$0.50
$0.40
Output
$0.50
$0.40
$2.50
$2.00
Cache read
$0.01
$0.008
$0.05
$0.04
5-min cache write
$0.125
$0.10
$0.625
$0.50
1-hour cache write
$0.20
$0.16
$1.00
$0.80
Den oprindelige artikels tasasnapshot er bevaret ovenfor. Tjek den aktuelle CometAPI-liste og kontofakturering før køb eller deployment; listingens startinputrate er ikke et fuldstændigt tilbud for hvert promptlængde-bånd, cacheoperation eller valgfrit værktøj.
Eksempel: Omkostning for 100.000 supportforespørgsler
Antag 100.000 månedlige forespørgsler, hver med 2.000 inputtokens og 300 fakturerede outputtokens, inklusive eventuel genereret tænkning. Hver prompt kvalificerer sig til op-til-100K-båndet. Udelad caching, værktøjsomkostninger og retries.
Komponent
Forbrug
Anthropic
CometAPI
Input
200M tokens
$20.00
$16.00
Output
30M tokens
$15.00
$12.00
Total
100,000 foresp.
$35.00
$28.00
Under disse antagelser er den illustrative forskel $7 pr. måned, eller 20%. Produktionsomkostninger afhænger af forespørgselslængder, skjult tænkning, caching og retry-adfærd.
Brug modellens aktuelle tokenantal i beregningen. Omkostning = inputtokens × gældende inputrate / 1,000,000 + fakturerede outputtokens × gældende outputrate / 1,000,000, plus separat gældende cache-, værktøjs- og retry-omkostninger. Tænkningstokener er en del af faktureret output.
Reducér omkostninger uden at miste kvalitet på accepterede opgaver
Optimering
Handling
Fordel
Indsats-tuning
Brug low hvor kvaliteten tillader
Lavere ræsonneringsoverhead
Promptreduktion
Fjern redundant samtalehistorik
Færre inputtokens
Prompt-caching
Hold genbrugt kontekst stabil
Lavere gentagen inputomkostning
Streaming
Render tokens, efterhånden som de ankommer
Bedre oplevet responsivitet
Skemavalidering
Afvis fejlformede records tidligt
Mindre efterfølgende rework
Modelrouting
Eskalér komplekse opgaver
Bedre omkostnings-/kvalitetsbalance
Batch-behandling
Batch egnede offline-forespørgsler
Potentielle ekstra besparelser
Vælg ikke automatisk den laveste indsats. Et billigere enkeltkald kan øge de samlede omkostninger, hvis det medfører flere retries. Evaluer nøjagtighed, p50/p95-latens, tokenforbrug og omkostning pr. succesfuld opgave.
For prompt-caching skal du genbruge et stabilt prefix og inspicere cacheoprettelse og cache-læseforbrug i stedet for at antage et hit. Haiku 5.5 har en minimum cachebar prompt på 512 tokens på den dokumenterede Claude API. Ændring af indsats kan ugyldiggøre cachede prefixer; hold indstillinger stabile inden for en samtale. Et 1M kontekstvindue er en kapacitetsgrænse, ikke en anbefaling om at sende hvert dokument i hver tur.
Hold et stabilt genbrugeligt prefix til caching, forkort unødvendige inputs og benchmark ændringer i indsats. Streaming forbedrer oplevet responsivitet frem for automatisk at reducere faktureret forbrug. Sammenlign omkostning pr. accepteret opgave på tværs af hele workflowet, inkl. retries og værktøjskald.
Claude Haiku 4.5 til Haiku 5.5 migrationsguide
Opdater integrationen og request-formatet
Område
Migrationshandling
Model-ID
Erstat med claude-haiku-5-5
Tænkning
Erstat manuelt budget_tokens med adaptiv tænkning
Indsats
Brug output_config.effort efter behov
Sampling
Udelad temperature, top_p og top_k; enhver top_k-værdi er ikke støttet
Responsparser
Håndtér flere indholdsbloktyper
Outputbudget
Giv tilstrækkelig plads til ræsonnering og endeligt output
Prefill
Fjern ikke-understøttet assistant-prefilling
Caching
Retest prompts ved ændring af indsats
Værktøjsintegrationer
Verificér understøttede værktøjsversioner
For CometAPI-ruten, der bruges her, behold COMETAPI_KEY og den native base-URL, mens du ændrer model-ID og request-konfiguration. Erstat legacy enabled thinking med et budget ved adaptiv tænkning og indsats. Fjern assistant-prefilling og udelad samplingparametre. Bevar sondringen mellem Claudes native content-array og den kompatible routes choices-respons.
Bevar tilstand og genberegn budgetter
Den officielle Haiku 5.5-migrationsguide rapporterer cirka 30% flere inputtokens for identisk tekst end Haiku 4.5. Genoptæl repræsentative prompts og retun max_tokens, latensgrænser og estimerede forespørgselsomkostninger, før du flytter trafik. Returnerede tænkningsblokke fungerer kun i den konto, der producerede dem, eller en linket konto; et kontoskifte kan lydløst droppe disse blokke. Bevar et append-only samtaleprefix i stedet for at ændre tidligere beskeder efter generering. Inspicér stop_reason, inkl. max_tokens og refusal, og håndtér dem eksplicit, før output accepteres.
Genoptæl repræsentative prompts med målmodellen og retun max_tokens, latensgrænser og omkostningsestimater. Test gemte samtaler mod den konto og gatewayrute, der vil afspille dem; antag ikke, at signerede tænkningsblokke er bærbare på tværs af uvedkommende konti eller omskrevne samtaleprefixer.
Konklusion
Claude Haiku 5.5 repræsenterer et reelt inflektionspunkt for omkostningseffektiv, høj-throughput AI. Ved at levere dramatisk bedre agent- og computerbrugsperformance til omtrent en tiendedel af den tidligere Haiku-pris på størstedelen af forespørgsler har Anthropic gjort storskala udrulning af kapable små modeller praktisk. Uanset om du kalder den officielle API, kører via Amazon Bedrock eller bruger en samlet gateway som CometAPI for yderligere besparelser og operationel enkelhed, åbner kombinationen af hastighed, kapabilitet og pris nye produktmuligheder, der tidligere var uøkonomiske.