
Den hurtigste måde at bruge GLM-5.3 Flash API på er at kalde modellen via CometAPI's OpenAI-kompatible chat-completions-endpoint. Forbindelsesdetaljerne er samlet i API-specifikationstabellen nedenfor; behold API-nøglen på serveren.
Svar først: opret en CometAPI-nøgle, installer et OpenAI-kompatibelt SDK, send en POST-anmodning til /v1/chat/completions, og tilføj derefter streaming, vision, JSON-output eller værktøjer først efter, at den grundlæggende anmodning lykkes.
Hvad er GLM-5.3 Flash API?
GLM-5.3 Flash er Z.ai’s effektivitetsfokuserede, native multimodale model i GLM-5-familien. Den eksponerer ræsonnering, lang kontekst, visuel forståelse og agentorienterede funktioner via et chat-API. Modellen indeholder 320B samlede parametre men aktiverer 18B per token; den arkitektur er vigtig for omkostninger, men udviklere oplever primært resultatet som en model, der kan forblive aktiv på tværs af lange prompts og gentagne værktøjskald.
Denne guide holder bevidst arkitektur- og benchmarkdækning kort. Den ledsagende modeloversigt forklarer allerede hybrid attention-designet, åbne vægte, komplet lancerings-benchmarkmatrix, prisbaggrund og sammenligning i modelserien. Her er fokus integrationsadfærd og produktionsbeslutninger.
API-specifikationer, der påvirker integrationen
| API-specifikation | Værdi | Praktisk betydning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Konfigurer dette én gang i klienten på serversiden. |
| Endpoint | POST /v1/chat/completions | Brug den OpenAI-kompatible chat-completions-rute. |
| Kompatible SDK’er | OpenAI-kompatible Python- og JavaScript-klienter | Genbrug velkendte klientmønstre med CometAPI-base-URL. |
| Godkendelse | Bearer API-nøgle | Behold nøglen i en server-side miljøvariabel eller en secret manager. |
| Modelkode | glm-5.3-flash | Brug denne eksakte værdi i request-body. |
| Kontekstvindue | 1.048.576 tokens | Velegnet til store repositories, dokumentpakker og lange agenthistorikker. |
| Maksimalt output | Op til 131.072 tokens | Sæt en lavere, applikationsspecifik grænse for at styre omkostninger og latenstid. |
| Native input | Tekst, billede, video, fil | Support på hostede ruter kan variere; valider den præcise CometAPI-rute før afhængighed af alle modaliteter. |
| Output | Tekst | Modellen fortolker medier men returnerer ikke direkte genererede billeder eller video. |
| Ræsonnering | low, high, max | Brug indsatsniveauer for at bytte latenstid og tokenforbrug for dybde. |
| Tænkning | Altid aktiveret | Send ikke en parameter, der forsøger at deaktivere tænkning. |
| Udviklerfunktioner | Streaming, funktionskald, caching, struktureret output | Nyttigt til interaktive apps, agenter og maskinlæsbare pipelines. |
Modellens kapabilitet og gatewayens kapabilitet er ikke identiske. Behandl den live CometAPI-modelside og API-skemaet som kontrakten for ruten, du faktisk kalder, især for video, filer, streng JSON Schema og udbyderspecifikke tænkningsfelter.
Kort performancekontekst
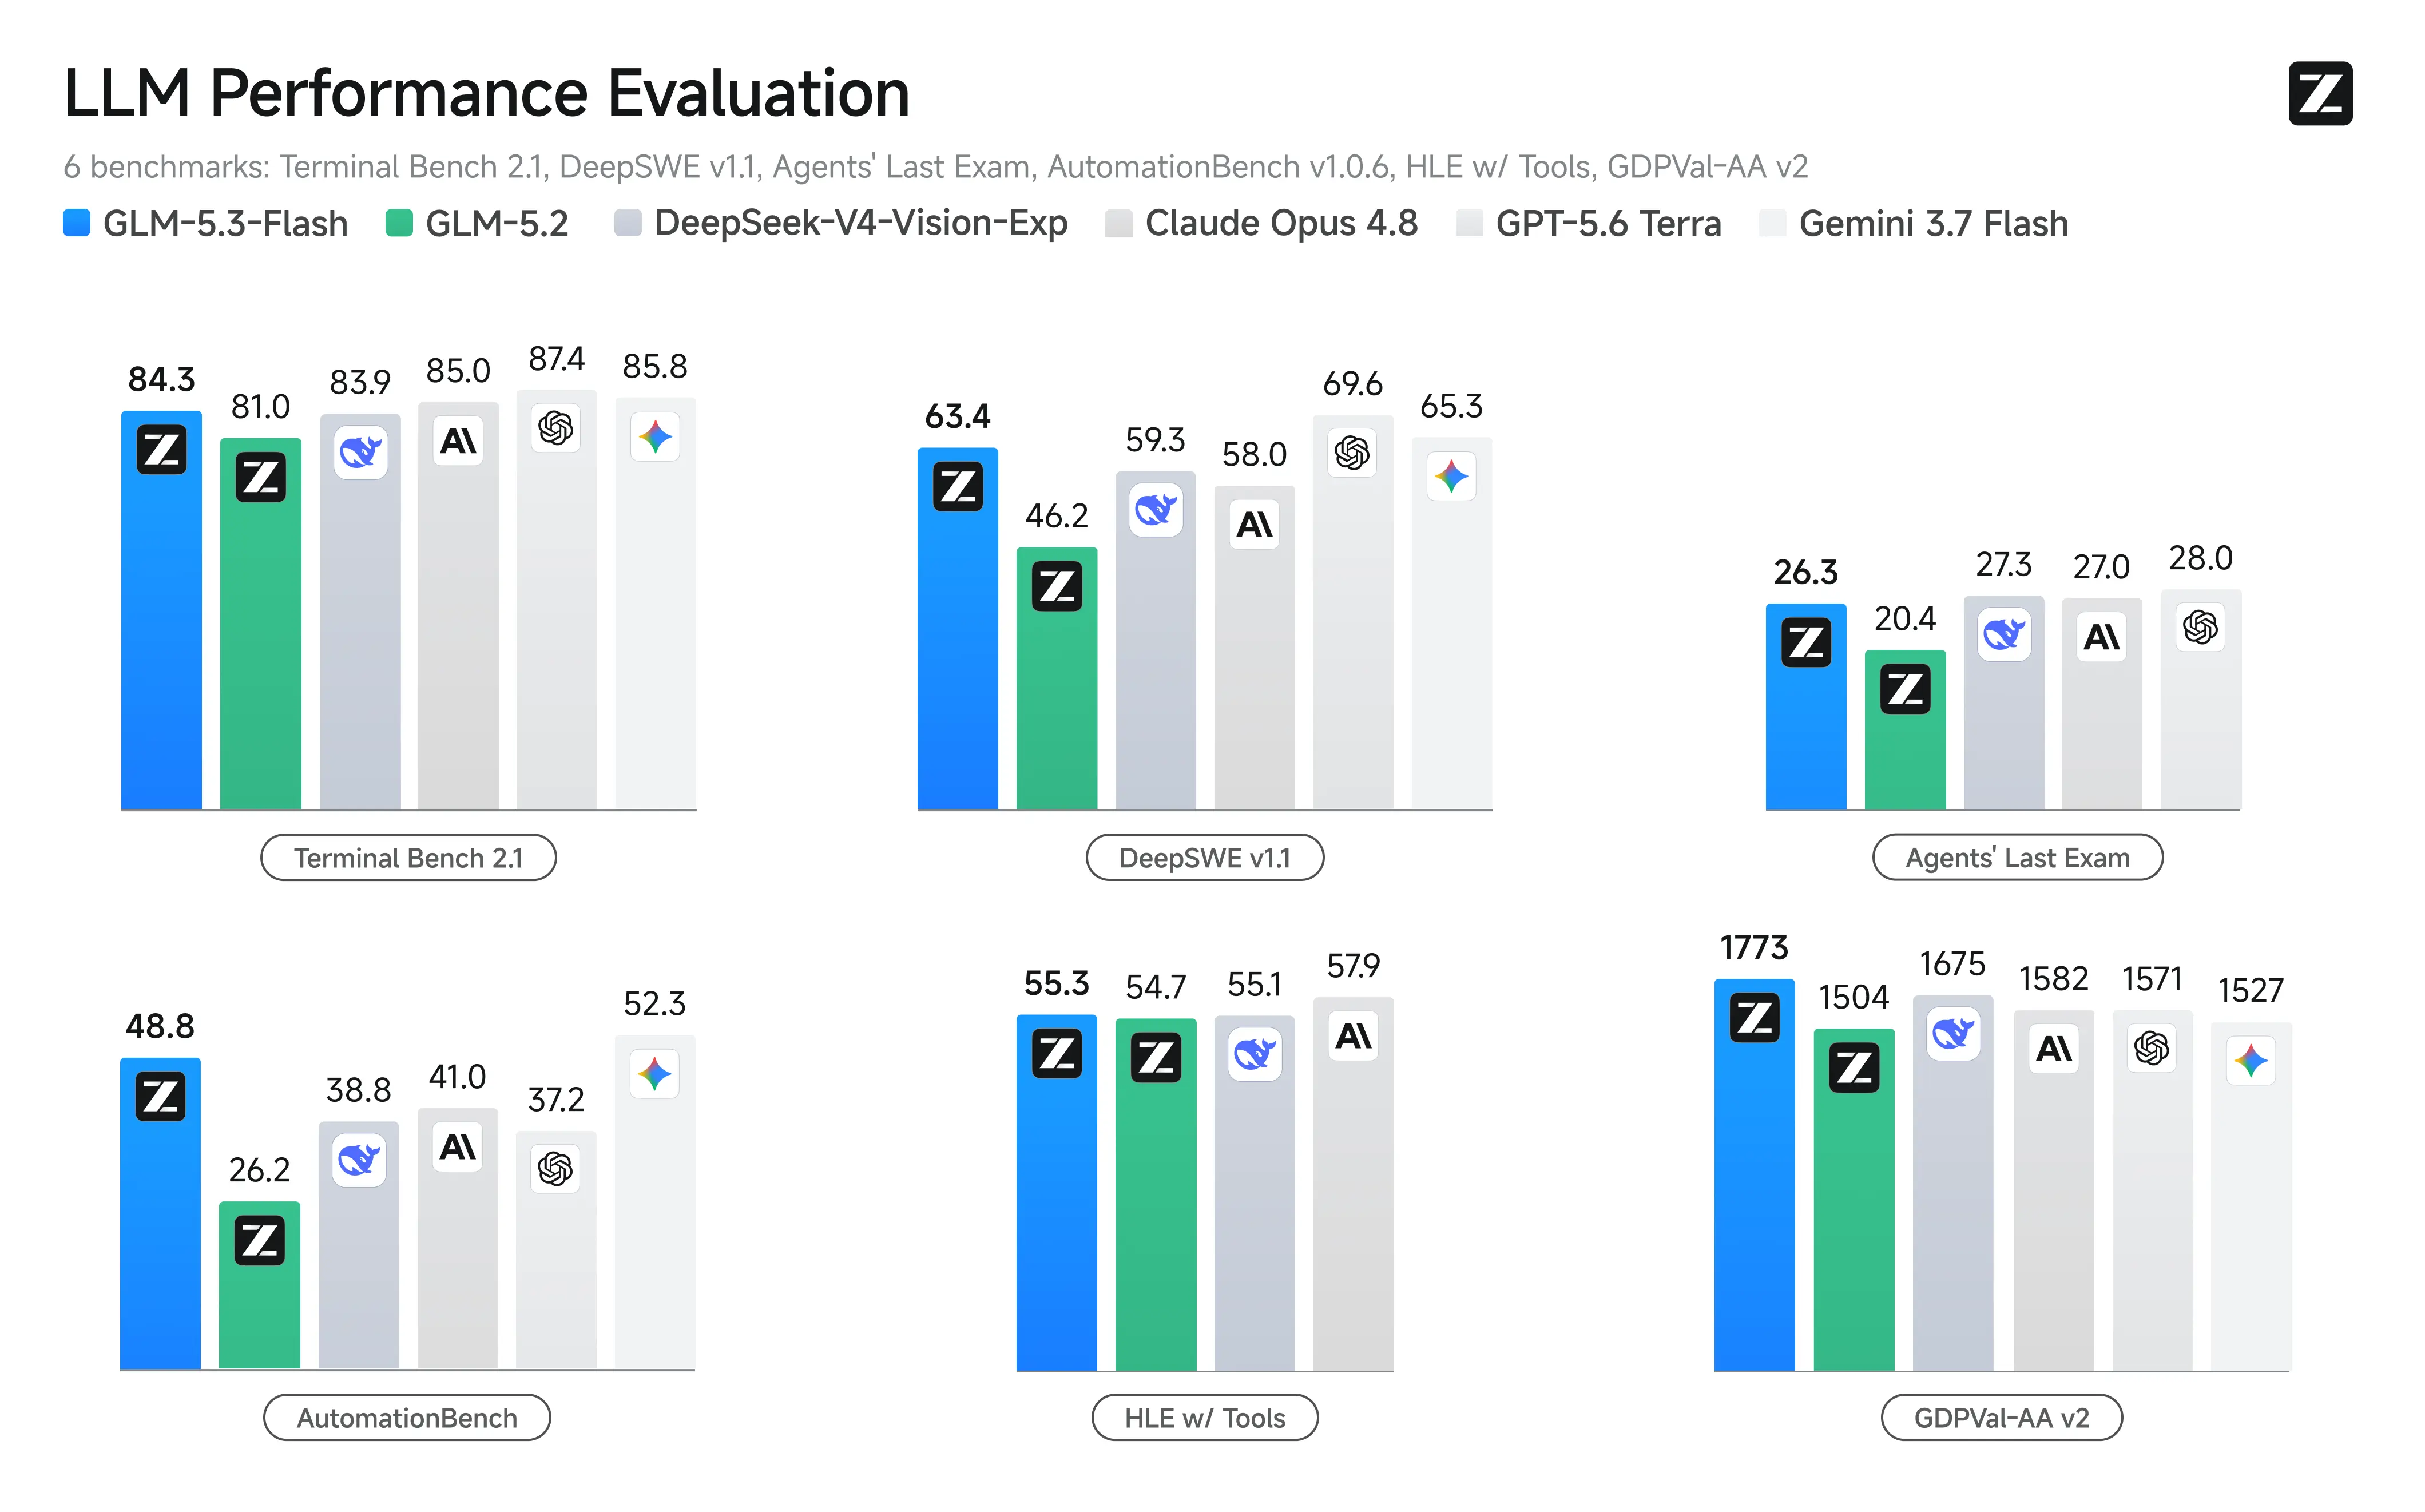
Z.ai rapporterer stærke lanceringsresultater på opgaver, der er vigtige for API-byggere: terminalarbejde, software engineering, værktøjsbrug og automatisering. Dette er leverandør-rapporterede scores opnået med specifikke harnesses og værktøjspolitikker, så de hjælper med at identificere sandsynlige styrker frem for at etablere en universel rangering.
| Benchmark | GLM-5.3 Flash | Hvad det antyder for API-arbejdsbelastninger |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Godt match til terminaldrevne coding-agenter. |
| DeepSWE v1.1 | 63.4 | Lovende repository-skala software engineering. |
| Toolathlon Verified | 78.4 | Stærkt signal for værktøjsvalg og -brug. |
| AutomationBench | 48.8 | Forbedret flertrins-automatisering vs. forgænger. |
Den praktiske implikation er smallere end benchmarktabellen: GLM-5.3 Flash er en stærk kandidat, når arbejdsflowet kombinerer lang kontekst med værktøjer eller visuel feedback. For en komplet modelsammenligning, brug den eksisterende modeloversigt i stedet for at duplikere den her.
Kilde: Z.ai official benchmark graphic
Den officielle benchmark-grafik sammenligner GLM-5.3 Flashs performance på tværs af model- og indsatsindstillinger. For denne API-guide giver den kort performancekontekst i stedet for at gentage den komplette lanceringsmatrix. Applikationer bør stadig måle opgavesucces, end-to-end-latenstid og samlet tokenforbrug på deres egne prompts.
Hvorfor bruge GLM-5.3 Flash via CometAPI?
CometAPI eksponerer GLM-5.3 Flash gennem et OpenAI-kompatibelt interface. Det gør det muligt for et team at genbruge velkendte SDK-mønstre, centralisere legitimationsoplysninger og fakturering og skifte modeller uden at skulle bygge hele lagret for anmodninger om.
• Én integrationsmodel. Den samme baseklient kan kalde forskellige understøttede modeller ved at ændre model-ID.
• Centraliseret synlighed af forbrug. Teams kan gennemgå forbrug og omkostninger uden at vedligeholde et separat dashboard for hver udbyder.
• Hurtigere evaluering. Et enkelt request-harness kan sammenligne svarkvalitet, latenstid og fejl på tværs af kandidatmodeller.
• Simpler fallback-design. Applikationer kan holde retry- og routinglogik i ét gatewaylag.
• Lavere opført rutepris. Den nuværende modelside angiver $0.06 per million input-tokens og $0.20 per million output-tokens; bekræft den live side før budgettering.
Før du begynder
Du har brug for en CometAPI-konto, en API-nøgle og et af følgende lokale miljøer:
• Python 3.9 eller nyere med pip
• Node.js 18 eller nyere med npm
• cURL til en minimal kommandolinjetest
Placer aldrig en produktions-CometAPI-nøgle i browser-JavaScript, en mobilapp, et offentligt repository, et screenshot eller klient-side logs. Kald CometAPI fra en betroet server og opbevar nøglen i en miljøvariabel eller en secret manager.
Sådan bruger du GLM-5.3 Flash API med CometAPI
Trin 1: Opret en CometAPI API-nøgle
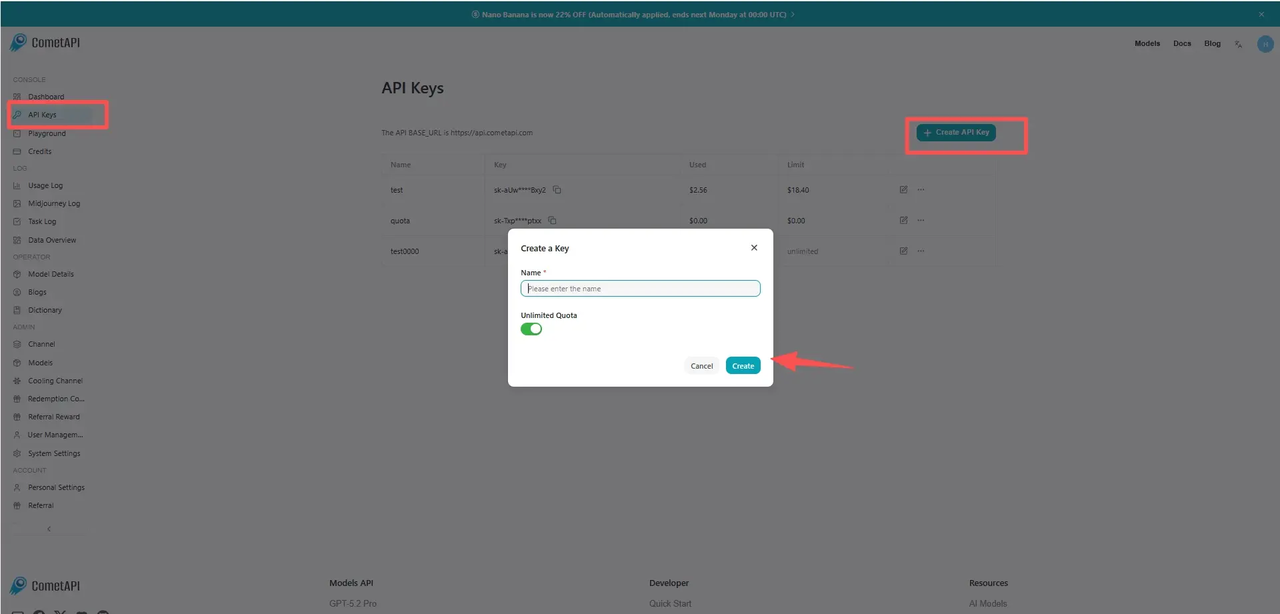
Log ind på CometAPI, åbn API-nøglekonsollen, opret en nøgle, og kopier den én gang ind i dit secret management-workflow. Brug en separat nøgle til udvikling og produktion, så du kan rotere eller tilbagekalde ét miljø uden at afbryde det andet.
Kilde: CometAPI official API key guide image
Trin 2: Gem nøglen som en miljøvariabel
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
I produktion bør du erstatte shell-historik med en deploymentshemmelighed, containerhemmelighed eller en managed vault.

### Trin 3: Installer et OpenAI-kompatibelt SDK
python -m pip install --upgrade openai
npm install openai
```

### Trin 4: Lav den første anmodning med cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Et vellykket svar indeholder en assistant-besked under choices[0].message.content plus usage-metadata, når ruten returnerer det. Start med denne lille anmodning, før du tilføjer valgfrie parametre.

### Trin 5: Kald API'et fra Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Trin 6: Kald API'et fra JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Sådan styrer du ræsonneringsindsats

Den officielle modeldokumentation understøtter low, high og max ræsonneringsindsats. Tænkning forbliver aktiveret; indsatsindstillingen ændrer, hvor meget ræsonneringsbudget modellen kan bruge.

| Indsats | Gode start-arbejdsopgaver                         | Trade-off                                              |
| ------- | -------------------------------------------------- | ------------------------------------------------------ |
| low     | Klassifikation, omskrivning, kort ekstraktion      | Lavere latenstid og output-tokenforbrug; mindre dybde. |
| high    | Kodereview, planlægning, dokumentanalyse           | Afbalanceret standard til mange produktionstasks.      |
| max     | Kompleks debugging, værktøjsagenter, svær ræsonnering | Størst dybde; potentielt større latenstid og omkostning.|

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Hvis det installerede SDK eksponerer reasoning_effort som et førsteklasses argument, kan du sende det direkte. Hvis CometAPI-ruten afviser et udbyderspecifikt felt, skal du fjerne det og bruge rutens standard. Forsøg ikke at deaktivere tænkning.

## Sådan streamer du svar

Streaming er nyttigt til chat, coding-assistenter og lang analyse, fordi det lader interfacet vise output, efterhånden som det ankommer. Det reducerer ikke det samlede antal genererede tokens, så behold de samme outputgrænser og omkostningskontroller.

### Python-streaming

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript-streaming

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Håndter annullering. Stop med at læse streamen, når klienten afbryder forbindelsen, og annuller upstream-arbejde, når det understøttes.

• Buffer sikkert. Antag ikke, at hver chunk indeholder et helt ord, en JSON-token eller et værktøjskaldsobjekt.

• Registrer endeligt forbrug. Forbrug kan kun fremgå i den sidste hændelse eller rutespecifik metadata.

## Sådan sender du billeder

GLM-5.3 Flash accepterer visuelt indhold via image_url-blokke i messages[].content[]. Den officielle dokumentation anbefaler en tilgængelig billed-URL eller en Base64 Data URL. CometAPI's modelside identificerer image-to-text-kapabilitet, men applikationer bør stadig teste formater, filstørrelse og rutens adfærd før produktion.

### Analyser en billed-URL

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Send et lokalt billede som Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Beskær irrelevant whitespace før du encoder et billede.

• Nedskalér billeder, der er meget større end den information, der inspiceres.

• Stil et specifikt visuelt spørgsmål i stedet for at bede om en generel beskrivelse.

• Antag ikke, at en offentlig webside-URL er en direkte billed-URL.

• Test rækkefølgen for flere billeder, da hvert billede bør refereres tydeligt i prompten.

## Sådan anmoder du om struktureret JSON

Struktureret output er værdifuldt, når den næste komponent er kode frem for en menneskelig læser. Brug et snævert skema, valider resultatet, og behold en fallback for ruter, der ikke eksponerer streng JSON Schema i præcis samme form.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON-tilstand fjerner ikke behovet for validering. Tjek krævede felter, typer, tilladte værdier og maksimumlængder, før du lagrer resultatet eller udløser et andet system.

## Sådan bruger du funktionskald

Funktionskald lader modellen beslutte, hvornår den har brug for eksterne data, mens applikationskoden forbliver ansvarlig for godkendelse og eksekvering. Det sikre mønster er: modellen foreslår et værktøjskald, serveren validerer det, serveren eksekverer værktøjet, og modellen modtager resultatet.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Valider argumenter. Behandl JSON fra værktøjskald som utroværdig input.

• Håndhæv autorisation. Modellen afgør ikke, hvad den nuværende bruger må gøre.

• Adskil læse- og skriveværktøjer. Kræv bekræftelse for destruktive eller eksternt synlige handlinger.

• Begræns værktøjsinventaret. Eksponér kun værktøjer relevante for det aktuelle workflow.

• Sæt loft på løkken. Sæt maksimum for værktøjsrunder, samlede tokens, forløbet tid og omkostning.

## GLM-5.3 Flash API-parametre

| Parameter               | Formål                             | Praktisk vejledning                                         |
| ----------------------- | ---------------------------------- | ------------------------------------------------------------ |
| model                   | Vælger modelruten                  | Brug glm-5.3-flash.                                          |
| messages                | Samtale og multimodalt input       | Behold gyldig rolleorden; bevar påkrævede værktøjsbeskeder.  |
| max_completion_tokens   | Begrænser genereret output         | Sæt pr. workflow i stedet for at stole på modelmaksimum.     |
| temperature             | Sampling-adfærd                    | Den officielle anbefaling er 1.                              |
| top_p                   | Nucleus sampling                   | Den officielle anbefaling er 0,95.                           |
| reasoning_effort        | Ræsonneringsbudget                 | Brug low, high eller max; rutesupport bør testes.            |
| stream                  | Inkrementelt output                | Brug true til interaktive svar.                              |
| tools                   | Funktionsdefinitioner              | Hold skemaer snævre og valider hvert kald.                   |
| tool_choice             | Styrer værktøjsvalg                | Start med auto, medmindre workflowet kræver et værktøj.      |
| response_format         | Anmoder om maskinlæsbar output     | Valider support og den returnerede JSON.                     |

## Z.ai direkte API vs. CometAPI

Begge ruter kan være passende. Beslutningen handler mest om integrations-ejerskab, modelbredde, fakturering og hvor hurtigt applikationen har brug for udbydernative funktioner.

| Dimension       | Z.ai direkte API                              | CometAPI                                             | Praktisk resultat                                                    |
| --------------- | --------------------------------------------- | ---------------------------------------------------- | -------------------------------------------------------------------- |
| Konto og nøgle  | Z.ai-konto og -nøgle                          | CometAPI-konto og -nøgle                             | Nøgler er ikke udskiftelige.                                         |
| SDK-mønster     | OpenAI-kompatibelt                            | OpenAI-kompatibelt                                   | Meget klientkode kan genbruges.                                      |
| Modeldækning    | Z.ai-modelfamilie                              | Flere udbydere og modelfamilier                      | CometAPI er nyttigt til routing og sammenligning.                    |
| Native features | Tidligst adgang til udbyderspecifik adfærd     | Afhænger af gateway-eksponering og pass-through      | Test avancerede felter på den valgte rute.                           |
| Fakturering     | Udbyderspecifik                                | Centraliseret på tværs af understøttede modeller     | Ensartet fakturering kan forenkle multi-modeldrift.                  |
| Fallback-design | Kræver en anden udbyderintegration             | Kan forblive inden for ét gatewaylag                 | CometAPI kan reducere skiftfriktion.                                 |
| Bedst egnet     | Dybt engagement i Z.ai-native kapabiliteter    | Ensartet adgang, evaluering og produktionsrouting    | Vælg baseret på systemarkitektur, ikke en generisk vinder.           |

Brug det direkte API, når den nyeste udbydernative parameter eller produktfunktion er afgørende. Brug CometAPI, når én klient, samlet fakturering og muligheden for at sammenligne eller erstatte modeller er vigtigere. I produktion skal du køre det samme repræsentative testsæt mod den præcise rute, du planlægger at deploye.

## Omkostningsestimering og token-budgettering

Den nuværende CometAPI-modelside angiver $0.06 per million input-tokens og $0.20 per million output-tokens. Med disse satser er den estimerede anmodningsomkostning:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Arbejdsgang             | Input tokens | Output tokens | Estimeret omkostning |
| ----------------------- | ------------ | ------------- | -------------------- |
| Kort spørgsmål          | 2,000        | 400           | $0.00020             |
| Kodereview              | 50,000       | 4,000         | $0.00380             |
| Stor dokumentanalyse    | 250,000      | 10,000        | $0.01700             |
| Lang agentkørsel        | 800,000      | 30,000        | $0.05400             |

Priser er tidsfølsomme. Bekræft de live input-, cachet-input- og output-satser før publikation eller produktionsbudgettering. Ræsonnering og værktøjsløkker kan øge faktureret output og gentaget input, så estimer komplette workflows i stedet for ét synligt svar.

## GLM-5.3 Flash API bedste praksis til produktion

### Kontrol af omkostning og latenstid

#### Outputbegrænsninger

Benchmark-genereringsindstillinger og produktions-API-grænser er forskellige. Den citerede HLE-evaluering brugte en maksimal genereringslængde på 163.840 tokens, mens nogle evalueringer brugte 64K outputs; ingen af indstillingerne beviser, at hver hostet API-rute kan returnere mere end 100.000 tokens. Sæt grænsen ud fra det live ruteskema og workflowets budget. Brug små grænser til klassifikation og ekstraktion, mellemstore grænser til analyse og større grænser kun til eksplicit langform eller agentopgaver.

Kontekstkontrol

Et kontekstvindue på én million tokens er kapacitet, ikke et mål. Hent relevante filer, fjern duplikerede logs, placer stabile instruktioner nær begyndelsen, og mål, om yderligere kontekst forbedrer opgavesucces.

### Tilstand og pålidelighed

#### Bevar tilstand

Gem komplette assistant-beskeder, der er nødvendige for næste tur, inklusive værktøjskald og rutespecifikke felter, som din applikation har verificeret. Tab af struktureret historik kan bryde en flertrins-værktøjsløkke, selv når den synlige tekst ser komplet ud.

#### Forsøg igen selektivt

• Forsøg igen ved midlertidige 429, 500, 502, 503 og netværkstimeouts med eksponentiel backoff og jitter.

• Forsøg ikke blindt igen ved godkendelsesfejl, ugyldige parametre eller for store anmodninger.

• Vedhæft et applikations-request-ID, så dobbelt arbejde kan genkendes.

• Brug idempotenskontrol omkring eksterne skriveoperationer, selv hvis selve modelanmodningen forsøges igen.

### Sikkerhed og validering

#### Valider maskinlæsbare output

Skemavalidering, tilladte værdier, længdegrænser og domæneregler bør ligge mellem modellen og enhver database, kø eller ekstern API. Et syntaktisk gyldigt JSON-objekt kan stadig være ufuldstændigt eller usikkert.

#### Autoriser værktøjskald

Behandl model-forslåede værktøjskald som utroværdige forespørgsler: valider argumenter, håndhæv brugerautorisation, adskil læse- og skriveoperationer, og kræv bekræftelse for destruktive handlinger.

### Observabilitet og fallback

#### Mål arbejdsgang

• Opgavesucces eller menneskelig accept-rate

• Tid til første token og samlet latenstid

• Input, cachet input, ræsonnering og output tokens

• Antal værktøjskald og værktøjsfejlrate

• Retries, ratelimits og udbyderfejl

• Omkostning per gennemført arbejdsgang i stedet for kun omkostning per API-kald

#### Design fallback

Vælg en fallback efter arbejdsgang, ikke ry. En tekst-only fallback kan være acceptabel til dokumentekstraktion, men fejle en opgave baseret på screenshots. Definér hvilke input og værktøjsskemaer der er portable, hvilke parametre der skal fjernes, og hvornår brugeren skal se en gendannelig fejl i stedet for et automatisk modelskift.

## Almindelige fejl og fejlfinding

| Symptom                 | Sandsynlig årsag                                                    | Hvad du skal tjekke                                                            |
| ----------------------- | ------------------------------------------------------------------- | ------------------------------------------------------------------------------ |
| 401 Unauthorized        | Manglende, forkert formateret eller tilbagekaldt nøgle              | Bekræft Authorization-header og server-side miljøvariabel.                     |
| 404 eller model ikke fundet | Forkert model-ID eller utilgængelig rute                         | Brug glm-5.3-flash og bekræft tilgængelighed på den live modelside.            |
| 429 Rate Limit          | Anmodnings- eller tokengrænse overskredet                           | Back off, reducer samtidighed, inspicér kontogrænser, og forsøg igen med jitter. |
| Unsupported parameter   | Udbydernativt felt ikke eksponeret af gateway                       | Fjern valgfrie felter, og tilføj dem derefter tilbage én ad gangen.            |
| Context length exceeded | Prompt plus anmodet output overskrider rutegrænsen                  | Trim, hent, opsummér eller sænk max_completion_tokens.                         |
| Invalid image           | URL utilgængelig, format ikke understøttet eller Base64 ugyldig     | Test en direkte HTTPS-billed-URL og korrekt MIME-præfiks.                      |
| Broken streamed JSON    | Chunks blev parset som komplette objekter                           | Buffer streamen og parse først efter den komplette JSON-payload er ankommet.   |
| Tool loop never ends    | Intet budget for trin eller tvetydige værktøjsresultater            | Sæt loft for runder, forbedr værktøjsbeskrivelser, og returnér eksplicitte fejl. |

## Hvornår bør du bruge GLM-5.3 Flash API?

### Gode anvendelser

• Repository-skala kodeforståelse og multifil-review

• Visuel kodning, screenshot-analyse og interface-QA

• Lange dokumentpakker og evidensunderstøttet syntese

• Værktøjsbrugende agenter med gentagen planlægning og verifikation

• Højvolumen-workflows, hvor tokenomkostning påvirker enhedsøkonomi

• Applikationer, der drager fordel af at skifte eller sammenligne modeller via én gateway

### Brug en anden rute eller model når

• Produktet har brug for billede- eller videooutput i stedet for tekstoutput.

• Opgaven er en lille, lavrisiko-klassifikation, som en mindre model kan håndtere pålideligt.

• En udbydernativ funktion er obligatorisk, men ikke eksponeret på gatewayruten.

• Workflowet kan ikke tolerere altid-aktiveret tænkning eller den tilknyttede latenstidsprofil.

• Applikationen endnu ikke har testet modellen på egne værktøjer, data og fejlsager.

## Ofte stillede spørgsmål

###

### Hvad skal jeg verificere på den præcise CometAPI-rute før lancering?

Verificér modeltilgængelighed, accepterede multimodale formater, maksimalt output, ræsonneringsfelter, adfærd for struktureret output, ratelimits og aktuelle priser med repræsentative anmodninger.

### Hvilke metrikker bør en produktionsevaluering spore?

Spor opgavesucces, tid til første token, samlet latenstid, input- og outputtokens, værktøjskaldsfejl, retry-rate og omkostning per gennemført arbejdsgang, ikke kun omkostning per API-kald.

### Hvordan bør jeg vælge mellem Z.ai direkte og CometAPI?

Brug Z.ai direkte, når øjeblikkelig adgang til udbydernativ adfærd er essentiel. Brug CometAPI, når samlet godkendelse, fakturering, modelsammenligning og gateway-level fallback er vigtigere.

### Hvad gør en fallback sikker?

En sikker fallback accepterer samme inputmodalitet, bevarer påkrævede værktøjsskemaer, fjerner ikke-understøttede parametre, forbliver inden for opgavens autorisationsgrænser og fejler synligt, når adfærd ikke kan bevares.

## Konklusion

GLM-5.3 Flash er mest nyttig via et API, når lang kontekst, visuelt input, ræsonnering og værktøjsbrug er en del af det samme workflow. Den grundlæggende CometAPI-integration er lille: én server-side nøgle, én OpenAI-kompatibel klient, model-ID’et glm-5.3-flash og chat-completions-endpointet. Produktionskvalitet kommer fra alt omkring den anmodning: afgrænsede prompts, outputgrænser, skemavalidering, værktøjsautorisation, retries, observabilitet og arbejdsflow-specifik evaluering.

Start med et kort tekstkald, tilføj én avanceret kapabilitet ad gangen, og test den komplette brugerrejse før skalering. Bekræft den live GLM-5.3 Flash-modelside for aktuel tilgængelighed, understøttet ruteadfærd og priser.

## SEO-metadata

Meta-titel: How to Use GLM-5.3 Flash API: Developer Guide

Meta-beskrivelse: Lær, hvordan du bruger GLM-5.3 Flash API med CometAPI, inkl. eksempler i Python og JavaScript, vision, streaming, værktøjer, JSON-output og bedste praksis.

Keywords: GLM-5.3 Flash API, hvordan man bruger GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API-vejledning, multimodalt API, ræsonnerings-API, funktionskald

URL-slug: how-to-use-glm-5-3-flash-api