Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Grok 4.2 er xAIs nyeste multiagent‑ræsonnementsmodel, der kombinerer fire samarbejdende agenter og nye agent‑baserede funktioner til værktøjskald for at levere markant hurtigere inferens med færre hallucinationer til enterprise‑workloads. For at kalde den i dag bruger de fleste udviklere enten (a) de officielle xAI REST/gRPC‑endpoints eller (b) kalder den via en aggregator som CometAPI (ét REST‑endpoint, POST https://api.cometapi.com/v1/responsess), som forenkler nøgler, fakturering og skift mellem flere modeller.
Den hurtige udvikling af store sprogmodeller (LLM’er) har ændret, hvordan softwareudviklere bygger intelligente applikationer. Blandt de nyeste aktører i AI-økosystemet er xAI’s Grok-modelserie, en række avancerede generative modeller designet til at konkurrere med førende systemer som GPT-serien og Gemini-modeller. I begyndelsen af 2026 skabte fremkomsten af Grok 4.2, en inkrementel, men kraftfuld videreudvikling af Grok 4, betydelig interesse i udviklerfællesskabet.
Grok 4.2 markerer et skifte mod agentbaserede ræsonneringsarkitekturer, der gør det muligt for flere AI-agenter at samarbejde internt om at løse komplekse problemer. Denne tilgang har til formål at forbedre ræsonneringsnøjagtighed, kvaliteten af kodegenerering og lang-kontekst-analyse—områder, som historisk har udfordret store sprogmodeller.
For udviklere og virksomheder er et af de vigtigste spørgsmål ikke kun , men . Gennem API’er og middleware-platforme som kan udviklere bygge chatbots, kodningsassistenter, videnværktøjer eller automatiseringspipelines drevet af Grok 4.2.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
hvad Grok 4.2 kan gøre
hvordan man integrerer den i produktionssystemer
CometAPI
Hvad er Grok 4.2?
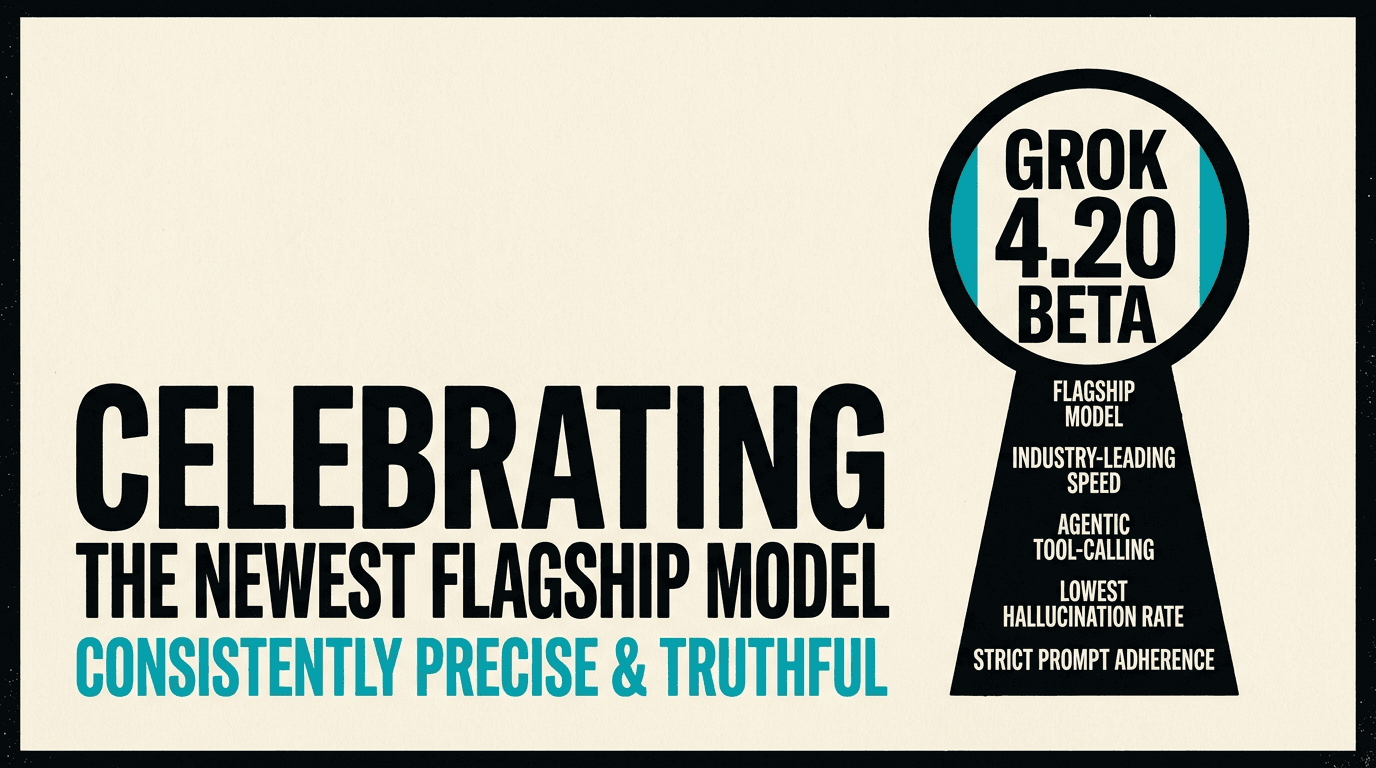
Grok 4.2 er den seneste offentlige beta-iteration af Grok-familien — en ræsonnerings-først LLM-serie fra xAI. 4.2-udgivelsen fremhæver multi-agent-samarbejde (fire interne agenttråde, der peer-reviewer svar), udvidet værktøjskald (server-side og client-side værktøjer) og høj-gennemløbs inference-tilstande målrettet realtids- og enterprise-arbejdsbelastninger.
Vigtige ting at huske:
4.2 bygger videre på Grok 4’s fokus på ræsonnering, men introducerer agentkoordinering og “rapid learning”-stil iterative opdateringer i beta.
API-overfladen forbliver REST/gRPC-kompatibel med chat/completions og endpoints for strukturerede svar (f.eks. /v1/chat/completions, /v1/responses).
Hurtige tekniske specifikationer (tabel)
Element
Grok 4.20 (familie)
Udvikler / Udbyder
xAI.
Offentlig beta-tilgængelighed
Annonceret marts 2026 (beta i xAI Enterprise API).
Modaliteter (input / output)
Tekst + billede-input → tekst-output (strukturerede output og funktion-/værktøjskald understøttet).
Kontekstvindue (typisk / udvidet)
Standard interaktive tilstande: 256k tokens; agent-/værktøj-/udvidede tilstande understøtter op til 2.000.000 tokens ifølge xAI’s dokumentation.
Grok 4.2 kører flere specialiserede “agenter” parallelt (forfattere rapporterer fire), som uafhængigt foreslår svar og forener dem for at reducere hallucination og forbedre faktualitet. Tidlige community-artikler og leverandørdocs tilskriver dette design forbedret pålidelighed i den virkelige verden ved forudsigelses- og finansopgaver.
Agent-baserede værktøjskald (server & klient)
Grok 4.2 udvider API’ets værktøj-/funktionskald: du kan registrere lokale (klient)funktioner eller lade modellen kalde server-side/søge-/kodeværktøjer, som udbyderen administrerer. Flowet er: definér værktøjer (navn + JSON-skema) → inkluder dem i anmodningen → modellen returnerer tool_call-objekter → din app udfører og svarer. Dette muliggør sikker integration med databaser, søgning eller enterprise-tjenester.
Strukturerede output, streaming og krypteret ræsonnering
Strukturerede JSON-output for forudsigelig parsing (ideelt til apps).
Streaming for lav-latenstids-UX (chat, stemmeagenter).
For visse ræsonneringsindhold understøtter platformen krypterede ræsonneringsspor, der kan anmodes tilbage til revision.
Lang kontekst og multimodalitet
Grok 4.2 understøtter store token- og udvidede kontekstvinduer til ræsonnerings- og hentningsscenarier. Billedforståelse og TTS/stemmegrænseflader er også en del af de udvidede kapaciteter.
Grok 4.2 multi-agent vs reasoning vs non-reasoning: Hvad er de praktiske forskelle
Kort svar: Grok 4.2 multi-agent, Grok 4.2 reasoning og non-reasoning er tre formålsoptimerede udgavevarianter af Grok 4.20 Beta-familien fra xAI — samme kernemodellinje, men forskellig kørselsadfærd, værktøj- & token-afvejninger og tiltænkte arbejdsbelastninger:
Grok 4.2 multi-agent (grok-4.20-multi-agent-beta-0309) — multi-agent-orkestreringstilstand. Starter flere samarbejdende agenter (du kan vælge agent_count), der researcher, krydstjekker, debatterer og syntetiserer et endeligt svar. Bedst til dyb research, langformssyntese, multi-værktøjs-workflows, hvor intern “tænkning”/agentspor er vigtige. Eksempelfunktioner: indbyggede værktøjer (web_search, x_search, code_execution), verbose_streaming til streaming af agentoutput og kontrol af ræsonneringsindsats.
Grok 4.20 Reasoning (grok-4.20-beta-0309-reasoning) — enkelt-agent reasoning-tilstand. Producerer tanke-kæde/interne ræsonnerings-tokens (når aktiveret) og er tunet til mere omhyggelige analytiske opgaver (matematik, kodeforklaring, designafvejninger). Normalt højere tokenforbrug pr. kald (ræsonnerings-tokens + completions-tokens) og en smule højere latenstid end non-reasoning-varianten. Brug denne til opgaver, der drager fordel af dybere overvejelse.
Grok 4.20 NonReasoning (grok-4.20-beta-0309-non-reasoning) — lav-latenstids, gennemløbsoptimeret non-reasoning-variant til hurtig Q&A, korte completions eller højvolumen-pipelines. Denne variant undgår (eller minimerer) lange interne tanke-kæde-output, hvilket reducerer forbruget af ræsonnerings-tokens og pris/latenstid — især nyttigt, når din app har brug for hurtige, koncise svar eller deterministiske/strukturerede output kombineret med server-side værktøjer (søgning). Bemærk: xAI har flere “fast/non-reasoning”-varianter i sin familie, og non-reasoning-stilen tilbydes eksplicit som en separat variant til gennemløbsscenarier.
Overblik over Grok 4.20 Beta-modelvarianter
Model
Type
Hovedformål
Kaldformat
grok-4.20-multi-agent-beta-0309
Multi-agent-system
Dyb research og komplekse opgaver
OpenAI's Responses-kald
grok-4.20-beta-0309-reasoning
Enkelt-model reasoning
Matematik, kodning, kompleks logik
OpenAI's Responses- og Chat-kald
grok-4.20-beta-0309-non-reasoning
Hurtig inference-model
Enkel chat, resuméer, hurtige svar
OpenAI's Responses- og Chat-kald
Disse er i det væsentlige forskellige driftstilstande for Grok 4.20, optimeret til forskellige arbejdsbelastninger. Introduktionen til Grok 4.2-modellen giver en detaljeret forklaring og udviklingsproces.
Hvornår skal jeg vælge multi-agent vs reasoning vs non-reasoning?
Brug multi-agent når:
Du har brug for eksplorativ research (indsamle, sammenligne, citere flere kilder).
Du vil have modellen til at kalde flere værktøjer autonomt (web_search, x_search, kodeeksekvering) og syntetisere fundene.
Du har brug for agent-niveauspor (til at revidere mellemtrin) eller vil køre flere perspektiver parallelt. Afvejninger: højere tokenforbrug, flere værktøjskald-omkostninger, længere ende-til-ende tid for dybe forespørgsler.
Brug reasoning når:
Opgaver kræver dybere logiske kæder, koderæsonnering, matematik eller omhyggelige, trin-for-trin-forklaringer.
Du vil have modellens interne ræsonnering tilgængelig (krypteret eller sporbar, hvor understøttet) til fejlsøgning eller verifikation.
Latenstid er acceptabel i bytte for svar med højere kvalitet.
Brug non-reasoning når:
Latenstid og gennemløb er prioriteter (chatbots i skala, konversationel UI, korte faktuelle opslag).
Du kombinerer modellen med server-side søgeværktøjer, så modellen ikke behøver at “tænke længe” for at være korrekt.
Du vil minimere pris pr. anmodning og undgå at returnere intern ræsonnering.
Funktion
Multi-agent
Reasoning
Non-reasoning
Agenter
Flere
Enkelt
Enkelt
Hastighed
Langsom
Medium
Hurtig
Nøjagtighed
Højest
Høj
Medium
Omkostning
Højest
Medium-høj
Lav
Bedst til
Research
Logik/kodning
Chat/resuméer
Ydelsessammenligning af grok 4.2
Hvordan bruger du Grok 4.2 API via CometAPI? trin-for-trin
Dette afsnit giver en praktisk integrationsrute: brug CometAPI som en stabil gateway til at kalde Grok 4.2 med et enkelt REST-mønster, der virker på tværs af modeller. CometAPI dokumenterer en konsistent endpoint-struktur og godkendelsesordning for Grok 4 (og analoge modeller).
Hvorfor bruge CometAPI: Én API-nøgle til at skifte modeller, samlet fakturering, forenklet eksperimentering og omkostningssammenligninger. Fantastisk for teams, der vil A/B-teste modeller uden kodeændringer. Model-API-priser er typisk rabatteret med 20 %, hvilket sparer udviklere udviklingsomkostninger.
Godkendelse og endpoint-grundlag (hvad du skal bruge)
API-nøgle: CometAPI kræver et bearer-token i Authorization-headeren. Eksempel fra CometAPI-docs: Authorization: Bearer YOUR_COMETAPI_KEY.
Base-URL: CometAPI eksponerer typisk et chat/completion-endpoint som https://api.cometapi.com/v1/chat/completions eller https://api.cometapi.com/v1/responses
Modelvælger: Angiv model-id i din request body (f.eks. model: "grok-4" eller et Grok 4.2-specifikt endpoint, hvis tilgængeligt via CometAPI’s modelliste).
Minimalt Python-eksempel (Responses-format kald til Grok 4.2 Multi-agent)
Nedenfor er et praktisk Python-eksempel (requests + simpel retry/backoff), der demonstrerer at sende en chat-completion til Grok via CometAPI. Erstat COMETAPI_KEY med de korrekte værdier for din konto og Grok 4.2-endpoint-navnet i CometAPI
import os

from openai import OpenAI

# Get your CometAPI key from https://api.cometapi.com/console/token, and paste it here
COMETAPI_KEY = os.environ.get("COMETAPI_KEY") or "<YOUR_COMETAPI_KEY>"
BASE_URL = "https://api.cometapi.com/v1"

client = OpenAI(base_url=BASE_URL, api_key=COMETAPI_KEY)
response = client.responses.create(
    model="grok-4.20-multi-agent-beta-0309",
    input=[
        {
            "role": "user",
            "content": "Research the latest breakthroughs in quantum computing and summarize the key findings.",
        }
    ],
    tools=[{"type": "web_search"}, {"type": "x_search"}],
)

print(response.output_text or response.model_dump_json(indent=2))
Streaming, funktion-/værktøjskald og multi-agent-arbejdsgange
Mønster for funktion-/værktøjskald
Definér værktøjer (navn, beskrivelse, JSON-parameterskema) i din anmodning eller i dashboardet.
Din app udfører værktøjet og sender resultatet tilbage; modellen fortsætter og komponerer det endelige svar.
Streaming for lav latenstid
Brug streaming-endpoints for ord-for-ord-UX (chatapps, stemmeagent). Udbyderen understøtter streaming og udsatte completions (opret et job og poll resultat). Dette reducerer oplevet latenstid og er essentielt for realtidsagenter.
Case-studier og scenariomønstre
Scenario A — Kundesupport-agent (flere runder + værktøjskald)
Brug Grok 4.2 til at indlæse brugerklage → kald CRM-værktøj (tool_call) for at hente kundedata → kald fakturerings-API’er → syntetisér endeligt svar med strukturerede trin. Fordel: modellen kan kalde værktøjer og fortsætte med konsolideret svar. (Arkitektur: streaming websocket-chat + værktøjsfunktions-endpoints + DB-logning).
Scenario B — Finansiel prognose + live-søgning
Brug agent-baseret værktøjskæde: web-søgeværktøj (server-side), beregningsværktøj (klient) og ræsonnér på tværs af resultater. Tidlige konkurrencer viser, at Grok 4.2 klarer sig godt i kombinerede søg+ræsonneringsopgaver. Benchmark før produktion.
Scenario C — Compliance-revision og krypteret ræsonnering
Indfang krypterede ræsonneringsspor pr. anmodning til efterfølgende audit; brug deterministisk ræsonneringstilstand (temperature:0), når der genereres regulatoriske narrativer.
Bedste praksis ved integration af Grok 4.2 i produktion
Effektiv brug af Grok 4.2 kræver en kombination af ingeniørmæssig og operationel disciplin. Nedenfor er konkrete bedste praksisser, der afspejler både generel LLM-integrationsviden og punkter specifikke for Grok 4.2’s beta-adfærd.
Design til adfærdsdrift under beta
Fordi Grok 4.2 itererer ugentligt under den offentlige beta, skal du antage, at subtile adfærdsændringer vil forekomme. Fastlås modelversionen (hvis udbyderen tilbyder versions-ID’er), brug canary-udrulninger, og implementér automatiske regressionstests, der øver kritiske prompts og API-flows, så du kan opdage adfærdsdrift tidligt.
Brug funktionskald / strukturerede output, hvor det er muligt
Foretræk typede funktionskald eller JSON-output til forretningskritiske integrationer. Strukturerede output reducerer parsefejl og muliggør deterministisk downstream-behandling. CometAPI / Grok understøtter funktionskald-stil-interaktioner; definér dit skema og valider svar ved modtagelse.
Rate limits, batching og omkostningskontrol
Batch-behandl ikke-interaktive forespørgsler for at reducere overhead pr. kald.
Sæt sikre timeouts (f.eks. 20–30 s) og implementér retries med eksponentiel backoff for forbigående fejl.
Token-budgetter: styr max_tokens for at undgå løbske regninger; instrumentér gennemsnitlige tokens pr. anmodning. CometAPI og andre aggregatorer dokumenterer rate limits og priser — tjek disse sider.
Konklusion
Grok 4.2 — der i øjeblikket rulles ud som en offentlig beta med ugentlige opdateringer — tegner til at blive et stort skridt inden for ræsonneringsfokuserede og multimodale LLM’er. Den bringer arkitektoniske ændringer (multi-agent-ræsonnering, meget store kontekstvinduer, native multimodalitet), der muliggør nye klasser af produktfunktioner, men tilføjer også operationel kompleksitet. At bruge en gateway som CometAPI giver en praktisk abstraktion til hurtig eksperimentering