Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Hy4 vs GPT-6.1 Terra: benchmarks, API-priser og hvilken model du skal vælge
Sammenlign Hy4 og GPT-6.1 Terra i forhold til kodning, forskning, officielle API-specifikationer og CometAPI-prissætning. Find den rette model til din arbejdsbelastning.
Hy4 er et stærkt udgangspunkt til finansiel research og tekstgenerering i høj volumen; GPT-6.1 Terra er et stærkt udgangspunkt til terminalkodning og fejlfinding. Begge accepterer tekst og billeder og understøtter værktøjsbrug. De tydeligste forskelle er opgavepræstation, outputkapacitet og pris: Terra fører terminal-kodningstesten nedenfor, mens Hy4 fører finans- og researchtestene og koster mindre til de listede CometAPI-satser.
Vigtigste pointer
Vælg efter arbejdsbyrde: Hy4 til research og outputtunge applikationer; Terra til terminalkodning og fejlfinding.
Begge tilbyder kontekstvinduer på omkring én million tokens. Terra har et større maksimalt outputbudget.
Terra fører Terminal-Bench 4.0 med 10.10 procentpoint; Tencent-modellen fører Finance Agent v2.1 med 8.74 point i Vals AIs resultater.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
CometAPI-eksemplet med 10M input- og 2M outputtokens koster $10.672 versus $16.00 til de viste basispriser.
Match endpoint, værktøjsadfærd og ræsonneringsindstillinger til din applikation, før du skifter udbyder.
Specifikationer, benchmark-øjebliksbilleder og priser kontrolleret den 6. november 2026.
Hy4 vs GPT-6.1 Terra: Specifikationer og kapaciteter
Hy4 kombinerer tekst- og billedforståelse med ræsonnering og værktøjsbrug, inklusive arbejdsgange på tværs af kommandolinje og grafiske brugerflader. GPT-6.1 Terra understøtter visuel ræsonnering, computerbrug og skrivning med eksplicit kontrol over ræsonneringsindsats og et større outputbudget. Tabellen nedenfor sammenligner specifikationer fra Tencent og OpenAI.
Officielle API-specifikationer
Specifikation
Hy4 · Tencent Cloud officielle specifikationer
GPT-6.1 Terra · OpenAI officielle specifikationer
Udvikler
Tencent
OpenAI
API-model-ID
hy4
gpt-6.1-terra
Input / output
Tekst og billeder / tekst
Tekst og billeder / tekst
Kontekstvindue
1024K tokens (Tencent-betegnelse)
1,050,000 tokens
Maksimalt output
64K tokens (Tencent-betegnelse)
128,000 tokens
Værktøjskald
Understøttet (Function Calling)
Understøttet; kræver Responses API
Strukturerede output
Understøttet
Understøttet
Primære anvendelser
Softwareudvikling, finansiel analyse og langkørende agentopgaver
Visuel ræsonnering, computerbrug, skrivning og afgrænsede kodeopgaver
Begge modeller kan arbejde med store dokumentsamlinger og kodebaser. For lange prompts skal du også budgettere plads til svaret: Tencent angiver et maksimalt input på 960K for Hy4. Den lille forskel i annonceret kontekstkapacitet er mindre nyttig til udvælgelse end, hvor præcist hver model bruger dit materiale.
Terra tilbyder mere plads til et langt svar med op til 128,000 outputtokens mod Hy4’s offentliggjorte 64K-grænse. Det hjælper, når en rapport eller en kodedelleverance skal passe i ét svar. Ræsonneringstokens bruger også af Terras outputbudget.
Ræsonneringsindstillinger
Terra tilbyder seks indstillinger for ræsonneringsindsats: none, low, medium, high, xhigh og max, hvor medium er standard. Det giver applikationer en eksplicit måde at justere inferensindsats efter opgave. En klassifikationsanmodning og en svær fejlsøgningsopgave behøver ikke bruge samme budget.
Tencents lancering beskriver ræsonnering kombineret med visuel perception og værktøjsbrug, men definerer ikke en tilsvarende seks-niveau-kontrol i den meddelelse. Betragt ræsonneringsparametre som endpointspecifikke: Kopiér ikke én udbyders indsatsindstilling ind i en anden anmodning og antag, at den har samme betydning.
Hy4 vs GPT-6.1 Terra: Præstation
Vals AI leverer direkte resultater for begge modeller på tværs af kodning, finans, juridisk research og skatteopgaver. Disse scorer viser, hvor hver model er en nyttig kandidat til din arbejdsbyrde.
Uafhængige benchmarkresultater og testbetingelser
Følgende Vals Index v2.2-resultater blev kontrolleret den 10. november 2026. Højere scorer er bedre.
Benchmark eller metric
Hy4: Vals AI-resultater
GPT-6.1 Terra: Vals AI-resultater
Fortolkning
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 procentpoint
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 point
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 point
Finance Agent v2.1
64.70%
55.96%
Tencent-model +8.74 point
Legal Research Bench
41.35%
25.96%
Tencent-model +15.39 point
Tax Agent Bench
34.40%
17.08%
Tencent-model +17.32 point
Vals AI angiver temperatur 0.9, top_p 1.0 og en outputgrænse på 65,536 tokens for Hy4; Terra bruger maksimal ræsonneringsindsats og en outputgrænse på 128,000 tokens. Disse indstillinger er forskellige, så læs resultaterne som sammenligninger af de testede konfigurationer snarere end lige budgetkørsler.
Terras forspring er større på terminalopgaver end på kodegenerering: 10.10 procentpoint på Terminal-Bench 4.0 mod 2.99 point på Vibe Code Bench. Det gør fejlfinding og kommandolinjeudvikling til de tydeligste steder at begynde at evaluere Terra.
Hy4 fører Finance Agent, Legal Research Bench og Tax Agent Bench med 8.74, 15.39 og 17.32 procentpoint. Research-arbejdsgange, der indsamler evidens og anvender domæneregler, er derfor lovende startpunkter for Hy4.
Den samlede forskel er 1.19 procentpoint, og de offentliggjorte usikkerhedsintervaller overlapper.
Tencents Hy4-lanceringsbenchmarks
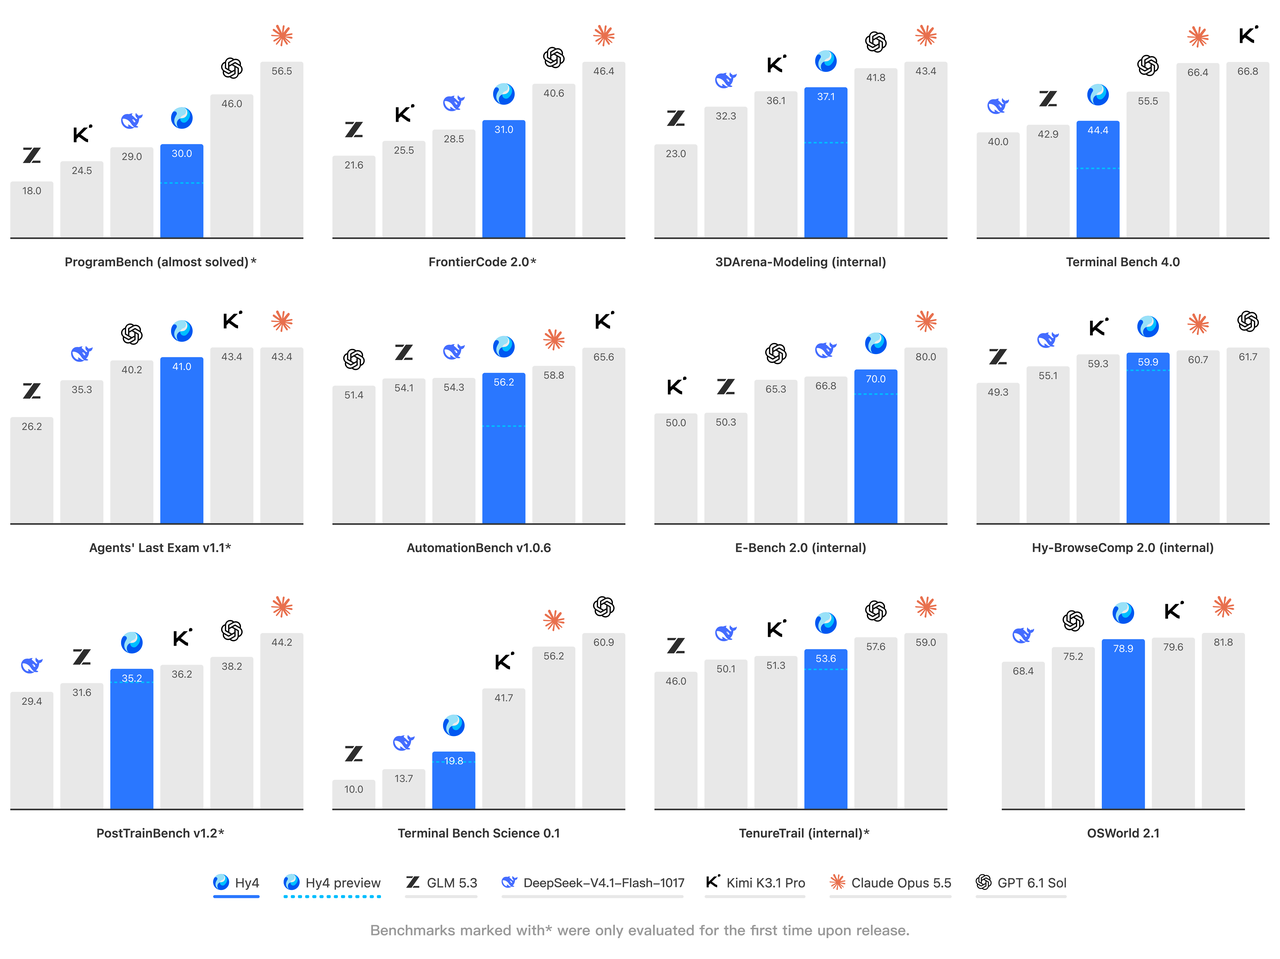
Tencents lanceringsgraf tilføjer resultater for kodning og computerbrug. Den sammenligner Hy4 med GPT-6.1 Sol; brug Vals AI-tabellen ovenfor for den direkte sammenligning med GPT-6.1 Terra.
Tencent-rapporterede Hy4-benchmarkresultater, november 2026. OpenAI-modellen vist er GPT-6.1 Sol.
I Tencents lanceringsgraf scorer Hy4 44.4 på Terminal Bench 4.0 og 78.9 på OSWorld 2.1. Disse tal beskriver Tencents evalueringssetup og er separate fra Vals AI-scorerne ovenfor.
Arbejdsgange for vision og computerbrug
Tencent introducerer billedforståelse i den officielle release og beskriver træning til arbejdsgange, der spænder over kommandolinjeværktøjer, grafiske grænseflader, Blender og CAD. Det gør diagramanalyse og visuelle softwareopgaver centrale for positioneringen.
OpenAI positionerer sin model til skærmbaserede arbejdsgange, kortfattet skrivning og afgrænsede kodefix. For en katalogapplikation: test produktfoto-matchning; for teknisk arbejde: brug tegninger med små etiketter og mål; for desktopautomatisering: verificér de gemte filer og applikationstilstand.
Et godt visuelt testdatasæt bør adskille aflæsning fra handling. Mål først, om modellen udtrækker de korrekte værdier eller identificerer det rigtige grænsefladeelement. Mål derefter, om den komplette arbejdsgang når det krævede resultat uden forkerte klik, manglende filer eller unødvendig menneskelig indgriben.
Hastighed og end-to-end-latenstid
For chat er de relevante hastighedsmål, hvor hurtigt svaret begynder, og hvor lang tid det tager at blive færdigt. For agenter: mål den komplette opgave, inklusive værktøjskørsel og eventuelle reparationer.
Sammenlign begge modeller på typiske og krævende opgaver ved din forventede samtidighed. Spor median- og latenstid i halen sammen med succesfuld gennemførelse: Et hurtigt svar er kun nyttigt, hvis det får arbejdet gjort.
Hy4 vs GPT-6.1 Terra: Omkostninger
Sammenlign først tokenpriser, og medregn derefter arbejdet, der kræves for at opnå et brugbart resultat. Priserne nedenfor er CometAPI-basispriser i amerikanske dollars pr. million tokens; de er separate fra omkostning-pr.-test-tallene rapporteret af Vals AI.
CometAPI-priser for input og output
Omkostningspost
Hy4 API i CometAPI
GPT-6.1 Terra API i CometAPI
Input pr. million tokens
$0.6672
$0.80
Output pr. million tokens
$2.00
$4.00
Tabellen nedenfor bruger CometAPIs listede basispriser i amerikanske dollars pr. million tokens. Sammenlign input og output separat, og beregn derefter omkostningen for din typiske anmodning.
Eksempelomkostning for 10,000 anmodninger
Overvej 10,000 anmodninger, hver med 1,000 ikke-cachede inputtokens og 200 fakturerbare outputtokens. På tværs af alle anmodninger er det 10 millioner inputtokens og 2 millioner outputtokens. Ved brug af CometAPI-basispriserne ovenfor:
Hy4 koster ca. 33.3% mindre i dette eksempel. Dette estimat dækker ikke-cachet input og fakturerbart output; tilføj cache-, værktøjs- og retry-omkostninger, når du budgetterer en komplet arbejdsgang.
Fakturering hos direkte udbyder og forespørgsler med lang kontekst
For lange dokumenter på OpenAI’s direkte API udløser prompts over 272K inputtokens 2× input- og cachepriser og 1.5× outputpriser for hele forespørgslen. Anvend faktureringsreglerne for den tjeneste, du bruger; CometAPI-eksemplet ovenfor bruger CometAPI-basispriser. OpenAI-prisdetaljer.
Omkostning pr. accepteret opgave
En accepteret opgave er en, der opfylder din applikations kvalitets- og afleveringskontroller. Medregn alle forsøg, værktøjsbrug og review-arbejde, der er nødvendigt for at nå det resultat, inklusive forbrug på forsøg, der fejler.
Omkostning pr. accepteret opgave = samlede model-, retry-, værktøjs- og menneskelig-review-omkostninger ÷ opgaver, der består acceptkontroller.
Et dyrere kald kan stadig være økonomisk, hvis det fjerner flere reparationsforsøg. Omvendt kan det give begrænset værdi at betale en højere sats for hver opgave, når en billigere model opfylder kvalitetstærsklen.
Hvilken model skal du vælge: Hy4 eller GPT-6.1 Terra?
Start med den model, hvis styrker matcher din primære arbejdsbyrde. Brug følgende valg til at opbygge en shortlist, og sammenlign derefter kvaliteten og omkostningen af fuldførte opgaver.
Hvornår du skal vælge Hy4
Vælg først Hy4 til finansiel research, juridisk eller skattemæssig dokumentanalyse og applikationer, der genererer meget tekst. Dens forspring på de tre domænebenchmarks gør den til en nyttig kandidat til evidenstung research. Til de listede CometAPI-satser er dens outputpris halvdelen af Terras, hvilket kan gøre en materiel forskel for udkast og rapportering i stor skala.
For researcharbejde skal den færdige besvarelse bedømmes på kildepræcision, beregninger og dækning af spørgsmålet. Hy4 er det bedre match, når den opfylder disse krav til en lavere samlet omkostning, inklusive review og retries.
Hvornår du skal vælge GPT-6.1 Terra
Vælg først GPT-6.1 Terra til terminalkodning, fejlfinding og kodefix. Dens forspring på 10.10 point på Terminal-Bench er det stærkeste kodningssignal i denne sammenligning. Det større outputbudget gør den også værd at teste til lange rapporter og omfattende koderesponser.
Bedøm Terra på, om dens patches består dine tests, og om dens leverancer er komplette. For visuelle eller desktopopgaver: sammenlign begge modeller på dine faktiske skærme, diagrammer og filer, og kontroller det endelige gemte resultat.
Dirigering af research og kodning til forskellige modeller
En blandet arbejdsbyrde kan have fordel af at bruge begge modeller. En finansanalyseassistent kunne bruge Hy4 til research og rapportudkast og derefter kalde Terra, når et analyse-script skal fejlsøges:
Send evidensindsamling og rapportudkast til Hy4.
Tjek citater, kildeværdier og beregninger, før rapporten accepteres.
Dirigér et fejlslagent analysetript til Terra med koden, fejloutput og forventet adfærd.
Kør det rettede script, og anvend de samme evidenskontroller, før det endelige resultat returneres.
Brug en anden model, når den forbedrer slutresultatet nok til at dække de ekstra omkostninger og integrationsarbejdet.
Hvor kan du få adgang til Hy4 og GPT-6.1 Terra?
Adgang via officielle udbydere
Få adgang til Hy4 via Tencent Cloud TokenHub og GPT-6.1 Terra via OpenAI’s API. Brug udbyderens dokumentation til autentificering, model-ID’er og fakturering.
CometAPI-adgang og værktøjskompatibilitet
CometAPI tilbyder begge modeller under ID’erne hy4 og gpt-6-1-terra. Dets modelsider viser forespørgseksempler og priser for hver rute: Hy4 og GPT-6.1 Terra.
For værktøjsaktiverede applikationer skal du verificere den valgte routes understøttelse af funktionskald og strukturerede output. På OpenAI’s direkte API kræver Terra-værktøjskald Responses API.
Sådan tester og ruller du dit valg ud
Før du ændrer produktionstrafik, skal du sammenligne modellerne på repræsentative opgaver med de samme input, værktøjer og godkendelseskriterier. Registrér succesfulde gennemførelser, samlede omkostninger og forløbet tid, og rul derefter den stærkere rute ud gradvist.
Medtag rutineanmodninger og svære sager, der betyder noget for dine brugere.
Tjek værktøjsargumenter, strukturerede output, fejl og fuldførelsesstatus.
Sæt retry-grænser og rollback-triggere, før du sender live trafik.
Konklusion
Vælg Hy4, når forskningskvalitet og lavere tekstgenereringsomkostninger er dine prioriteter. Vælg GPT-6.1 Terra, når terminalkodning, fejlfinding og et større outputbudget betyder mest.
For en blandet applikation: start med én model pr. hovedarbejdsbyrde og tilføj en anden rute, hvor den forbedrer resultaterne. Det bedste valg er det, der fuldfører dine opgaver nøjagtigt til en omkostning, du kan bære.