Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Hvad er Kimi K3.1: lanceringsdato, læk og forventede funktioner
Udforsk rapporter om udgivelsesdatoen for Kimi K3.1, lækkede ræsonneringsniveauer, 1M-kontekst og ledetråde om Agent Swarm, samt K3-sammenligninger og API-forberedelse.
Pr. 9. oktober 2026 antyder rapporter, at Kimi K3.1 kan lande denne måned, men de gennemgåede kilder fastslår ikke en officiel lanceringsdato, endelig pris eller K3.1‑specifikke benchmarkresultater. De rapporterede Low / High / Max-, Extra Long-, Agent- og Swarm‑flag overlapper med eksisterende K3‑funktioner. Den potentielle opgradering er kun væsentlig, hvis den forbedrer ræsonneringseffektivitet, pålidelighed ved lang kontekst og omkostning pr. fuldført opgave; konfigurationsetiketter alene kan ikke dokumentere sådanne gevinster.
Key Takeaways
Lanceringstidspunkt: Oktober er en medieomtalt mulighed, uden officiel lanceringsforpligtelse bekræftet af de citerede kilder.
Tekniske spor: Low / High / Max og en rapporteret 1M‑token‑mulighed overlapper med K3‑funktioner; K3.1‑arkitektur og endelige grænser er fortsat ubekræftede.
Agent‑arbejdsgange: Agent-, Swarm-, søge- og batch‑flag indikerer mulig integrationsarbejde snarere end målte forbedringer.
Ydelse og pris: Offentliggjorte K3‑resultater og takster er referencegrundlag, ikke K3.1‑benchmarks eller tariffer.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Hvad er Kimi K3.1: lanceringsdato, læk og forventede funktioner - CometAPI
API‑parathed: Bekræft aktiverede model‑ID’er, dokumenterede parametre og konto‑adgang, før du udruller K3.1 via CometAPI.
Hvad er Kimi K3.1?
Kimi K3.1 er en rapporteret næste iteration af Moonshot AI’s Kimi‑modelfamilie. Lækkede konfigurationsidentifikatorer antyder arbejde med ræsonnering, lang kontekst og agent‑arbejdsgange. Dets endelige specifikationer, lanceringsdato og pris er ikke fastslået af de gennemgåede kilder, så det bør behandles som en forventet model snarere end en bekræftet offentlig udgivelse.
Hvad ved vi om Kimi K3.1?
(Seneste community‑rapporter pr. 23. oktober 2026)
Kimi K3.1 er den forventede efterfølger til Moonshot AI’s Kimi K3 (udgivet 16. juli 2026 — en MoE‑model med åbne vægte og 2,8T parametre samt 1M kontekst). Ingen officielle specifikationer, priser, benchmarks eller udgivelsesdato er annonceret af Moonshot. Alt nedenfor er community‑kilder og spekulation.
Stille test på Arena under kodenavnet “Kibitz”
En anonym model ved navn Kibitz dukkede op i LMSYS / Arena.ai kodning‑kampe omkring 21.–22. oktober 2026.
Community‑beviser peger stærkt på, at det er en Moonshot/Kimi‑model:
Den identificerer sig som Kimi, når den bliver spurgt.
Tokenizer‑fingeraftrykstest viser, at den fejler alle 11 Moonshot‑kun testtokens (præcis som tidligere Kimi‑modeller); modeller fra andre laboratorier består dem.
Navngivningsmønsteret matcher tidligere stealth‑tests: K2.5 → Kiwido, K2.6 → Kiwire, K3 → Kivine og nu Kibitz.
Kimi Code’s interne konfiguration viste kortvarigt et model‑switch‑mål kaldet “k3.1” (samt en migrationsregel fra K3‑sessioner).
Tidlige brugertests (især 3D/voxel‑generering, SVG, Three.js‑scener og komplekse frontend‑opgaver) er beskrevet som meget stærke — til tider tæt på Claude Opus 5.5 Medium eller konkurrencedygtige med Fable 5.1 / GPT-6 Astra, med mærkbart hurtigere generering i nogle tilfælde.
Arena.ai postede selv: “En ny model fra @Kimi_Moonshot er på vej. Følg med for at se, hvor den lander i Arena.”
Officiel teaser‑video på 24 sekunder (23. oktober 2026)
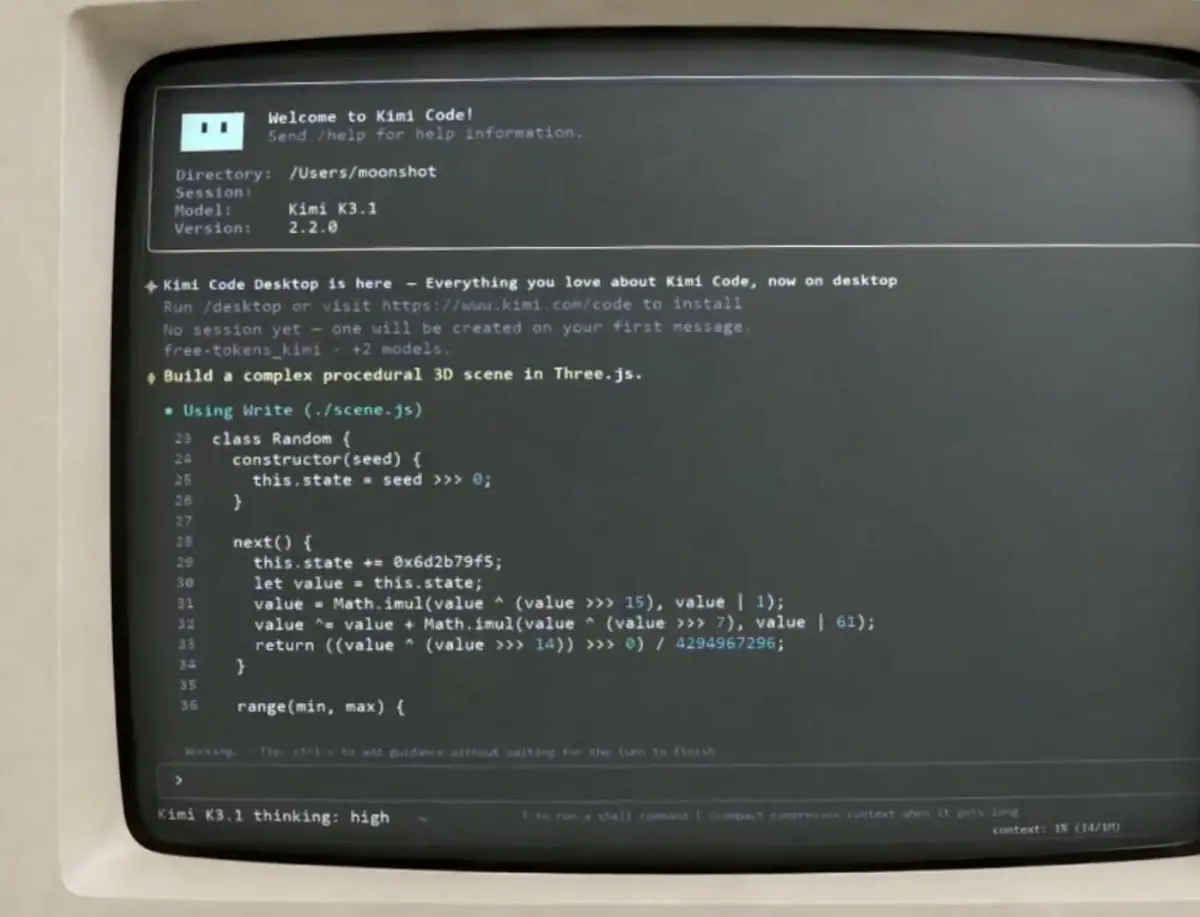
Den 23. oktober 2026 postede den officielle @Kimi_Moonshot‑konto en 24‑sekunders retro‑stil video uden billedtekst.
Den viser en vintage CRT‑skærm, der kører Kimi Code (version 2.2.0). Modelvælgeren viser tydeligt “Kimi K3.1”, med thinking sat til “high” og en 1M‑kontekstindikator. Modellen bliver bedt om at generere en kompleks procedurel 3D‑scene i Three.js.
Dette er første gang Moonshot offentligt har vist navnet “Kimi K3.1”. Der blev ikke givet yderligere detaljer (lanceringsdato, størrelse, pris eller vægte). Opslaget fik hurtigt stor engagement.
Andre understøttende spor
Sidst i september 2026: Udviklere opdagede en “kimi-k3-1”‑identifikator på Moonshots API‑backend.
En kortlivet SGLang pull request (lukket inden for minutter) refererede til en live DeepInfra Kimi‑K3.1‑deployment, inkl. et nyt “medium” thinking‑indsatsniveau og billedinput.
Community‑lækere (fx @ChrisGPT) hævder, at det bliver en lavpris, state‑of‑the‑art open‑source‑model og kan komme før næste tirsdag (altså meget snart). En bredt delt Minecraft‑selvportræt‑test hævdede markant bedre omkostningseffektivitet end GPT-6 Astra, men tallene er uofficielle.
Aktuel statusoversigt
Ikke udgivet — ingen model card, API‑endpoint, pris, vægte eller officiel annoncering endnu.
Stærkeste signaler: Kibitz‑test på Arena + officiel teaser‑video, der viser navnet.
Forventet fokus (baseret på K3‑præcedens og community‑snak): forbedret lang‑horisont agent‑drevet kodning, 3D/kreativ generering, effektivitet og muligvis lavere omkostning end K3.
Historisk mønster: K3 dukkede selv op anonymt på Arena (~30 timer) før den officielle lancering.
Community‑konsensus er, at en fuld udgivelse er nært forestående (dage snarere end uger), men intet er bekræftet, før Moonshot melder det ud.
Hvornår bliver Kimi K3.1 udgivet?
De gennemgåede kilder fastslår ikke en officiel udgivelsesdato for Kimi K3.1. IT Home rapporterer oktober 2026, mens Wccftechs tidligere dækning siger før oktober. Dette er forskellige medieprognoser, ikke en verificeret udviklingsplan. Et screenshot kan ikke fastslå udrulningsdatoer, kontoegnethed eller deploy‑parathed.
Afvent en dateret Moonshot‑meddelelse, understøttede model‑ID’er, udviklerdokumentation og adgangsbetingelser, før en lanceringsdato behandles som bekræftet. Prissætning og reproducerbare K3.1‑specifikke evalueringer er separat evidens, der er nødvendig for deploy‑beslutninger.
Hvilke specifikationer kan Kimi K3.1 tilbyde?
Det stærkeste tekniske udgangspunkt er den eksisterende Kimi K3, en udgivelse fra juli 2026 med en sparse MoE‑arkitektur på 2,8 billioner parametre, native visuelt input og et kontekstvindue almindeligt beskrevet som 1M tokens. De citerede kilder fastslår ikke K3.1‑arkitektur, parameterantal eller model‑specifikke evalueringsresultater.
Low / High / Max i den nuværende Kimi Code‑dokumentation
Low / High / Max‑flag
Vision
Native visuelt input
Ikke bekræftet
Swarm
Eksisterende Kimi Swarm‑funktion
Swarm‑flag rapporteres at fremgå
API‑pris
Offentliggjort K3‑takst
Ingen endelig prissætning
Vægte
K3‑vægte udgivet
Ukendt
Hvilke funktioner er rapporteret for Kimi K3.1?
De tre temaer nedenfor kombinerer de rapporterede K3.1‑spor med dokumenterede K3‑funktioner. De forklarer, hvad indstillingerne kunne betyde, uden at fremstille rygtede K3.1‑funktioner som bekræftede specifikationer.
Tre ræsonneringsniveauer giver en indsatsafvejning
Low kan passe til ekstraktion, simpel Q&A og rutineklassifikation, når lavere latenstid er vigtig. High kan tilbyde en praktisk balance til flertrinsudvikling og dokumentarbejde. Max kan allokere mere ræsonneringsbudget til svær kodning eller research, med højere latenstid og mulig omkostning. Disse opgavemappinger er fortolkninger, der skal testes, ikke verificerede K3.1‑garantier.
Disse arbejdsbyrdeeksempler er analytiske fortolkninger, ikke verificerede K3.1‑servicegarantier. Udviklere bør sammenligne kvalitet pr. enhed af forbrug: en høj‑indsats kørsel kan koste mere pr. forsøg, men færre gentagelser kan reducere den samlede arbejdsflowsomkostning. Den meningsfulde opgradering ville være forbedret opgavesucces ved et sammenligneligt token‑ og værktøjsbudget.
En 1M‑token‑mulighed udvider basis for lang kontekst
Et million‑token‑vindue kan rumme betydelige kode‑repositories, lange tekniske dokumenter, projekthistorikker og omfattende værktøjsspor. Men maksimal kontekstlængde er ikke det samme som nøjagtig brug af fjern information. En produktiv model skal stadig hente de rigtige fakta, opretholde tværdokument‑konsistens og holde prefill‑latens håndterbar.
Evaluer lang kontekst ved at teste retrieval på forskellige promptpositioner, konsistens på tværs af dokumenter og tid til første token. Mål også cache‑genbrug og omkostningen ved at bevare eller komprimere agent‑historik. En nominelt 1M‑token‑grænse er kun nyttig, hvis modellen kan hente fjern evidens nøjagtigt inden for acceptabel latenstid og budget.
Agent‑ og Swarm‑flag antyder koordineret opgaveudførelse
De agentrelaterede identifikatorer og Swarm‑flag er måske mere interessante end kontekstallene. Kimi understøtter allerede multi‑agent‑arbejde; derfor må den rygtede opgradering forbedre routing, delegering, resultat‑aggregation og omkostningskontrol snarere end blot at tilføje en Swarm‑etiket.
I en plausibel orkestreret arbejdsgang opdeler en koordinator en kompleks forespørgsel i forskning, kodning, test og syntese‑delopgaver. Specialiserede arbejdere kører parallelt, returnerer evidens og forenes af koordinatoren. Sådan parallelisering kan reducere forløbstid, mens det øger det samlede antal modelkald, så væg‑ur‑hastighed og omkostning skal rapporteres separat.
Kimis officielle Agent Swarm‑dokumentation beskriver eksisterende parallel agent‑eksekvering. Eksemplet nedenfor illustrerer, hvordan sådan orkestrering kan opdele arbejdet; det fastslår ikke K3.1’s endelige konfiguration eller en påkrævet Swarm‑topologi.
En forsknings‑arbejder kan hente kilder og verificere citater; en kode‑arbejder kan modificere moduler og returnere eksekveringsbevis; en analyse‑arbejder kan sammenligne alternativer med reproducerbare beregninger. En koordinator tildeler opgaver, forener uenigheder og sætter et budgetloft. Hver arbejders output skal verificeres, før det kombinerede resultat accepteres.
For K3.1 bør udviklere se efter reproducerbare benchmarks af vellykkede end‑to‑end agent‑opgaver, fejlrecovery, håndtering af agent‑til‑agent‑uenighed, antal værktøjskald og samlet forbrug. Konfigurationsflag alene kan ikke fastslå forbedring.
Hvordan sammenlignes Kimi K3.1 med K3 på benchmarks?
Der findes ingen verificeret K3.1‑specifik benchmarktabel. Tallene nedenfor er fra Moonshots officielle K3‑evalueringer og vises udelukkende som sammenligningsbasis. Forskellige model‑harnesses og vurderingsindstillinger begrænser streng én‑til‑én‑sammenligning.
Benchmark
Kimi K3
GPT-5.6 Sol
Claude Fable 5
DeepSWE
67.5
73.0
70.0
Terminal-Bench 2.1
88.3
88.8
88.0
FrontierSWE
81.2
71.3
86.6
Program Bench
77.8
77.6
76.8
Kimi Code Bench 2.0
72.9
64.8
76.9
SWE Marathon
42.0
39.0
35.0
Kildedivergens: det oprindelige billede viser Fable 5 på 84,6 på Terminal‑Bench 2.1, mens den officielle repository‑evalueringstabel rapporterer 88,0. Tabellen ovenfor følger repository’et; det officielle billede er gengivet uden ændring.
Evalueringsnoterne angiver K3 max effort, temperatur 1,0 og top‑p 1,0. DeepSWE v1.1 bruger Kimi Code her; det separat citerede mini‑SWE‑agent‑resultat er 67,3. Terminal‑Bench bruger Kimi Code for K3, Terminus 2 for Fable 5 og Codex for Sol. FrontierSWE bruger Kimi Code/Codex og dominansscores fra 16. juli; ProgramBench bruger Kimi Code for K3. KCB 2.0 bruger Kimi Code/Claude Code for K3 og Claude Code/Codex for Fable/Sol. SWE Marathon bruger en H20‑kalibreret v1.1‑gren med Claude Code/Codex; Fable ramte fallbacks på 35% af opgaverne. Dette er leverandør‑rapporterede resultater under forskellige harnesses.
Se de officielle evalueringsnoter for hver benchmarks fulde protokol; tallene fastslår ikke en kontrolleret K3.1‑sammenligning.
K3 er særligt konkurrencedygtig på Program Bench og SWE Marathon i dette sæt, mens de komparative førere varierer efter test. K3.1 kan ikke erklæres hurtigere eller mere præcis, før der er offentliggjort tests med dokumenteret agent‑harness, ræsonneringsbudget og evalueringsdato.
Kimi K3 API i CometAPI (officiel lancerings‑takstreference)
Kimi K3.1 API i CometAPI (ubekræftet takst)
Cached input
US$0.30 / 1M tokens
Ubekræftet
Uncached input
US$3.00 / 1M tokens
Ubekræftet
Output
US$15.00 / 1M tokens
Ubekræftet
Agent‑orkestrering
Afhænger af faktisk brug
Ubekræftet
Ved disse K3‑referencesatser vil 100.000 uncached input‑tokens plus 10.000 output‑tokens koste US$0,45. Dette er et illustrativt K3‑regneeksempel, ikke K3.1‑priser. Virksomhedsplanlægning bør bruge omkostning pr. verificeret opgave frem for tokens alene.
Hvordan kan udviklere forberede sig på Kimi K3.1 API‑adgang?
Adgangstjek kommer før integration
Udviklere kan følge Kimi K3.1 API i CometAPI for adgangsopdateringer. Den 9. oktober 2026 stod tilgængelighedssektionen stadig som Coming Soon, sammen med generisk endpoint‑ og health‑tekst. Behandl den inkonsistente side som et opdagelseslink; bekræft et aktiveret model‑ID og en vellykket kontoniveau‑test, før du antager produktionsadgang.
En lancerings‑tjekliste guider deploy‑beslutningen
Spørgsmål
Dokumentation tilgængelig nu
Bekræftelse nødvendig
Udgivelse?
Lækkede rapporter i september
Moonshot‑udgivelsesmeddelelse
Ny arkitektur?
Intet K3.1 model card
Teknisk rapport og parametre
Bedre ræsonnering?
Tre velkendte indsats‑tilstande
Kvalitet/omkostning vs K3 på hvert niveau
Bedre lang kontekst?
Rapporteret 1M‑mulighed
Nøjagtighed og latenstid ved 1M
Bedre multi‑agent?
Agent/Swarm‑konfigurationsflag
Agent‑succes og omkostningsbenchmarks
API‑produktionsadgang?
Coming Soon‑indikator
Understøttede ID’er, dokumentation, prissætning
Forberedelse kan begynde med portable evalueringer og et begrænset testbudget. Migration bør vente på dokumenteret adgang og gentagelige arbejdsløbsgevinster. Beslutningen er, om K3.1 producerer accepterede resultater mere stabilt og økonomisk, snarere end om en katalogside eller konfigurationsflag findes.
Ofte stillede spørgsmål
Hvordan kan udviklere verificere adgang til Kimi K3.1?
Bekræft udbyderens understøttede model‑ID og konto‑berettigelse, kør derefter en lille forespørgsel og inspicér den returnerede modelidentifikator, forbrug og fejl. Et vellykket kald verificerer adgang for den konto og rute på det tidspunkt; en katalogpost eller health‑label alene fastslår ikke en offentlig lancering eller stabil kvote.
Kan Kimi K3.1 erstatte K3 i en eksisterende agent?
Behandl migration som en kompatibilitetsændring. Tjek værktøjsskemaer, håndtering af ræsonneringshistorik, outputformater og timeout‑adfærd, før du afspiller repræsentative opgaver. Brug en fastlåst baseline og behold rollback‑routing. Et lignende modelnavn eller kontekstgrænse er utilstrækkelig evidens for, at langvarige sessioner vil opføre sig identisk.
Hvordan bør teams budgettere for et Kimi K3.1‑pilotprojekt?
Start med et afgrænset opgavesæt frem for at ekstrapolere en rygtet tokenpris. Spor uncached input, cache‑træffere, ræsonnerings-/output‑tokens, værktøjskald, genforsøg og tid til menneskelig korrektion. Reservér et fast evalueringsbudget og sammenlign omkostning pr. accepteret resultat, efter endelige satser er dokumenteret.
Hvad ville tælle som en meningsfuld Kimi K3.1‑opgradering?
Kræv gentagelige gevinster på din arbejdsbyrde ved sammenligneligt ræsonnerings‑ og værktøjsbudget. Test fjern‑evidenshentning, modstridende dokumenter, agent‑recovery og end‑to‑end‑opgaveaccept. Registrér fejlraten, latenstid og samlet forbrug sammen; et større nominelt vindue eller ekstra konfigurationsflag alene er utilstrækkeligt.
Konklusion
Kimi K3.1 bør bedst behandles som en rapporteret potentiel udgivelse. Den gennemgåede evidens identificerer mulig konfigurationsarbejde, mens K3 allerede leverer lang kontekst, justerbar indsats og Swarm‑eksekvering. Den praktiske mulighed er bedre opgavekvalitet til en bæredygtig omkostning. Forbered portable evalueringer nu, og træf migrationsbeslutninger efter, at officielle specifikationer, adgangsbetingelser, prissætning og reproducerbare K3.1‑resultater er tilgængelige.