Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Kimi K3.1 Pro vs Kimi K3: benchmarks, funktioner, priser og hvilken er bedst? - CometAPI
Kimi K3.1 Pro vs Kimi K3: benchmarks, funktioner, priser og hvilken er bedst?
Sammenlign Kimi K3.1 Pro og Kimi K3 på benchmarks, kodning, ræsonnement, kontekst, API-priser og hastighed. Find ud af, hvilken model der er bedre, og hvornår det er værd at opgradere.
Kimi K3.1 Pro er Moonshot AIs opgradering af Kimi K3 den 24. oktober 2026. Yderligere eftertræning forbedrer autonom kodning, finansiel research og udvidede værktøjsbaserede workflows, samtidig med at den omtrent én million tokens store kontekstkapacitet bevares.
Uafhængige evalueringer viser stærkere samlet ydeevne, og officielle standardpriser for input/output-tokens falder med en tredjedel. Opgraderingen kræver dog stadig arbejdsbelastningstests: dybere ræsonnering kan øge opgavelatens og de samlede omkostninger, mens K3 bevarer en lille føring på AA-LCR og har aktuelt tilgængelige vægte til selv-hosting.
Vigtigste pointer
De tydeligste gevinster ses i agentisk eksekvering. Artificial Analysis rapporterer Terminal-Bench 4.0-scorer på cirka 67% for K3.1 Pro mod 13% for K3; Moonshots interne Financial Research-scorer stiger fra 58.8 til 70.4.
Lavere tokenpriser garanterer ikke lavere opgaveomkostninger. Officielle standardpriser for input/output falder fra $3/$15 til $2/$10 pr. million tokens, men ekstra ræsonnering, værktøjskald og retries kan udligne besparelsen.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Kontekstvinduet forbliver det samme. Begge modeller understøtter op til 1,048,576 tokens. K3 ligger en anelse foran i den citerede AA-LCR v1.1-evaluering, så test lang-kontekst-nøjagtighed på dine egne dokumenter.
Tilgængeligheden af vægte kan afgøre valget. Pr. 24. oktober 2026 er K3-vægte tilgængelige; K3.1 Pro-vægte er planlagt til frigivelse senest 4. november. Teams med behov for øjeblikkelig selv-hosting bør indregne denne forskel.
Kimi K3.1 Pro vs Kimi K3: Oversigt og specifikationer
Kimi K3.1 Pro bygger videre på K3 via yderligere eftertræning med forbedringer fokuseret på kodning, finansiel research og udvidede agent-workflows. Begge bevarer cirka én million tokens i kontekst. De vigtigste forskelle er opgaveydelse, tokenpriser, serving-muligheder og tilgængelighed af vægte.
Specifikation
Kimi K3.1 Pro
Kimi K3
Udvikler
Moonshot AI
Moonshot AI
Udgivelsesdato
24. oktober 2026
16. juli 2026
Arkitektur
K3-afledt MoE, yderligere eftertrænet
MoE med KDA, AttnRes
Modelstørrelse
3T-klasse og 104B aktive parametre
2.8T total og 104B aktive parametre
Kontekstvindue
Op til 1,048,576 tokens
Op til 1,048,576 tokens
Standard API-pris for input/output
$2 / $10 pr. million tokens
$3 / $15 pr. million tokens
Highspeed-version
Tilgængelig
Ingen separat K3 Highspeed-variant er angivet
Tilgængelighed af vægte
Frigivelse planlagt senest 4. november 2026
Tilgængelig under Kimi K3-licensen
Tilgængelighed af vægte afspejler information pr. 24. oktober 2026. API-priser er i USD for almindeligt input og output, eksklusive cache-write-gebyrer, skatter og andre relevante afgifter.
Arkitektur og eftertræning
K3 introducerede en arkitektur med 2,8 billioner parametre, der kombinerer Kimi Delta Attention, Attention Residuals og Stable LatentMoE. Den aktiverer cirka 104 milliarder parametre pr. token.
Moonshot beskriver K3.1 Pro som en eftertrænet version af K3 udviklet med væsentligt større eftertræningscompute. Opgraderingen fokuserer på at anvende modellens evner på flertrinsopgaver, herunder værktøjsbrug, debugging og resultatverificering. Annonceringen introducerer ikke en separat navngiven basisarkitektur.
Fælles funktioner og API-krav
Begge modeller understøtter multimodale input, værktøjskald, strukturerede output og kontekstcaching. Billed- og videoformater afhænger af den valgte API-rute. Begge ræsonnerer altid og understøtter low, high og max reasoning effort, hvor max er standard.
For fleromgangssamtaler og værktøjskald skal integrationer bevare komplette assistant-beskeder, inklusive ræsonneringsindhold og værktøjskald, som krævet af API'et. Faktiske kontekstgrænser og funktionsunderstøttelse bør også kontrolleres for den valgte udbyder, produkt og abonnementstype.
Kimi K3.1 Pro vs Kimi K3: Ydeevne
Grundlaget er Moonshots interne tests og rapporterede sammenligninger samt uafhængige tredjepartsevalueringer.
Disse bør tolkes separat, da benchmark-harnesses, testdatasæt, ræsonneringsindstillinger og scoringskriterier kan variere.
Artificial Analysis’ lanceringsevaluering rapporterer en stigning på 11 point på den sammensatte Intelligence Index med særligt store forbedringer i terminalbaseret kodning og agentiske workflows.
Uafhængig benchmark (Artificial Analysis)
Kimi K3
Kimi K3.1 Pro
Forskel
Intelligence Index
44
55
+11
Terminal-Bench 4.0
~13%
~67%
+54 procentpoint
AutomationBench-AA
58%
73%
+15 procentpoint
GDPval-AA Elo
1,534
1,846
+312
AA-Omniscience Index
20
30
+10
Humanity's Last Exam
~47%
~52%
+5 procentpoint
AA-Omniscience hallucination rate
53%
44%
−9 procentpoint
AA-LCR v1.1
88.7%
86.3%
−2.4 procentpoint
Dette er uafhængige evalueringsresultater. Afrundede værdier bruges, hvor evaluator rapporterer afrundede scorer. Lavere hallucinationsrater er bedre.
Den største forbedring ses i terminalbaseret kodning. K3.1 Pro klarer sig markant bedre i opgaver, der kræver kommandoeksekvering, miljøinteraktion, debugging og gentagen validering.
AutomationBench-AA viser også en betydelig gevinst, hvilket tyder på stærkere eksekvering i software-as-a-service-workflows.
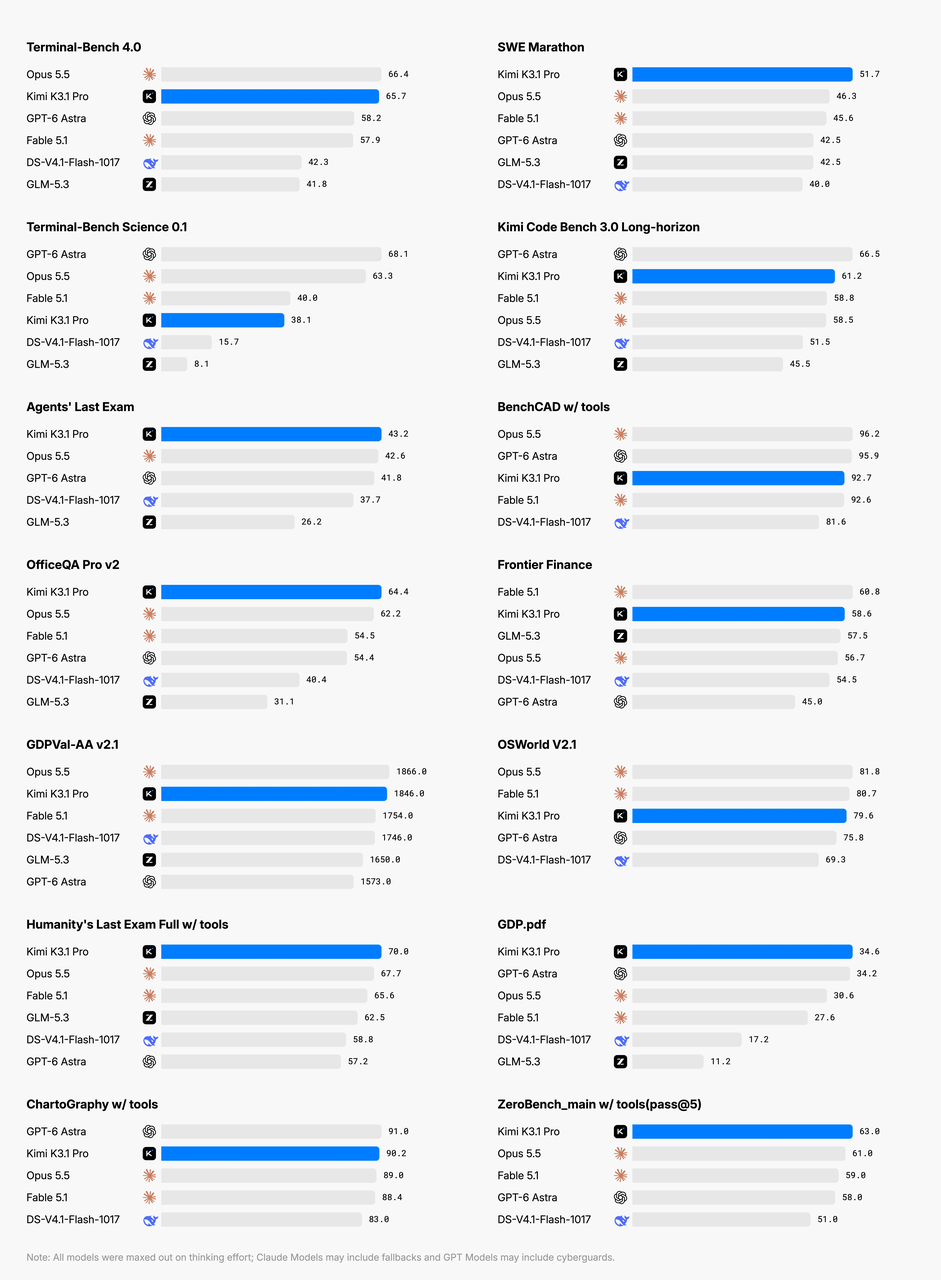
Moonshots udgivelsesbenchmarks fokuserer på kodning, videnskab, 3D-rekonstruktion, finans, vidensarbejde og autonome agenter.
De udvalgte sammenligninger inkluderer Claude Opus 5.5 og GPT-6 Astra. Sammenlign hvert resultat inden for det navngivne benchmark og den angivne konfiguration.
Benchmark (Moonshot AI)
Kimi K3.1 Pro
Anden model
Sammenligningsmodellens score
Terminal-Bench 4.0
65.7%
Claude Opus 5.5
66.4%
Terminal-Bench 4.0
65.7%
GPT-6 Astra
58.2%
SWE-Marathon
51.7%
Claude Opus 5.5
46.3%
Kimi Code Bench 3.0
61.2%
GPT-6 Astra
66.5%
BenchCAD with tools
92.7%
Claude Opus 5.5
96.2%
OfficeQA Pro v2
64.4
Claude Opus 5.5
62.2
Frontier Finance
58.6
Claude Opus 5.5
56.7
OSWorld 2.1
79.6%
Claude Opus 5.5
81.8%
K3.1 Pro nærmer sig eller overgår flere førende proprietære modeller i udvalgte opgaver. Men den dominerer ikke alle kategorier.
For eksempel ligger den stadig efter Claude Opus 5.5 i de leverandørrapporterede BenchCAD- og OSWorld-sammenligninger, og den officielle grafik viser en større svaghed i Terminal-Bench Science.
Evalueringsopsætningerne varierer: Artificial Analysis bruger mini-swe-agent-harnesset til Terminal-Bench 4.0, mens Moonshot bruger Claude Code. Sammenlign scorer inden for samme testopsætning; harnesses, ræsonneringsindsats og runtime-grænser kan påvirke resultaterne.
Kodning og softwareudvikling
Til kompleks autonom kodning er K3.1 Pro generelt det stærkere valg.
Moonshots interne Kimi Code Bench 3.0 Long-horizon-resultater stiger fra 55.95% for K3 til 61.2% for K3.1 Pro, en gevinst på cirka 5.25 procentpoint.
Uafhængige Terminal-Bench-resultater viser også en markant gevinst. Disse tests vurderer flertrins eksekvering: forståelse af et repository, ændring af filer, kørsel af kommandoer, diagnosticering af fejl og verifikation af resultatet.
K3.1 Pro er den stærkere kandidat til udvikling på tværs af flere filer, autonomt terminalarbejde og udvidet debugging. Til simpel kodegenerering bør du sammenligne begge modeller på dine egne opgaver; K3 er stadig det umiddelbare valg, når selv-hosting er påkrævet.
En vigtig skelnen er, at kodningsbenchmarks er stærkt afhængige af agentframeworket. Værktøjer, prompts, runtime-grænser og testmiljøer påvirker udfaldet.
Til produktionssoftwareudvikling er den bedste evaluering stadig en matchet sammenligning på dine egne repositories.
Finansiel research og forretningsdrift
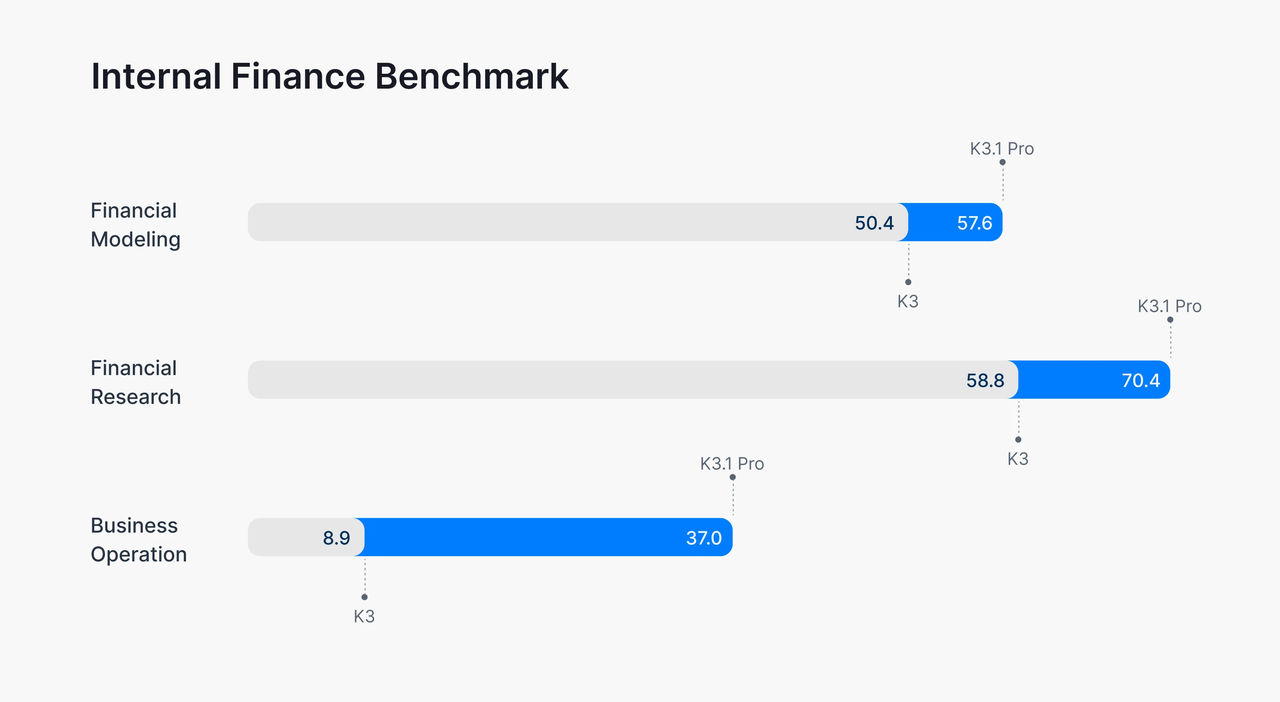
Finansiel modellering giver nogle af de klareste direkte sammenligninger mellem de to modeller.
Moonshot testede både K3 og K3.1 Pro på interne evalueringer, der dækkede regnearksopbygning, forskningskvalitet og simuleret forretningsdrift.
Moonshots interne finansresultater dækker finansiel modellering, research og simuleret forretningsdrift. Disse leverandørrapporterede opgavescorer er ikke mål for investeringsafkast. Indstillinger pr. opgave bør ikke antages at være identiske med uvedkommende benchmarks.
I Moonshots interne tests stiger Financial Modeling fra 50.4 til 57.6, en gevinst på 7.2 point, og Financial Research stiger fra 58.8 til 70.4, en gevinst på 11.6 point. Business Operation stiger fra 8.9 til 37.0, cirka 4.2 gange K3-scoren.
Dette benchmark evaluerer langsigtet styring og beslutningstagning i et simuleret forretningsmiljø. Det er derfor tættere relateret til agentisk planlægning end til simpel finansiel spørgsmål/svar.
Financial Research måler evnen til at producere evidensbaseret research med respekt for kildekrav og informations-cutoffs. Financial Modeling fokuserer på matematiske sammenhænge, regnearkslogik og kvaliteten af arbejdsbogen.
Mønstret antyder, at K3.1 Pro er særligt værdifuld, når finansopgaver kræver vedvarende ræsonnering, verifikation og strukturerede leverancer.
For investorer, analytikere og forretningsbrugere er den praktiske fordel potentielt bedre håndtering af multi-dokument-workflows. Ingen af modellerne bør bruges som uantastelig autoritet for finansielle beslutninger.
Lang-kontekst-ræsonnering og faktuel pålidelighed
AA-LCR-lang-kontekstresultaterne viser dog K3 en smule foran. Dette er en nyttig påmindelse om, at en nyere model kan forbedres væsentligt samlet set uden at vinde hver specialiseret opgave.
De rapporterede evalueringer viser færre faktuelle fejl på deres respektive testdatasæt.
På Kimi Hallu Bench Hard med værktøjer rapporterer Moonshot, at fejlraten på påstandsniveau faldt fra 23.4% for K3 til 8.3% for K3.1 Pro.
Det er cirka en relativ reduktion på 65% på Moonshots bevidst vanskelige stresstest fremfor et estimat af daglige fejlrater. Uafhængigt heraf rapporterer Artificial Analysis et fald i AA-Omniscience-hallucinationsraten fra 53% til 44%. De to evalueringer bruger forskellige metoder, så deres procenter er ikke direkte sammenlignelige.
Den praktiske lære er, at K3.1 Pro fremstår mere pålidelig på de evaluerede opgaver, men faktuelle forbedringer eliminerer ikke behovet for retrieval, kilder, beregningskontrol og menneskelig gennemgang i væsentlige workflows.
Dataanalyse: Evidens fra Plotlys evaluering
Plotly evaluerede standard K3.1 Pro via OpenRouter ved hjælp af en privat test med 43 spørgsmål over et syntetisk vindenergi-datalager. Highspeed blev ikke testet. Resultaterne illustrerer trade-off’et mellem svarkvalitet, gennemføringstid og omkostning i den specifikke SQL-baserede analytiske workflow.
Plotly Data Analytics-mål
Kimi K3
Kimi K3.1 Pro
Korrekte svar
35/43
42/43
Nøjagtighed
81.4%
97.7%
Skjulte mønstre opdaget
0/5
5/5
Identificerede datakvalitetsproblemer
1/3
3/3
Samlet evalueringsomkostning
$5.01
$13.47
Median tid pr. spørgsmål
43 sekunder
2.5 minutter
I denne evaluering besvarede K3.1 Pro flere spørgsmål korrekt og identificerede flere skjulte mønstre og datakvalitetsproblemer, men pådrog højere omkostninger og længere median gennemføringstid.
De rapporterede gebyrer er observerede evalueringsomkostninger, ikke estimater beregnet ud fra Moonshots standard API-priser. Den offentliggjorte opsætning fastslår ikke, at alle udbyderindstillinger var identiske mellem de to kørseler, så forskellene kan ikke alene tilskrives modellen.
Disse resultater underbygger at evaluere K3.1 Pro til analytiske opgaver, hvor ekstra fund kan retfærdiggøre mere tid og forbrug. De fastslår ikke den samme nøjagtighed eller omkostningsforde
Er Kimi K3.1 Pro hurtigere end Kimi K3?
Skeln mellem output-token-gennemløb og end-to-end opgavelatens.
Artificial Analysis rapporterer 73.5 output-tokens i sekundet for K3.1 Pro mod 38.5 for K3 ved maksimal ræsonneringsindsats via Kimis API. Dette er målinger af tokengenerering, kontrolleret 24. oktober 2026; den samlede opgavelatens afhænger også af ræsonneringslængde og værktøjseksekvering.
Men hurtigere tokengenerering garanterer ikke hurtigere opgaveafslutning.
Moonshot tilbyder også K3.1 Pro Highspeed, som markedsføres til at levere cirka to til tre gange hurtigere output end standardvarianten. Dette er en serving-hastighedsforbedring, ikke en separat verificeret intelligensopgradering.
K3.1 Pro har højere rapporteret output-token-gennemløb, men fuldfører ikke nødvendigvis opgaver hurtigere. Skeln mellem hastigheden på generering af tokens og den tid, der kræves for at ræsonnere, kalde værktøjer og afslutte arbejdet.
Output-hastighed vs. opgavegennemføringstid
Artificial Analysis rapporterer output-hastigheder på 73.5 tokens pr. sekund for K3.1 Pro og 38.5 for K3 ved maksimal ræsonneringsindsats via Kimis API. Disse målinger blev kontrolleret den 24. oktober 2026 og beskriver tokengenereringsgennemløb snarere end end-to-end opgavelatens.
En model kan generere tokens hurtigere, men tage længere samlet tid, hvis den producerer flere ræsonneringstokens eller udfører ekstra værktøjskald. I den ovennævnte Plotly-evaluering var K3.1 Pros median gennemføringstid 2.5 minutter pr. spørgsmål mod 43 sekunder for K3, samtidig med højere nøjagtighed.
Til interaktive applikationer bør du måle tiden til første token og den samlede opgavegennemføringstid på den faktiske udbyderrute. Output-gennemløb alene er ikke nok til at forudsige responsivitet.
Overvej K3.1 Pro Highspeed
Moonshot markedsfører K3.1 Pro Highspeed som leverende cirka to til tre gange output-hastigheden af standard K3.1 Pro. Dette vedrører serving-hastighed; det bør ikke tolkes som en to-til-tre-dobling i reduktion af den samlede opgavegennemføringstid.
Overvej Highspeed til interaktiv kodning eller assistenter, hvor brugere venter på svar. Sammenlign end-to-end latens, opgavesucces og samlet debiteret omkostning mod standard-endpointet før valg. Highspeed har højere almindelige input- og output-tokenpriser, mens dens cached-input-pris er den samme.
Kimi K3.1 Pro vs Kimi K3: Omkostninger
Officielle API- og CometAPI-priser
Standard K3.1 Pros officielle input-, output- og cache-hit-priser er en tredjedel lavere end K3’s. De anførte CometAPI-input- og outputpriser er yderligere 20% under de tilsvarende officielle priser.
Model
Officiel input / 1M
Officiel output / 1M
Officiel cached input / 1M
CometAPI input / 1M
CometAPI output / 1M
Kimi K3.1 Pro
$2.00
$10.00
$0.20
$1.60
$8.00
Kimi K3
$3.00
$15.00
$0.30
$2.40
$12.00
Kimi K3.1 Pro Highspeed
$4.00
$20.00
$0.20
Check current quote
Check current quote
USD pr. million tokens; priser kontrolleret 24. oktober 2026. Inputkolonner viser almindelige priser for ikke-cachet input. Skatter og særskilt debiterede gebyrer er udeladt.
Officiel Kimi-prissætning angiver også cache-write-gebyrer: $2/$4 pr. million tokens for standard Pro med 5 minutters/1 times retention og $4/$8 for Highspeed. Cache hits, cache writes og almindeligt input er separate, gensidigt udelukkende debiteringskategorier.
Officiel Kimi og CometAPI er separate udbyderruter. Bekræft aktuelle priser og cache-understøttelse for din valgte rute, inklusive Highspeed-tilgængelighed. Sammenlign samlet debiteret opgaveomkostning såvel som tokenpriser.
Eksempel med fast tokenforbrug
Overvej en arbejdsbelastning, der bruger 100,000 ikke-cachede input-tokens og 20,000 output-tokens.
For denne faste arbejdsbelastning er den officielle API-omkostning $0.60 med K3 og $0.40 med K3.1 Pro. Ved de anførte CometAPI-priser koster de samme tokenmængder henholdsvis $0.48 og $0.32. Disse totaler inkluderer kun de angivne input- og output-tokens.
Men dette er en fast-token-sammenligning. Kompleks agentisk workflow kan forbruge forskellige mængder ræsonneringstokens og værktøjskald afhængigt af modellen.
Tokenbesparelsen forsvinder
Lad I være identisk antal ikke-cachede input-tokens, O være Kimi K3’s debiterede output-tokenantal, og P være Kimi K3.1 Pros debiterede output-tokenantal, alle målt i millioner. Ved de officielle standardpriser i pristabellen er gebyrerne 3I + 15O og 2I + 10P dollars. De er lige store, når P = 1.5O + 0.1I.
For output-tunge forespørgsler kan K3.1 Pro derfor bruge cirka 50% flere debiterede output-tokens, før den mister sin prisfordel. Denne beregning forudsætter uændrede priser og udelukker caching, værktøjsgebyrer og anden særskilt debiteret brug. Brug faktiske debiterede tokenkategorier i stedet for synlig svarlængde.
Omkostning pr. succesfuldt fuldført opgave
Beregn omkostning pr. succesfuld opgave som den samlede debiterede omkostning for alle evalueringsforsøg divideret med antallet af unikke opgaver, der opfylder et foruddefineret acceptkriterium. Inkludér gebyrer fra mislykkede forsøg, retries og timeouts, når udbyderen debiterer dem; at dividere kun omkostningen for succesfulde kørsler med deres antal kan undervurdere omkostning pr. succes.
Hold opgavesættet, acceptkriterier, retry-grænse og timeout-politik faste mellem Kimi K3 og K3.1 Pro. Rapportér succesrate sammen med omkostning pr. succes, så svære opgaver ikke kan fjernes for kunstigt at få en model til at fremstå mere økonomisk. Hvis ingen opgave lykkes, er omkostning pr. succes ikke defineret, ikke nul.
Kimi K3.1 Pro vs Kimi K3: Sammenligning og valg
Til de fleste hostede agentiske arbejdsbelastninger er K3.1 Pro det stærkere udgangspunkt. Beslutningen bør dog afspejle opgavekompleksitet og deployeringskrav.
Anvendelsestilfælde
Anbefalet model
Begrundelse
Autonom kodning
Kimi K3.1 Pro
Evaluer flerfil-ændringer, terminalarbejde, debugging og endelige testudfald.
Multi-dokument finansiel research
Kimi K3.1 Pro
Forbedrede research- og forretningsdrifts-benchmarks
Lavere tokenpris er ikke nødvendigvis lig med lavere opgaveomkostning
Hostet automatisering og professionelle workflows
For hostede kodningsagenter og analytiske workflows bør du evaluere K3.1 Pro på de svære dele af det faktiske arbejde: flerfil-ændringer, evidensindsamling, beregningskontrol og recovery efter et mislykket værktøjskald. Foretræk målte reduktioner i mislykkede opgaver eller korrektivt arbejde frem for en højere overskriftsscore alene.
For etablerede K3-applikationer bør du bevare den eksisterende rute som sammenligningsbaseline. Rutineopgaver kan allerede opfylde accepttærsklen, mens specialiserede lang-kontekst-opgaver kan opføre sig anderledes end de samlede benchmarks. Prioritér de arbejdsbelastningssegmenter, hvor en opgradering har en målbar fordel.
Selv-hosting og deployeringsbegrænsninger
Pr. 24. oktober 2026 er K3s fulde vægte tilgængelige til deployering under modellens licens og hardwarekrav. K3.1 Pros fulde vægte er endnu ikke offentliggjort.
Moonshot planlægger at frigive K3.1 Pro-vægte senest 4. november 2026. Dette er en annonceret frigivelsesplan, ikke et tilgængeligt checkpoint; bekræft de offentliggjorte vægte og gældende vilkår, før du planlægger selv-hosting.
Kriterier for produktionsevaluering
Sammenlign K3 og K3.1 Pro på repræsentative opgaver med de samme prompts, værktøjer, acceptkriterier, retry-grænser og timeouts. Registrér udbyder- og ræsonneringsindstillinger, og bevar komplette assistant-beskeder som krævet af API’et.
Mål opgavesucces, latenstid, tokenforbrug og omkostning pr. succesfuld opgave, inklusive debiterede fejl og retries. Gennemgå tilfælde, hvor K3 lykkes, men K3.1 Pro fejler. For menneskelig evaluering bør du skjule modellabels og randomisere outputrækkefølgen.
Hvis K3.1 Pro opfylder dine tærskler for kvalitet, latenstid og omkostning, så udrul den gradvist med en testet K3-fallback.
Kontrolleret migration og fallbacks
En praktisk tilgang er at begynde med en lille procentdel af produktionstrafikken på K3.1 Pro.
Hold K3 tilgængelig som fallback under validering. Sammenlign opgavekvalitet, latenstid, fejlrater og forbrug, før du øger brugen af K3.1 Pro.
Vær særligt opmærksom på skemaer for værktøjskald, ræsonneringsrelaterede beskedfelter, multimodale input og output-parsing. API-kompatibilitet garanterer ikke automatisk identisk applikationsadfærd.
Benchmark-gevinster og -regressioner
Hvis begge modeller besvarede de samme 43 spørgsmål og scorede 35 og 42, kunne K3.1 Pro have korrigeret syv K3-fejl uden regressioner, eller otte fejl samtidig med at miste ét tidligere korrekt svar. Den samlede score alene kan ikke skelne disse udfald.
Inspicér parrede svar og klassificér dem som begge korrekte, kun K3 korrekt, kun K3.1 Pro korrekt eller begge ukorrekte. Gennemgå K3-only-succeser i forhold til dine mest impactfulde opgaver før migration. Resultatet 42/43 beskriver det testdatasæt; det garanterer ikke en succesrate på 97.7% på en anden arbejdsbelastning.
Blind evaluering af modeloutputs
Skjul modellabels og randomisér den rækkefølge, hvori gennemgåere ser outputs. Definér accepterubrikken før gennemgang: for kode, brug eksekverbare tests og regressionschecks; for research, kontroller kildeunderstøttelse, beregninger og om den ønskede leverance er komplet. Score korrekthed før du overvejer præsentation eller skrivestil.
Afslør først modelidentitet, latenstid og debiteret omkostning efter kvalitetsvurderingen er registreret. Dette adskiller outputkvalitet fra forventninger til den nyere model. Afgør uenigheder blandt gennemgåere efter de samme tests eller kildemateriale, og bevar beslutningerne, så en senere model- eller promptændring kan evalueres konsistent.
Hvor kan du få adgang til Kimi K3.1 Pro og Kimi K3?
Officiel udbyderadgang
Brug Moonshots dokumenterede Kimi K3 API eller Kimi K3.1 Pro API til direkte udbyderintegration. Tjek den valgte endpoints modelidentifikator, understøttede request-felter og kontogrænser. Offentlig API-adgang og downloadbare modelvægte er separate deployeringsmuligheder.
Adgang via CometAPI
Udviklere kan få adgang til Kimi K3.1 Pro API og Kimi K3 API via CometAPIs samlede grænseflade og sammenligne begge ruter med den samme applikationsarbejdsbelastning.
Dette gør K3-til-K3.1 Pro-migration relativt ligetil, især for applikationer, der allerede bruger en OpenAI-kompatibel chatgrænseflade.
For at bruge CometAPI skal du oprette en konto og API-nøgle og derefter konfigurere din applikation med endpoint og modelidentifikator i integrationsdokumentationen. Vælg kimi-k3 til K3, kimi-k3.1-pro til standard K3.1 Pro eller kimi-k3.1-pro-highspeed til Highspeed-ruten, hvor den understøttes. Start med en lille forespørgsel, og sammenlign derefter den samme arbejdsbelastning på tværs af modeller, mens du tjekker returnerede resultater, latenstid og debiteret forbrug.
Konklusion
Kimi K3.1 Pro er den stærkere kandidat til krævende autonom kodning, finansiel research og udvidede agent-workflows i de evalueringer, der er gennemgået her. Kimi K3 er stadig relevant til øjeblikkelig selv-hosting og arbejdsbelastninger, hvor dens eksisterende nøjagtigheds- eller latenstidsprofil allerede opfylder kravene.
Vælg ud fra repræsentative opgaver og den faktiske udbyderrute. Sammenlign succesfulde udfald, latenstid og samlet forbrug, og migrér derefter gradvist. Lavere tokenpriser og højere samlede benchmark-scorer er nyttige udgangspunkter, men de fastlægger ikke den bedste konfiguration for enhver applikation.