Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Muse Wonder, Claude Opus 5.5 og GPT-6 Sol er modeller med høj kapacitet, målrettet kodning og agent-workflows. Metas nye Muse Wonder fremhæver vedvarende hukommelse og vedvarende udførelse; Opus 5.5 fører det citerede samlede intelligensindeks; GPT-6 Sol har de laveste standardpriser for kort-kontekst input og output i denne sammenligning, mens dets lang-kontekst-niveau prissættes separat. Vælg ud fra repræsentativ opgavekvalitet, pålidelighed og totalomkostning frem for en enkelt leaderboard-score.
Vigtigste pointer
Overordnet intelligens: Claude Opus 5.5 scorer 58 mod Muse Wonders 52 på det rapporterede Intelligence Index v4.3.
Langsigtet kodning: Muse Wonder opnår 78.8 på DeepSWE 1.1 og 53.1 på SWE-Marathon; Opus 5.5 registrerer 74.2 og 46.3 i Metas tabel.
Lavpris-ræsonnering: GPT-6 Sol starter ved $2 input / $10 output pr. million tokens via OpenAIs kort-kontekst standard-API.
Hukommelsesfokuserede agenter: Muse Wonder introducerer Active Memory og Active Focus.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Tilgængelighed betyder noget: Muse Wonder Full er et separat, mere begrænset produkt end den udviklervenlige standardudgave af Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol i overblik
Vælg Muse Wonder til vedvarende agenter og langvarig engineering, Claude Opus 5.5 til bred kodning og terminaltunge workflows, og GPT-6 Sol for lavere standardpriser på tokens i kort kontekst.
Beslutningsfaktor
Muse Wonder
Claude Opus 5.5
GPT-6 Sol
Start test med
Vedvarende agenter og udvidet engineering
Terminaltung kodning og professionelle workflows
Budgetfølsom kodning og automatisering
Kontekstvindue
1,048,576 tokens
1M tokens
1,050,000 tokens
Offentliggjorte styrker
DeepSWE 78.8; SWE-Marathon 53.1
Intelligence Index 58; ProgramBench 70.5
Standard input/output $2/$10 per 1M tokens
Standard input/output pr. 1M tokens
$4 / $20
$4 / $20
$2 / $10; kort-kontekst-niveau
Udbyderadgang
Meta Model API; Full er et særskilt abonnementsprodukt
Denne oversigt sammenfatter daterede specifikationer og offentliggjorte resultater gennemgået nedenfor. Benchmark-rækker bruger forskellige evalueringsmetoder, og lave tokensatser giver ikke i sig selv lavere pris pr. vellykket opgave. Standard Muse Wonder og Muse Wonder Full er forskellige adgangsmuligheder.
Specifikationerne blev kontrolleret den 13. oktober 2026. Understøttede modaliteter og funktioner afhænger af det valgte endpoint og udgivelsesflade, inkl. lydtilgængelighed. Modelniveau-kapaciteter garanterer ikke support på enhver gateway-rute.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Oversigt og specifikationer
Muse Wonder: Vedvarende agent-workflows
Meta introducerede Muse Wonder og Muse Wonder Full den 12. oktober 2026. Standardudgaven af Muse Wonder fremhæver langvarige professionelle opgaver, vedvarende agen-hukommelse og genopretning efter forhindringer. Active Memory skal hente nyttig tidligere kontekst, mens Active Focus er designet til at opretholde fremdrift på multitrins arbejde. Meta beskriver kodning, research, finansiel analyse og personlig assistance som nøglescenarier.
Claude Opus 5.5: Professionel kodning og værktøjsbrug
Claude Opus 5.5 er målrettet kodning, ræsonnering og professionelle workflows med flere værktøjer. Anthropic udgav den 22. september 2026. Dets kontekstvindue er på én million tokens, mens de rapporterede kodningsresultater nedenfor viser styrker, der varierer efter benchmark.
GPT-6 Sol: Omkostningsbevidst ræsonnering
GPT-6 Sol sigter mod at kombinere stærk ræsonnering og værktøjsbrug med relativt overkommelig inferens. Den understøtter programatiske workflows via OpenAIs API-økosystem. Dens standard satser for kort kontekst er lavere end de anførte satser for Claude Opus 5.5, men den samlede økonomi afhænger også af genforsøg og forbrug af ræsonneringstokens.
OpenAI beskriver GPT-6 Sol som en model til kompleks kodning og agentiske workflows; dens udgivelsesmeddelelse giver de evalueringsresultater, der bruges nedenfor. Denne artikel sammenligner de angivne modelversioner, ikke alle nyere modeller i hver leverandørs sortiment.
Arkitektur og styring af ræsonnering
De citerede kilder giver ikke en sammenlignelig opdeling af parameterantal og arkitektur for alle tre modeller. Ingen tæt-vs.-mixture-of-experts-rangering er derfor berettiget. Active Memory og Active Focus beskriver Metas agentkapabiliteter; de er ikke substitutter for en oplyst neuralt arkitektur. GPT-6 Sol eksponerer konfigurerbar ræsonneringsindsats, mens rapporterede Meta- og Claude-scorer også afhænger af indsats og evalueringsopsætning. Betragt disse indstillinger som en del af den konfiguration, der sammenlignes, ikke som udskiftelige mål for compute.
Sammenligningsresultat: Alle tre tilbyder store kontekstvinduer og udvikler-API’er. Muse Wonder dokumenterer bredere modelniveau-inputmodaliteter; Opus 5.5 og GPT-6 Sol fremhæver workflows for tekst og billede. Kontekstkapacitet og funktions-tilgængelighed skal stadig tjekkes på det valgte endpoint.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Ydelse
Offentliggjorte benchmarks og kildegrænser
Metas officielle modelkort tilbyder direkte sammenligninger mellem Muse Wonder og Claude Opus 5.5. OpenAI publicerer GPT-6 Sol-resultater separat, så de tre modeller kan ikke placeres på én fuldt kontrolleret leaderboard uden at harmonisere evalueringsharness, versioner og indstillinger.
Benchmark
Muse Wonder
Claude Opus 5.5
Højere score
Artificial Analysis Intelligence Index v4.3
52
58
Opus
Personal Superintelligence Index
54.3
55.2
Opus
Harvey LAB-AA
10.0
4.2
Muse
Vals Finance Agent V2
56.6
58.6
Opus
AutomationBench-AA
39.1
41.2
Opus
JobBench
70.5
75.4
Opus
MemoryBench
85.6
81.5
Muse
Terminal-Bench 4.0-AA
52.0
59.6
Opus
DeepSWE 1.1
78.8
74.2
Muse
SWE-Marathon
53.1
46.3
Muse
ProgramBench
50.0
70.5
Opus
Den officielle modelkortsmetode skelner mellem interne tests, tredjepartsevalueringer og af udbyder rapporterede konkurrent-scorer. Tabellen gengiver de oplyste værdier; den etablerer ikke en ensartet, uafhængigt kontrolleret prøve på tværs af alle rækker.
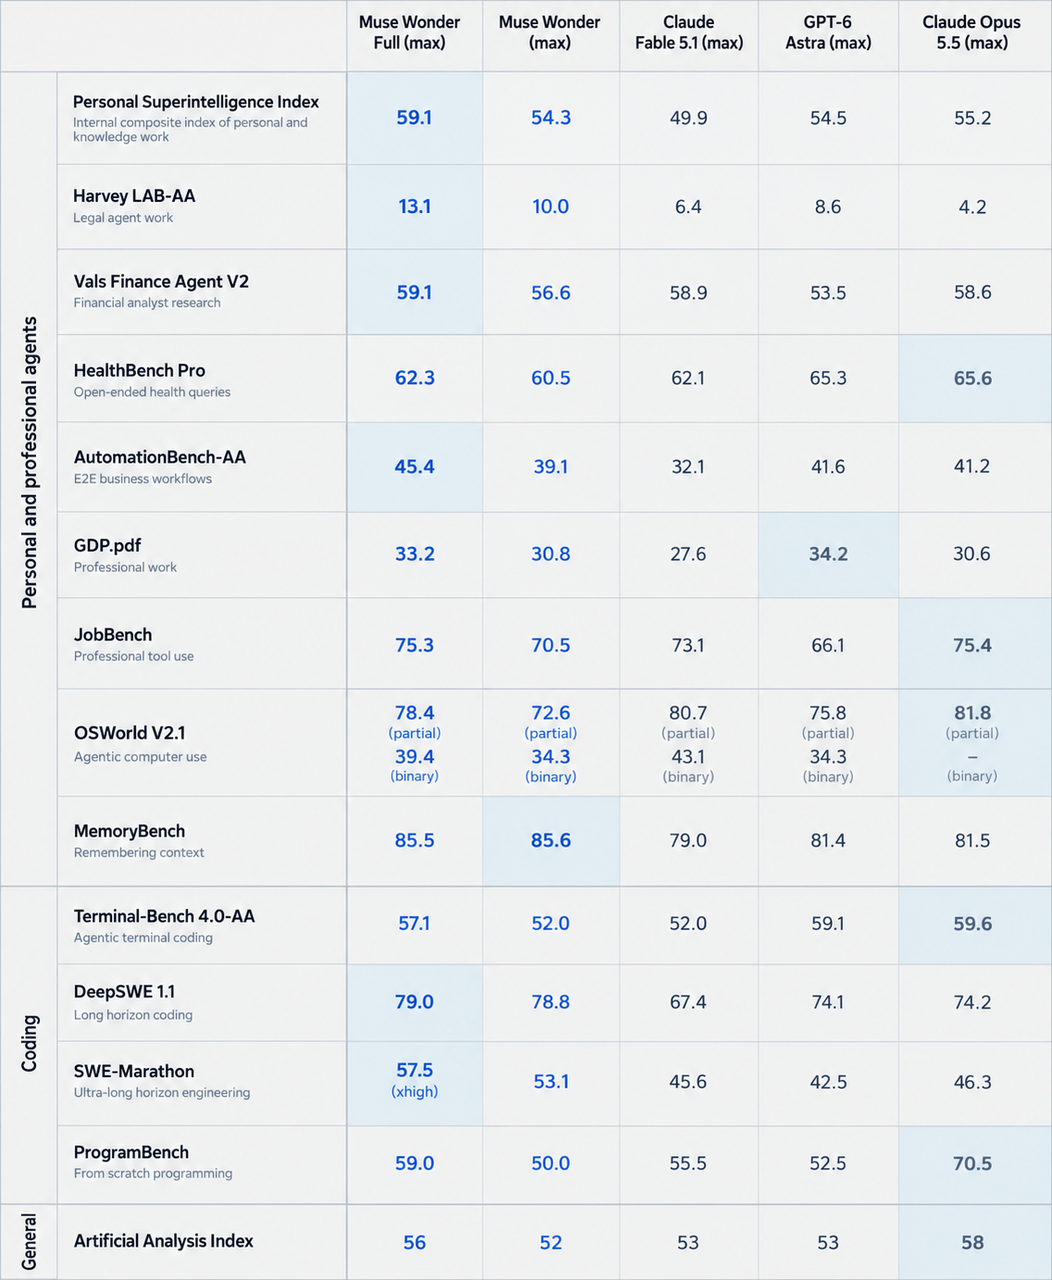
Original benchmark-scorecard fra Metas Muse Wonder-modelkort, gengivet uden at blive tegnet om. Den ekstra OpenAI-model, der vises i dette officielle billede, er GPT-6 Astra, ikke GPT-6 Sol. De omgivende tabeller identificerer de modeller, der er relevante for denne artikel.
Evalueringsbetingelser
DeepSWE v1.1 dækker 113 opgaver på tværs af 91 repositories og fem sprog, bedømt med funktions- og regressionstests ved brug af pass@1; Metas scorecard bruger Datacurve-resultater for Muse Wonder og Opus 5.5. SWE-Marathon bruger projekttests og rapporterer pass@1 fra Abundant AI; agent-harness varierer, og Wonder Fulls score er markeret xhigh. ProgramBench bruger mini-swe-agent og måler rollouts, der består mindst 95% af skjulte tests, med internet deaktiveret efter opsætning. MemoryBench er Metas interne 64K–100K-token samtaletest bedømt af en LLM-dommer. Disse miljøer og metrikker bør ikke sammenfoldes til én generel nøjagtighedsscore.
Kodning og software engineering
Muse Wonder fører på de rapporterede DeepSWE 1.1- og SWE-Marathon-resultater. Claude Opus 5.5 fører på Terminal-Bench 4.0-AA og ProgramBench. Denne opdeling antyder, at langhorizon-engineering, kommandolinjeværktøjer og programrekonstruktion presser forskellige færdigheder.
GPT-6 Sol-resultater og sammenlignelighed på tværs af kilder
Offentliggjort OpenAI-evaluering
GPT-6 Sol
Rapporteret indstilling
DeepSWE 1.1
68.8%
Maximum reasoning
AutomationBench 1.0.6
33.2%
xhigh reasoning
Agents' Last Exam V1
56.4%
Maximum reasoning
OSWorld 2.0 offline
60.5%
xhigh reasoning
OpenAIs offentliggjorte evalueringsresultater rapporterer ovenstående scorer. Dets OSWorld-resultat er delvis belønning på det offline sæt v2026.08.08 snarere end en streng opgavefuldførelsesrate. OpenAI bemærker, at evalueringerne brugte dets forskningsmiljø eller API; produktionskonfigurationer kan afvige.
De rapporterede DeepSWE-scorer antyder en forskel på 10,0 procentpoint mellem Muse Wonder og GPT-6 Sol og 5,4 point mellem Opus 5.5 og GPT-6 Sol. Dette er aritmetiske forskelle mellem publikationer, ikke kontrollerede estimater af en model-only fordel. Forskellige agentopsætninger, prompts, indsatsniveauer og værktøjsbudgetter kan påvirke resultatet.
Hukommelse og langvarige agenter
Muse Wonder er målrettet agenter, der skal huske tidligere beslutninger, genoprette kontekst og fortsætte afbrudt arbejde. Active Memory kan hjælpe en forskningsassistent med at huske projektspecifikke fakta, mens Active Focus understøtter iterativ handling, når en tidligere plan ikke lykkes. Disse produktegenskaber erstatter ikke tilstandsverifikation, tilladelser, revisionsspor eller obligatorisk menneskelig bekræftelse for følsomme handlinger.
Muse Wonder Full-ydelse
Muse Wonder Full er en separat produktmulighed. Meta tilbyder standard Muse Wonder via sin API, mens Full er begrænset til Power Usage- og Maximum Usage-abonnementer i Muse Code. En højere score gør ikke Full til en API-erstatning for standardmodellen.
Metas rapporterede Wonder Full-resultater er 56 på Intelligence Index, 59.1 på Personal Superintelligence, 13.1 på Harvey LAB-AA og 45.4 på AutomationBench-AA. Den scorer også 79.0 på DeepSWE 1.1, 57.5 på SWE-Marathon, 85.5 på MemoryBench og 75.3 på JobBench. Disse offentliggjorte resultater beskriver det separat tilgængelige Full-produkt; de er ikke nye målinger fra en fælles-harness sammenligning.
Sammenlignet med standard Muse Wonder-scorerne ovenfor forbedrer Full syv af disse otte rapporterede mål; MemoryBench er en smule lavere med 85.5 mod 85.6. Opus 5.5 fører fortsat det rapporterede Intelligence Index med 58.
Latens og pålidelighed
Det citerede materiale giver ikke en matchet tre-model latenssammenligning. Mål tiden til første nyttige output, median og 95%-percentil end-to-end opgavetid, timeout-frekvens og fuldførelse uden intervention. Hold opgaveinput, værktøjstilladelser, samtidighed og acceptkriterier faste; registrér indsatsindstillinger og genforsøgsbudgetter. Hurtigere tokengenerering alene etablerer ikke hurtigere fuldførelse af en multitrins opgave.
Sammenligningsresultat: Muse Wonder fører de citerede tests for vedvarende engineering, mens Opus 5.5 fører de citerede terminal- og programrekonstruktions-tests. GPT-6 Sol forbliver en kandidat med lavere tokensatser, men de tilgængelige publikationer beviser ikke en kvalitets- eller hastighedsrangering i lige miljø på tværs af alle tre.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Omkostninger
Officielle API-tokenpriser
Pris pr. 1M tokens
Muse Wonder
Claude Opus 5.5
GPT-6 Sol
Standard input
$4
$4
$2
Standard output
$20
$20
$10
Cachet input
$0.20
$0.20
$0.20
Input i lang kontekst
$4
$4
$4
Output i lang kontekst
$20
$20
$15
Cachet input i lang kontekst
$0.20
$0.20
$0.40
Meta publicerer $4 input, $20 output og $0.20 cachet input pr. million tokens. Anthropic angiver Opus 5.5 til $4 input, $20 output og $0.20 cache-hits pr. million tokens. OpenAIs pristabel angiver GPT-6 Sol til $2/$10 for kort-kontekst input/output og $4/$15 for lang kontekst; satser for cachet input varierer også efter niveau. Anvend det relevante kontekstniveau pr. forespørgsel, behandlingsmode og endpoint-betingelser før du estimerer en arbejdsbelastning.
For GPT-6 Sol bliver forespørgsler med mere end 272,000 inputtokens faktureret til højere satser:
Inputtokens: 2× standardsatsen, stigende fra $2 til $4 pr. million tokens.
Cachede inputtokens: 2× standardsatsen, stigende fra $0.20 til $0.40 pr. million tokens.
Outputtokens: 1.5× standardsatsen, stigende fra $10 til $15 pr. million tokens.
Disse højere satser gælder for hele forespørgslen, ikke kun de tokens, der overstiger 272,000. En forespørgsel med 272,001 inputtokens går derfor ind i lang-kontekst prisniveau for alle dens input-, cachede input- og outputtokens.
Til sammenligning pålægger Muse Wonder og Claude Opus 5.5 ikke en tilsvarende prispræmie for lang kontekst under deres standard API-satser.
Denne forskel er særlig vigtig for analyse af store dokumenter, kodning på tværs af hele repositories og langvarige AI-agenter, hvor GPT-6 Sols prisfordel i kort kontekst kan indsnævres, efterhånden som forespørgsler bliver større.
CometAPI-priser og faktureringsbetingelser
På anmeldelsestidspunktet listede CometAPI Opus 5.5 til $3.20 input / $16 output og GPT-6 Sol til $1.60 input / $8 output pr. million tokens. Dette er CometAPIs uafhængige satser og må ikke forveksles med de officielle udbyderpriser ovenfor. Bekræft den gældende rute, kontekstniveau og kontofaktureringsbetingelser før omkostningsestimering; priser og betingelser kan ændre sig.
Omkostning pr. accepteret opgave
Beregn omkostning pr. accepteret opgave som samlet faktureret model- og værktøjsforbrug, inkl. takserede genforsøg og fallbacks, divideret med antallet af outputs, der opfylder foruddefinerede acceptkriterier. Registrér menneskelig gennemgangstid separat eller konverter den med en eksplicit lønsats. Spor mislykkede forespørgsler og faktiske opkrævninger uafhængigt: Fejl i sig selv fastslår ikke, om en forespørgsel blev faktureret.
Sammenligningsresultat: GPT-6 Sol har de laveste opførte standardpriser for kort-kontekst input og output, mens Muse Wonder og Opus 5.5 deler de samme opførte basissatser. Faktiske omkostninger pr. accepteret opgave afhænger af den valgte faktureringsrute, cachebrug, kontekstniveauer, værktøjsgebyrer, genforsøg og gennemgangsindsats.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Sammenligning og udvælgelse
Udvælgelse baseret på kapabilitet og arbejdsbyrde
Til bred kodning og terminal-workflows: start med Claude Opus 5.5, fordi den fører de citerede Intelligence Index-, Terminal-Bench- og ProgramBench-resultater. Validér den på refaktorering, værktøjseksekvering og programniveau-konsistens.
Til udvidede engineering-projekter: start med Muse Wonder, fordi dens rapporterede DeepSWE- og SWE-Marathon-resultater er stærkere end Opus 5.5’s. Mål opgavefuldførelse, genopretning fra forhindringer og samlede opgaveomkostninger.
Til vedvarende personlige agenter: start med Muse Wonder, fordi den tilbyder Active Memory og Active Focus og har en højere rapporteret MemoryBench-score end Opus 5.5. Test recall, korrektioner, kontinuitet og projektafsondring.
Til multitrins værktøjs-workflows: evaluer alle tre modeller. Muse tilbyder Active Focus, Opus fremhæver værktøjsorkestrering, og GPT-6 Sol understøtter Responses API-værktøjer. Sammenlign hele agentstakken, inkl. værktøjstilladelser, genforsøg og tilstandshåndtering.
Til professionelle dokumenter og analyser: evaluer Muse Wonder eller Claude Opus 5.5. Muse har specialiserede styrker, mens Opus har det stærkere citerede samlede indeks. Brug repræsentative dokumenter og opgavespecifikke acceptkriterier.
Til højvolumen og omkostningsfølsom automatisering: start med GPT-6 Sol, fordi den har de laveste opførte standardpriser for kort kontekst. Tjek omkostning pr. accepteret opgave, kontekstniveauer, latens og genforsøg.
Til Metas højeste ende: evaluer Muse Wonder Full, hvis det er tilgængeligt. Den har højere rapporterede scorer på flere specialiserede opgaver, men er adskilt fra standard API-modellen. Bekræft abonnementsadgang og egnethed før test.
Professionel kodning
Claude Opus 5.5 er et godt udgangspunkt for teams, der kræver en bred engineering-assistent, særligt hvor værktøjseksekvering, refaktorering og konsistens på programniveau er vigtige. Dens rapporterede fordele på Terminal-Bench og ProgramBench styrker den vurdering, selvom teams bør validere hele agentstakken og ikke kun modellen.
Automatisering i høj volumen
GPT-6 Sol er attraktiv, når forespørgslerne er mange, og omkostningsfølsomheden er høj. Selv en beskeden kvalitetsforskel kan være acceptabel for lavrisiko-opgaver, der let kan kontrolleres, såsom at udkaste dokumentation, udtrække strukturerede felter eller forklare kode. For lange autonome forløb bør kvalitet, tokens, latens og genforsøg spores samlet.
Tjekliste til produktionsevaluering
Produktionsevaluering bør spore seks metrikker: korrekthed, målt ved accepterede svar eller beståede tests; pålidelighed, målt ved opgaver fuldført uden menneskelig redning; latens, målt ved end-to-end opgavetid; tokenforbrug, målt ved samlet faktureret input og output; agenteffektivitet, målt ved værktøjskald og korrigerende genforsøg; og effektiv omkostning, beregnet som samlet forbrug divideret med accepterede opgaver.
Sammenligningsresultat: Sæt Muse Wonder på shortlisten til vedvarende agent- og udvidet engineering-arbejde, Opus 5.5 til brede kodnings-workflows med stærke terminalkrav, og GPT-6 Sol når tokensats er en væsentlig begrænsning. Forfrem en kandidat først, når den opfylder opgavespecifikke kvalitets- og pålidelighedstærskler.
Hvor kan du få adgang til Muse Wonder, Claude Opus 5.5 og GPT-6 Sol?
Officiel adgang via udbyder
Brug Meta Model API til standard Muse Wonder, Anthropic API til Opus 5.5 eller OpenAI API til GPT-6 Sol. Muse Wonder Full er tilgængelig via de angivne Muse Code-abonnementsplaner snarere end som en drop-in erstatning for standard API-modellen. Tjek konto-adgang, brugsgrænser og understøttede forespørgselsfunktioner for den rute, du vælger.
Adgang via CometAPI
En samlet gateway kan forenkle autentificering, fakturering og routing. Brug en model med højere ydeevne til kompleks arkitekturgennemgang og en billigere model til gentagende, lavrisiko udkast. Modelidentifikator og understøttet forespørgselsformat skal altid tjekkes mod det målrettede API-endpoint.
Udviklere kan tilgå Claude Opus 5.5 API i CometAPI og GPT-6 Sol API i CometAPI for at evaluere repræsentative arbejdsbelastninger. Bekræft den understøttede API-overflade for hver model, i stedet for at antage at en delt gateway gør alle forespørgselsformater udskiftelige.
De CometAPI-ruter, der citeres i denne artikel, dækker Opus 5.5 og GPT-6 Sol. Denne artikel etablerer ikke en CometAPI-rute for Muse Wonder eller Wonder Full; brug den bekræftede udbyderrute, når du evaluerer disse produkter.
Konklusion
Ingen enkelt model vinder på alle arbejdsbelastninger. Muse Wonder er den stærkeste kandidat at teste for vedvarende agentadfærd og langvarige engineering-opgaver. Claude Opus 5.5 er en stærk kandidat til bred kodning, terminaltunge workflows og vidensarbejde, og den fører den værdi på Artificial Analysis Intelligence Index, som Meta rapporterer. GPT-6 Sol tilbyder de laveste standardpriser for tokens i kort kontekst og er attraktiv for omkostningsfølsom automatisering. Produktionsteams bør foretage det endelige valg ud fra accepteret opgavekvalitet, pålidelighed, latens, genforsøg, værktøjsbrug og samlede omkostninger på repræsentative arbejdsbelastninger.
FAQ
Hvordan kan teams teste Muse Wonder, Opus 5.5 og GPT-6 Sol retfærdigt?
Brug et holdt-out sæt af reelle opgaver med faste acceptkriterier, identiske inputartefakter og dokumenterede værktøjstilladelser. Registrér hver modelversion, indsatsindstilling, agent-harness, timeout og tokenbudget. Kør gentagne forsøg, hvor outputs varierer, rapportér fejl såvel som succeser, og adskil en sammenligning i fælles-harness fra en sammenligning af bedst-konfigurerede systemer. Dette giver evidens, der gælder for jeres workflow, frem for et andet teams benchmark-opsætning.
Kan en API-gateway bevare agenttilstand ved skift mellem modeller?
En delt gateway-adresse garanterer ikke i sig selv portabel samtaletilstand, værktøjskalds-identifikatorer eller gemte svarreferencer. Bevar en kanonisk applikationsside-registrering af beskeder, værktøjsoutput og valideret opgavetilstand. Test hver routes tilstands- og værktøjssemantik, før du router et igangværende job til en anden model; ellers kan en billigere fallback miste information, der er nødvendig for at afslutte korrekt.
Hvordan bør teams budgettere for genforsøg og menneskelig gennemgang?
Definér et accepteret resultat før test, og divider derefter samlet faktureret model- og værktøjsforbrug med accepterede resultater. Rapportér gennemgangsarbejde separat eller inkluder det med en angivet timeløn. Tæl mislykkede forsøg, korrigerende kald og fallback-modeller, og sammenlign både typiske og høj-omkostnings opgaver. Dette undgår at behandle en lavere tokensats som en garanteret reduktion i prisen på nyttigt arbejde.
Hvad bør en evalueringsprocedure for hukommelsesfølsomme agenter omfatte?
Test om agenten husker relevante fakta, indarbejder korrektioner, ignorerer forældede instruktioner og holder separate projekter isoleret. Inkludér forsinkede opfølgninger og modstridende opdateringer i stedet for kun en enkelt lang prompt. Tjek hukommelsesadfærd på applikationsniveau såvel som på modelniveau, fordi persistens, hentning og sletning afhænger af det implementerede system.
Output
Tekst
Tekst
Tekst
Særfunktion
Active Memory og Active Focus
Værktøjer og underagenter
Konfigurerbar ræsonneringsindsats og API-værktøjer