
TL;DR
Meta lancerede Muse Wonder og Muse Wonder Full den 12. oktober 2026. Wonder er tilgængelig via Meta Model API og Muse Code, mens Full er tilgængelig i Muse Code gennem abonnementerne Power Usage og Maximum Usage. Full fører på flere offentliggjorte benchmarks, men det praktiske valg afhænger af API-adgang, opgavekvalitet og omkostninger. Denne sammenligning gennemgår offentliggjorte kilder og omfatter ikke uafhængig hands-on testning.
Key Takeaways
- Wonder understøtter API-integration; Full er tilgængelig gennem Muse Code-abonnementerne Power Usage og Maximum Usage.
- Metas lanceringsgraf rapporterer Artificial Analysis Intelligence Index-scorer på 52 for Wonder og 56 for Full. Forskellen på fire point repræsenterer ikke en universel procentvis forbedring i opgaveydelse.
- Wonder understøtter et kontekstvindue på 1,048,576 tokens og input i tekst, billede, lyd, video og PDF med tekstoutput.
- Metas standard API-takster er $4 input, $0.20 cached input og $20 output pr. million tokens; Full har ingen offentlig per-token Model API-takst.
- Maksimal ræsonneringsindsats vælger ikke Full. Start med Wonder til applikationer; evaluer Full til krævende interaktivt arbejde i Muse Code.
Muse Wonder vs Muse Wonder Full: Overview and Specifications
Start med Wonder, når du har brug for en model, der kan kaldes til et produkt eller en automatiseret arbejdsgang. Evaluer Full, hvis du bruger Muse Code, og dens benchmark-styrker er relevante for dine opgaver. Adgang kræver et Power Usage- eller Maximum Usage-abonnement og er fortsat underlagt planbegrænsninger. Den praktiske forskel er først adgang, dernæst benchmark-ydelse.
Tabellen opsummerer specifikationerne, offentliggjorte resultater og kommercielle vilkår, der diskuteres nedenfor. Modaliteter på modelniveau garanterer ikke identisk understøttelse på alle endpoints. Den kontekstgrænse, der er angivet i Fulls modelkort, er ikke en offentlig API-kontrakt.
Begge varianter sigter mod kompleks kodning samt personlig og professionel agentisk arbejde. De vigtigste dokumenterede forskelle er deres offentliggjorte ydeevne og adgangsmuligheder: Wonder er tilgængelig via Meta Model API og Muse Code, mens Full er tilgængelig gennem kvalificerede Muse Code-abonnementer.
Muse Wonder for Programmable Workflows
Meta introducerede Muse Wonder-modelfamilien som frontier AI-systemer til personlige og professionelle agentiske arbejdsgange med fokus på vedvarende ræsonnering, værktøjsbrug, software engineering og svært vidensarbejde.
Muse Wonder er standardmodellen, der er tilgængelig via Metas Model API og Muse Code. Den er velegnet til udviklere, der designer kodeassistenter, dokumentanalyse, multimodale systemer og langvarige agenter. Dens API-grænseflade muliggør direkte arbejdsbelastningsmåling, brugsfakturering og integration i produktionssoftware.
Muse Wonder Full for Demanding Interactive Work
Muse Wonder Full er en mere kapabel variant optimeret til særligt krævende arbejdsgange. Metas egne lanceringsmaterialer associerer den med professionel analyse og langhorisont-kodning. Ved lancering er adgang knyttet til kvalificerede Muse Code-abonnementsplaner frem for en separat prissat offentlig API.
API-specifikationen dokumenterer Wonders multimodale input, præcis kontekstgrænse og indstillinger for ræsonnering. Full har en familie-niveau modelkortbeskrivelse, men ingen tilsvarende offentlig API-kontrakt. Delte familieegenskaber etablerer ikke identiske endpoint-parametre eller produkt-uploadgrænser.
Active Memory, Active Focus, and Reasoning Settings
Meta beskriver Active Memory og Active Focus som to mekanismer designet til at bevare nyttig kontekst og opretholde målrettet fremdrift gennem svære opgaver. De eliminerer ikke behovet for applikationsniveau-verifikation, tilladelser eller menneskelig overvågning.
At sætte Wonder til maksimal ræsonneringsindsats gør den ikke til Wonder Full. Skellet er et model-adgangsskel, ikke blot en knap i en forespørgsel.
Muse Wonder vs Muse Wonder Full: Performance
Published Benchmarks and Source Boundaries
Full fører på det rapporterede kompositindeks, men benchmark-scorer måler ydeevne på udvalgte evalueringer, ikke en universel procentvis forbedring. Sammenlign samme benchmarkversion, inferensindstillinger og evalueringsdato, før du drager konklusioner for produktion.
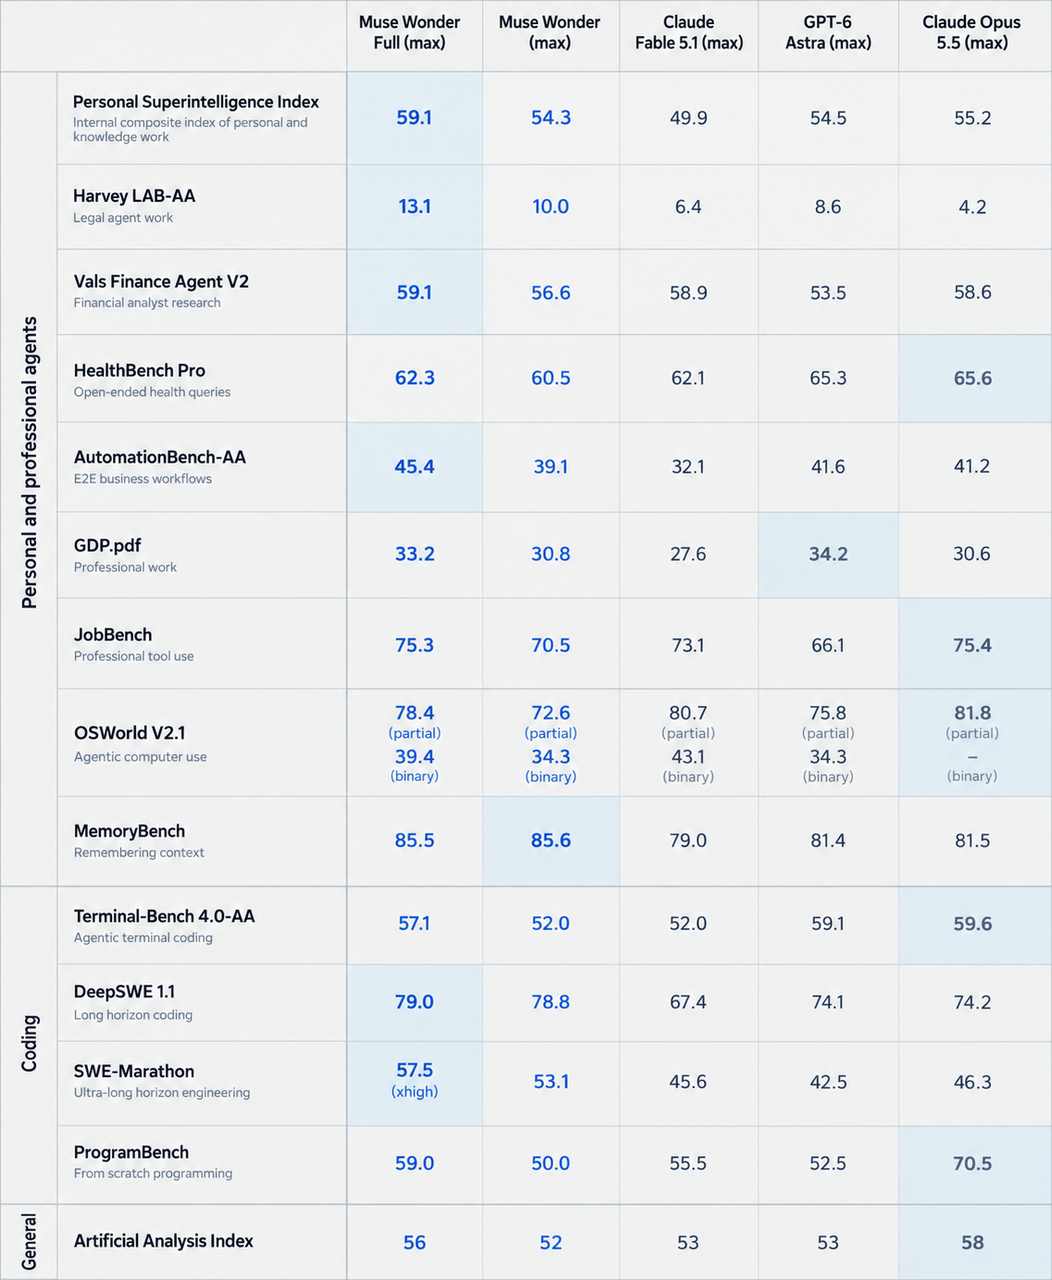
Officielt Meta-modelkort scorecard, gengivet uden omtegning. Den ledsagende metodik identificerer resultatkilder og indstillinger.
Evaluation Conditions
Metas evalueringsmetodik bruger maksimal ræsonnering, medmindre andet er angivet. SWE-Marathon anvender leverandør-rapporterede miljøer snarere end en kontrolleret fælles harness på tværs af alle modeller. Dette er tredjepartsresultater opsummeret af Meta; de er ikke fire ensartet kontrollerede interne tests. Udgivelsessnapshot er 12. oktober 2026 og ikke en live leaderboard.
DeepSWE måler langhorisont-arbejde i repositories ved hjælp af funktionelle og regressionstests. MemoryBench måler recall i samtaler på 64K–100K tokens med en LLM-dommer. Disse scorer vurderer forskellige adfærd og bruger forskellige bedømmelsessystemer. Den rapporterede MemoryBench-forskel på 0,1 point er for lille til at understøtte en praktisk rangering uden information om evalueringsvarians.
Coding and Software Engineering
Full ligger foran på de citerede koderesultater, men størrelsen af forskellen varierer: DeepSWE adskiller sig med 0,2 point, SWE-Marathon med 4,4 og Terminal-Bench med 5,1. Dette mønster understøtter test af Full på svært, udstrakt arbejde; det viser ikke, at enhver kodegennemgang eller kort implementering kræver Full. API-tilgængelighed er fortsat en separat implementeringsbegrænsning.
Memory and Long-Running Agents
Full fører ikke på alle rapporterede mål. MemoryBench er 85,5 for Full og 85,6 for Wonder i det officielle scorecard. Betragt det næsten dødt løb som en grund til at teste faktisk hukommelsesadfærd, inklusive korrigerede fakta, forældede instruktioner og projektaisolation. Evaluer Active Focus gennem end-to-end fuldførelse og genopretning fra mislykkede trin i stedet for at antage, at et højere kompositscore garanterer bedre vedholdenhed.
Latency and Reliability
De citerede materialer etablerer ikke en matchet latensrangering mellem Wonder API og Full i Muse Code. Mål tiden til nyttigt output, median og 95.-percentil opgavetid, timeout-frekvens, genforsøg og fuldførelse uden menneskelig redning. Registrer værktøjer, ræsonneringsindstilling, runtime og opgavegrænser for hver overflade, så en produktniveau-sammenligning ikke præsenteres som et udelukkende modelvægt-eksperiment.
Muse Wonder vs Muse Wonder Full: Cost
Official API Prices and Subscription Units
Meta offentliggør standard Wonder API-takster på $4 input, $0.20 cached input og $20 output pr. million tokens. Full bruger en abonnementsadgangsmodel, så samme token-prisberegning gælder ikke for den.
Metas Power Usage- og Maximum Usage-planer inkluderer både Wonder og Full i Muse Code. Fordele og tilgængelighed kan variere efter region, så tjek det aktuelle tilbud og kontoens kvote, før du budgetterer. Disse abonnementer giver begrænset interaktiv brug; de omfatter ikke ubegrænsede produktions-API-kald.
Token-omkostningseksempel: 100,000 ikke-cached input-tokens koster $0.40, og 20,000 output-tokens koster $0.40, i alt $0.80. Et flertrins agentkørsel kan medføre yderligere tokenforbrug på tværs af forespørgsler plus værktøjsgebyrer.
Meta angiver web search grounding til $2.50 pr. 1,000 søgeforespørgsler ud over token-gebyrer.
CometAPI Billing Conditions
Muse Wonder er tilgængelig via CometAPI med kontospecifik, rute-niveau prissætning. Bekræft input, output, cached input og andre faktureringsvilkår separat fra Metas listepriser, før du sender produktionstrafik. Pr. 16. oktober 2026 er Wonder Full markeret Coming soon, så denne listing er hverken en tilgængelig API-rute eller et pristilbud eller en frigivelsesforpligtelse.
Cost per Accepted Task
Definér et accepteret leverancekriterium, før du måler omkostning. Divider den samlede fakturerede model- og værktøjsudgift, inklusive debiterede genforsøg og fallbacks, med accepterede leverancer. Registrér review-arbejde separat eller anvend en eksplicit timetakst. For Full skal du også spore nyttigt arbejde udført inden for abonnementskvoten. Månedlige gebyrer og per-token-takster er forskellige enheder, så en sammenligning af deres overskriftspriser alene kan ikke identificere den billigste arbejdsgang.
Muse Wonder vs Muse Wonder Full: Comparison and Selection
Capability and Workload-Based Selection
Vælg Muse Wonder til produktions-API-integration, batch-dokumentbehandling, custom-agenter og reproducerbare A/B-tests. Dens kaldbare API og brugbaseret fakturering lader dig automatisere arbejdsgange, inspicere værktøjsadfærd, køre regressionstests og måle omkostning pr. accepteret opgave. Start her, når implementeringskontrol og reproducerbarhed er centrale krav.
Vælg Muse Wonder Full til kompleks interaktiv refaktorering og professionel analyse i Muse Code, forudsat at du har et kvalificerende abonnement. Dens rapporterede benchmark-styrker gør den til en kandidat til svære, udstrakte opgaver; test om den reducerer korrektioner og gennemgangstid på dit eget arbejde, og bekræft at abonnementskvoten passer til din arbejdsbyrde.
Application and Automation Workflows
Muse Wonder er et fornuftigt valg til repository Q&A, scriptet kodegennemgang, dokumentekstraktion, retrieval-baserede assistenter og custom-agenter. Dens API-adgang lader teams overvåge latens, spore værktøjsadfærd, automatisere regressioner og fastsætte omkostningslofter.
Til en tjeneste eller batch-pipeline skal du først evaluere den understøttede Wonder API-rute. Den giver applikationen eksplicit kontrol over forespørgsler, værktøjsudførelse, genforsøg og måling. Hvis opgaven afhænger af funktioner, der kun er tilgængelige i Muse Code, skal du evaluere den som en separat interaktiv arbejdsgang med sine egne driftsbegrænsninger.
Interactive Coding and Professional Analysis
Full er værd at evaluere til lange kodningssessioner, refaktorering på tværs af flere filer og kompleks professionel analyse i Muse Code, givet dens højere scorer på flere offentliggjorte benchmarks. Adgangsbegrænsninger betyder, at disse fordele ikke automatisk kan overføres til produktions-API-applikationer.
Brug repræsentative refaktoreringer, undersøgelser og færdige artefakter til at teste, om Full reducerer korrigerende iterationer eller review-indsats. Bekræft den faktiske abonnementskvote, før du gør den til en afhængighed for tilbagevendende arbejde. Hvis forbedringen er lille på dine opgaver, opfylder standardvarianten muligvis allerede accepttærsklen.
Production Evaluation Criteria
Til en praktisk evaluering bør du indsamle mindst tre typer beviser: end-to-end opgavefuldførelse, kvaliteten af det færdige artefakt og samlet forbrug inkl. genforsøg og menneskelig gennemgang. En føring på fire point i kompositten kan have betydning for en kompleks agent, mens den giver lille observerbar forskel i en simpel klassifikationsopgave.
Where Can You Access Muse Wonder and Muse Wonder Full?
Official Provider Access
Brug Meta Model API til standard Wonder eller få adgang til den i Muse Code. Full kræver et kvalificerende Muse Code-abonnement; at sætte standardmodellen til max effort ændrer ikke den valgte variant. Bekræft den præcise kontoentitlement, understøttede forespørgselsfunktioner og brugsgrænser før test.
CometAPI-integration er adskilt fra adgang til Wonder Full via Muse Code. Et Muse Code-abonnement bør ikke antages at give et genanvendeligt produktions-API-legitimationsoplysning eller ubegrænset throughput.
CometAPI Access
Udviklere kan få adgang til Muse Wonder API i CometAPI. Muse Wonder Full API i CometAPI er markeret Coming soon pr. 16. oktober 2026; den status etablerer hverken en lanceringsdato eller et kaldbart endpoint. Bekræft kontoens prissætning og understøttede felter før implementering.
Til CometAPI-forespørgsler skal du bruge den modelidentifikator, der er dokumenteret for din valgte rute. Før du starter et flertrinsjob, skal du tjekke understøttede beskedformater, værktøjssemantik og tilstandshåndtering. Bevar valideret opgavetilstand i applikationen, så en ruteændring ikke stiltiende kasserer oplysninger, der er nødvendige for at afslutte arbejdet.
Conclusion
Muse Wonder og Muse Wonder Full er nært beslægtede, men kommercielt og operationelt forskellige. Wonder tilbyder en dokumenteret, multimodal, lang-kontekst API til at bygge applikationer; Full tilbyder stærkere rapporteret ydeevne, men snævrere interaktiv adgang. Betragt kompositscoren som nyttig evidens, ikke en universel beslutningsregel. Test den version, du faktisk kan implementere, op imod dine egne opgaver, begrænsninger, latens og omkostninger.
FAQ
How should teams compare Muse Wonder API with Full in Muse Code?
Brug samme repository-snapshot, opgaveinstruktioner, acceptancetests og bedømmelsesrubrik. Registrér hver overflades værktøjsadgang, ræsonneringsindstilling, forløbet tid, genforsøg og menneskelig intervention. Betragt resultatet som en arbejdsgangssammenligning: API-agenten og Muse Code kan tilbyde forskellige værktøjer og eksekveringssløjfer, så en kvalitetsforskel kan ikke automatisk tilskrives modelvægte alene.
What happens when a Muse Wonder Full subscription reaches its limit?
Metas abonnementsregler kræver, at brugere opgraderer eller venter på en opfriskning efter at have nået en grænse; Maximum Usage-abonnenter skal vente på reset. Yderligere API-nøgler faktureres separat på pay-as-you-go-basis, og Full tilbydes ikke via den offentlige Model API. Planlæg interaktivt arbejde omkring kontoens faktiske kvote i stedet for at antage, at et abonnement giver ubegrænset throughput.
Can Muse Wonder API persist business records across independent requests?
Brug ikke en familie-niveau hukommelsesfunktion som erstatning for et applikationsdatastore. Hvis en opgave har brug for holdbare poster, så bevar dem eksplicit, hent relevant materiale og send det gennem den understøttede forespørgselsgrænseflade. Test isolation, retention og hentning på den faktiske udbyderrute; modellens kontekstkapacitet alene etablerer ikke persistens på tværs af forespørgsler.
How should teams estimate the cost of a Muse Wonder agent task?
Mål input, cached input og output-forbrug på tværs af hele værktøjssløjfen, inklusive mislykkede forsøg og genforsøg. Læg værktøjsgebyrer og menneskelig gennemgangstid til og sammenlign omkostning pr. accepteret leverance. For Full skal du spore færdiggjort arbejde og tidsforbrug i forhold til abonnementskvoten. Tokenpriser og månedlige abonnementsgebyrer beskriver forskellige indkøbsenheder, så ingen af dem fastlægger alene den billigere arbejdsgang.