Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Gemini 4 Carbon er Google DeepMind’s frontier-model til krævende ingeniørarbejde og defensiv cybersikkerhed. Annonceret den 28. oktober 2026, og den forbedrer Argon på publicerede kodnings-, sikkerheds- og langkontekst-evalueringer. Introduktionspriserne er $2 pr. million input-tokens og $10 pr. million output-tokens, men adgangen er indledningsvis begrænset til udvalgte cyberforsvarere og betroede partnere. For udviklere er muligheden stærkere autonomt arbejde; den umiddelbare begrænsning er adgang.
Vigtigste pointer
Gemini 4 Carbon er Googles næste frontier-model efter Argon, optimeret til vedvarende, flerdages agentisk ingeniørarbejde og cybersikkerhedsforsvar.
Gemini 4 Carbon ligger som nr. 1 på Artificial Analysis Intelligence Index v5.0 (score 59), foran Claude Opus 5.5 (58) og GPT-6 Astra (57). Stærke fremskridt i kodning, full-stack webudvikling (+89 Elo på WebDev Arena til nr. 4), videnskabelig ræsonnering, multimodal forståelse og alignment (0,0 % succes på Gray Swan Indirect Prompt Injection Benchmark).
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
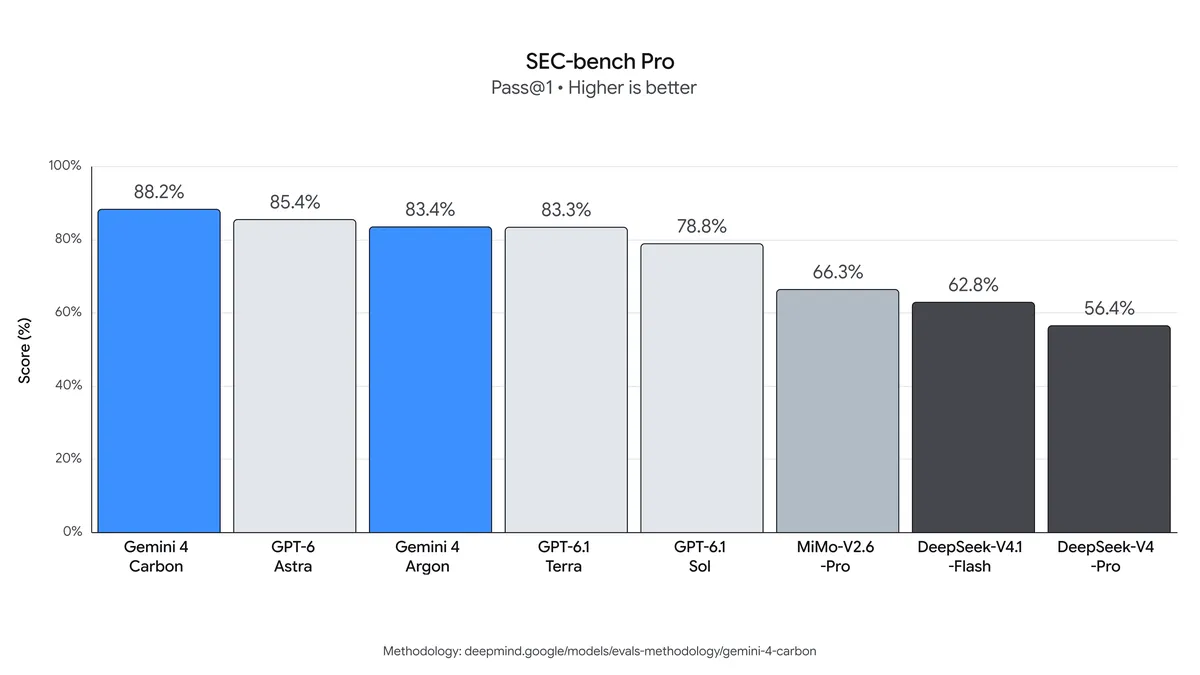
Fremragende cybersikkerhedsresultater (uden guardrails): 88.2% på SEC-bench Pro (finding vulnerabilities), 54.8% på ExploitGym (exploitation) og 71.0% på CWE-bench (patching).
Begrænset initial adgang via Fairwind Program for cyberforsvarere; offentlig API og bredere udrulning kommer senere.
Samme introduktionspriser som Argon; efter introperioden gælder standardtakster.
Platforme som CometAPI understøtter allerede den bredere Gemini-familie (inklusive Argon) via en samlet OpenAI-kompatibel API, hvilket gør det let at skifte modeller og forberede sig på Carbons bredere frigivelse. Offentlige API-detaljer og en bred lanceringsdato er ikke annonceret pr. 29. oktober 2026.
Hvad er Gemini 4 Carbon?
Gemini 4 Carbon er Googles nyeste flagskibs-frontier AI‑model, designet til at håndtere komplekst softwareingeniørarbejde, cybersikkerhedsforskning og autonome arbejdsgange.
Ifølge den officielle annoncering bygger Carbon på fundamentet fra Gemini 4 Argon, med betydelige forbedringer i kodning, agentisk ræsonnering og sikkerhedsfokuserede opgaver.
Carbon er designet til arbejde, der omfatter undersøgelse, udførelse og verifikation på tværs af flere trin. En defensiv ingeniøragent kan f.eks. inspicere et repository, validere en mistænkt sårbarhed i et isoleret miljø, udvikle en patch og teste, om ændringen adresserer den oprindelige fejl.
Google rapporterer, at deres interne teams har observeret, at Carbon arbejder sig igennem komplekse ingeniøropgaver over flere dage. Dette er interne observationer og ikke en publiceret garanti for en bestemt autonom køretid. Google har ikke frigivet en fuld teknisk rapport, parameterantal eller detaljeret arkitektur. Kontekstvindue og outputgrænser forventes at ligne eller forbedre Argons (rapporteret i multi-million-token-området med høj outputkapacitet), og den understøtter multimodale input, herunder tekst, billeder, video, lyd og PDF’er.
Hvad er de vigtigste funktioner i Gemini 4 Carbon?
Langsigtet software engineering
Carbon er designet til ingeniørproblemer, der ikke kan gennemføres pålideligt i et enkelt ræsonneringstrin.
Eksempler omfatter root cause‑analyse på tværs af store repositories, afhængighedsrelaterede fejl, low-level systemdebugging og kompleks refaktorering.
Forbedringerne sigter mod evnen til at fortsætte arbejdet efter et mislykket forsøg.
En effektiv kodningsagent skal kunne genkende, når den første løsning fejler, inspicere nye beviser og revidere sin tilgang uden at drive væk fra den oprindelige opgave.
Defensive cybersikkerhedsarbejdsgange
Carbons sikkerhedsresultater spænder over at finde sårbarheder, validere udnyttelighed og rette fejl. Det nyttige spørgsmål for et sikkerhedsteam er, om en agent kan bevæge sig fra et mistænkt problem til et reproducerbart fund og en testet rettelse, mens den respekterer de tilladelser og det miljø, den får tildelt.
Lang-kontekst og multimodal forståelse
Carbon registrerer en GraphWalks BFS F1-score på 96.2% i 256K–1M-token-undermængden, op fra Argons 84.2%. Dette er bevis for langkontekst graf‑ræsonnering snarere end en garanti for korrekt hentning fra et hvilket som helst dokument på en million tokens.
De publicerede Chartography- og Blueprint-Bench 2‑resultater dækker også visuel forståelse. Disse tests kan hjælpe med at identificere lovende dokument- og diagram‑workflows, men de fastlægger ikke den komplette modalitetsskema for en fremtidig offentlig API.
Hvordan klarer Gemini 4 Carbon sig på benchmarks?
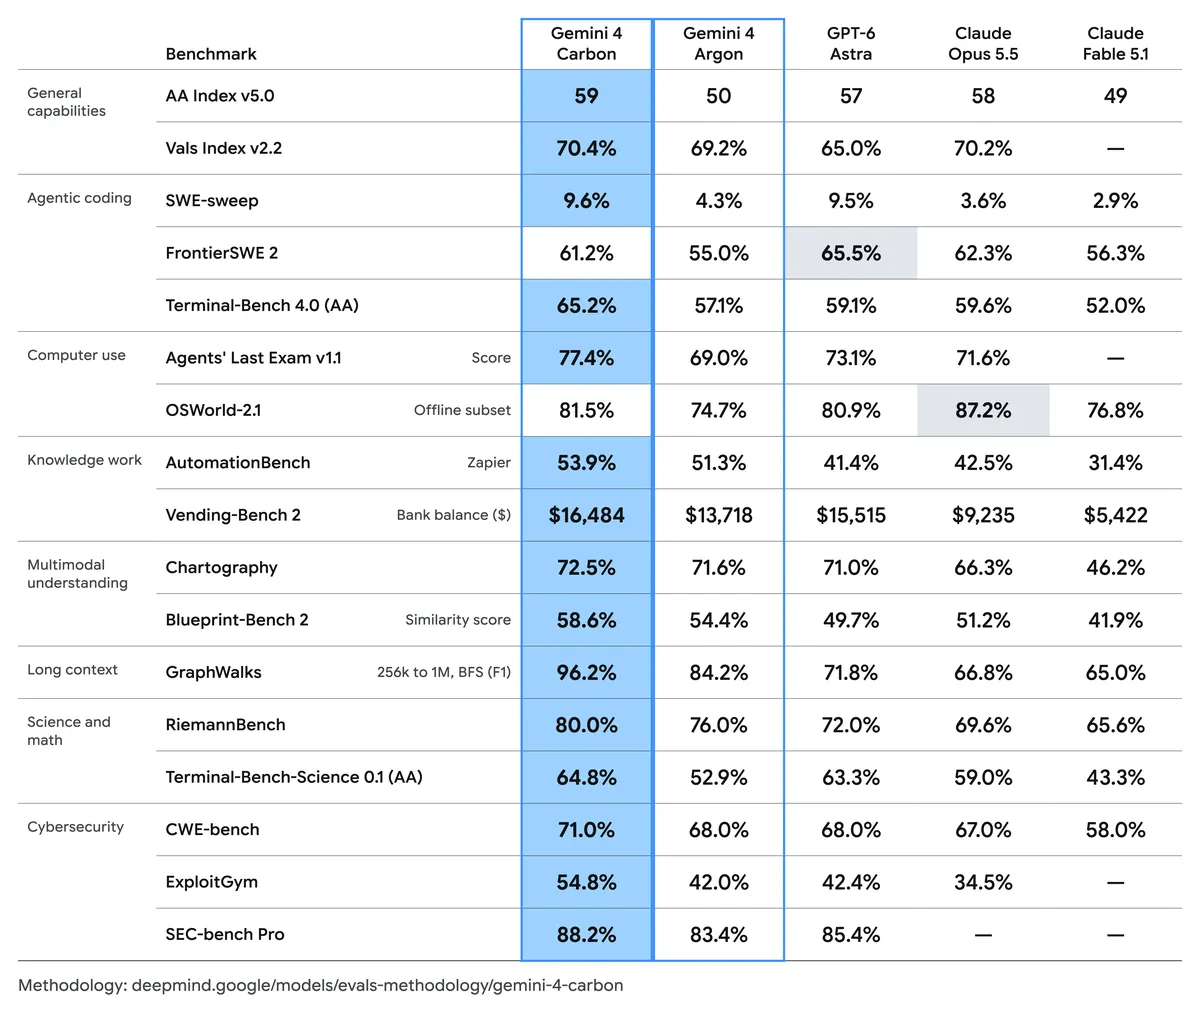
De publicerede resultater fremhæver tre grunde til at evaluere Carbon: stærkere kodningspræstation, bedre langkontekst‑ræsonnering og forbedringer på tværs af cybersikkerhedsarbejdsgangen. Den officielle annoncering inkluderer det originale sammenligningsdiagram nedenfor; de vigtigste resultater er opsummeret i det følgende afsnit.
Vælg benchmarks, der ligner din egen arbejdsbyrde. En model, der fører en generel intelligensindeks, kan stadig være bagefter en anden model på en bestemt ingeniøropgave.
Benchmarkresultater og testbetingelser
Overordnet ræsonnering: Carbon scorer 59 på AA Intelligence Index v5.0, sammenlignet med 50 for Argon, 57 for GPT-6 Astra og 58 for Claude Opus 5.5.
Kodning: Terminal-Bench 4.0 stiger fra 57.1% til 65.2%, en forbedring på 8,1 procentpoint i forhold til Argon. SWE-sweep stiger fra 4.3% til 9.6%.
Langkontekst-ræsonnering: Carbon scorer 96.2% på GraphWalks 256K–1M-token BFS F1‑undersættet, op fra Argons 84.2%.
Hvor alternativer fører: GPT-6 Astra scorer 65.5% på FrontierSWE 2 mod Carbons 61.2%; Claude Opus 5.5 scorer 87.2% på OSWorld offline-undersættet mod Carbons 81.5%. Disse sammenligninger refererer til modellerne og evalueringsindstillingerne i det publicerede diagram.
På tværs af de 17 udvalgte resultater i den oprindelige sammenligning fører Carbon i 15. Den bredde gør den til en lovende kandidat til komplekse workflows, men de to undtagelser viser, hvorfor din egen opgavemiks betyder noget. Sammenlign modeller på accepterede resultater, gennemførelsestid og omkostninger frem for at gennemsnitliggøre urelaterede benchmarkscorer.
Evalueringsmetoden bruger generelt den højeste thinking‑indstilling og pass@1, medmindre andet er angivet. Den kombinerer Google‑kørte resultater med eksterne evaluatorer og udbyder‑rapporterede scorer, så agent‑skaffolding og ræsonneringsbudgetter er ikke identiske på hver post.
GraphWalks: Den citerede undermængde bruger 200 problemer og rapporterer BFS F1.
Agents’ Last Exam: Evalueringen bruger et 122-opgave v1.1‑sæt, ALE-Claw‑harness, et vindue på fem timer og aktiverede sikkerhedsfiltre.
OSWorld: Det rapporterede resultat dækker en 82-opgave offline‑undersæt og tager maksimum over tre enkeltforsøg.
Kodningspræstation i praksis
Carbon forbedrer Terminal-Bench 4.0 fra 57.1% til 65.2%, en gevinst på 8,1 procentpoint. SWE-sweep stiger fra 4.3% til 9.6%, mere end en fordobling af scoren, om end stadig under 10% i absolutte tal. Disse resultater understøtter evaluering af svære repository‑opgaver og viser samtidig, hvorfor uafhængige tests og review fortsat er nødvendige.
Hvor stærk er Gemini 4 Carbon til cybersikkerhed?
Benchmark og sikkerhedsopgaver
Gemini 4 Carbon
Gemini 4 Argon
Forskel
SEC-bench Pro — sårbarhedsopdagelse
88.2%
83.4%
+4,8 procentpoint
ExploitGym — validering af udnyttelse
54.8%
42.0%
+12,8 procentpoint
CWE-bench — afhjælpning af sårbarheder
71.0%
68.0%
+3,0 procentpoint
Den største gevinst er i validering af udnyttelse. For et autoriseret defensivt team kan reproducerbare beviser for, at en sårbarhed kan udnyttes, forbedre prioriteringen; et plausibelt fund alene er ikke nok. Patches skal stadig have tests, der bekræfter, at den oprindelige fejl er rettet, og at eksisterende funktionalitet er bevaret.
Google rapporterer de eksterne sikkerhedsevalueringer uden implementerede guardrails. SEC-bench Pro bruger en specifik 183‑opgave JavaScript‑engine‑split; ExploitGym bruger et enkeltforsøg offline‑setup med mitigations slået fra. Disse betingelser fastlægger ikke ubegrænset produktionsadfærd eller en detektionsrate for vilkårlig software i den virkelige verden.
Er Gemini 4 Carbon sikrere og mere pålidelig end Argon?
Uunderstøttede påstande faldt med cirka 50 % i forhold til Argon i interne test.
Agent‑overreach faldt med 26 %.
Under‑service faldt med 29 %.
Høj‑alvorlige misalignment‑alarmer faldt med næsten 80 % i interne kodningsmiljøer.
Succesfuld snyd på Terminal-Bench 4.0 faldt til 0.0% i Googles evaluering.
På den evaluerede Gray Swan‑benchmark for indirekte prompt‑injektion er Carbons angrebssuccesrate 0.0% mod Argons 0.7%. Det betyder, at de evaluerede angreb ikke lykkedes under den opsætning; det fastlægger ikke immunitet over for nye angreb eller andre miljøer med værktøjer.
Disse tal stammer fra forskellige evalueringer og bør ikke kombineres til en enkelt pålidelighedsscore.
For en produktionsagent bør du bevare uafhængige tilladelseskontroller, eksekveringslogge og validering af påståede resultater. En models forbedrede adfærd hjælper, men applikationen skal stadig styre, hvilke filer, tjenester og handlinger den kan få adgang til.
Hvad koster Gemini 4 Carbon API’et?
Google har annonceret Carbons introduktions- og efterfølgende token‑takster. Tallene for cachet input nedenfor er beregnet ud fra den annoncerede 95 % rabat; detaljer om den offentlige API‑implementering og berettigelse afventer stadig.
Fakturakategori, USD pr. 1M tokens
Introduktionspris
Efterfølgende pris
Input-tokens
$2.00
$4.00
Output-tokens
$10.00
$20.00
Berettigede cachede input-tokens
$0.10
$0.20
Carbons introduktionsperiode har ingen annonceret slutdato. Argons publicerede introduktionspriser slutter 30. november 2026; den deadline gælder ikke for Carbon. Batch‑priser, ekstra værktøjsgebyrer og en gratis plan er ikke annonceret for Carbon.
Eksempel på omkostning for en anmodning
Antag, at en anmodning bruger 200,000 ikke‑cachede input-tokens og 10,000 samlede fakturérbare output-tokens. Med de annoncerede introduktionspriser koster input $0.40 og output $0.10, i alt $0.50. Det samme token‑forbrug ville koste $1.00 ved de efterfølgende takster.
Hvis alle 200,000 input-tokens kvalificerer til den annoncerede rabat for cachet input, bliver introduktionsestimatet $0.12 inklusive output. Dette er en betinget illustration, ikke et løfte om, at hvert gentaget input kvalificerer.
Output‑kvoten skal inkludere eventuelle thinking‑tokens, der faktureres som output under de endelige gældende regler. Hvis 10,000 kun henviser til det synlige svar, vil yderligere fakturérbare thinking‑tokens øge estimatet. Værktøjer, genforsøg og andre tjenester er udelukket.
Hvordan kan udviklere forberede sig på Gemini 4 Carbon API’et?
Nuværende tilgængelighed for Gemini 4 Carbon API
Pr. 29. oktober 2026 begynder adgangen med udvalgte cybersikkerhedsforsvarere og udvides gradvist til betroede partnere. Googles Fairwind Program beskriver en kontrolleret adgangsvej. En bred udviklerudgivelsesdato og offentlig Carbon‑modelidentifikator er ikke annonceret.
Annoncerede priser betyder derfor ikke, at en applikation kan kalde en generelt tilgængelig Carbon‑API i dag. Dens endelige offentlige kontekstgrænse, maksimale output, modalitetsskema, værktøjskompatibilitet og driftsgrænser mangler stadig dokumenterede produktionsspecifikationer.
Pr. 29. oktober 2026 har Google endnu ikke lanceret en generelt tilgængelig Carbon‑API, så Carbon er endnu ikke tilgængelig via CometAPI. Mens du venter, kan du bruge Gemini 4 Argon til en indledende evaluering. Tjek CometAPI Carbon‑siden for tilgængelighed og udbyderpriser, når adgangen åbner.
Alternativer, mens du venter på Carbon API’et
Du kan begynde at evaluere din kodnings‑workflow, før Carbon bliver bredt tilgængelig. Byg en baseline med en model, du har adgang til i dag, og sammenlign derefter Carbon på de samme opgaver, når dens API åbner. Tre muligheder at overveje er Gemini 4 Argon, GPT-6.1 Astra og Claude Opus 5.5; bekræft det præcise modelnavn, adgang og pris hos din udbyder, før du vælger en rute.
Gemini 4 Argon: Start her, hvis du allerede bruger Gemini, eller ønsker en direkte baseline for Carbon. Prøv repræsentative repository‑ændringer, code reviews og bug‑rettelser, og registrér hvilke outputs der består dine accepttests.
**GPT-6.1 Astra:** Medtag den som en cross‑udbyder‑sammenligning for de samme ingeniøropgaver. Mål accepterede rettelser, gennemførelsestid og samlede omkostninger. De GPT-6 Astra‑resultater, der blev diskuteret tidligere, gælder den benchmarkede version og bør ikke behandles som GPT-6.1 Astra‑scorer.
**Claude Opus 5.5:** Tilføj den som endnu en kandidat til repository‑analyse, refaktorering og review. Brug de samme opgavebeskrivelser og valideringskriterier, så du kan sammenligne den praktiske værdi af hvert resultat.
Hold dit modelvalg konfigurerbart, og gem prompts, testcases og resultater fra hver kørsel. Det giver dig et nyttigt udgangspunkt for at evaluere Carbon uden at binde din workflow til et uannonceret API‑format.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Forbered et workflow til modelevaluering
En praktisk evalueringsramme bør måle mere end generel svarkvalitet.
For kodnings- og sikkerheds‑workflows omfatter nyttige metrikker:
Opgavefærdiggørelsesrate: Hvor ofte opfylder agenten foruddefinerede accepttests?
Rettelseskorrekthed: Adresserer det foreslåede ændringsforslag den oprindelige fejl uden at ødelægge eksisterende adfærd?
Falsk-positiv-rate: Hvor ofte mislykkes en rapporteret problemstilling i valideringen?
End-to-end-latenstid: Hvor lang tid tager den fulde arbejdsgang, inklusive værktøjseksekvering?
Samlet opgaveomkostning: Hvor meget koster hvert accepteret resultat efter genforsøg og værktøjsbrug?
Instruktionsoverholdelse: Holder agenten sig inden for autoriserede filer, værktøjer og handlinger?
Brug et fast sæt reelle opgaver, og gem en registrering af hver model, dens indstillinger, tokenforbrug og testresultater. Inkludér genforsøg og manuelle rettelser i omkostningen. Når Carbon bliver tilgængelig, skal du køre den samme evaluering for at se, om den leverer mere accepteret arbejde for din tid og dit budget.
Konklusion
Gemini 4 Carbon er en lovende opgradering til krævende kodning, langkontekst‑ræsonnering og defensivt sikkerhedsarbejde. Dens publicerede resultater viser klare gevinster over Argon, mens adgangen pr. 29. oktober 2026 fortsat er begrænset. Etabler indtil videre en baseline med en tilgængelig model og hold din integration fleksibel. Når Carbons offentlige API åbner, skal du sammenligne kvaliteten af færdiggjort arbejde, sparet tid og samlede omkostninger, før du beslutter, om du vil skifte.
FAQ
Kan Gemini 4 Carbon køre uden menneskelig overvågning?
Rapporter om internt flerdages ingeniørarbejde fastlægger ikke ubemandet pålidelighed for vilkårlige opgaver. Et team, der overvejer autonom eksekvering, bør definere tilladte handlinger, stopbetingelser og accepttests og derefter måle, hvor ofte agenten fuldfører arbejdet uden korrektion. Køretid alene viser ikke, at en agents output er korrekt.
Kan en eksisterende Argon‑integration skifte direkte til Carbon?
Ikke på baggrund af den foreliggende dokumentation. Hold udbydervalget konfigurerbart, men verificér Carbons faktiske modelidentifikator, understøttede skema, værktøjer, grænser og kontoadgang, før du ændrer en deployment. Genbrug af en prompt kan hjælpe med en kontrolleret sammenligning; det beviser ikke API‑kompatibilitet.
Hvilke Gemini 4 Carbon‑tests er relevante for en privat kodebase?
Inkludér repræsentative bugs, repository‑ændringer og sikkerhedsfund med kendte acceptkriterier. Tjek om patches består relevante tests, om fund kan reproduceres, og om uvedkommende adfærd ændres. Inkludér mislykkede forsøg og manuel korrektion i omkostningsanalysen, så en stærk offentlig benchmarkscore ikke skjuler operationelt arbejde.