Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Die besten GPT-6 Astra API-Alternativen: Preise, Benchmarks und Anwendungsfälle
Die besten GPT-6 Astra API-Alternativen, einschließlich Claude Opus 5, Claude Fable 5.1, GPT-5.6 Sol, Gemini 3.8 Flash, Claude Sonnet 5 und DeepSeek V4.1 Flash
TL;DR: Welche GPT-6 Astra API-Alternative sollten Sie wählen?
Wählen Sie das Modell entsprechend der Workload: Claude Opus 5 als nächstliegender Premium-Ersatz, Claude Fable 5.1 für die härteste, anhaltende Reasoning-Arbeit, GPT-5.6 Sol für die reibungsärmige OpenAI-Migration, Claude Sonnet 5 für die Produktion mit hohem Volumen, Gemini 3.8 Flash für kostengünstige multimodale Aufgaben und DeepSeek V4.1 Flash, wenn die Tokenkosten die primäre Einschränkung sind.
Behalten Sie GPT-6 Astra für Workloads, bei denen seine stärkere Computer-Nutzung, autonome Ausführung, wissenschaftliches Reasoning oder Cybersicherheitsleistung Wiederholversuche und menschliche Eingriffe materiell reduziert.
Wichtigste Erkenntnisse: Was zählt beim Ersetzen von GPT-6 Astra?
GPT-6 Astra ist bei seinen stärksten Agentenaufgaben schwer zu ersetzen. Die offizielle GPT-6 Astra Benchmark-Tabelle verzeichnet 57,9 % auf Terminal-Bench 4.0, 97,6 % auf FrontierMath Tier 4 und 96,0 % auf GPQA Diamond.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Claude Opus 5 ist die ausgewogenste direkte Alternative für den ersten Test. Anthropic bepreist Opus 5 mit $5/$25 pro Million Eingabe-/Ausgabe-Token, also der Hälfte von Astras Basistarifen.
Claude Fable 5.1 ist keine Budget-Alternative. Die Preisgestaltung von $10/$50 für Eingabe/Ausgabe entspricht Astras Headline-Rate, während ausgewählte Wissens- und Long-Horizon-Reasoning-Evaluierungen Fable 5.1 begünstigen.
GPT-5.6 Sol ist eher ein einfacher Downgrade als ein echter Plattformwechsel. Das 1,05M-Kontextfenster, 128K maximale Ausgabe und $4/$20 senken die Migrationshürde für OpenAI-Anwendungen.
Gemini 3.8 Flash bietet ein starkes Preis/Leistungs-Verhältnis im gehosteten Betrieb. Der Einführungstarif 2026 beträgt $0,75/$3,75 pro Million Eingabe-/Ausgabe-Token.
DeepSeek V4 Flash liegt in einer anderen Preisklasse. Die offiziellen Haupt- und Nebenzeiten-Tarife liegen weit unter Premium-Preisen, aber niedrigere Tokenkosten belegen nicht die gleiche Agenten-Erfolgsquote.
Die beste Produktionskennzahl ist meist die Kosten pro akzeptiert abgeschlossener Aufgabe. Berücksichtigen Sie Wiederholversuche, Tool-Fehler, Latenz, Ausgabetoken-Nutzung und menschliche Nacharbeit.
Was ist die GPT-6 Astra API?
OpenAI positioniert GPT-6 Astra als Flaggschiffmodell für komplexe End-to-End-Arbeit. Die API-Spezifikation umfasst ein Kontextfenster mit 1.050.000 Tokens und 128.000 Tokens maximale Ausgabe, Text- und Bildeingaben, Reasoning-Token-Unterstützung sowie fünf Einstellungen für den Reasoning-Aufwand: low, medium, high, xhigh und max.
Astra unterscheidet sich von einem herkömmlichen Chatbot, da es für langlaufende Ausführungen konzipiert ist. Die offizielle Fähigkeitsübersicht betont Computer-Nutzung und professionelle Arbeit, neben Softwareentwicklung, Browsing, Wissenschaft, Cybersicherheit und komplexem Reasoning.
werden für die gesamte Anfrage mit $20/M Eingabe und $75/M Ausgabe neu bepreist. Budgetieren Sie diese Anfragen separat.
Warum Teams über GPT-6 Astra hinausblicken
Astra ist besonders überzeugend, wenn seine zusätzlichen Fähigkeiten fehlgeschlagene Versuche, Toolfehler, manuelle Eingriffe oder wiederholte Aufrufe schwächerer Modelle eliminieren. Seine Premiumpreise sind jedoch schwerer zu rechtfertigen für Zusammenfassung, Extraktion, Klassifikation, Routine-RAG, normalen Chat und Standard-Codegenerierung.
Teams evaluieren daher Alternativen, um Kosten zu senken, im vorhandenen Providerekosystem zu bleiben, die Cache-Effizienz zu verbessern, Multimodalität hinzuzufügen oder ein schnelleres Modell für Routineverkehr zu nutzen, während Astra für Eskalationen reserviert bleibt.
Benchmark-Vergleich und Einschränkungen
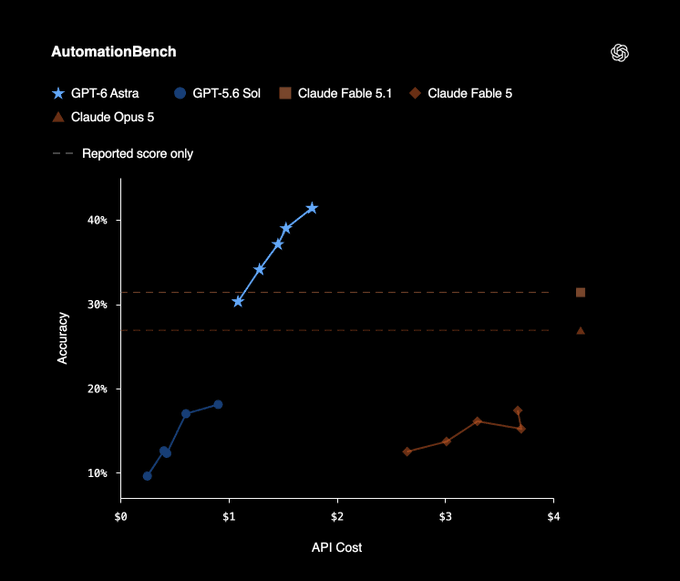
Evidenzhinweis: Die Tabelle nutzt OpenAIs veröffentlichten Vergleichsrahmen, um mehrere Alternativen unter einem gemeinsamen Setup einzuordnen. Diese vom Anbieter gemeldeten Werte können sich mit Modellsnapshots, Prompts, Tools und Evaluationsmethodik ändern; nutzen Sie sie zur Vorauswahl und validieren Sie die Finalisten dann auf repräsentativen Produktionsaufgaben.
Benchmark
GPT-6 Astra
GPT-5.6 Sol
Claude Fable 5.1
Claude Opus 5
Gemini 3.8 Flash
Terminal-Bench 4.0
57,9%
37,3%
55,8%
52,6%
19,1%
DeepSWE v1.1
74,1%
72,7%
67,4%
73,7%
73,8%
FrontierCode 1.1 Extended
64,5%
60,6%
63,6%
63,6%
56,3%
GPQA Diamond
96,0%
94,6%
93,7%
93,7%
95,3%
FrontierMath Tier 4
97,6%
83,0%
87,8%
73,2%
—
Humanity’s Last Exam, with tools
57,2%
—
65,0%
63,6%
—
Die Ergebnisse zeigen, warum es irreführend ist, irgendein Modell als universellen „Astra-Ersatz“ zu bezeichnen. Astra führt klar auf mehreren agentischen und wissenschaftlichen Bewertungen, während Fable 5.1 bei Humanity’s Last Exam besser abschneidet und mehrere Alternativen bei DeepSWE äußerst nahe bleiben.
Öffentliche Benchmark-Indizes können sich ebenfalls ändern, wenn Methodik und Modellsnapshots überarbeitet werden. Nutzen Sie sie zur Vorauswahl, nicht als Ersatz für workload-spezifische Evaluierung.
Alternativen zu GPT-6 Astra
Kein einzelnes Modell ersetzt Astra über jede Workload hinweg. Die praktischste Wahl hängt von der benötigten Fähigkeit, dem bereits genutzten Providerekosystem und den Kosten fehlgeschlagener oder wiederholter Läufe ab.
Alternative
Offizieller Preis pro 1M Tokens (Eingabe/Ausgabe)
Kontext
Bester Grund, es zu wählen
Claude Opus 5
$5 / $25
1M
Nächstliegender Premium-Ersatz
Claude Fable 5.1
$10 / $50
1M
Härtestes Reasoning und langlaufende Agenten
GPT-5.6 Sol
$4 / $20
1,05M
Reibungsärmige OpenAI-Migration
Claude Sonnet 5
$2 / $10
1M
Produktion mit hohem Volumen
Gemini 3.8 Flash
$0,75 / $3,75 (Einführung)
1M
Günstige Multimodalität und Batch-Workloads
DeepSeek V4.1 Flash
$0,22–$0,44 / $0,66–$1,32
1M
Niedrigste Tokenkosten und Hochvolumen
Claude Opus 5
Warum in Betracht ziehen
Claude Opus 5 ist die erste Alternative für Tests, wenn ein Produkt Premium-Reasoning, -Coding oder professionelle Arbeitsleistung zu einem niedrigeren Listenpreis als Astra benötigt.
Preis, Kontext und Cache
Anthropic listet Claude Opus 5 mit $5/M Eingabe und $25/M Ausgabe bei einem Kontextfenster von 1M Tokens. Bestätigen Sie die aktuellen Cache-Bedingungen vor der Produktionsbudgetierung.
Wo es gut performt
Es ist wettbewerbsfähig bei Coding, Analyse, professionellem Schreiben und Agent-Workflows; die zitierte Benchmark-Tabelle positioniert es bei DeepSWE und FrontierCode nahe an Astra.
Einschränkungen
Es übertrifft Astra nicht konsistent. Astra bleibt die stärkere Option, wenn Computer-Nutzung, fortgeschrittene autonome Ausführung, Cybersicherheit oder OpenAI-native Tools zentral für das Produkt sind.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: Premium-Coding-Agenten, komplexe Analysen und professionelles Schreiben. Vermeiden, wenn: der Workflow stark von Astra-spezifischen Tools oder der Computer-Nutzung abhängt.
Claude Fable 5.1
Warum in Betracht ziehen
Claude Fable 5.1 ist ein konkurrierendes Flaggschiff für härtestes Reasoning, Recherche, Coding und langlaufende Agentenaufgaben – nicht jedoch ein günstiger Ersatz.
Preis, Kontext und Cache
Die Raten von $10/M Eingabe und $50/M Ausgabe entsprechen Astras Headline-Preisen. Das 1M-Kontextfenster und ein Cache-Lese-Preis von $0,25/M können die Ökonomie verbessern, wenn große Prompts häufig wiederverwendet werden.
Wo es gut performt
Besonders attraktiv für anhaltendes Reasoning und cache-lastige Agenten; im zitierten Vergleich führt es Astra bei Humanity’s Last Exam mit Tools.
Einschränkungen
Es senkt nicht die Headline-Tokenrate, und Astra behält Vorteile bei mehreren agentischen und wissenschaftlichen Benchmarks sowie OpenAI-nativen Tools.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: maximale Reasoning-Qualität und wiederholte Long-Context-Workflows. Vermeiden, wenn: das primäre Ziel eine große Senkung der Standard-Tokenpreise ist.
GPT-5.6 Sol
Warum in Betracht ziehen
GPT-5.6 Sol bietet die reibungsärmige Migration für Anwendungen, die bereits auf OpenAI-kompatibles Verhalten und Tooling ausgerichtet sind.
Preis, Kontext und Cache
Die zitierte Modellspezifikation nennt $4/M Eingabe und $20/M Ausgabe, ein Kontextfenster von 1,05M Tokens und 128K maximale Ausgabe. Verifizieren Sie aktuelle Bedingungen für gecachte Eingaben vor der finalen Budgetierung.
Wo es gut performt
Es bleibt bei DeepSWE und GPQA Diamond nahe an Astra und kostet im Standard-Kurzkontext deutlich weniger.
Einschränkungen
Die Lücke vergrößert sich bei Aufgaben, die durch Terminal-Bench und FrontierMath repräsentiert werden; Einsparungen können verschwinden, wenn schwächere Task-Completion zu Retries oder manueller Nacharbeit führt.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: bestehende OpenAI-Anwendungen und allgemeine Workloads, die nicht Astras stärkste Agentenfähigkeiten benötigen. Vermeiden, wenn: die Workload wiederholt von Astras großen Benchmark-Gewinnen profitiert.
Claude Sonnet 5
Warum in Betracht ziehen
Claude Sonnet 5 ist ein praktischer Produktionsstandard für kompetente, wiederholbare Wissensarbeit, die nicht bei jeder Anfrage ein Frontier-Flaggschiff erfordert.
Preis, Kontext und Cache
Der zitierte dauerhafte Tarif liegt bei $2/M Eingabe und $10/M Ausgabe mit einem Kontextfenster von 1M Tokens. Bestätigen Sie aktuelle Cache-Bedingungen für Deployments mit hohem Prompt-Wiederverwendungsanteil.
Wo es gut performt
Geeignet für Ticketklassifikation, Dokumentextraktion, Standard-RAG, Content-Transformation, Code-Erklärung, Routine-Funktionsaufrufe und strukturierte Generierung.
Einschränkungen
Es kann Astra nicht zuverlässig bei jeder Long-Horizon- oder Frontier-Reasoning-Aufgabe ersetzen.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: Hochvolumen-Produktionsverkehr und Routine-Geschäftsautomatisierung. Vermeiden, wenn: ein Scheitern bei einer schwierigen Agentenaufgabe teurer ist als der Premiumpreis für das Flaggschiff.
Gemini 3.8 Flash
Warum in Betracht ziehen
Gemini 3.8 Flash kombiniert multimodale Eingaben, großen Kontext und niedrige gehostete API-Kosten für Dokument-, Medien-, Coding- und Batch-Pipelines.
Preis, Kontext und Cache
Der zitierte Einführungstarif beträgt $0,75/M Eingabe und $3,75/M Ausgabe bis zum 31. Dezember 2026, mit einem Kontextfenster von 1M Tokens und rabattiertem Caching während des Promotionszeitraums.
Wo es gut performt
Gut geeignet für multimodale Extraktion, PDFs, Audio, Video, Bilder, große Dokumentensammlungen, Batch-Analysen und kostensensitive Coding-Workloads.
Einschränkungen
Promotionspreise sind zeitlich begrenzt, und die schwierigsten autonomen Agenten- oder Computer-Nutzungsaufgaben erfordern weiterhin eine workload-spezifische Validierung gegenüber Astra.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: kostengünstige Multimodalität und hochvolumige Batch-Verarbeitung. Vermeiden, wenn: die Anwendung die stärkste autonome Ausführung unabhängig von den Tokenkosten erfordert.
DeepSeek V4.1 Flash
Warum in Betracht ziehen
DeepSeek V4.1 Flash ist die kostenfokussierte Option für hochdurchsatzfähiges Reasoning, Coding, Zusammenfassung, Extraktion, Klassifikation und Offline-Verarbeitung.
Preis, Kontext und Cache
Der zitierte Haupt-/Nebenzeiten-Plan listet Cache-Hit-Eingaben mit $0,007–$0,014/M, Cache-Miss-Eingaben mit $0,22–$0,44/M und Ausgaben mit $0,66–$1,32/M bei einem Kontextfenster von 1M Tokens. Prüfen Sie vor Veröffentlichung die aktuelle V4.1-Preisseite.
Wo es gut performt
Attraktiv, wenn Tokenkosten dominieren und die Anwendung Routing, Validierung oder Offline-Qualitätsprüfungen zur Steuerung der Variabilität nutzen kann.
Einschränkungen
Ein deutlich niedrigerer Tokenpreis belegt keine gleichwertige autonome Aufgabenerfolgsrate. Zuverlässigkeit, Toolverhalten, Latenz und Akzeptanzrate müssen auf der Ziel-Workload gemessen werden.
Am besten geeignet / Vermeiden, wenn
Bestens geeignet für: großskalige, kostensensitive Verarbeitung mit Validierung. Vermeiden, wenn: ein fehlgeschlagener, hochwertiger autonomer Lauf die Tokenersparnis überwiegen würde.
GPT-6 Astra vs. Alternativen: Welches Modell gewinnt in welcher Kategorie?
Indem man Preis, Architektur, Kontext und Benchmarks zusammenführt, ergibt sich eine nützlichere Entscheidungstabelle, als Modelle einfach von Platz eins bis sechs zu ranken.
Kategorie
Beste Wahl
Warum
Insgesamt beste Astra-Alternative
Claude Opus 5
Nahezu Frontier-Leistung zum halben Astra-Listenpreis
Maximales Reasoning
Claude Fable 5.1
Flaggschiff-Reasoning und starke Long-Horizon-Performance
Im OpenAI-Ökosystem bleiben
GPT-5.6 Sol
Ähnliches API-Ökosystem mit 60 % niedrigeren Tokenpreisen
Produktion mit hohem Volumen
Claude Sonnet 5
Starke Qualität zu $2/$10
Multimodalität Preis/Leistung
Gemini 3.8 Flash
1M Kontext plus sehr niedrige Einführungspreise 2026
Niedrigste API-Kosten
DeepSeek V4.1 Flash
$0,22–$0,44 Eingabe und $0,66–$1,32 Ausgabe
Agenten mit starker Computer-Nutzung
GPT-6 Astra
Eines von Astras klarsten Differenzierungsmerkmalen
Wissenschaftliche und schwierige Mathematik
GPT-6 Astra
Sehr starke FrontierMath- und Science-Agent-Ergebnisse
Cache-lastige langlaufende Agenten
Claude Fable 5.1
$0,25/M Cache-Reads
Das wichtigste Ergebnis ist, dass GPT-6 Astra einige Kategorien weiterhin gewinnt. Ein Artikel über Alternativen sollte nicht implizieren, dass ein günstigeres Modell es universell ersetzt. Astra wird teuer, wenn es überall eingesetzt wird; es kann dennoch wirtschaftlich sein, wenn seine höhere Task-Completion-Rate mehrere Versuche schwächerer Modelle ersetzt.
Wie viel können Sie tatsächlich sparen, wenn Sie die GPT-6 Astra API ersetzen?
Betrachten Sie eine Workload, die 1 Million nicht gecachte Eingabetokens und 200.000 Ausgabetokens verbraucht. Cache-Rabatte, Toolgebühren, Wiederholversuche, Batch-Preise und Long-Context-Zuschläge ignoriert:
Dieses einfache Beispiel zeigt auch, warum Tokenpreise nicht die einzige Kennzahl sein können. Wenn eine $20-Astra-Anfrage einmalig erfolgreich ist, während ein $4-Modell sechs Versuche, mehrere Tool-Retries und menschliche Nacharbeit erfordert, war Astra tatsächlich günstiger.
Verfolgen Sie diese Zahl neben Latenz, Aufgabenerfolg, Retry-Rate, Tool-Call-Fehlern und Eskalation-zum-Menschen-Rate.
Wie können Sie GPT-6 Astra-Alternativen über CometAPI testen?
Ein praktischer Vorteil einer Multi-Model-API-Schicht ist, dass die Evaluierung kein Provider-Integrationsprojekt werden muss. CometAPI bietet GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash und DeepSeek V4.1 Flash über einen gemeinsamen Modellkatalog.
Mit einem OpenAI-kompatiblen Client kann das Modell konfigurierbar statt hardcodiert werden:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Prüfe diesen Migrationsplan und identifiziere die drei risikoreichsten Annahmen.",
        }
    ],
)

print(response.choices[0].message.content)
Sie können denselben Evaluierungssatz mit folgenden Modell-IDs erneut ausführen:
Das ist in der Regel informativer, als eine Alternative allein von einer Benchmark-Bestenliste auszuwählen. Nehmen Sie 100–500 repräsentative Produktionsprompts und protokollieren Sie Aufgabenerfolg, menschliche Akzeptanz, Wiederholversuche, Toolfehler, Gesamtzahl der Tokens, Latenz und gesamte API-Kosten.
Sollten Sie GPT-6 Astra durch ein einzelnes Modell ersetzen oder Modell-Routing verwenden?
Für viele Anwendungen ist das Ersetzen von Astra durch ein Universalmodell die falsche Optimierung. Eine effizientere Architektur sieht so aus:
Routineverkehr → Claude Sonnet 5, Gemini 3.8 Flash oder DeepSeek V4.1 Flash
Schwieriges Reasoning → Claude Opus 5 oder GPT-5.6 Sol
Sehr schwierige langlaufende Aufgaben → Claude Fable 5.1 oder GPT-6 Astra
Computer-Nutzung oder Astra-spezifische Agent-Workflows → GPT-6 Astra
Damit wird Astra zum Eskalationsmodell statt zum Standardmodell. Wenn nur 10 % der Anfragen tatsächlich Frontier-Agentenleistung benötigen, bedeutet das Routing von 100 % des Traffics durch Astra, dass sein Premiumpreis auch für die übrigen 90 % gezahlt wird.
Welche GPT-6 Astra API-Alternative sollten Sie wählen?
Wählen Sie Claude Opus 5, wenn Sie das ausgewogenste Verhältnis von Qualität und Preis wünschen.
Wählen Sie Claude Fable 5.1, wenn maximale Reasoning-Qualität wichtiger ist als die Senkung der Headline-Tokenraten.
Wählen Sie GPT-5.6 Sol, wenn Sie bereits OpenAI nutzen und die geringste Integrationsänderung möchten.
Wählen Sie Claude Sonnet 5, wenn der Großteil Ihres Produktionsverkehrs kompetente, aber gewöhnliche Wissensarbeit ist.
Wählen Sie Gemini 3.8 Flash, wenn Multimodalität, Skalierung und niedrige gehostete API-Kosten wichtig sind.
Wählen Sie DeepSeek V4.1 Flash, wenn Tokenkosten die dominierende Einschränkung sind und Ihre Workload mehr Evaluierung und Validierung tolerieren kann.
Und wählen Sie GPT-6 Astra selbst, wenn Ihre Anwendung tatsächlich von stärkerer Computer-Nutzung, schwieriger autonomer Softwarearbeit, wissenschaftlichem Reasoning oder anderen agentischen Fähigkeiten profitiert.
Der Hauptfehler besteht nicht darin, das „falsche“ Frontier-Modell zu wählen, sondern darin, Frontier-Preise für Anfragen zu zahlen, die nie ein Frontier-Modell benötigten.
FAQ
Was ist die beste Gesamtalternative zur GPT-6 Astra API?
Claude Opus 5 ist eine der stärksten Allzweck-Alternativen. Es bietet ein 1M-Kontextfenster, starke Coding- und Agentenfähigkeiten und $5/$25 Listenpreise – die Hälfte von Astras Standard-Tokenraten.
Was ist die günstigste GPT-6 Astra-Alternative?
Unter den hier behandelten Modellen hat DeepSeek V4.1 Flash die niedrigsten First-Party-Tokenpreise. Der aktuelle Nebenzeiten-Tarif liegt bei $0,22/M nicht gecachter Eingabe und $0,66/M Ausgabe. Allerdings sollte man nicht annehmen, dass es Astras Erfolgsquote bei autonomen Aufgaben allein aufgrund des niedrigeren Preises erreicht.
Ist Claude Fable 5.1 besser als GPT-6 Astra?
Keines der Modelle gewinnt jede Workload. OpenAIs Vergleich gibt Astra deutliche Vorteile bei FrontierMath Tier 4 und Terminal-Bench 4.0, während Fable 5.1 bei Humanity’s Last Exam mit Tools höher punktet.
Lohnt sich GPT-5.6 Sol noch nach GPT-6 Astra?
Ja. Die Standard-API-Preise von $4/$20 liegen deutlich unter Astras $10/$50, während ein Kontextfenster von 1,05M Tokens erhalten bleibt. Es kann daher für Workloads die bessere Voreinstellung sein, bei denen Astras Vorteile die Task-Completion nicht materiell verbessern.
Ist Gemini 3.8 Flash gut genug, um GPT-6 Astra zu ersetzen?
Für bestimmte Coding-, multimodale, Dokument- und Batch-Workloads ja. Es ist deutlich günstiger und hat ein 1M-Kontextfenster. Für die schwierigsten autonomen Agenten- und Computer-Nutzungsaufgaben bleibt Astra die stärkere Wahl.
Hat GPT-6 Astra einen Preisnachteil bei sehr langen Prompts?
Ja. OpenAI wendet einen höheren Preistarif an, wenn die Eingabe 272K Tokens überschreitet. Long-Context-Anfragen sollten daher separat budgetiert werden.
Sollte ich Modelle nach Tokenpreis oder Benchmark-Scores vergleichen?
Nutzen Sie beides nur als Screening-Metriken. Die wichtigste Produktionskennzahl ist meist die Kosten pro akzeptiert abgeschlossener Aufgabe, einschließlich Reasoning-Tokens, Retries, Tool-Calls, Latenz und menschlicher Nacharbeit.
Kann ich mehrere GPT-6 Astra-Alternativen in derselben Anwendung verwenden?
Ja. In vielen Anwendungen ist Modell-Routing vorzuziehen, statt jede Anfrage einem einzigen Modell anzuvertrauen. Ein kostengünstiges Modell kann Routineanfragen übernehmen, während stärkere Modelle zunehmend schwierige Eskalationen bearbeiten.