
Kurzfassung
Claude Opus 5.5 und Claude Sonnet 5.5 bieten 1M Kontext und 128K maximale Standardausgabe, mit Text- und Bild-Eingabe sowie einem Wissensstand bis Juni 2026. Opus ist auf komplexe, offene Arbeiten ausgerichtet; Sonnet auf schnellere Ausführung bei klar abgegrenzten Alltagsaufgaben.
Zu den Standard-API-Tarifen von Anthropic kostet Sonnet 5.5 $2/M Eingabe und $10/M Ausgabe, genau die Hälfte von Opus 5.5 mit $4/M Eingabe und $20/M Ausgabe. Mehrere veröffentlichte Werte liegen nahe beieinander, aber die Rangfolge variiert je Benchmark. Opus erzielt höhere Werte auf dem CursorBench, während Sonnet beim Terminal-Bench vorn liegt. Diese Ergebnisse nutzen unterschiedliche Effort-Einstellungen und sind kein kontrollierter Head-to-Head-Test.
Wählen Sie das Modell, das Ihre Qualitäts- und Latenzanforderungen zum niedrigsten Gesamtaufgabenpreis erfüllt. Teams sollten Kosten pro akzeptierter Aufgabe, Latenz, Tool-Call-Verhalten, Wiederholungen und den erforderlichen Anteil an Urteilsvermögen vergleichen, bevor sie entscheiden, wann Opus seinen Aufpreis wert ist.
Zentrale Erkenntnisse
- Preis: Sonnet 5.5 kostet die Hälfte des Standard-Input/Output-Preises von Opus 5.5.
- Spezifikationen: Beide unterstützen ein 1M-Token-Kontextfenster und bis zu 128K Standardausgabe.
- Coding: Opus führt FrontierCode und CursorBench an, während Sonnet den höheren veröffentlichten Terminal-Bench-4.0-Wert erzielt.
- Wissensarbeit: Opus behält einen kleinen Vorteil bei GDPval-AA und AA-Briefcase.
- Bereitstellung: Testen Sie das schnellere Sonnet für klar abgegrenzte Ausführung und Opus für komplexe Eskalation; validieren Sie beide gegen Zielwerte für Qualität, Latenz und Kosten.
Claude Opus 5.5 vs Sonnet 5.5 auf einen Blick
| Entscheidungsfaktor | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Kontext / max. Standardausgabe | 1M / 128K | 1M / 128K |
| Eingabe-/Ausgabe-Modalitäten | Text + Bild -> Text | Text + Bild -> Text |
| Reasoning | Adaptives Denken, immer aktiv | Adaptives Denken |
| Standard-Effort der Claude-Plattform | Medium | High |
| Offizieller Input-/Output-Preis | $4 / $20 pro 1M | $2 / $10 pro 1M |
| Cache-Lesen | $0.20 / 1M | $0.10 / 1M |
| Vergleichslatenz | Moderat | Schnell |
| Coding-Highlight | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| Highlight Wissensarbeit | GDPval-AA 1846 | GDPval-AA 1844 |
| Primärer Einsatzzweck | Komplexe, mehrdeutige, lang laufende Arbeiten | Schnelle, klar abgegrenzte, wiederholbare Produktionsarbeit |
Claude Opus 5.5
Claude Opus 5.5 wurde am 22. September 2026 als erstes Modell der Claude-5.5-Familie veröffentlicht. Anthropic positioniert es für fortgeschrittenes Coding, komplexe Agenten, professionelle Wissensarbeit und lang laufende Workflows, bei denen die Wahrung der Intention über viele Schritte wichtiger ist als minimale Latenz.
Sein markantestes Betriebsverhalten ist stets aktives adaptives Denken. Entwickler können den Reasoning-Effort steuern, aber das adaptive Denken selbst kann nicht deaktiviert werden. Dies macht Migrationstests wichtig für ältere Agenten, die zuvor von einem Pfad mit ausgeschaltetem Thinking oder anderen Effort-Standards abhingen.
Die Claude Opus 5.5 API in CometAPI bietet eine einheitliche Route unter derselben Modell-ID, claude-opus-5-5, neben anderen Modellen für Workload-Routing.
Claude Sonnet 5.5
Claude Sonnet 5.5 wurde am 28. September 2026 als zweites Modell der Claude-5.5-Familie veröffentlicht. Anthropic beschreibt es als schnellere, kostengünstigere Ergänzung zu Opus 5.5 für klar abgegrenzte Alltagsarbeiten, einschließlich Bugfixes, Dokumenterstellung, Coding, Agenten und designorientierte Aufgaben.
Anthropic berichtet, dass Sonnet 5.5 mehr als 30% schneller als Sonnet 5 ausgibt und pro Aufgabe bis zu 30% weniger kosten kann als dieser Vorgänger. Dies sind vom Anbieter gemeldete Vergleiche mit Sonnet 5, keine gemessenen Geschwindigkeits- oder Aufgaben-Kostenverhältnisse gegenüber Opus 5.5.
Die Claude Sonnet 5.5 API in CometAPI verwendet die Modell-ID claude-sonnet-5-5 und eignet sich, um Sonnet als kostengünstigere Ausführungsschicht in Mixed-Model-Anwendungen zu testen.
Claude Opus 5.5 vs Sonnet 5.5: Performance
Anthropics veröffentlichte Ergebnisse zeigen kleine Punktunterschiede bei mehreren Evaluierungen zur Wissensarbeit und Computerbedienung. Opus meldet höhere Werte bei FrontierCode, CursorBench und Humanity’s Last Exam, während Sonnet beim Terminal-Bench höher liegt. Die Vergleiche hängen von Effort-Einstellungen und Evaluationsbedingungen ab.
| Benchmark | Claude Opus 5.5 | Claude Sonnet 5.5 | Was gemessen wird |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | Aufgaben von Kommandozeilen-Agenten |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | Real-World Software Engineering |
| CursorBench 4.0 | 57.8% | 55.5% | Mehrdeutige Multi-File-Coding-Aufgaben |
| GDPval-AA v2.1 | 1846 | 1844 | Professionelle Wissensarbeit |
| AA-Briefcase v1.1 | 1822 | 1811 | Langhorizont-Wissensarbeit |
| Humanity's Last Exam, tools | 67.7% | 64.5% | Multidisziplinäres Reasoning |
| OSWorld 2.1 | 81.8% | 80.1% | Computerbedienung |
| Chartography | 64.4% | 61.6% | Visuelle Diagrammerkennung |
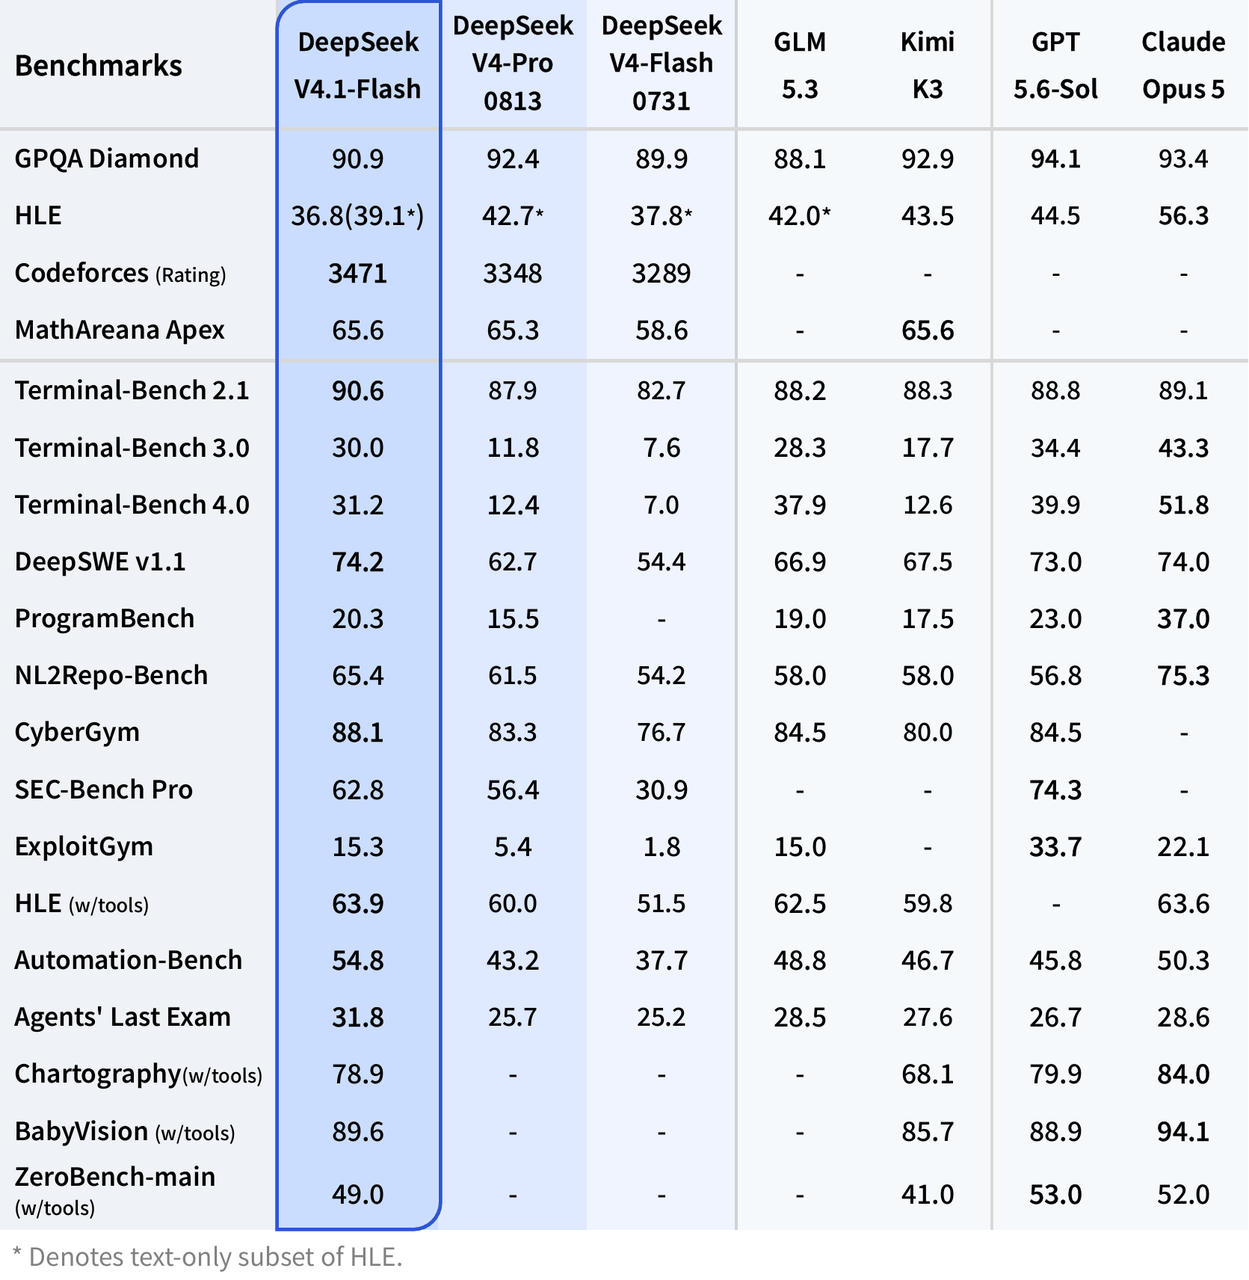
Dies sind veröffentlichte Ergebnisse, kein kontrollierter Vergleich für diesen Artikel.
- Effort: Opus’ Terminal-Bench-Ergebnis nutzt Xhigh. Sonnets FrontierCode-Wert ist bei Xhigh höher als bei Max.
- Bewertung und Tools: OSWorld verwendet Teilpunkte; die hier angegebenen Chartography-Ergebnisse nutzen keine Tools.
- Bereitstellung: Sonnets GDPval-AA- und AA-Briefcase-Ergebnisse wurden auf einer Pre-Release-Bereitstellung mit einem inzwischen behobenen Structured-Output-Bug gemessen.
Agentenbasiertes Coding
Sonnets Terminal-Bench-4.0-Wert von 70.6% liegt höher als Opus 5.5s gemeldete 66.4%, aber die offizielle Fußnote sagt, dass das Opus-Ergebnis bei Xhigh-Effort vorliegt. Bei FrontierCode 1.1 Main führt Opus mit 54.4% gegenüber Sonnets 46.2% (Max); beim CursorBench 4.0 führt Opus mit 57.8% zu 55.5%.
Diese Aufspaltung ist relevant, weil Coding-Agent-Benchmarks unterschiedliche Verhaltensweisen belohnen. Terminal-Bench betont erfolgreiche mehrstufige Ausführung in einer Kommandozeilenumgebung, während CursorBench mehrdeutige Multi-File-Aufgaben aus realen Coding-Sitzungen nutzt. Für begrenztes Coding und iterative Ausführung kann Sonnet sehr konkurrenzfähig sein; für breitere Repository-Scale-Arbeit behält Opus laut Anthropics veröffentlichten Bewertungen die stärkeren Nachweise.
Wissensarbeit und Reasoning
Bei GDPval-AA v2.1 erzielt Sonnet 5.5 1844 gegenüber Opus 5.5 mit 1846. Bei AA-Briefcase v1.1 ist der Abstand 1811 zu 1822. Diese Ergebnisse sind bemerkenswert, weil die Preislücke viel größer ist als die Benchmark-Differenz.
Anthropic identifiziert Opus 5.5 als stärker bei komplexen, offenen Arbeiten, die anhaltendes Urteilsvermögen erfordern. Für Forschung, Architektur und Audits testen Sie, ob dieses Verhalten falsche Entscheidungen oder menschliche Korrekturen in Ihren eigenen Aufgaben reduziert, anstatt aus kleinen Benchmark-Spannen einen wirtschaftlichen Vorteil abzuleiten.
Computerbedienung und visuelle Aufgaben
Bei OSWorld 2.1, mit Teilpunktwertung, erzielt Opus 81.8% und Sonnet 80.1%. Bei Chartography ohne Tools sind die Werte 64.4% bzw. 61.6%. Für Browser- oder GUI-Agenten deutet dies darauf hin, dass Latenz, Tool-Call-Effizienz und aufgabenbezogene Kosten ebenso wichtig sein können wie die Überschriften-Benchmarkdifferenz.
Interpretation der Benchmarks
Die Benchmark-Aussage ist nicht, dass Sonnet Opus ersetzt hat. Vielmehr hat Anthropic die Fähigkeitslücke so weit verringert, dass die Form des Workloads wichtiger ist als die Modellstufe allein. Klar abgegrenzte und latenzsensitive Aufgaben begünstigen zunehmend Sonnet’s Ökonomie, während Mehrdeutigkeit, lange Horizonte und kostspielige Fehlermodi die stärksten Gründe bleiben, Opus zu testen.
Claude Opus 5.5 vs Sonnet 5.5: Preisgestaltung
Offizielle Claude-API-Preise
Die Opus-Preisspezifikation und die Sonnet-Preisspezifikation unterscheiden Standard-Token-Sätze, Cache-Aufbewahrungsfenster und Batch-Rabatte. Die Preise unten sind USD pro Million Tokens; optionale Service-Modifikatoren separat bestätigen.
| Preiskennzahl | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Input / 1M Tokens | $4.00 | $2.00 |
| Output / 1M Tokens | $20.00 | $10.00 |
| Cache-Lesen / 1M Tokens | $0.10 | $0.20 |
| 5-Minuten-Cache-Schreiben / 1M Tokens | $5.00 | $2.50 |
| 1-Stunden-Cache-Schreiben / 1M Tokens | $8.00 | $4.00 |
| Batch-Input / 1M Tokens | $2.00 | $1.00 |
| Batch-Output / 1M Tokens | $10.00 | $5.00 |
Sonnet hat halbierte Standard-Input-, Output- und Cache-Schreibsätze.
Cache-Lesen folgt demselben 2:1-Preisverhältnis: Sonnet 5.5 kostet $0.10/M zwischengespeicherte Eingabe, während Opus 5.5 $0.20/M kostet. Die Wiederverwendung zwischengespeicherter Präfixe reduziert für beide Modelle die Input-Kosten und bewahrt dabei Sonnets niedrigeren Pro-Token-Satz. Gesamteinsparungen pro Aufgabe hängen dennoch von Ausgabelänge, Cache-Schreiben, Wiederholungen und Annahmequote ab.
Kosten pro akzeptierter Aufgabe
Zur Veranschaulichung kostet eine Anfrage mit 100K nicht zwischengespeicherten Eingabe-Tokens und 10K Ausgabe-Tokens etwa $0.60 bei Opus 5.5 und $0.30 bei Sonnet 5.5 zu Standardtarifen. Aber ein 2x Token-Preisunterschied garantiert keine 2x Differenz bei den Kosten pro erfolgreicher Aufgabe. Wiederholungen, Tool-Calls, Ausgabelänge, Cache-Treffer, fehlgeschlagene Versuche und menschliche Korrekturen können das Ergebnis verändern.
Produktionsevaluierungen sollten daher die Kosten pro akzeptierter Aufgabe zusammen mit Abschlussrate, p50/p95-Latenz, Wiederholungen, Tool-Calls und menschlicher Intervention protokollieren.
CometAPI-Preise
Der Modellkatalog von CometAPI kündigt einen 20%-Rabatt auf viele unterstützte Anthropic-Routen an. Für die Claude Opus 5.5 API in CometAPI weist der referenzierte Katalogpreis $3.20/M Input und $16/M Output aus. Für die Claude Sonnet 5.5 API in CometAPI zeigen lokalisierte Katalognachweise $1.60/M Input und $8/M Output. Da Gateway-Preise variieren können, bestätigen Sie die Live-Modellroute, bevor Sie Produktionsverkehr budgetieren.
| CometAPI-Tarif | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Input / 1M | $3.20 | $1.60 |
| Output / 1M | $16.00 | $8.00 |
| Relativer Rabatt vs offiziell | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Technische Spezifikationen
Beide Modelle teilen sich die Kern-Kontext- und Ausgabelimits aus der Übersichtstabelle. Das zusätzliche 300K-Ausgabelimit ist eine Beta-Fähigkeit der Batch-API und nicht das Standardlimit für interaktive Ausgaben.
Die Kontextlänge ist kein Unterscheidungsmerkmal zwischen den beiden Modellen. Beide unterstützen dasselbe 1M-Token-Fenster und eine 128K-Standardausgabeobergrenze. Bedeutender sind Unterschiede im Reasoning-Verhalten, in der Geschwindigkeit und im Umfang des erforderlichen schwierigen Urteilsvermögens.
Sonnets gemeldete Verbesserung der Ausgabegeschwindigkeit bezieht sich auf Sonnet 5. Opus verfügt außerdem über den Fast mode mit bis zu 2,5x Output-Token-Durchsatz, bepreist mit $8/M Input und $40/M Output. Es ist eine Research-Vorschau in der Claude-API; dies ist keine Garantie für 2,5x schnellere End-to-End-Aufgaben oder Time-to-First-Token.
Architektur-Offenlegung und Integrationsverhalten
Die zitierten Materialien offenbaren keine Parameterzahlen oder ausreichende interne Architekturdetails für einen belastbaren Vergleich Dichte vs. MoE. Vergleichen Sie stattdessen dokumentierte Schnittstellen und Verhalten. Beide Migrationen erfordern das Testen von Tool-Auswahlbeschränkungen und bewahrtem Thinking; bei Opus kann adaptives Thinking nicht deaktiviert werden. Validieren Sie den Konversationszustand beim Routing zwischen Modellen, anstatt opake Thinking-Blöcke ohne Kompatibilitätsprüfung weiterzuleiten.
Claude Opus 5.5 vs Sonnet 5.5: Anwendungsfälle
Eine sinnvolle Bereitstellungsstrategie ist, Sonnet 5.5 als Standardausführungsmodell und Opus 5.5 als Eskalationsmodell zu behandeln. Dies kann die Ausgaben für gut spezifizierte, wiederholbare Aufgaben reduzieren, während Opus für Arbeiten reserviert wird, die von anhaltendem Urteilsvermögen profitieren. Einsparungen hängen von Sonnets Annahmequote und der Häufigkeit der Eskalation ab.
Auswahl nach Workload
| Workload | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Routine-Coding | Leistungsfähig, höhere Kosten | Starke Eignung |
| Bugfixing | Nützlich für schwierige Fälle | Starke Eignung |
| Hochvolumiger API-Traffic | Höhere Stückkosten | Starke Eignung |
| Dokument-/Folienerstellung | Stark | Wirtschaftlicher |
| Coding-Subagenten | Selektiv einsetzen | Starke Eignung |
| Repository-Scale-Migration | Starke Eignung | Für begrenzte Arbeiten testen |
| Mehrdeutige Architektur | Starke Eignung | Abhängig von der Komplexität |
| Lang laufende autonome Agenten | Starke Eignung | Gute Ausführungsschicht |
| Schwierige Recherche/Analyse | Starke Eignung | Gut für begrenzte Arbeiten |
| Latenzsensitive UX | Moderat | Starke Eignung |
| Gemischter Produktions-Workload | Eskalationsmodell | Standardausführungsmodell |
Ein praxistauglicher Router kann mit Sonnet starten und eskalieren, wenn die Aufgabe einen Schwellenwert für Mehrdeutigkeit, Tool-Loop-Länge, wiederholte Fehlschläge oder Geschäftsauswirkung überschreitet. Die Routingregel sollte gegen produktionsnahe Aufgaben validiert werden, anstatt aus Benchmark-Werten abgeleitet zu werden.
So rufen Sie Opus 5.5 und Sonnet 5.5 über CometAPI auf
Erstellen Sie einen CometAPI-API-Schlüssel und konfigurieren Sie einen Anthropic-kompatiblen Client zur Nutzung des CometAPI-Endpunkts. Wählen Sie die Modell-ID für die Aufgabe, senden Sie Ihren Prompt über die Messages API und lesen Sie die Textantwort. Halten Sie beim Modellvergleich Prompt, Ausgabelimit, Tools und Annahmekriterien konsistent und protokollieren Sie den effektiven Reasoning-Effort.
Opus-5.5-Beispiel
Für eine Migrationsplan-Überprüfung wählen Sie claude-opus-5-5 und bitten das Modell, die risikoreichsten Schritte zu identifizieren, ihre Auswirkungen zu erklären und Schutzmaßnahmen vorzuschlagen. Senden Sie die Anfrage über die CometAPI Messages API und prüfen Sie den zurückgegebenen Text.
Sonnet-5.5-Beispiel
Für dieselbe Migrationsplan-Überprüfung wählen Sie claude-sonnet-5-5 und übermitteln denselben Prompt und dasselbe Ausgabelimit über CometAPI. Vergleichen Sie die Antwort anhand derselben Annahmekriterien und protokollieren Sie Latenz, Wiederholungen und tatsächliche Kosten, bevor Sie entscheiden, welches Modell zum Workload passt.
Für produktives Routing halten Sie beide Modell-IDs hinter derselben Anwendungsoberfläche und protokollieren Abschlussqualität, Latenz, Wiederholungen und tatsächlich abgerechnete Kosten. Vermeiden Sie Eskalationen allein aufgrund eines langen Prompts; Mehrdeutigkeit und Fehlkosten sind in der Regel bessere Signale.
Fazit
Claude Opus 5.5 und Sonnet 5.5 teilen heute weitgehend denselben technischen Rahmen; die Modellwahl hängt daher zunehmend von Ökonomie und Workload-Verhalten statt von der Kontextgröße ab. Sonnet kombiniert schnellere Ausführung und halbierte Standard-Tokenpreise mit einer Benchmark-Performance, die oft nahe an Opus liegt.
Opus gewinnt an Wert, je mehr Mehrdeutigkeit, Aufgabendauer und Kosten einer Fehlentscheidung zunehmen. Sein Mehrwert liegt weniger in einem größeren Kontextfenster und mehr in der Fähigkeit, Urteilsvermögen über schwierige, offene Workflows hinweg aufrechtzuerhalten.
Für viele Produktionsteams ist die effizienteste Architektur die Nutzung beider: Sonnet für die wiederholbare Mehrheit der Arbeiten und Opus für den Teil der Aufgaben, bei dem stärkeres Reasoning messbar Fehlschläge, Wiederholungen oder menschliche Eingriffe reduziert.
FAQ
Wie verhindert ein Claude-5.5-Router teure Eskalationsschleifen?
Setzen Sie eine maximale Anzahl an Versuchen und ein Budget vor der Ausführung. Eskalieren Sie nach einem reproduzierbaren Fehlschlag, fehlenden Belegen oder einem aufgabenspezifischen Qualitätsgate – nicht nach jeder unsicheren Antwort. Protokollieren Sie, welcher Fehler Opus ausgelöst hat und ob es das akzeptierte Ergebnis verbessert hat. Wenn kein Modell besteht, geben Sie das ungelöste Problem zur Überprüfung zurück, anstatt unbegrenzt zu wiederholen.
Wie lassen sich Opus und Sonnet fair auf einem Workload vergleichen?
Nutzen Sie denselben Aufgabenkorpus, verfügbare Tools, Eingabebelege, Ausgabelimit und Bewertungsrubrik. Protokollieren Sie den effektiven Effort und testen Sie Cold-Cache- und Warm-Cache-Läufe separat. Überprüfen Sie Ergebnisse nach Möglichkeit ohne Kenntnis des Modells. Berichten Sie Annahmequote und Gesamtkosten einschließlich erfolgloser Versuche; gleiche Tokenpreise oder ein Benchmark belegen keine Gleichwertigkeit.
Was sollte erhalten bleiben, wenn während einer Aufgabe zwischen Claude-5.5-Modellen gewechselt wird?
Bewahren Sie Benutzeranweisungen, relevante Belege, Tool-Ergebnisse und eine explizite Fortschrittszusammenfassung. Behandeln Sie opakes Thinking als modell- und konversationsspezifisch; gehen Sie nicht davon aus, dass es routenübergreifend wiedergegeben werden kann. Testen Sie das vom Anbieter unterstützte Übergabeverhalten vor der Produktion, insbesondere wenn der Workflow Konten, Gateways oder SDKs mischt.
Wann sollte die Wahl eines Claude-5.5-Modells neu bewertet werden?
Führen Sie die betroffenen Abnahmetests nach einem Deployment-Fix, Routing-Änderung, Preisänderung, Tool-Änderung oder einer wesentlichen Prompt-Aktualisierung erneut aus. Behalten Sie den früheren Lauf als Basislinie und protokollieren Sie Datum, Modell-ID, Endpunkt, Konfiguration und Harness-Version. Dies unterscheidet einen Modellwechsel von Änderungen in der umgebenden Anwendung.