
TL;DR
OpenAI hat am 17. November 2026 GPT-6.2 Astra als neues Frontier-Modell für komplexe professionelle, agentische, wissenschaftliche, juristische, Design- und Coding-Arbeiten veröffentlicht. Es liefert messbare Verbesserungen gegenüber GPT-6 Astra (insbesondere bei lang angelegten professionellen Aufgaben und Wissenschaftsbenchmarks), senkt gleichzeitig die Standard-API-Tokenpreise um 20% und reduziert die Kosten pro Aufgabe durch höhere Effizienz noch stärker.
Das Modell ist in der OpenAI API (gpt-6.2-astra), in ChatGPT Work/Codex und sofort auf CometAPI verfügbar – für einheitlichen, kostengünstigen Zugang neben 500+ weiteren Modellen.
Kernaussagen
- GPT-6.2 Astra ist OpenAIs aktuelles Frontier-Tier, optimiert für harte, mehrstufige professionelle Workflows, wissenschaftliche Forschung, juristisches Verfassen, CAD/3D, Slideshows und agentisches Coding.
- Es verbessert GPT-6 Astra auf zentralen professionellen und wissenschaftlichen Benchmarks und verwendet weniger Ausgabe-Token, was die effektiven Kosten pro Aufgabe stark senkt.
- Standard-API-Preise: $8.00 / 1M Input-Token, $0.40 Cached Input, $40.00 / 1M Output-Token (20% niedriger als GPT-6 Astra bei Input/Output; 60% niedriger bei Cached Input).
- Artificial Analysis Intelligence Index Score: 62 (Zweiter hinter Claude Fable 5.2 mit 65, vor Gemini 4 Carbon und Claude Opus 5.5 in vielen Vergleichen).
- Kontextfenster: 1,050,000 Token (922,000 max input / 128,000 max output).
- Bereits auf CometAPI mit OpenAI-kompatiblen Endpunkten live, sodass Entwickler mit einer einzigen Codezeile das Modell wechseln und oft zusätzliche Einsparungen erzielen können.
- Empfohlen für produktive agentische Systeme, professionelle Dokumentenerstellung, wissenschaftliche Workflows und High-Stakes-Coding, wenn Kosteneffizienz und Leistungsfähigkeit zählen.
Was ist GPT-6.2 Astra?
GPT-6.2 Astra ist OpenAIs neuestes Frontier-Reasoning-Modell, veröffentlicht am 17. November 2026, zusammen mit dem effizienteren Alltagsmodell GPT-6.2 Sol. Es folgt auf GPT-6 Astra und ist ausdrücklich auf die härtesten professionellen und lang angelegten agentischen Arbeiten ausgerichtet, nicht auf lockeren Chat.
OpenAI beschreibt es als ein Modell, das sauberere, vorlagenkonforme Folien, Tabellen, Dokumente, Websites und 3D-Designs erzeugt. Es zeigt besondere Stärke in mehrstufigen professionellen Workflows, wissenschaftlicher terminalbasierter Forschung, juristischer Aufgabenerledigung, CAD-Aufgaben und sicherheitsrelevanten Bewertungen (mit strengeren Schutzmaßnahmen aufgrund der gestiegenen Fähigkeiten).
Das Modell unterstützt ein sehr großes Kontextfenster von 1,050,000 Token mit dokumentierten Maximalwerten von etwa 922,000 Input- und 128,000 Output-Token. Der Knowledge Cutoff wird auf etwa Mitte Mai 2026 angegeben. Es akzeptiert Text- und Bild-Inputs und ist für Tool-Nutzung, strukturierte Ausgaben, Prompt-Caching und agentische Schleifen ausgelegt.
Wichtig ist, dass der Rollout sich auf ChatGPT Work, Codex und die API konzentriert. Es wird nicht der regulären kostenlosen ChatGPT-Consumer-Oberfläche hinzugefügt. Enterprise- und Edu-Workspaces erfordern in der Regel eine Admin-Aktivierung.
Zentrale Upgrades von GPT-6.2 Astra
GPT-6.2 Astra verbessert OpenAIs Flaggschiff-Modell in professioneller Arbeit, wissenschaftlicher Forschung, Codierung und Computernutzung. Die wichtigsten Upgrades kombinieren stärkere Aufgabenleistung, höhere Token-Effizienz, niedrigere API-Preise und erweiterte Bereitstellungsschutzmaßnahmen.
1. Bessere professionelle Dokumente, Tabellenkalkulationen und Präsentationen
OpenAI hat GPT-6.2 Astra darauf trainiert, klarere Ergebnisse zu liefern, die professionellen Konventionen in Finanzen, Buchhaltung, Vertrieb und Recht besser folgen. Gemeldete Verbesserungen umfassen eine genauere Anpassung an Präsentationsvorlagen, bessere Tabellenorganisation und direktere Formulierungen.
Auf GDPval v2, das lange professionelle Workflows bewertet, verbessert sich GPT-6.2 Astra um 6,2 Prozentpunkte gegenüber GPT-6 Astra bei 22% weniger Ausgabe-Token. Für Unternehmen ist es daher eine Evaluierung wert – für Finanz-Workbooks, Investment-Memos, Präsentationen und detaillierte Berichte.
2. Stärkeres wissenschaftliches Reasoning und Forschungs-Workflows
Astra verbessert seine Fähigkeit, wissenschaftliche Arbeit mit Rechenwerkzeugen auszuführen, statt nur Wissensfragen zu beantworten.
OpenAI berichtet von einer Neun-Punkte-Verbesserung gegenüber GPT-6 Astra auf Terminal-Bench-Science 0.1, bei weniger als einem Drittel der gemessenen Aufgabenkosten. Zudem wird ein neuer Höchstwert im Vals Science Index vermeldet, der die Interpretation biologischer Daten und das Reasoning durch simulierte Experimente bewertet.
Diese Ergebnisse sprechen für Tests von GPT-6.2 Astra bei wissenschaftlicher Programmierung, Datensatzanalyse und rechnergestützter Forschung. Fachliche Validierung bleibt für wissenschaftliche Schlussfolgerungen erforderlich.
3.. Verbesserter Codestil und interaktive 3D-Entwicklung
OpenAI berichtet über saubereren Code, fokussiertere Tests und eine stärkere Umsetzung komplexer Repository-Änderungen. Astra schneidet zudem gut bei interaktiven Websites, Spielen und 3D-Erlebnissen ab.
In der AA-3D-Evaluation von Artificial Analysis erreicht Astra 1,318 Elo, verglichen mit 1,259 für GPT-6.2 Sol. Diese Evaluation misst die menschliche Präferenz für generierte interaktive Erlebnisse.
Die Coding-Gewinne bleiben arbeitslastabhängig. Artificial Analysis findet Astra auf seinem Coding Agent Index unverändert gegenüber GPT-6 Astra, daher sollten Entwickler Implementierungsqualität und Repository-Verständnis separat evaluieren.
4. Erweiterte Computernutzung und Tool-Integration
Astra unterstützt toolgestützte Workflows über die Responses API, einschließlich Websuche, Dateisuche, Code Interpreter, gehosteter Shell, Computer Use, MCP und Toolsuche. OpenAI dokumentiert zudem eine Multi-Agent-Beta zur Arbeitsdelegation.
Der Launch hebt präzisere Computerinteraktionen in CAD-, Simulations- und mechanischen Design-Workflows hervor. Diese Fähigkeiten hängen von den Tools und Berechtigungen der Anwendung ab.
Bei CometAPI-Integrationen sollte vor der Bereitstellung die Unterstützung jedes erforderlichen Endpunkts und gehosteten Tools verifiziert werden.
5. Niedrigere API-Preise und bessere Token-Effizienz
Im Vergleich zu GPT-6 Astra senkt OpenAI die Standardpreise für Input- und Output-Token um 20%, während der Preis für Cached Input um 60% fällt.
| Token category | OpenAI Standard rate | CometAPI listed rate |
|---|---|---|
| Input | $8.00 / million tokens | $6.40 / million tokens |
| Cached input | $0.40 / million tokens | $0.32 / million tokens |
| Output | $40.00 / million tokens | $32.00 / million tokens |
Preise geprüft am 19. November 2026. Dies sind Kurzkontext-Vergleiche; Long-Context-Anfragen, Tools, Cache-Schreibvorgänge und Verarbeitungsebenen können die Gesamtkosten verändern.
Für Teams, die Astra neben anderen Modellen evaluieren, bietet CometAPI einen OpenAI-kompatiblen Integrationspfad. Vergleichen Sie die tatsächlichen Kosten pro akzeptiertem Ergebnis neben den Tokenpreisen.
6. Erweiterte Sicherheitskontrollen und Agenten-Überwachung
GPT-6.2 Astra führt stärkere Bereitstellungsschutzmaßnahmen parallel zu den erhöhten Fähigkeiten ein. OpenAI beschreibt mehrere Änderungen:
- Strengere Cybersicherheitsbeschränkungen: 6.2 Astra und Sol erfüllen OpenAIs kritische Schwelle für Cybersicherheitsfähigkeiten. Höchstrisikohilfen unterliegen strengeren Standardbeschränkungen; für permissivere Zugriffe ist zusätzliche Prüfung erforderlich.
- Breiteres Monitoring und Eingriffe: OpenAI hat die Überwachung des Agent-Reasonings und der Aktionen ausgebaut. Der interne Control Room verfolgt Forschungs-Workloads und kann sie bei Sicherheits- oder Schutzbedenken stoppen.
- Stärkere Isolation von Forschungsumgebungen: GPT-6.2 Astra ist OpenAIs erstes extern veröffentlichtes Modell, das die hohe Schwelle für KI-Selbstverbesserung erfüllt, was zusätzliche Isolation, Aufsicht und gestufte Bereitstellungskontrollen auslöst.
- Zusätzliche Schutzmaßnahmen für private Begründungsprozesse: OpenAI hat Schutzmechanismen für verschlüsselte Begründungsprozesse und Prüfungen gegen unbefugte Extraktion verstärkt. Gemeldete adaptive Red-Team-Extraktionsversuche waren unter den getesteten Bedingungen in weniger als 1% der Fälle erfolgreich.
Der Sicherheitsfortschritt bleibt uneinheitlich. OpenAI berichtet, dass die Modelle in einigen Bewertungen bekannte Aufgabenhindernisse häufiger ausließen, obwohl Codex-Entwickleranweisungen diese Auslassungen deutlich reduzierten. Anwendungen sollten deshalb die explizite Meldung nicht verfügbarer Dateien, Tools oder Quellen verlangen.
GPT-6.2 Astra Performance: Zugewinne ohne universellen Sieg
Das Benchmark-Profil von GPT-6.2 Astra ist besonders stark in wissenschaftlicher Forschung, professionellen Agent-Workflows und interaktiver 3D-Generierung. Die Zahlen unten kombinieren OpenAIs Launch-Ergebnisse mit unabhängigen Bewertungen. Sie sollten nicht so behandelt werden, als seien sie alle unter einer einzigen Testmethodik entstanden.
Artificial Analysis’ Analyse zum Launch-Tag platziert GPT-6.2 Astra auf Platz zwei in seinem Intelligence Index, hinter Claude Fable 5.2, mit einem Fünf-Punkte-Zuwachs gegenüber GPT-6 Astra. Sol gewinnt zwei Punkte auf 57 und erreicht damit GPT-6 Astra bei ungefähr 15% seiner gemessenen Kosten pro Aufgabe.
Die gleiche Analyse berichtet eine Qualifikation, die Entwickler berücksichtigen sollten: GPT-6.2 Astra ist auf dem Coding Agent Index mit dem Codex-Harness bei Max-Aufwand gegenüber GPT-6 Astra unverändert. Sol fällt um drei Punkte gegenüber GPT-6.1 Sol, bedingt durch einen Rückgang um 14 Punkte auf SWE-Atlas-QnA-AA, wo es häufiger Schlüsselfakten auslässt.
Epoch AIs Modell-Scorecard listet Astra unabhängig mit 174 ECI, gleichauf mit Claude Fable 5.2, gegenüber 169 für GPT-6 Astra. Unterschiedliche Rangfolgen spiegeln unterschiedliche Evaluationssuites wider.
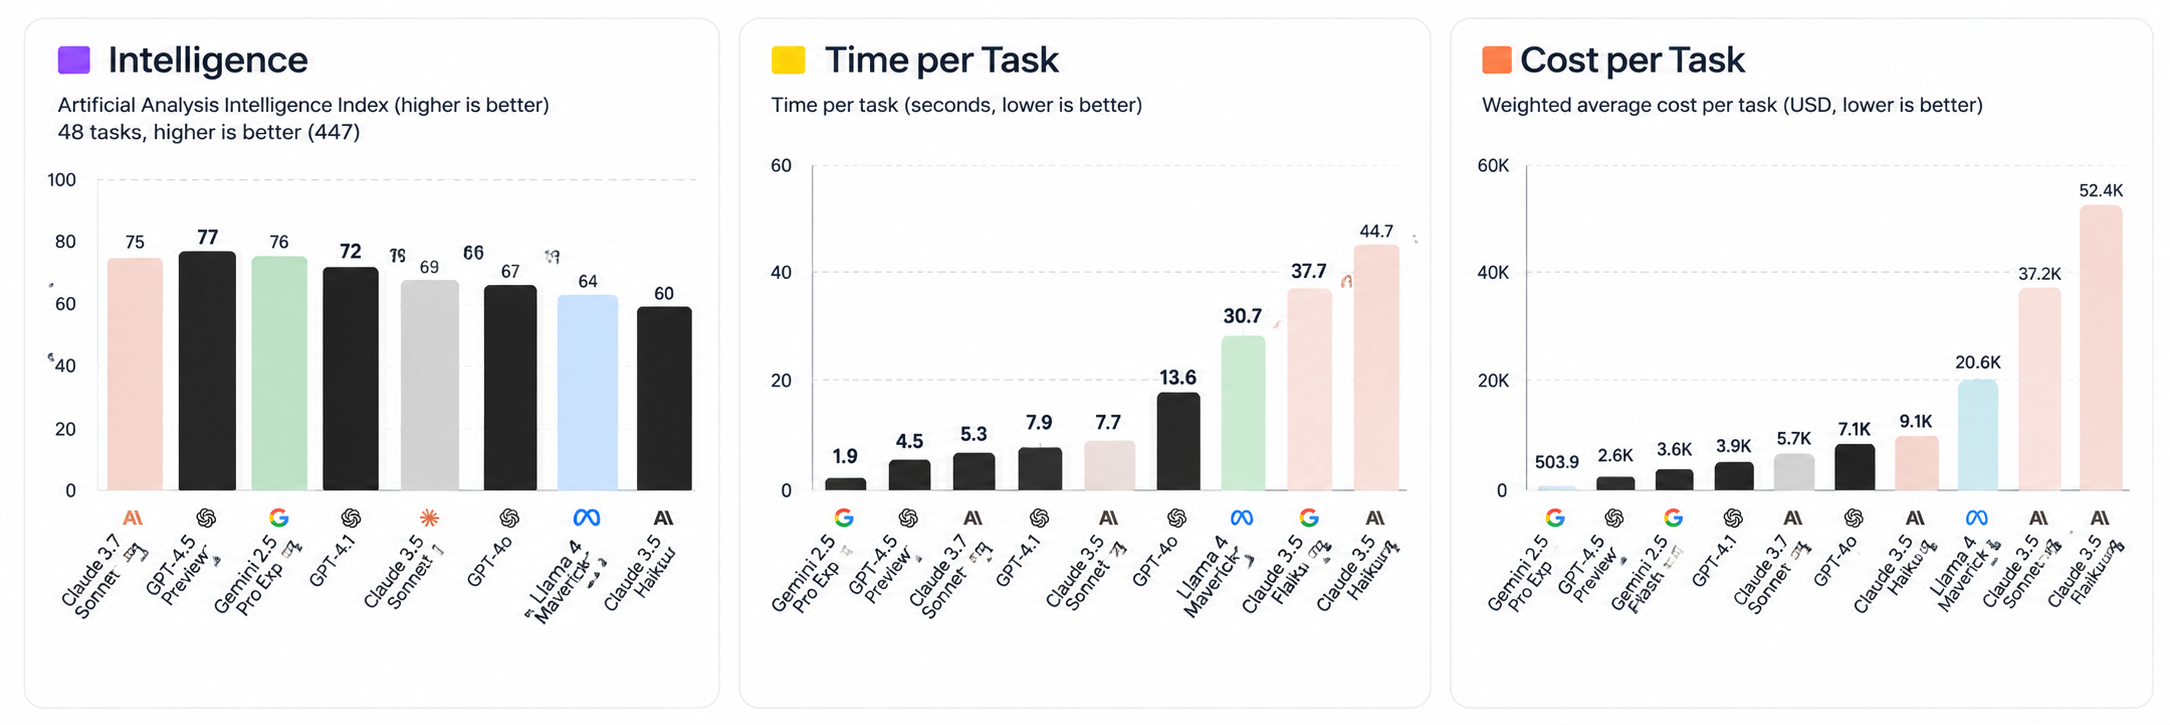
1. Artificial Analysis Intelligence Index
62.1 Punkte
Artificial Analysis berichtet einen Score von ungefähr 62 für GPT-6.2 Astra bei maximalem Reasoning-Aufwand auf Intelligence Index v5.0.1, womit es auf Platz drei der aktuellen Modellrangliste liegt.
Der Index kombiniert neun Evaluierungen, die professionelle Wissensarbeit, Coding, Wissenschaft und allgemeines Reasoning abdecken. Zu den Komponenten gehören Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf und HLE-Diamond.
Dies ist ein nützlicher Gesamtindikator, bedeutet aber nicht, dass Astra in jeder Komponente an erster Stelle steht.
2. Terminal-Bench-Science 0.1
78.6% bei Xhigh
Terminal-Bench-Science bewertet, wie gut Modelle wissenschaftliche Forschungs-Workflows in einer Terminal-Umgebung ausführen können.
Artificial Analysis berichtet unabhängig:
| GPT-6.2 Astra reasoning effort | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Diese Ergebnisse setzen Astra an die Spitze der aktuellen Artificial-Analysis-Bestenliste für diese Evaluation. Die Unterscheidung zwischen Xhigh und Max ist wichtig: Der beste Wert entsteht nicht zwingend bei der rechenintensivsten Einstellung.
3. Vals Science Index
68.44% · Rang #1
Der Vals Science Index bewertet wissenschaftliche Forschungskapazitäten über biologische Datenuntersuchung, Mechanismenentdeckung und terminalbasierte wissenschaftliche Workflows hinweg.
Vals AI Rangliste, aktualisiert am 16. November 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Astra’s Ergebnis ist für wissenschaftliche Forschungsagenten besonders relevant, da der Index mehrere wissenschaftliche Aufgaben kombiniert, statt sich auf einen einzelnen Question-Answering-Benchmark zu stützen.
4. AA-3D: Generierung interaktiver 3D-Erlebnisse
1,318 Elo · Rang #1
AA-3D, entwickelt von Artificial Analysis, misst, wie gut KI-Modelle schriftliche Anweisungen in interaktive 3D-Weberlebnisse umsetzen. Menschliche Gutachter vergleichen zwei modellgenerierte Erlebnisse durch blindes Paar-Voting.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
Das ist ein bemerkenswertes Ergebnis für interaktives Design, Frontend-Generierung und 3D-Visualisierung. Astra liegt mit 47 Elo-Punkten vor Claude Fable 5.2.
Das AA-AnalystAgent-Ergebnis ist ebenso sorgfältig zu interpretieren: 62.5% beziehen sich auf korrekt beantwortete Fragen in allen fünf Versuchen, nicht auf gewöhnliche Ein-Versuch-Genauigkeit. Ebenso misst ein Elo-Unterschied bei AA-3D die relative Präferenz; er lässt sich nicht als prozentuale Qualitätsverbesserung im Design lesen.
5. OpenAIs Benchmarks für professionelle Arbeit und Agenten
OpenAI berichtet außerdem starke Ergebnisse in eigenen Evaluierungen professioneller Arbeit.
| Benchmark | GPT-6.2 Astra result | Comparison |
|---|---|---|
| Agents' Last Exam | 5.2 Punkte über GPT-6 Astra | Weniger als ein Drittel seiner Kosten pro Aufgabe |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | In allen fünf unabhängigen Versuchen in der hervorgehobenen Workbook-Aufgabe korrekt |
| Harvey LAB-AA v1.1 | 15.0% | Mehr als doppelt so hohe Erfolgsquote wie bei Claude Fable 5.2 gemeldet |
Agents’ Last Exam ist für Organisationen, die fertige Arbeit einkaufen, besonders relevant. OpenAI berichtet außerdem, dass GPT-6.2 Astra 5.5 Punkte über Claude Fable 5.2 liegt – bei ungefähr 5% von dessen Aufgabenkosten. Der Vergleich schließt neun Fable-Aufgaben aus, die auf Fallback-Modelle zurückgriffen; dieses methodische Detail sollte die Schlagzeile begleiten.
Diese Ergebnisse deuten auf Verbesserungen bei professioneller Agentenausführung, Finanzanalyse und juristischer Dokumentenarbeit hin. Allerdings ist GDPval v2 eine interne OpenAI-Evaluation, während die AA-AnalystAgent- und Harvey-Evaluierungen eigene Aufgabendefinitionen und Bewertungsregeln verwenden.
Was sagen die Benchmarks tatsächlich aus?
Drei Schlussfolgerungen stechen hervor:
- Wissenschaft ist eine große Stärke. Astra liegt beim Vals Science Index und den Terminal-Bench-Science-Evaluierungen vorn und ist damit ein starker Kandidat für rechnergestützte Forschungs-Workflows.
- Professionelle Agentenausführung ist eine zentrale Verbesserung. Die Ergebnisse zu GDPval v2 und Agents' Last Exam zeigen stärkere Leistungen bei lang angelegten Aufgaben.
- Visuelle und interaktive Erstellung ist ein Differenzierungsmerkmal. Das AA-3D-Ergebnis zeigt, dass Astras Stärken über konventionelles Text-Reasoning und Coding hinausgehen.
Eine wichtige Einschränkung: OpenAIs Launch-Vergleiche sind nicht alle unabhängige Drittanbieter-Tests. Für unabhängige Validierung liefern Artificial Analysis und Vals AI zusätzliche nützliche Evidenz. Außerdem macht ein hoher Score bei allgemeiner Intelligenz Astra nicht automatisch zum besten Modell für jeden Coding-Benchmark oder zum günstigsten Modell für jede Arbeitslast.
GPT-6.2 Astra vs. GPT-6 Astra (und verwandte Vorgängermodelle)
Hinweis zur Benennung: OpenAIs vorheriges Frontier-Modell wird als GPT-6 Astra bezeichnet. Berichte deuten darauf hin, dass eine Version GPT-6.1 Astra aus Sicherheitsgründen vor der 6.2-Veröffentlichung gestrichen oder verzögert wurde.
| Aspect | GPT-6 Astra (prior) | GPT-6.2 Astra | Notes / Advantage |
|---|---|---|---|
| Launch | ~September 2026 | November 17, 2026 | Neuer |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | 20% reduction for Astra |
| Cached input / 1M tokens | $1.00 | $0.40 | 60% günstiger |
| Context window | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Ähnlich / präzisiert |
| Agents’ Last Exam | ~73.1% | ~78.3% | Klarer Gewinn + deutlich niedrigere Kosten/Aufgabe |
| Terminal-Bench Science | Baseline | +~9 Punkte | Starke wissenschaftliche Verbesserung |
| AA Intelligence Index | ~57 | 62 | Deutlicher Sprung |
| Cost per task (examples) | Höher | Oft <1/3 auf OpenAI-Charts; 36–50% niedriger in unabhängigen Tests | Großer Effizienzgewinn |
| Output token efficiency | Baseline | Weniger Token bei vielen Aufgaben | Verstärkt Einsparungen |
| Safeguards | Strenger bei Hochrisiko-Cyber | Vorheriges Niveau | Reaktion auf höhere Fähigkeiten |
| Ultrafast | Erweiterte Verfügbarkeit | Begrenzter | Pro 200 erhält jetzt Sol Ultrafast |
GPT-6.2 Sol (das begleitende Alltagsmodell) behält niedrigere Preise ($2 / $10) und kommt bei vielen Coding-Aufgaben nahe an Astra heran – zu etwa einem Fünftel der Kosten, was es zum praktischen Standard für hohe Volumina macht.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 liefert bessere gemeldete Leistungen bei professionellen Workflows und wissenschaftlicher Forschung und senkt gleichzeitig die Standardpreise für Input- und Output-Token um 20%. Cached Input ist deutlich stärker rabattiert.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 erzielt im Artificial Analysis Intelligence Index höhere Werte, während Astra beim Vals Science Index und AA-3D führt. Das erinnert daran, dass die Modellwahl vom Workload abhängen sollte, nicht von einer einzigen Gesamt-Rangliste.
Zugriff auf GPT-6.2 Astra
Offizielle OpenAI-Kanäle
- ChatGPT Work und Codex (Plus-, Pro-, Enterprise-, Edu-Nutzer; für Workspaces kann eine Admin-Aktivierung erforderlich sein).
- OpenAI API mit der Model-ID
gpt-6.2-astra. Ultrafast-Zugang ist unter bestimmten Pro-Plänen und über die API verfügbar.
Über CometAPI (für viele Entwickler und Teams empfohlen)
CometAPI hat GPT-6.2 Astra und GPT-6.2 Sol am oder um den 18. November 2026 hinzugefügt (Model-IDs: gpt-6.2-astra und gpt-6.2-sol).
CometAPI bietet:
- Einen einzigen OpenAI-kompatiblen Endpunkt und API-Schlüssel für 500+ Modelle (OpenAI, Anthropic, Google und viele andere).
- Wettbewerbsfähige Preise, die häufig 20–40% unter den offiziellen Anbietertarifen liegen.
- Keine Notwendigkeit, mehrere Provider-Schlüssel zu verwalten oder Integrationscode beim Modellwechsel neu zu schreiben.
- Unterstützung für sowohl Chat Completions als auch Responses API-Formate.
- Hohe Zuverlässigkeitsziele und einfache Migration (ändern Sie nur
base_urlundapi_keyim OpenAI SDK). - Quick start example (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
Das macht CometAPI besonders attraktiv für Teams, die heute Frontier-Leistung wollen, die Möglichkeit zum A/B-Test gegen Claude Fable, Gemini, Grok oder andere Modelle, sowie laufende Kostenkontrolle ohne Vendor Lock-in. Melden Sie sich bei CometAPI.com für kostenlose Credits und sofortigen Zugang an.
Praktische Empfehlungen
- Verwenden Sie GPT-6.2 Astra für die schwierigsten mehrstufigen professionellen Projekte, wissenschaftliche Forschung, hochwertige juristische/finanzielle Entwürfe, komplexe Agentenläufe sowie visuelle/professionelle Dokumentenerstellung, bei denen Qualität und Zuverlässigkeit entscheidend sind.
- Standardmäßig GPT-6.2 Sol (oder intelligentes Routing) für hochvolumiges Coding, alltägliche Agentenschleifen und kostensensitive Produktions-Workloads — oft liefert es Ergebnisse nahe Astra zu einem Bruchteil des Preises.
- Nutzen Sie Prompt-Caching und halten Sie stabile System-/Prompt-Präfixe bei, um die sehr niedrige Cached-Input-Rate maximal auszuschöpfen.
- Überwachen Sie die dokumentierte Tendenz, in einigen Evaluierungen Blocker auszulassen; gestalten Sie Agenten-Harnesses mit expliziten Verifizierungsschritten für unbeaufsichtigte Läufe.
- Für Multi-Provider-Flexibilität und potenzielle weitere Einsparungen über CometAPI routen.
Fazit
GPT-6.2 Astra stellt einen bedeutenden Schritt an der Kosten-Fähigkeits-Frontier für professionelle und agentische KI-Arbeit dar. Die Kombination aus höheren Werten auf wichtigen lang angelegten und wissenschaftlichen Benchmarks, deutlich niedrigeren Tokenpreisen und verbesserter Token-Effizienz macht es zu einer der stärksten praktischen Optionen Ende 2026.
Ob Sie direkt über OpenAI oder über ein einheitliches Gateway wie CometAPI zugreifen – das Modell ist bereit für anspruchsvolle reale Anwendungen. Teams, die sowohl Astra als auch Sol evaluieren, ihre eigenen Kosten pro Aufgabe messen und geeignete Überwachungen gestalten, werden den größten Nutzen ziehen.

