
Die lokale Ausführung von Qwen3.8-Max ist inzwischen möglich, aber die Formulierung “Qwen 3.8 Max locally” bedarf einer wichtigen Klarstellung. Alibabas gehostetes Max-Produkt und das herunterladbare Checkpoint sind eng verwandt, aber keine identischen Produkte.
Qwen hat den gehosteten Max-Dienst Anfang August 2026 eingeführt und am 12. August 2026 Qwen3.8-2.4T-A95B als Open Weights veröffentlicht. Dieses Checkpoint ist das Modell, das Sie tatsächlich in Ihrer eigenen Infrastruktur bereitstellen.
Dies ist kein normales Ollama-auf-einem-Gaming-PC-Tutorial. Das unquantisierte Checkpoint ist ein Mixture-of-Experts-Modell mit 2,4 Billionen Parametern, und das aktuelle vLLM-Rezept beziffert seine BF16-Gewichte auf 4,45 TiB. Selbst produktionsorientierte 4-Bit-Gleitkomma-Varianten belegen noch etwa 1,3–1,5 TiB an Gewichten.
Kurzantwort: Vollständiges Self-Hosting der Qwen 3.8 Max-Klasse ist eine Rechenzentrums-Bereitstellung. Ein praktikabler Produktionsstartpunkt ist ein FP4-Checkpoint auf 8× B300 oder 8× MI355X GPUs; H200-Bereitstellungen benötigen mehr GPUs. Für eine normale Workstation verwenden Sie stattdessen Qwen3.8-27B.
Qwen 3.8 Max vs. das offene Modell, das Sie tatsächlich bereitstellen
Das herunterladbare Checkpoint Qwen3.8-2.4T-A95B wird offiziell als kausales Sprachmodell mit 2,4T Parametern beschrieben, von denen pro Token etwa 95B aktiviert sind. Der gehostete Max-Dienst ergänzt produktseitige Funktionen, die im aktuellen offenen Checkpoint nicht vorhanden sind.
| Spezifikation | Qwen3.8-Max gehosteter Dienst | Qwen3.8-2.4T-A95B offenes Checkpoint |
|---|---|---|
| Gesamtparameter | 2.4T | 2.4T |
| Aktive Parameter | ~95B | ~95B |
| Architektur | Sparse MoE | Sparse MoE |
| Eingabe | Text, Bild, Video | Text |
| Kontext | 1M verwalteter Kontext | 262.144 nativ; erweiterbar auf ~1,01M |
| Denkverhalten | Verwaltetes Denken/Non-Thinking-Optionen | Denken erforderlich; Reasoning-Aufwand konfigurierbar |
| Integrierte Tools | Im Managed Service verfügbar | Anwendung muss Tools bereitstellen |
| Self-Hosting | Kein Gewichtsmanagement erforderlich | Ja; offenes Checkpoint |
Das gehostete Produkt bietet Text-, Bild- und Videoeingabe mit einem Kontext von 1.000.000 Tokens. Das offene Checkpoint ist hingegen textbasiert und besitzt nativ 262.144 Tokens Kontext. Dieser Unterschied ist relevant, wenn Ihre Anwendung auf multimodale Eingabe oder verwaltete integrierte Tools angewiesen ist.
Qwen 3.8 Architektur und Spezifikationen
CometAPI behandelt den Modellhintergrund bereits in What is Qwen3.8 Max, daher konzentriert sich diese Bereitstellungsanleitung auf architekturrelevante Details für Speicher, Parallelisierung und Serving.
| Bereitstellungsrelevante Spezifikation | Qwen3.8-2.4T-A95B |
|---|---|
| Gesamt- / aktive Parameter | 2.4T / ~95B pro Token |
| Layer-Layout | 92 Layer: 69 Gated DeltaNet + 23 Full Attention |
| MoE-Routing | 512 geroutete Experten; 10 geroutete + 1 shared aktiv |
| Voll-Attention-Heads | 64 Query- / 4 Key-Value-Heads |
| Nativer Kontext | 262.144 Tokens |
| Erweiterter Kontext | Bis ungefähr 1.010.000 Tokens |
| Multi-Token Prediction | Unterstützt |
| Modalität des Open-Checkpoints | Nur Text |

Offizielle hybride Qwen-Modellarchitektur, verwendet im SGLang Qwen3.8 Deployment-Leitfaden.
Interpretieren Sie “95B aktive Parameter” nicht als Speicherbedarf eines 95B-Modells. Sparse Activation reduziert die Rechenarbeit pro Token, aber das Serving-System benötigt weiterhin Zugriff auf den vollständigen Experten-Gewichtssatz.
Qwen 3.8 Max Benchmark-Überblick
Da die bestehende Qwen3.8 Max-Übersicht von CometAPI Benchmarks bereits ausführlich behandelt, verwendet dieser Artikel nur einen bereitstellungsrelevanten Ausschnitt aus der offiziellen Qwen-Model-Card-Benchmark-Tabelle.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
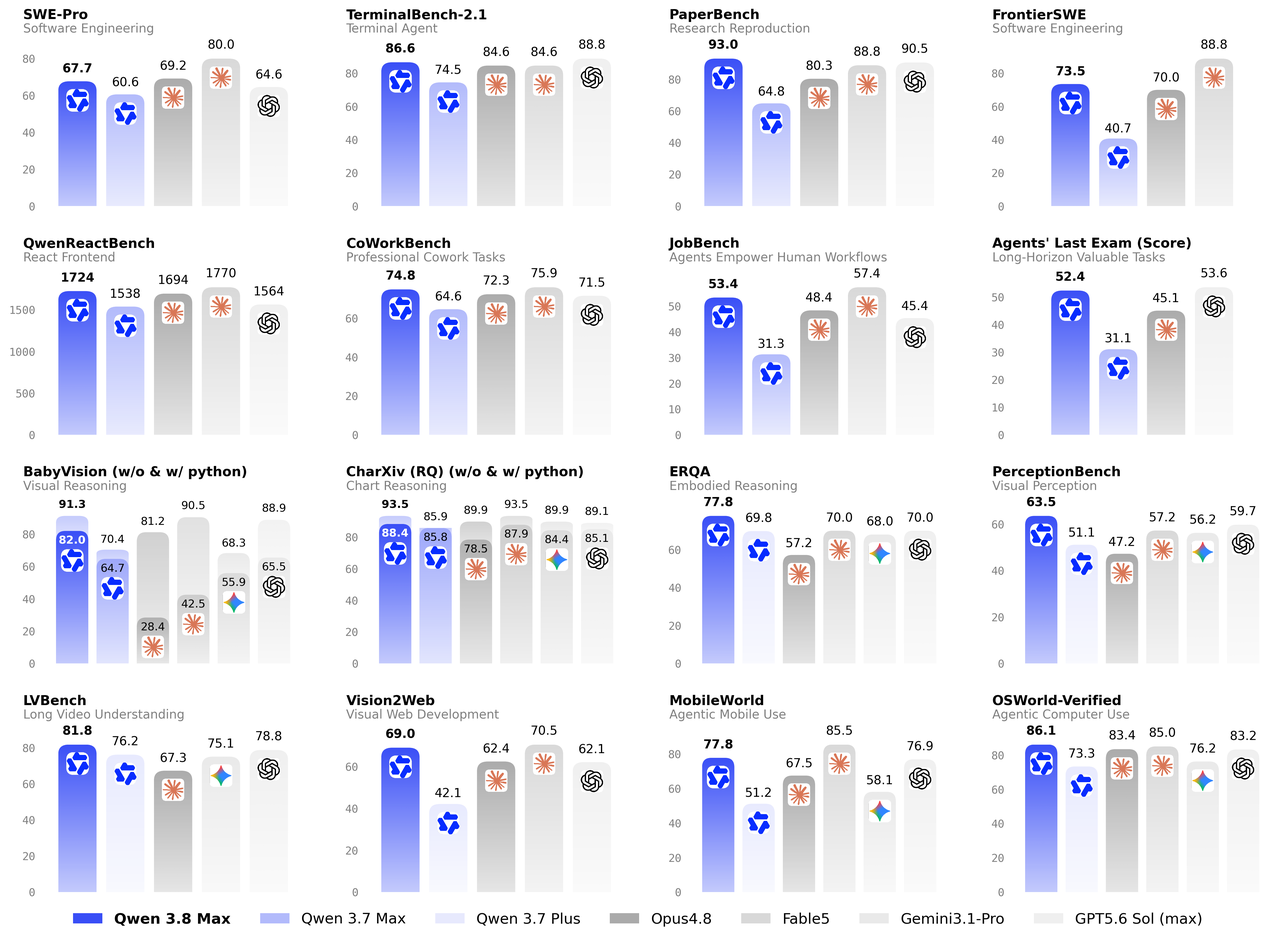
Offizielle Qwen3.8-Performance-Grafik, veröffentlicht vom Qwen-Team.
Die größten gemeldeten Zugewinne gegenüber Qwen3.7-Max in diesem Ausschnitt sind PaperBench und FrontierSWE. Qwen3.8-Max übertrifft zudem GPT-5.6 Sol bei SWE-bench Pro und PaperBench, während GPT-5.6 Sol bei Terminal Bench 2.1 vorne liegt. Für Bereitstellungsentscheidungen dienen diese Werte als Fähigkeitskontext; die untenstehenden Messungen zu Speicher und Serving-Durchsatz sind operativ relevanter.
Benchmark-Tabellen sind keine universellen Ranglisten. Harnesses, Timeouts, Kontextlimits, Toolzugriff und Quantisierung können die Ergebnisse verändern. Benchmarken Sie genau das Checkpoint, die Präzision, den Serving-Stack und die Prompt-Verteilung, die Sie einsetzen wollen.
Welche Hardware benötigt Qwen3.8 für die lokale Bereitstellung?
GPU-Anforderungen für Qwen3.8-2.4T-A95B
Dies ist die zentrale Frage der Bereitstellung. Das aktuelle vLLM-Qwen3.8-Rezept veröffentlicht Gewichts-Footprints des Checkpoints und realistische GPU-Anzahlen mit Laufzeit-Reserve – nützlicher als eine reine VRAM-Abschätzung anhand der Parameterzahl.
| Präzision | Gewichtsspeicherbedarf | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Empfohlene Nutzung |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPUs | 24 GPUs | 48 GPUs | Maximale Wiedergabetreue / Forschung |
| FP8 | 2.27 TiB | 16 GPUs | 16 GPUs | 32 GPUs | Hohe Wiedergabetreue in Produktion |
| MXFP4 | 1.45 TiB | — | 8 GPUs | 16 GPUs | Praktische AMD-Bereitstellung |
| NVFP4 W4A4 | 1.32 TiB | 8 GPUs | — | 16 GPUs | Praktische NVIDIA-Bereitstellung |
Für die meisten Organisationen, die Qwen3.8 wirklich selbst hosten müssen, ist FP4 der praktikable Ausgangspunkt. Die herausragende NVIDIA-Konfiguration ist NVFP4 W4A4 auf 8× B300; der entsprechende AMD-Weg ist MXFP4 auf 8× MI355X.
Ein 8×-H200-Server ist für diese empfohlenen Vollmodell-Bereitstellungen nicht ausreichend. Das offizielle Rezept veranschlagt für den H200 derzeit 16 GPUs für FP4, 32 für FP8 und 48 für BF16.
VRAM-Anforderungen für Qwen3.8-27B
Qwen3.8-27B ist die praktikable Alternative auf Workstation-Niveau. Der reine Gewichtsspeicher beträgt ungefähr 54 GB in BF16, 27 GB in FP8 und 13,5 GB bei 4-Bit-Präzision. Laufzeit-Overhead und KV-Cache erhöhen den tatsächlichen Bedarf, besonders bei langen Kontexten.
| Präzision | Geschätzter Gewichtsspeicher | Praktische Bereitstellungshinweise |
|---|---|---|
| BF16 | ~54 GB | Verwenden Sie je nach Kontext und Serving-Overhead eine 64–80 GB GPU. |
| FP8 / INT8 | ~27 GB | Eine 40–48 GB GPU bietet praktikableren Laufzeitpuffer. |
| 4-bit | ~13.5 GB | Eine 20–24 GB Consumer-GPU kann bei moderaten Kontextlängen ausreichen. |
Diese Zahlen sind Planungsschätzungen aus der Parameterzahl abgeleitet. Bestätigen Sie das exakte Checkpoint, das Quantisierungsformat, den Serving-Stack, die Kontextlänge und die KV-Cache-Einstellungen, bevor Sie Produktionshardware dimensionieren.
Läuft Qwen3.8 auf Consumer-GPUs?
Das vollständige Modell Qwen3.8-2.4T-A95B ist auf gewöhnlichen Consumer-GPUs selbst bei aggressiver Quantisierung nicht praktikabel. Ein Community-Projekt hat einen stark komprimierten 397 GB UD-Q1_0-Build über vier DGX Spark-Systeme demonstriert, doch dieser Weg ist eine experimentelle Extremquantisierung statt einer Basis für qualitätssensitives Serving.
Für eine Workstation oder ein Homelab ist Qwen3.8-27B die passendere Wahl; dessen Open Weights wurden am 14. August 2026 veröffentlicht. Das Modell ist um Größenordnungen einfacher zu hosten und die richtige Option, wenn „lokal“ eine einzelne Workstation statt eines GPU-Clusters bedeutet.
Bevor Sie Qwen 3.8 Max installieren
Planen Sie die Infrastruktur, bevor Sie einen Installationsbefehl ausführen. Sie brauchen Linux, einen kompatiblen Beschleuniger-Stack, genügend lokalen oder geteilten Speicher für das Checkpoint, Hochgeschwindigkeits-GPU-Interconnects und – bei Knotenverbund – ein Netzwerk für verteilte Inferenz. Das vLLM-Rezept empfiehlt derzeit vLLM nightly und Transformers 5.4.0 oder neuer.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Qwen 3.8 in FP8 mit vLLM bereitstellen
FP8 ist eine sinnvolle Wahl, wenn Sie ein von Qwen bereitgestelltes Checkpoint möchten und Multi-Node-Infrastruktur verfügbar ist. Das offizielle Checkpoint ist Qwen/Qwen3.8-2.4T-A95B-FP8.
Für eine Bereitstellung mit zwei Knoten und 16 GPUs der B300-Klasse führen Sie auf dem Head-Knoten aus:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Auf dem Worker-Knoten verwenden Sie die gleiche Topologie mit einer anderen node-rank und ohne API-Server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Übertragen Sie das 16-GPU-Beispiel nicht unverändert auf H200-Server, ohne die Topologie anzupassen. Dieselbe FP8-Variante ist im vLLM-Rezept derzeit mit 32× H200 dimensioniert.
Qwen 3.8 auf einem 8×-B300-Server ausführen
Für NVIDIA Blackwell ist NVFP4 die praktikabelste Vollmodell-Konfiguration. vLLM validiert aktuell NVFP4 W4A4 mit Tensor-Parallelismus über acht B300-GPUs.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Das Inferact-NVFP4-Build ist ein quantisiertes Checkpoint und nicht das ursprüngliche BF16-Qwen-Artefakt. Validieren Sie die Modellqualität anhand Ihres eigenen Akzeptanzsets, bevor Sie es als Ersatz für BF16 oder FP8 betrachten.
Qwen 3.8 mit SGLang bereitstellen
SGLang hat am 12. August Day-0-Support für Qwen3.8 hinzugefügt und ist besonders attraktiv für High-Throughput-Serving, Prefix Caching, Expert-Parallelismus, spekulatives Decoding sowie Prefill/Decode-Disaggregierung.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang meldet 346 Ausgabe-Tokens/s bei Batch-Größe 1 auf TP8 B300 mit MTP und deutlich höheren Gesamtdurchsatz in disaggregierten Serving-Layouts. Betrachten Sie diese Zahlen als Messungen des Serving-Stacks, nicht als Qualitätsbenchmarks des Modells selbst.
Den lokalen OpenAI-kompatiblen Endpoint testen
Sowohl vLLM als auch SGLang stellen OpenAI-kompatible APIs bereit, was die Anwendungsintegration vereinfacht.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Die offizielle Model Card empfiehlt temperature=1.0, top_p=0.95 und top_k=20 als Basis-Sampling-Parameter. Für agentische Aufgaben sollten Sie genügend Output-Budget für Reasoning lassen, statt max_tokens nur für die sichtbare Endantwort zu dimensionieren.
Das 1M-Kontextfenster aktivieren
Das offene Checkpoint Qwen3.8-2.4T-A95B besitzt einen nativen Kontext von 262.144 Tokens und kann auf ungefähr 1,01M erweitert werden. Das vLLM-Rezept dokumentiert folgendes Muster:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Setzen Sie 1M nicht standardmäßig, nur weil es unterstützt wird. Größere maximale Kontexte reservieren mehr Cache-Kapazität und können die Parallelität stark reduzieren. Dimensionieren Sie --max-model-len für die reale Arbeitslast.
Wie lässt sich die Inferenzleistung von Qwen3.8 verbessern?
MTP-3 verwenden, um die Latenz für Einzelnutzer zu reduzieren
Qwen3.8 unterstützt Multi-Token Prediction. In den veröffentlichten vLLM-Messungen steigert MTP-3 die Ausgabe pro Nutzer von 130 auf 307 Tok/s für FP8 TP16 und von 133 auf 304 Tok/s für NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
fastsafetensors für schnelleren Start verwenden
Bei Modellen im Terabyte-Maßstab ist die Startzeit wichtig. In einer vLLM-Messung sank das Laden der Gewichte mit fastsafetensors und Lazy Loading von 545 s auf 306 s.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Expert-Parallelismus nutzen, um gleichzeitigen Durchsatz zu erhöhen
Für hohe Parallelität profitiert Qwen3.8 von Expert-Parallel-Layouts, da es 512 geroutete Experten besitzt. vLLM berichtet bis zu 3.200 Gesamt-Tok/s/GPU für FP8 EP und bis zu 4.300 Gesamt-Tok/s/GPU für eine optimierte NVFP4-DEP16-Konfiguration.
--max-model-len zur Balance zwischen VRAM und Parallelität setzen
Setzen Sie --max-model-len auf die längste Sequenz, die Ihre Arbeitslast wirklich benötigt. Ein größerer Wert reserviert mehr KV-Cache-Kapazität, erhöht den Speicherbedarf und kann die Anzahl paralleler Anfragen reduzieren, selbst wenn die Modellgewichte bereits passen.
Starten Sie mit einem repräsentativen Produktionsperzentil statt dem maximal beworbenen Kontext des Modells. Lasttesten Sie den gewählten Grenzwert mit derselben Präzision, Batch-Charakteristik und demselben Serving-Stack wie in der Produktion, und erhöhen Sie ihn nur, wenn reale Anfragen mehr Kontext benötigen.
Qwen 3.8 Max: lokale Bereitstellung vs. API
Offene Gewichte machen lokale Inferenz nicht automatisch wirtschaftlich. Die richtige Entscheidung hängt von Auslastung, Datenresidenz, Personal, Verfügbarkeitszielen und davon ab, ob Sie die multimodalen Funktionen des Managed-Modells tatsächlich benötigen.
| Dimension | Selbst gehostetes Qwen3.8-2.4T-A95B | Qwen3.8-Max über CometAPI |
|---|---|---|
| Infrastruktur | Multi-GPU-Server oder -Cluster | Keine GPU-Infrastruktur |
| Eingabemodalität | Text | Text, Bild, Video |
| Kontext | 262K nativ; ~1,01M erweitert | Verwaltete 1M |
| Datenkontrolle | Maximal | Cloud-API |
| Betrieb | Monitoring, Upgrades und HA liegen bei Ihnen | Vom Provider gemanagt |
| Am besten geeignet | Datenresidenz, konstante Auslastung, Infra-Team | Die meisten App-Teams und variable Workloads |
Wenn Sie bereits geeignete Beschleuniger besitzen und eine konstant hohe Auslastung haben, kann Self-Hosting gerechtfertigt sein. Wenn Sie einen Cluster nur für dieses Modell anschaffen würden, ist Qwen3.8-Max auf CometAPI normalerweise der reibungslosere Weg. Der bestehende API-Guide deckt die gehostete Integration ab, während der Pricing-Guide die Kostenmodellierung behandelt; dieser Artikel konzentriert sich daher auf die lokale Bereitstellung.
Häufige Probleme bei der lokalen Bereitstellung von Qwen 3.8
Beim Start geht dem Server der GPU-Speicher aus
Reduzieren Sie zuerst --max-model-len, wenn der Cache das Problem ist. Wenn die Gewichte selbst nicht passen, löst die Kontextreduktion die Ursache nicht; wechseln Sie zu einem validierten Checkpoint mit geringerer Präzision oder fügen Sie GPUs hinzu.
Tensor-Parallelismus schlägt mit ungültiger Größe fehl
Qwen3.8 hat 64 Attention-Heads in den Full-Attention-Layern, daher muss TP 64 teilen. Naheliegende TP-Größen sind 1, 2, 4, 8, 16 und 32. Reiner aggregierter VRAM reicht somit nicht aus, um eine Topologie zu wählen.
Der Server benötigt lange zum Starten
Das Laden von ein bis mehreren Terabyte an Gewichten plus Kernel-JIT kann Minuten dauern. Erhöhen Sie VLLM_ENGINE_READY_TIMEOUT_S und prüfen Sie einen realen Inferenz-Endpunkt, statt ein kurzes Startfenster anzunehmen.
Das lokale Modell kann kein Bild verarbeiten
Das ist zu erwarten. Das offene Checkpoint Qwen3.8-2.4T-A95B ist textbasiert. Diese Einschränkung ist spezifisch für Qwen3.8-2.4T-A95B. Qwen3.8-27B unterstützt visuelle Eingaben, wenn dessen separate Vision-Projection-Dateien geladen werden.
1M-Kontext reduziert den Durchsatz drastisch
Reduzieren Sie --max-model-len auf die längste Sequenz, die Ihre Arbeitslast tatsächlich benötigt. Das größte unterstützte Kontextfenster ist nicht zwangsläufig die beste Produktionseinstellung; wählen Sie ein Kontextlimit, das Arbeitslast, KV-Cache-Nutzung und Parallelität ausbalanciert.
Können Ollama oder LM Studio Qwen 3.8 Max ausführen?
Das Ökosystem kann stark quantisierte Qwen3.8-Gewichte für Inferenz im Stil von llama.cpp paketieren, doch das ist nicht mit einem normalen Desktop-Ollama-Workflow zu verwechseln. Ein quantisiertes Build mit Hunderten von Gigabytes benötigt weiterhin Hunderte Gigabytes zugänglichen Speicher und bringt erhebliche Qualitäts- und Performance-Trade-offs mit sich.
Für gewöhnliche lokale Entwicklung ist Qwen3.8-27B das passende Ziel. Das vollständige 2,4T-Modell sollte als Server-/Cluster-Modell betrachtet werden, selbst wenn extreme Community-Quants es technisch auf ungewöhnlicher Hardware startbar machen.
Welche Bereitstellungsmethode sollten Sie wählen?
Für NVIDIA Blackwell ist eine 8× B300 NVFP4-Bereitstellung derzeit der sauberste Vollmodell-Startpunkt. Für AMD ist 8× MI355X mit MXFP4 die entsprechende praktikable Konfiguration. Verwenden Sie FP8, wenn Sie Checkpoint-Provenienz und Qualität über die Größe der Infrastruktur stellen, und BF16 nur dann, wenn maximale Wiedergabetreue die Speicheranforderungen im Multirack-Maßstab rechtfertigt.
Für eine Workstation verwenden Sie Qwen3.8-27B. Für Anwendungsteams, die Max-Funktionen ohne GPU-Clusterbetrieb benötigen, nutzen Sie das gehostete Qwen3.8-Max-Modell auf CometAPI.
Fazit
Qwen3.8-Max hat seit dem ersten API-Launch eine wichtige Grenze überschritten: Die Qwen-Familie der Max-Klasse verfügt nun über ein offenes 2,4T-Checkpoint, das Organisationen vollständig in eigener Infrastruktur betreiben können.
Aber offene Gewichte bedeuten nicht Consumer-Hardware. Der 4,45 TiB BF16-Footprint, das 2,27 TiB FP8-Checkpoint und die 1,3–1,5 TiB FP4-Varianten machen Qwen3.8-2.4T-A95B zu einem der infrastrukturneugierigsten offenen Modelle. Der praktische Vorteil: vLLM und SGLang unterstützen die Architektur bereits, und FP4 ermöglicht eine Ein-Knoten-Bereitstellung mit 8× B300 oder 8× MI355X.
Hosten Sie selbst, wenn Datenkontrolle, nachhaltige Auslastung und Infrastrukturverantwortung den Cluster rechtfertigen. Andernfalls nutzen Sie die Managed-Max-API – oder Qwen3.8-27B, wenn Sie eigentlich ein starkes Qwen-Modell auf einer einzelnen Workstation möchten.