
TL;DR
DeepSeek-V4.1-Flash ist open-weight und kann selbst gehostet werden, aber „lokal“ bedeutet nicht „auf einem Gaming-PC“. DeepSeek beschreibt es als ein 552B-Parameter-Mixture-of-Experts-Backbone mit einer Causal Encoder-Decoder-Architektur, wobei während der Prompt-Verarbeitung nur 8B Parameter aktiv sind und 16B während der Generierung. Das vollständige Modell bleibt ein Ziel für Deployments im Frontier-Maßstab.
Die aktuelle vLLM-Deployment-Anleitung veranschlagt das Checkpoint bei rund 511 GB auf der Festplatte und etwa 614 GB minimalem VRAM, sodass ein Server der Klasse 8×H200 oder ein vergleichbares System mit sehr viel Speicher realistischer ist als eine Consumer-Workstation.
Für Teams, die nur Zugriff statt Weight-Level-Kontrolle benötigen, ist die DeepSeek V4.1 Flash API in CometAPI deutlich einfacher, als einen Multi-GPU-Inferenzserver zu betreiben.
Key Takeaways
- DeepSeek-V4.1-Flash nutzt ein 552B-MoE-Backbone mit 8B aktiven Parametern während Prefill und 16B während Decode; aktive Parameter entsprechen nicht dem Speicherbedarf im Residentspeicher.
- Sein Kontextfenster mit 1.048.576 Tokens und der globale KV-Cache mit 890 Byte pro Token reduzieren den Cache-Druck, aber die Modellgewichte dominieren weiterhin die Kapazitätsplanung.
- Das offizielle Checkpoint ist etwa 511 GB groß. Das vLLM-Rezept schätzt ungefähr 614 GB aggregierten nutzbaren VRAM als Mindestbudget zum Laden des Modells und seines Laufzeit-Overheads; dies ist eine Ausgangsschätzung, keine Garantie für jede Batchgröße, Kontextlänge oder multimodale Konfiguration.
- vLLM ist der klarste Weg für Production Serving, während SGLang auf fortgeschrittene verteilte Inferenz abzielt; Ollamas aktueller Weg ist cloud-gehostet statt vollständig lokal.
- Self-Hosting ist besonders überzeugend für Privacy, air-gapped Betrieb, Forschung auf Weight-Level oder kontinuierliche Clusterauslastung; die meisten Entwickler werden eine gehostete API einfacher finden.
What Is DeepSeek-V4.1-Flash? Architecture, Parameters, and Model Size
DeepSeek hat V4.1-Flash offiziell am 10. September 2026 als kleinstes Modell seiner neuen Architekturfamilie mit nativer visueller Verständigkeit veröffentlicht. Trotz des Namens „Flash“ ist es kein kleines dichtes Modell.
Seine wichtigste architektonische Neuerung ist das Causal Encoder-Decoder (CED)-Design. Das Modell teilt die Berechnung asymmetrisch zwischen Prompt-Aufnahme und Token-Generierung auf, reduziert aktive Rechenleistung und behält gleichzeitig einen sehr großen Expertenpool.
| Specification | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | Multimodal MoE mit Causal Encoder-Decoder |
| Backbone parameters | 552B |
| Active parameters, input | 8B |
| Active parameters, output | 16B |
| Transformer layers | 40: 20 Encoder + 20 Decoder |
| Context window | 1,048,576 Tokens |
| Global KV cache | 890 Bytes/Token |
| Modalities | Texteingabe + Bildeingabe, Textausgabe |
| Weight license | MIT |
| Recommended sampling | Temperature 1.0; top_p 0.95 oder 1.0 |
| Official weights | Hugging Face |
| Primary local serving options | vLLM, SGLang, DeepSeek Referenz-Inferenz |
Die Unterscheidung zwischen aktiven Parametern und residenten Parametern ist entscheidend. MoE-Routing reduziert die für ein einzelnes Token verwendete Rechenmenge, aber der Server benötigt weiterhin Zugriff auf die Expertengewichte, die ausgewählt werden könnten. Daher kann ein „8B aktives“ Modell dennoch Hunderte Gigabyte Speicher- und Beschleunigerspeicher benötigen.
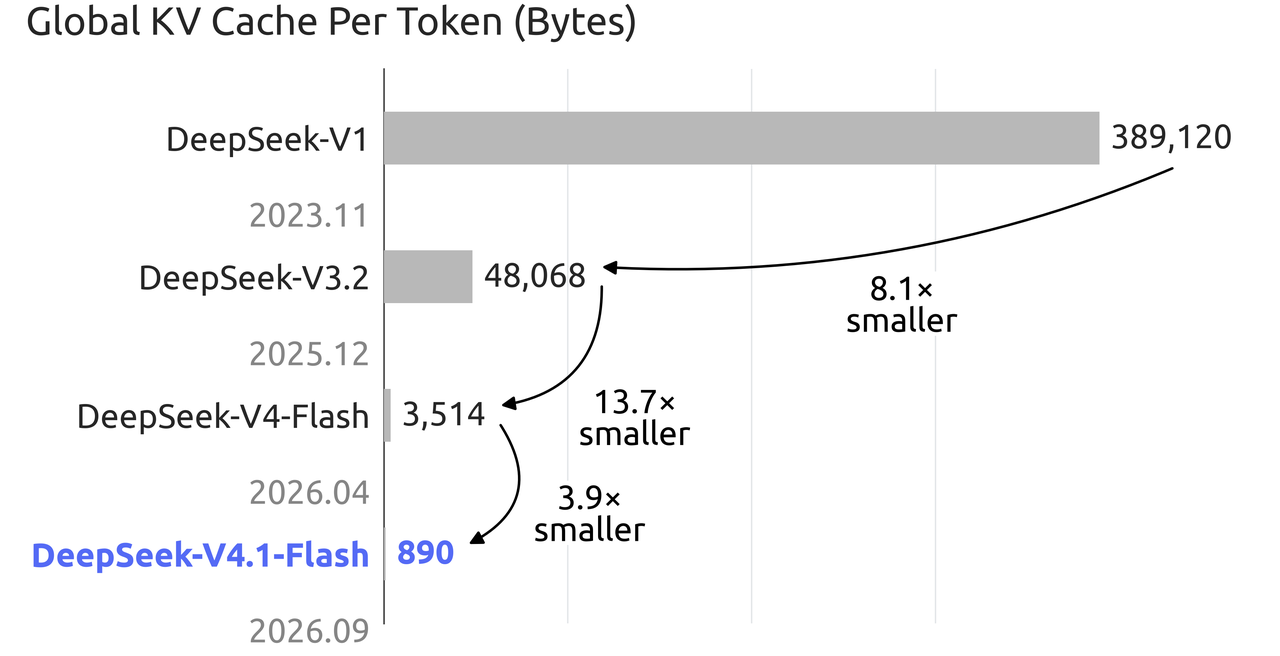
DeepSeeks offizielles KV-Cache-Diagramm zeigt, dass der globale Cache von 3.514 Bytes pro Token in V4 Flash auf 890 Bytes pro Token in V4.1 Flash fällt, eine Reduktion um etwa 3.9×. Das ist relevant für Million-Token-Inferenz, eliminiert aber nicht den deutlich größeren Speicherbedarf durch die Modellgewichte selbst.
How Good Is DeepSeek-V4.1-Flash Before You Deploy It?
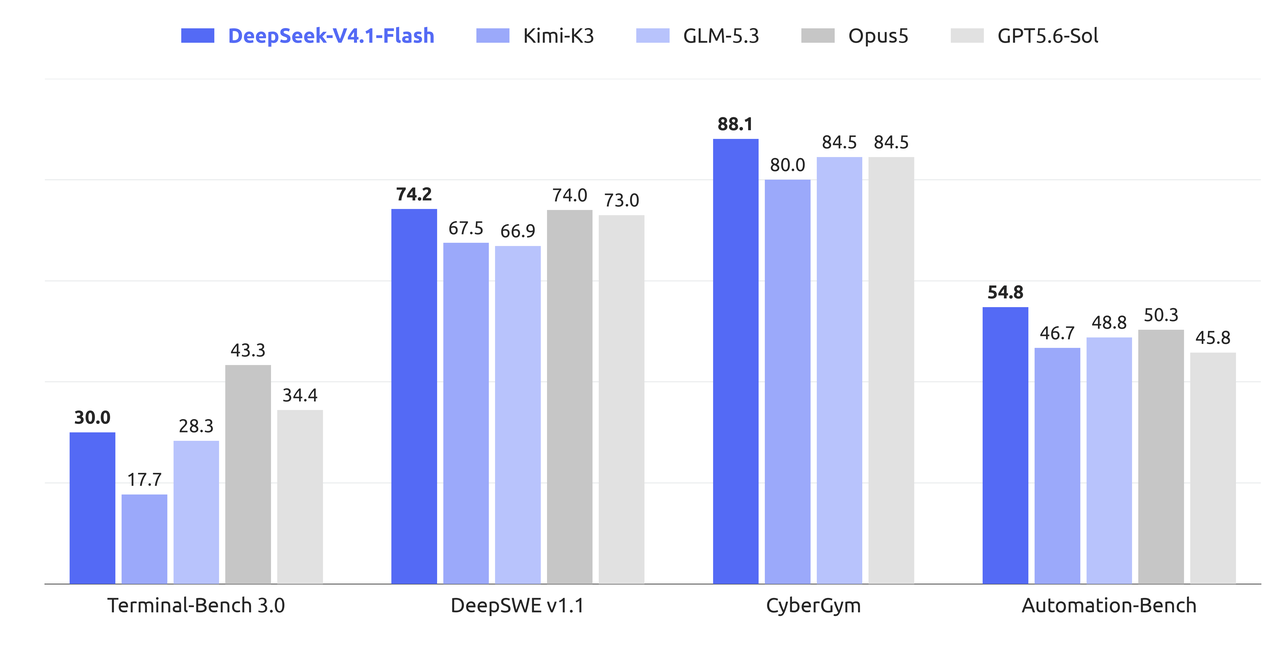
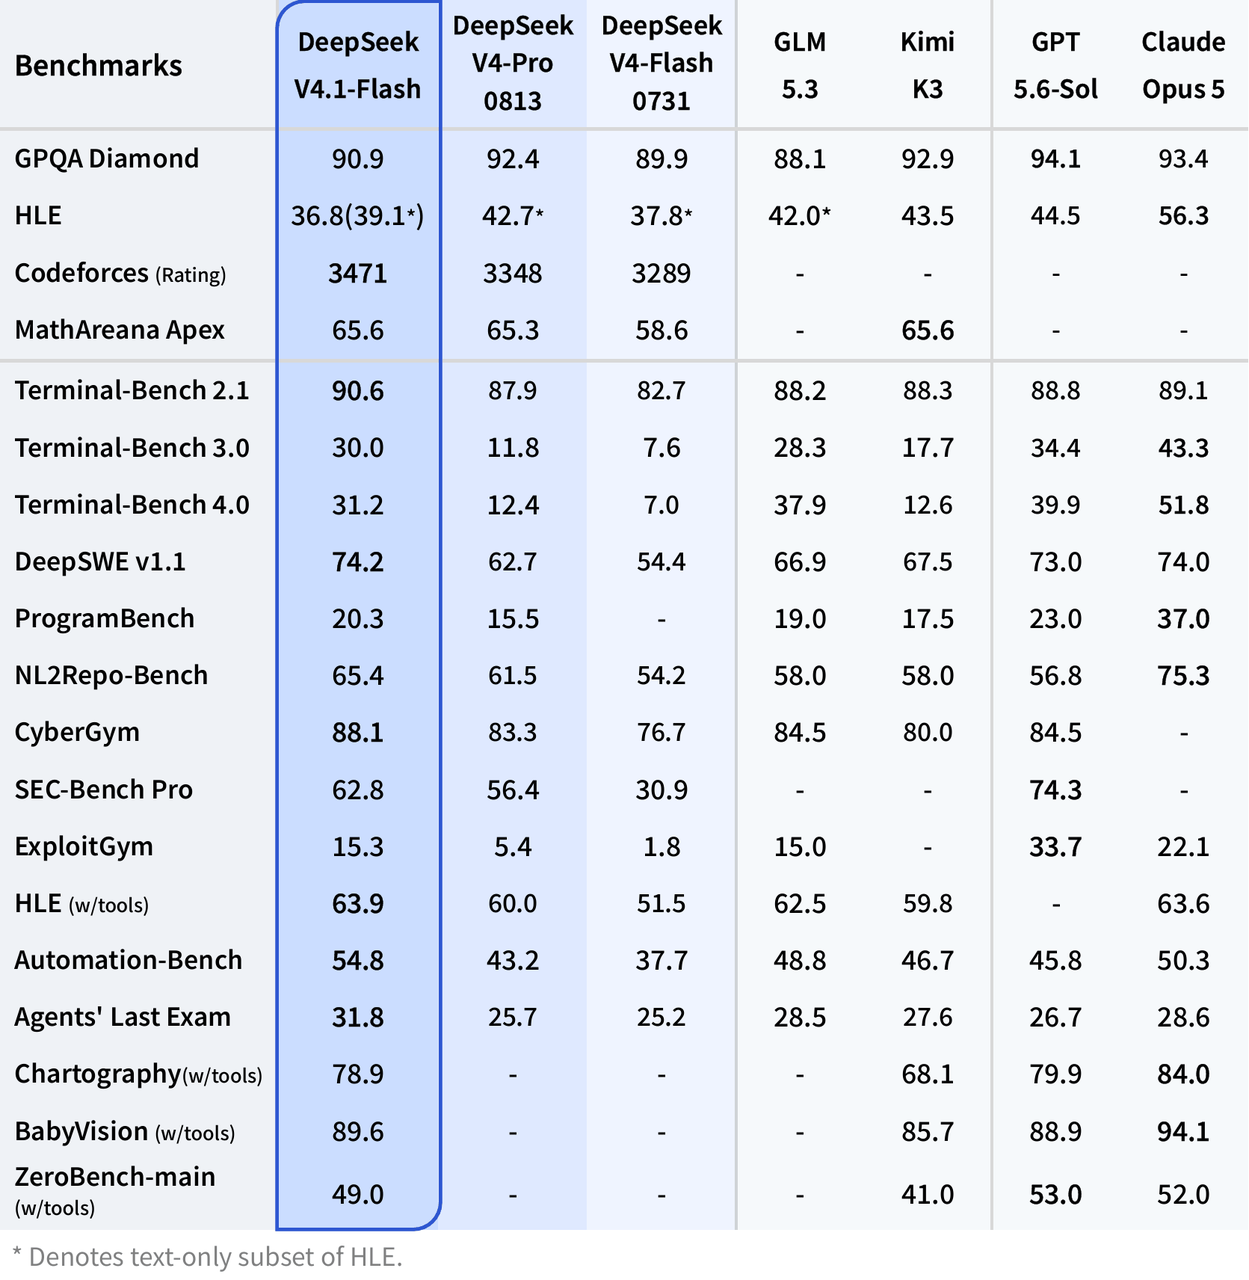
DeepSeeks veröffentlichte Benchmark-Tabelle positioniert V4.1-Flash primär als großes Upgrade für agentisches Codieren, Terminal-Bedienung, Automatisierung und Software-Engineering-Workloads. Dies sind vendor-reported Benchmark-Ergebnisse, daher sollten sie als Referenzmessungen behandelt werden, nicht als garantierte Anwendungsleistung.
Zur Reproduzierbarkeit empfiehlt die offizielle Model Card Temperature 1.0 und top_p 0.95, während Reasoning-Aufwand und Token-Budgets je nach Evaluation variieren. Die folgenden Zahlen sind vom Anbieter ausgeführte Referenzergebnisse, keine hardware-neutralen Leistungszusagen; benchmark-spezifische Harness-Details sollten vor der Reproduktion konsultiert werden.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Das Muster ist wichtiger als einzelne Werte. V4.1-Flash führt nicht jeden Benchmark an, aber der Sprung von V4 Flash 0731 ist insbesondere bei Terminal-Bench, DeepSWE, Automatisierung und Cybersecurity groß. Das macht lokale Deployments besonders relevant für private Coding-Agents, Analysen auf Repository-Ebene, interne Automatisierung und air-gapped Agent-Infrastruktur.
Can You Really Run DeepSeek-V4.1-Flash Locally?
Ja, aber das Wort „lokal“ braucht Einordnung. Das aktuelle vLLM-Rezept für DeepSeek-V4.1-Flash zerlegt das Checkpoint auf etwa ein halbes Terabyte und empfiehlt ein deutlich größeres VRAM-Budget, sobald Laufzeit-Overheads einbezogen werden.
| Component | Approximate stored size |
|---|---|
| Routed + DSpark experts | 259.5 GiB |
| Engram tables | 183.1 GiB |
| Attention, dense projections and routers | 6.9 GiB |
| Embeddings, LM head and norms | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| Full checkpoint | ~476 GiB / ~511 GB |
| vLLM recommended minimum VRAM budget | ~614 GB |
Die wesentliche Überraschung ist, dass V4.1-Flash intern bereits stark komprimiert ist. Routed-Expert-Gewichte nutzen Niedrigpräzisionsformate, daher ist das offizielle Checkpoint nicht einfach ein riesiges BF16-Modell, das sich leicht in 4-Bit konvertieren lässt.
DeepSeek-V4.1-Flash Hardware Requirements
| Hardware configuration | Practical status | Comments |
|---|---|---|
| 1× RTX 4090 / 5090 | No | Weit unter dem Speicherbedarf des Modells |
| 2–4 consumer GPUs | No for the official full checkpoint | Aggregierter VRAM bleibt unzureichend |
| 128 GB workstation | No | Aktive Parameter bestimmen nicht den residenten Gewichtsspeicher |
| 256 GB workstation | No for official serving path | Immer noch deutlich unter dem Footprint des offiziellen Checkpoints |
| 512 GB system RAM + GPU offload | Experimental | Community-/Offload-Bereich, nicht gleichbedeutend mit verifiziertem Prod-Serving |
| 4× high-memory datacenter GPUs | Hardware-dependent | Möglich mit ausreichend großen modernen Beschleunigern; Laufzeit-Rezept prüfen |
| 8× H200 | Yes, documented class | Rund 1.128 GB aggregiertes HBM |
| GB200 NVL4-class system | Yes | vLLM nennt ein 768-GB-Tray, das das Modell aufnehmen kann |
Wichtig: 8B aktive Parameter bedeuten nicht 8 GB VRAM. „Aktiv“ beschreibt, wie viel des MoE-Netzwerks bei der Berechnung eines Tokens beteiligt ist. Der vollständige Expertenbestand muss dennoch irgendwo für die Inferenz-Engine zugänglich gespeichert werden.
Which Runtime Should You Use for DeepSeek-V4.1-Flash?
| Runtime | Current V4.1-Flash status | Best use |
|---|---|---|
| vLLM | Aktuelles Deployment-Rezept verfügbar; aktuelles Image nötig | Production-Serving mit OpenAI-kompatibler API |
| SGLang | Unterstützt durch aktuelle DeepSeek-V4.1-Deployments | Hochleistungsfähige verteilte Inferenz |
| DeepSeek reference inference | Offizielle TP8-Referenzimplementierung | Architekturforschung und Validierung |
| Transformers | Model-Integration auf Hugging Face | Entwicklung und Experimente; Hardware weiterhin erforderlich |
| Ollama | Offizieller Library-Weg nutzt derzeit :cloud | Bequeme Cloud-Nutzung, nicht gleichbedeutend mit Self-Hosting |
Für Production-Self-Hosting ist vLLM derzeit der klarste Ausgangspunkt. SGLang-Deployment-Hinweise bieten einen weiteren unterstützten Pfad für fortgeschrittene verteilte Inferenz.
How to Run DeepSeek-V4.1-Flash Locally with vLLM
Dies ist der praktische Weg für einen Multi-GPU-Linux-Server.
Alle Befehlsbeispiele unten sind als sprachspezifische Code-Blöcke mit kurzen englischen Beschreibungen formatiert.
Step 1: Check Your Environment
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Mehrere hundert Gigabyte freier SSD-Speicher.
- Eine unterstützte Multi-GPU-Konfiguration.
- Etwa 614 GB aggregierter nutzbarer Beschleunigerspeicher für das aktuelle offizielle Weight-Serving-Profil.
- Ein schnelles Netzwerk, falls das Modell nicht bereits lokal gecacht ist.
Step 2: Download the DeepSeek-V4.1-Flash Weights
Die offiziellen Gewichte liegen im Hugging-Face-Repository DeepSeek-V4.1-Flash unter MIT-Lizenz.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Stellen Sie sicher, dass das Dateisystem, das ~/.cache/huggingface beherbergt, deutlich mehr als 511 GB frei hat. Temporäre Dateien und zusätzliche Engine-Artefakte können die Spitzenbelegung erhöhen.
Step 3: Start DeepSeek-V4.1-Flash with vLLM
Gemäß dem aktuellen vLLM-Rezept erfordert die Unterstützung von DeepSeek-V4.1 ein ausreichend aktuelles vLLM-Image. Eine text-only Acht-GPU-Startkonfiguration kann so aussehen:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Hier gibt es zwei bewusste Entscheidungen. Erstens deaktiviert --language-model-only den Vision-Encoder für reine Text-Workloads. Zweitens ist der Start mit 131.072 Tokens sicherer, als sofort den vollen 1-Million-Token-Kontext zu aktivieren. Sobald der Server stabil ist, können Sie erhöhen:
--max-model-len 1048576
Die passende Tensor-Parallel-Einstellung hängt von der Accelerator-Topologie ab, also kopieren Sie --tensor-parallel-size 8 nicht blind auf jeden Server.
Step 4: Test the Local DeepSeek-V4.1-Flash Endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Step 5: Call Your Local DeepSeek-V4.1-Flash Server with Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
How Do You Enable DeepSeek-V4.1-Flash Thinking Mode Locally?
V4.1-Flash unterstützt explizite Reasoning-Steuerungen über seine Chat-Vorlage. Ein Beispiel ist:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Wenn das Modell bei kleinem max_tokens-Wert wenig oder keinen finalen Inhalt zurückgibt, prüfen Sie, ob der Thinking-Modus das Generierungsbudget verbraucht, bevor Sie von einem fehlerhaften Deployment ausgehen.
How Do You Run DeepSeek-V4.1-Flash with Reference Code?
DeepSeek enthält zudem eine minimale TP8-Inferenzimplementierung im Modell-Repository. Sie ist primär als gut lesbarer Referenzcode gedacht, nicht als hochdurchsatzfähiger Produktionsserver.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Dieser Weg ist nützlich, um CED, MoE-Routing, Engram-Speicher, spekulatives Decoding und verwandte Implementierungsdetails zu inspizieren. Für normales Production-Serving sind vLLM oder SGLang einfacher zu betreiben.
Can You Run DeepSeek-V4.1-Flash Locally with Ollama?
Nicht im gleichen Sinne wie ein normales 7B- oder 32B-Ollama-Modell. Ollama exponiert V4.1-Flash derzeit über:
ollama run deepseek-v4.1-flash:cloud
Wichtig ist :cloud. Der aktuelle Ollama-Library-Eintrag nutzt einen Cloud-Weg, daher ist dieser Befehl nicht gleichbedeutend damit, das vollständige Modell herunterzuladen und die Inferenz vollständig auf Ihrer eigenen Maschine auszuführen.
DeepSeek-V4.1-Flash Local Deployment vs API: Which Makes More Sense?
| Dimension | Local DeepSeek-V4.1-Flash | Hosted API |
|---|---|---|
| Up-front hardware | Sehr hoch | Keine |
| Accelerator memory | ~614 GB praktisches offizielles Ziel | Vom Anbieter gemanagt |
| Model control | Vollständig | Begrenzt |
| Data stays on premises | Ja | Nein |
| Weight modification | Ja | Nein |
| Maintenance | Ihre Verantwortung | Anbieter-gemanagt |
| Setup complexity | Hoch | Niedrig |
| Scaling | Erfordert Infrastruktur | API-basiert |
| Best for | Air-gapped, privat, Forschung, hoch ausgelastete Cluster | Die meisten Entwickler und Prod-Apps |
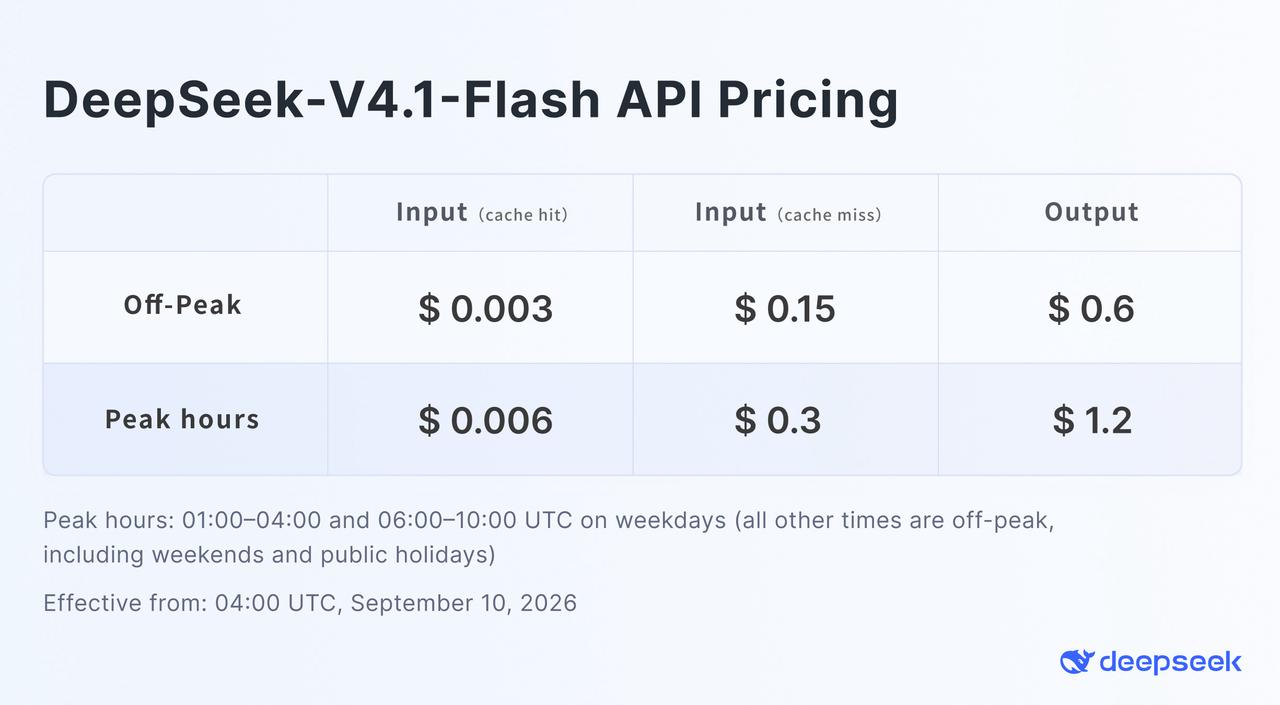
DeepSeeks offizielles Off-Peak-Pricing ist in seiner V4.1-Flash-Preistafel dargestellt. Für Entwickler, die die Gewichte nicht physisch besitzen müssen, bietet die DeepSeek V4.1 Flash API in CometAPI eine OpenAI-kompatible Alternative.
Das folgende Beispiel verwendet die Modellkennung von CometAPI. Es ist nicht die Kennung, die in DeepSeeks offizieller API verwendet wird.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Die praktische Entscheidung ist klar: Lokales Deployment wird dann überzeugend, wenn Privacy, air-gapped Betrieb, Experimente auf Weight-Level, planbare starke Auslastung oder regulatorische Anforderungen die Infrastrukturkosten überwiegen. Für normale Anwendungsentwicklung vermeidet ein gehosteter Endpunkt hunderte Gigabyte Modellmanagement und Multi-GPU-Orchestrierung.
What Problems Can You Encounter When Running DeepSeek-V4.1-Flash Locally?
The server runs out of memory before generation starts
Das vollständige Checkpoint, nicht die Zahl 8B/16B aktiver Parameter, bestimmt den größten Teil des Speicherbedarfs. Prüfen Sie Tensor-Parallelismus, GPU-Speicherauslastung, Vision-Laden und verfügbares HBM.
DeepSeek-V4.1-Flash takes a long time to start
Ein halbes Terabyte Checkpoint benötigt Zeit zum Herunterladen, Mappen, Initialisieren und Sharden. Lange Engine-Ready-Timeouts sind bei dieser Modellklasse normal.
The response is empty or ends with finish_reason=length
Der Thinking-Modus könnte das Generierungsbudget verbrauchen. Erhöhen Sie max_tokens, senken Sie den Reasoning-Aufwand oder deaktivieren Sie Thinking für einfache Anfragen.
Tool calls do not parse correctly
Stellen Sie sicher, dass der Server den DeepSeek V4.1 Tokenizer, den Tool-Call-Parser, den Reasoning-Parser und die Auto-Tool-Choice-Flags verwendet.
Vision input does not work
Wenn Sie mit --language-model-only gestartet haben, wurde der visuelle Encoder absichtlich deaktiviert. Starten Sie mit aktivierter Multimodal-Unterstützung neu, bevor Sie Bilder testen.
Should You Run DeepSeek-V4.1-Flash Locally?
DeepSeek-V4.1-Flash ist aus Self-Hosting-Sicht ungewöhnlich interessant, weil seine Architektur den pro-Token-Compute und die KV-Cache-Kosten deutlich reduziert, es aber kein Frontier-Open-Weight-Modell in ein Desktop-Modell verwandelt.
Für ein Forschungslabor, eine Enterprise-AI-Plattform, einen privaten Coding-Agent-Stack oder eine air-gapped Umgebung machen vLLM und SGLang Self-Hosting technisch realistisch. Für einen Entwickler mit ein oder zwei GPUs ist es kein praktisches Full-Model-Deployment-Ziel. In diesem Fall liefert die Nutzung von DeepSeek V4.1 Flash über CometAPI Zugriff auf das Modell, ohne Serving in ein großes Infrastrukturprojekt zu verwandeln.
FAQ
Is DeepSeek-V4.1-Flash open source?
Seine Modellgewichte und das Repository sind unter der MIT-Lizenz veröffentlicht, die breite Nutzung, Modifikation und Weiterverbreitung gemäß den Lizenzbedingungen erlaubt.
Can I run DeepSeek-V4.1-Flash on an RTX 4090 or RTX 5090?
Nicht das offizielle vollständige Modell. Eine einzelne Consumer-GPU hat nur einen Bruchteil des für das vollständige Checkpoint erforderlichen Speichers.
Does 8B active parameters mean DeepSeek-V4.1-Flash only needs 8 GB of VRAM?
Nein. Die 8B-Zahl beschreibt die während der Prompt-Verarbeitung beteiligten Parameter. Das vollständige Expertennetz und unterstützender Zustand müssen weiterhin gespeichert und zugänglich sein.
How much VRAM does DeepSeek-V4.1-Flash need?
Das aktuelle vLLM-Rezept nutzt etwa 614 GB als Planungsgröße für das offizielle Checkpoint plus Laufzeit-Overhead. Der tatsächliche Bedarf variiert mit Hardware, Batchgröße, Kontext, Vision-Unterstützung und Serving-Konfiguration.
How large is DeepSeek-V4.1-Flash on disk?
Die aktuelle vLLM-Aufschlüsselung veranschlagt das Checkpoint mit rund 476 GiB bzw. etwa 511 GB.
Can DeepSeek-V4.1-Flash run a 1M-token context locally?
Die Architektur unterstützt bis zu 1.048.576 Tokens, aber der praktische Speicherverbrauch hängt auch von Batchgröße, Laufzeitpuffern, Vision-Zustand und weiterem Overhead ab.
Can I run DeepSeek-V4.1-Flash locally with Ollama?
Der aktuelle Ollama-Eintrag nutzt einen :cloud-Weg, was nicht dem entspricht, die vollständigen Gewichte vollständig auf Ihrer eigenen Maschine laufen zu lassen.
Is vLLM or SGLang better for DeepSeek-V4.1-Flash?
Beide zielen auf leistungsstarkes Serving. vLLM hat derzeit ein besonders detailliertes V4.1-spezifisches Rezept, während SGLang ebenfalls für fortgeschrittene verteilte Deployments geeignet ist.
What is the easiest way to use DeepSeek-V4.1-Flash without local hardware?
Verwenden Sie eine gehostete API. DeepSeek stellt eine eigene API bereit, während CometAPI einen OpenAI-kompatiblen DeepSeek-V4.1-Flash-Endpunkt neben anderen AI-Modellen bietet.