
Der schnellste Weg, die GLM-5.3 Flash API zu nutzen, ist, das Modell über CometAPIs OpenAI-kompatiblen Chat-Completions-Endpunkt aufzurufen. Die Verbindungsdetails sind in der untenstehenden API-Spezifikationstabelle zusammengefasst; bewahren Sie den API-Schlüssel auf dem Server auf.
Antwort zuerst: Erstellen Sie einen CometAPI-Schlüssel, installieren Sie ein OpenAI-kompatibles SDK, senden Sie eine POST-Anfrage an /v1/chat/completions und fügen Sie Streaming, Vision, JSON-Ausgabe oder Tools erst hinzu, nachdem die Basisanfrage erfolgreich ist.
Was ist die GLM-5.3 Flash API?
GLM-5.3 Flash ist Z.ais effizienzorientiertes, natives multimodales Modell aus der GLM-5-Familie. Es stellt über eine Chat-API Funktionen für Reasoning, langen Kontext, visuelles Verständnis und agentenorientierte Fähigkeiten bereit. Das Modell enthält 320B Gesamtparameter, aktiviert jedoch 18B pro Token; diese Architektur ist für die Kosten wichtig, aber Entwickler erleben sie vor allem als ein Modell, das bei langen Prompts und wiederholten Tool-Aufrufen aktiv bleiben kann.
Dieser Leitfaden hält Architektur- und Benchmark-Abdeckung bewusst kurz. Der begleitende Modellüberblick erklärt bereits das Hybrid-Attention-Design, Open Weights, die vollständige Start-Benchmark-Matrix, Preisgestaltung und den Modellfamilienvergleich. Hier liegt der Fokus auf Integrationsverhalten und Produktionsentscheidungen.
API-Spezifikationen, die die Integration beeinflussen
| API specification | Value | Practical meaning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Einmalig im serverseitigen Client konfigurieren. |
| Endpoint | POST /v1/chat/completions | Den OpenAI-kompatiblen Chat-Completions-Route verwenden. |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | Vertraute Client-Muster mit der CometAPI Base-URL wiederverwenden. |
| Authentication | Bearer API key | Schlüssel in einer serverseitigen Umgebungsvariable oder einem Secret Manager aufbewahren. |
| Model code | glm-5.3-flash | Genau diesen Wert im Request-Body verwenden. |
| Context window | 1,048,576 tokens | Geeignet für große Repositories, Dokumentpakete und lange Agent-Historien. |
| Maximum output | Up to 131,072 tokens | Eine niedrigere, anwendungsspezifische Obergrenze setzen, um Kosten und Latenz zu steuern. |
| Native inputs | Text, image, video, file | Unterstützung je Route kann variieren; die genaue CometAPI-Route vorab für jede Modalität prüfen. |
| Output | Text | Das Modell interpretiert Medien, gibt aber keine generierten Bilder oder Videos direkt zurück. |
| Reasoning | low, high, max | Anstrengungsstufen nutzen, um Latenz und Tokenverbrauch gegen Tiefe abzuwägen. |
| Thinking | Always enabled | Keinen Parameter senden, der versucht, Thinking zu deaktivieren. |
| Developer features | Streaming, function calling, caching, structured output | Nützlich für interaktive Apps, Agenten und maschinenlesbare Pipelines. |
Modellfähigkeit und Gateway-Fähigkeit sind nicht identisch. Betrachten Sie die aktuelle CometAPI-Modellseite und das API-Schema als den Vertrag für die Route, die Sie tatsächlich aufrufen, insbesondere für Video, Dateien, striktes JSON Schema und providerspezifische Thinking-Felder.
Kurzer Performance-Kontext
Z.ai berichtet starke Startresultate bei Aufgaben, die für API-Builder relevant sind: Terminalarbeit, Software Engineering, Toolnutzung und Automatisierung. Dies sind vom Anbieter gemeldete Werte, die mit spezifischen Harnesses und Tool-Policies erzielt wurden; sie helfen, wahrscheinliche Stärken zu identifizieren, ohne eine universelle Rangfolge festzulegen.
| Benchmark | GLM-5.3 Flash | What it suggests for API workloads |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Gute Eignung für terminalgetriebene Coding-Agenten. |
| DeepSWE v1.1 | 63.4 | Vielversprechend für Repository‑Skalen Software Engineering. |
| Toolathlon Verified | 78.4 | Starkes Signal für Tool-Auswahl und -Nutzung. |
| AutomationBench | 48.8 | Verbesserte mehrstufige Automatisierung gegenüber dem Vorgänger. |
Die praktische Implikation ist enger als die Benchmark-Tabelle: GLM-5.3 Flash ist ein starker Kandidat, wenn der Workflow langen Kontext mit Tools oder visuellem Feedback kombiniert. Für einen vollständigen Modellvergleich nutzen Sie den bestehenden Modellüberblick statt ihn hier zu duplizieren.
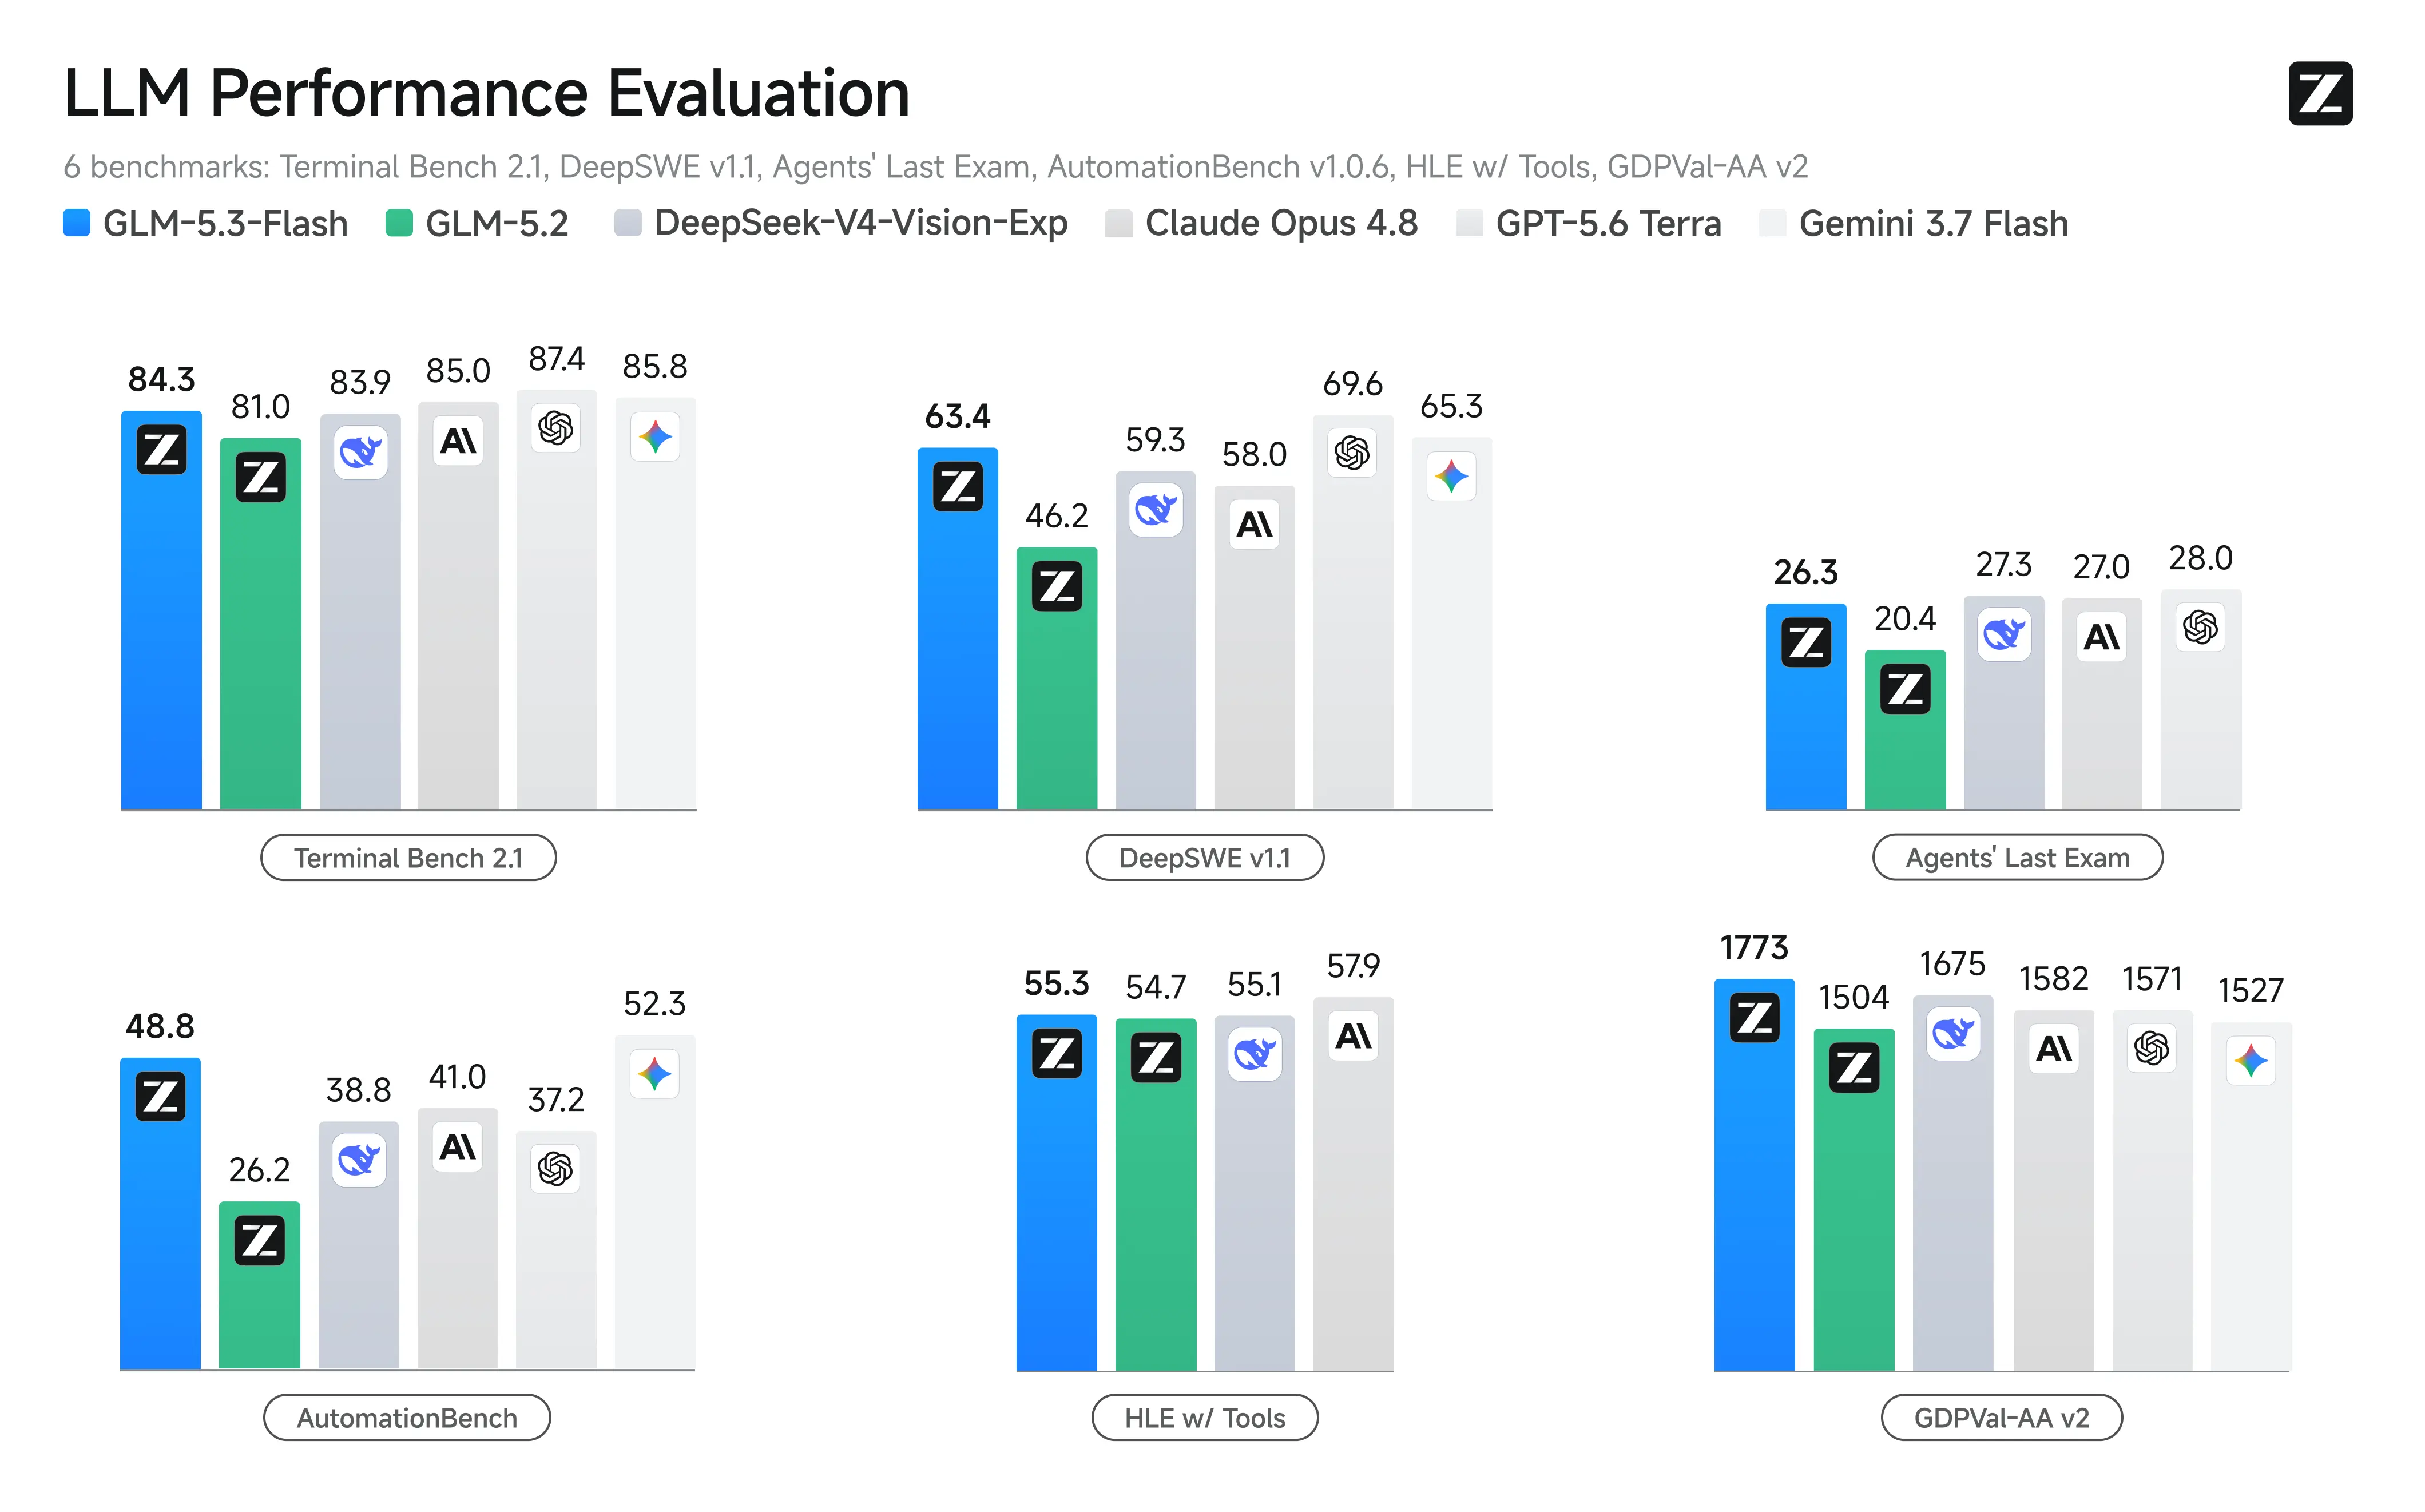
Quelle: Z.ai offizielles Benchmark-Grafik
Die offizielle Benchmark-Grafik vergleicht die Leistung von GLM-5.3 Flash über Modell- und Effort-Einstellungen hinweg. Für diesen API-Leitfaden liefert sie kompakten Leistungskontext, statt die vollständige Startmatrix zu wiederholen. Anwendungen sollten dennoch Erfolg der Aufgabe, End-to-End-Latenz und gesamten Tokenverbrauch auf eigenen Prompts messen.
Warum GLM-5.3 Flash über CometAPI verwenden?
CometAPI stellt GLM-5.3 Flash über eine OpenAI-kompatible Schnittstelle bereit. Das ermöglicht Teams, vertraute SDK-Muster wiederzuverwenden, Anmeldeinformationen und Abrechnung zu zentralisieren und Modelle zu wechseln, ohne die gesamte Request-Schicht neu aufzubauen.
• Eine Integrationsweise. Derselbe Basis-Client kann verschiedene unterstützte Modelle durch Änderung der Model-ID aufrufen.
• Zentralisierte Nutzungsübersicht. Teams können Nutzung und Kosten prüfen, ohne für jeden Anbieter ein separates Dashboard zu pflegen.
• Schnellere Evaluation. Ein einziges Request-Harness kann Antwortqualität, Latenz und Fehler über Kandidatenmodelle vergleichen.
• Einfacheres Fallback-Design. Anwendungen können Retry- und Routing-Logik in einer Gateway-Schicht halten.
• Geringerer gelisteter Routenpreis. Die aktuelle Modellseite listet $0.06 pro Million Input-Tokens und $0.20 pro Million Output-Tokens; prüfen Sie die Live-Seite vor der Budgetierung.
Bevor Sie beginnen
Sie benötigen ein CometAPI-Konto, einen API-Schlüssel und eine der folgenden lokalen Umgebungen:
• Python 3.9 oder höher mit pip
• Node.js 18 oder höher mit npm
• cURL für einen minimalen CLI-Test
Geben Sie niemals einen produktiven CometAPI-Schlüssel in Browser-JavaScript, eine mobile App, ein öffentliches Repository, einen Screenshot oder clientseitige Logs ein. Rufen Sie CometAPI von einem vertrauenswürdigen Server auf und verwahren Sie den Schlüssel in einer Umgebungsvariablen oder einem Secret Manager.
So verwenden Sie die GLM-5.3 Flash API mit CometAPI
Schritt 1: CometAPI-API-Schlüssel erstellen
Melden Sie sich bei CometAPI an, öffnen Sie die API-Key-Konsole, erstellen Sie einen Schlüssel und fügen Sie ihn genau einmal in Ihren Secret-Management-Workflow ein. Nutzen Sie einen separaten Schlüssel für Entwicklung und Produktion, um eine Umgebung rotieren oder widerrufen zu können, ohne die andere zu unterbrechen.
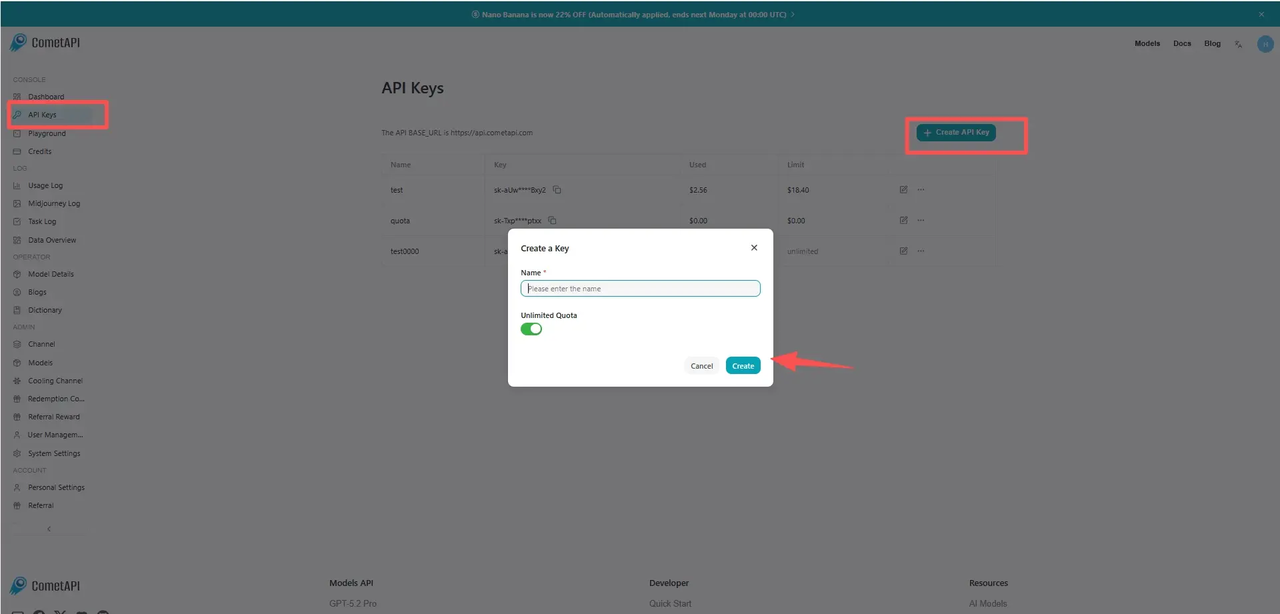
Quelle: CometAPI offizielle Anleitungsgrafik für API-Schlüssel
Schritt 2: Den Schlüssel als Umgebungsvariable speichern
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Ersetzen Sie in der Produktion die Shell-Historie durch ein Deployment-Secret, Container-Secret oder einen Managed Vault.

### Schritt 3: Ein OpenAI-kompatibles SDK installieren
python -m pip install --upgrade openai
npm install openai
```

### Schritt 4: Den ersten Request mit cURL senden

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Eine erfolgreiche Antwort enthält eine Assistant-Nachricht unter choices[0].message.content plus Nutzungsmetadaten, sofern die Route sie zurückgibt. Beginnen Sie mit dieser kleinen Anfrage, bevor Sie optionale Parameter hinzufügen.

### Schritt 5: Die API aus Python aufrufen

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Schritt 6: Die API aus JavaScript aufrufen

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## So steuern Sie den Reasoning-Aufwand

Die offizielle Modelldokumentation unterstützt low, high und max Reasoning-Aufwand. Thinking bleibt aktiviert; die Anstrengungseinstellung ändert, wie viel Reasoning-Budget das Modell nutzen kann.

| Effort | Good starting workloads                             | Trade-off                                            |
| ------ | --------------------------------------------------- | ---------------------------------------------------- |
| low    | Klassifizierung, Umformulierung, kurze Extraktion   | Niedrigere Latenz und Output-Token-Nutzung; weniger Tiefe. |
| high   | Code-Review, Planung, Dokumentanalyse               | Ausgewogener Standard für viele Produktivaufgaben.   |
| max    | Komplexes Debugging, Tool-Agenten, schwieriges Reasoning | Höchste Tiefe; potenziell größere Latenz und Kosten.     |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Wenn das installierte SDK reasoning_effort als First-Class-Argument anbietet, können Sie es direkt übergeben. Falls die CometAPI-Route ein providerspezifisches Feld ablehnt, entfernen Sie es und verwenden Sie den Routenstandard. Versuchen Sie nicht, Thinking zu deaktivieren.

## So streamen Sie Antworten

Streaming ist nützlich für Chat, Coding-Assistenten und lange Analysen, da die Oberfläche Ausgabe anzeigt, sobald sie eintrifft. Es reduziert jedoch nicht die Gesamtzahl generierter Tokens; behalten Sie dieselben Output-Limits und Kostenkontrollen bei.

### Python-Streaming

Python

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens=1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript-Streaming

JavaScript

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Abbruch behandeln. Beenden Sie das Lesen des Streams, wenn der Client die Verbindung trennt, und brechen Sie die Upstream-Arbeit ab, wenn unterstützt.

• Sicher puffern. Gehen Sie nicht davon aus, dass jeder Chunk ein vollständiges Wort, JSON-Token oder Tool-Call-Objekt enthält.

• Finale Nutzung aufzeichnen. Nutzungsdaten erscheinen möglicherweise nur im letzten Ereignis oder route-spezifischen Metadaten.

## So senden Sie Bilder

GLM-5.3 Flash akzeptiert visuelle Inhalte über image_url-Blöcke in messages[].content[]. Die offizielle Dokumentation empfiehlt eine erreichbare Bild-URL oder eine Base64-Data-URL. CometAPIs Modellseite weist auf Image-to-Text-Fähigkeit hin, dennoch sollten Anwendungen Formate, Dateigröße und Routenverhalten vor der Produktion testen.

### Ein Bild per URL analysieren

Python

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Ein lokales Bild als Base64 senden

Python

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Beschneiden Sie irrelevanten Leerraum vor dem Kodieren eines Bildes.

• Skalieren Sie Bilder herunter, die deutlich größer sind als die zu betrachtenden Informationen.

• Stellen Sie eine konkrete visuelle Frage statt einer generischen Beschreibung.

• Gehen Sie nicht davon aus, dass eine öffentliche Webseiten-URL eine direkte Bild-URL ist.

• Testen Sie die Reihenfolge mehrerer Bilder, da jedes Bild im Prompt eindeutig referenziert werden sollte.

## So fordern Sie strukturiertes JSON an

Strukturierte Ausgabe ist wertvoll, wenn die nächste Komponente Code statt ein menschlicher Leser ist. Verwenden Sie ein enges Schema, validieren Sie das Ergebnis und halten Sie ein Fallback bereit, falls Routen kein striktes JSON Schema in exakt derselben Form bereitstellen.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON-Modus ersetzt nicht die Validierung. Prüfen Sie Pflichtfelder, Typen, erlaubte Werte und maximale Längen, bevor Sie das Ergebnis speichern oder ein weiteres System auslösen.

## So verwenden Sie Function Calling

Function Calling erlaubt dem Modell zu entscheiden, wann es externe Daten benötigt, während die Anwendung weiterhin für Autorisierung und Ausführung verantwortlich ist. Das sichere Muster lautet: Das Modell schlägt einen Tool-Aufruf vor, der Server validiert ihn, der Server führt das Tool aus und das Modell erhält das Ergebnis.

Python

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Argumente validieren. Behandeln Sie Tool-Call-JSON als unzuverlässigen Input.

• Autorisierung durchsetzen. Das Modell entscheidet nicht, was der aktuelle Nutzer tun darf.

• Lese- und Schreib-Tools trennen. Für destruktive oder extern sichtbare Aktionen eine Bestätigung verlangen.

• Tool-Inventar begrenzen. Nur Tools freigeben, die für den aktuellen Workflow relevant sind.

• Die Schleife begrenzen. Maximale Tool-Runden, Gesamt-Tokens, verstrichene Zeit und Kosten festlegen.

## GLM-5.3 Flash API-Parameter

| Parameter               | Purpose                           | Practical guidance                                        |
| ----------------------- | --------------------------------- | --------------------------------------------------------- |
| model                   | Wählt die Modellroute             | glm-5.3-flash verwenden.                                  |
| messages                | Konversation und multimodaler Input | Rollreihenfolge korrekt halten; erforderliche Tool-Nachrichten bewahren. |
| max_completion_tokens   | Begrenzung der generierten Ausgabe | Pro Workflow festlegen statt auf das Modellmaximum zu vertrauen. |
| temperature             | Sampling-Verhalten                | Offizielle Empfehlung ist 1.                              |
| top_p                   | Nucleus Sampling                  | Offizielle Empfehlung ist 0.95.                           |
| reasoning_effort        | Reasoning-Budget                  | low, high oder max verwenden; Routensupport testen.       |
| stream                  | Inkrementelle Ausgabe             | true für interaktive Antworten verwenden.                 |
| tools                   | Funktionsdefinitionen             | Schemas eng halten und jeden Aufruf validieren.          |
| tool_choice             | Steuert die Tool-Auswahl          | Mit auto starten, sofern der Workflow kein Tool erzwingt. |
| response_format         | Maschinell lesbare Ausgabe        | Support und zurückgegebenes JSON validieren.              |

## Z.ai Direct API vs CometAPI

Beide Routen können sinnvoll sein. Die Entscheidung betrifft vor allem Integrationsverantwortung, Modellbreite, Abrechnung und die Geschwindigkeit, mit der die Anwendung Anbieter-native Funktionen benötigt.

| Dimension       | Z.ai Direct API                               | CometAPI                                           | Practical result                                               |
| --------------- | --------------------------------------------- | -------------------------------------------------- | -------------------------------------------------------------- |
| Account and key | Z.ai-Konto und -Schlüssel                     | CometAPI-Konto und -Schlüssel                      | Schlüssel sind nicht austauschbar.                             |
| SDK pattern     | OpenAI-kompatibel                             | OpenAI-kompatibel                                  | Viel Client-Code kann wiederverwendet werden.                  |
| Model coverage  | Z.ai-Modellfamilie                            | Mehrere Anbieter und Modellfamilien                | CometAPI ist nützlich für Routing und Vergleich.               |
| Native features | Frühester Zugang zu providerspezifischem Verhalten | Abhängig von Gateway-Exposure und Pass-Through     | Erweiterte Felder auf der gewählten Route testen.              |
| Billing         | Anbieter-spezifisch                           | Zentralisiert über unterstützte Modelle            | Einheitliche Abrechnung vereinfacht Multi-Modell-Betrieb.     |
| Fallback design | Erfordert eine weitere Anbieterintegration    | Kann innerhalb einer Gateway-Schicht bleiben       | CometAPI reduziert Wechselaufwand.                             |
| Best fit        | Tiefe Fokussierung auf Z.ai-native Fähigkeiten | Vereinheitlichter Zugang, Evaluation und Produktionsrouting | Nach Systemarchitektur wählen, nicht nach generischem Sieger.  |

Nutzen Sie die direkte API, wenn der neueste providerspezifische Parameter oder Produktfeature essenziell ist. Nutzen Sie CometAPI, wenn ein einziger Client, einheitliche Abrechnung sowie die Möglichkeit, Modelle zu vergleichen oder zu ersetzen, wichtiger sind. Führen Sie in der Produktion dieselbe repräsentative Test-Suite gegen genau die Route aus, die Sie bereitstellen wollen.

## Kostenschätzung und Tokenbudgetierung

Die aktuelle CometAPI-Modellseite listet $0.06 pro Million Input-Tokens und $0.20 pro Million Output-Tokens. Bei diesen Sätzen ergibt sich die geschätzte Request-Kostenformel:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Workload                | Input tokens | Output tokens | Estimated cost |
| ----------------------- | ------------ | ------------- | -------------- |
| Short question          | 2,000        | 400           | $0.00020       |
| Code review             | 50,000       | 4,000         | $0.00380       |
| Large document analysis | 250,000      | 10,000        | $0.01700       |
| Long agent run          | 800,000      | 30,000        | $0.05400       |

Preise sind zeitabhängig. Bestätigen Sie die aktuellen Raten für Input, gecachten Input und Output vor Veröffentlichung oder Produktionsbudgetierung. Reasoning und Tool-Schleifen können abgerechneten Output und wiederholten Input erhöhen, daher komplette Workflows statt einer einzelnen sichtbaren Antwort schätzen.

## Best Practices für die Produktion mit der GLM-5.3 Flash API

### Kosten- und Latenzkontrollen

#### Output-Grenzen

Benchmark-Generierungssettings und produktive API-Limits unterscheiden sich. Die zitierte HLE-Evaluation nutzte eine maximale Generationslänge von 163.840 Tokens, während einige Evaluierungen 64K Outputs verwendeten; keine dieser Einstellungen beweist, dass jede gehostete API-Route mehr als 100.000 Tokens zurückgeben kann. Setzen Sie die Obergrenze anhand des Live-Routenschemas und des Workflow-Budgets. Kleine Obergrenzen für Klassifikation und Extraktion, mittlere für Analysen und größere nur für explizite Langform- oder Agent-Aufgaben.

Kontextkontrolle

Ein Fenster von einer Million Tokens ist Kapazität, kein Ziel. Relevante Dateien abrufen, doppelte Logs entfernen, stabile Anweisungen nahe dem Anfang platzieren und messen, ob zusätzlicher Kontext den Aufgabenerfolg verbessert.

### Zustand und Zuverlässigkeit

#### State bewahren

Speichern Sie vollständige Assistant-Nachrichten, die für den nächsten Turn benötigt werden, einschließlich Tool-Calls und route-spezifischer Felder, die Ihre Anwendung verifiziert hat. Das Weglassen strukturierter Historie kann eine mehrstufige Tool-Schleife brechen, selbst wenn der sichtbare Text vollständig wirkt.

#### Selektiv wiederholen

• Transiente 429, 500, 502, 503 und Netzwerk-Timeouts mit exponentiellem Backoff und Jitter erneut versuchen.

• Keine blinden Retries bei Authentifizierungsfehlern, ungültigen Parametern oder zu großen Requests.

• Eine Application Request ID anhängen, damit doppelte Arbeit erkannt werden kann.

• Idempotenzkontrollen um externe Schreibvorgänge legen, auch wenn der Modell-Request selbst wiederholt wird.

### Sicherheit und Validierung

#### Maschinenlesbare Ausgabe validieren

Schema-Validierung, Wertemengenprüfungen, Längenlimits und domänenspezifische Regeln sollten zwischen Modell und jeder Datenbank, Queue oder externen API liegen. Ein syntaktisch gültiges JSON-Objekt kann dennoch unvollständig oder unsicher sein.

#### Tool-Aufrufe autorisieren

Behandeln Sie vom Modell vorgeschlagene Tool-Aufrufe als unzuverlässige Anfragen: Argumente validieren, Benutzerautorisierung durchsetzen, Lese- und Schreiboperationen trennen und für destruktive Aktionen eine Bestätigung verlangen.

### Observability und Fallback

#### Workflow messen

• Aufgabenerfolg bzw. menschliche Akzeptanzrate

• Time to First Token und Gesamtlatenz

• Input-, gecachte Input-, Reasoning- und Output-Tokens

• Anzahl der Tool-Aufrufe und Tool-Fehlerrate

• Retries, Rate Limits und Anbieterfehler

• Kosten pro abgeschlossenem Task statt Kosten pro isoliertem Aufruf

#### Fallback gestalten

Wählen Sie ein Fallback nach Workload, nicht nach Reputation. Ein reines Text-Fallback kann für Dokumentextraktion akzeptabel sein, aber bei einer Screenshot-basierten Aufgabe scheitern. Definieren Sie, welche Inputs und Tool-Schemas portabel sind, welche Parameter entfernt werden müssen und wann der Nutzer einen behebbaren Fehler sehen sollte, statt eines automatischen Modellwechsels.

## Häufige Fehler und Troubleshooting

| Symptom                 | Likely cause                                                       | What to check                                                                |
| ----------------------- | ------------------------------------------------------------------ | ---------------------------------------------------------------------------- |
| 401 Unauthorized        | Fehlender, fehlerhafter oder widerrufener Schlüssel               | Authorization-Header und serverseitige Umgebungsvariable prüfen.             |
| 404 or model not found  | Falsche Model-ID oder nicht verfügbare Route                      | glm-5.3-flash verwenden und Verfügbarkeit auf der Live-Modellseite prüfen.   |
| 429 Rate Limit          | Anfrage- oder Token-Kontingent überschritten                      | Backoff, Parallelität reduzieren, Kontolimits prüfen und mit Jitter erneut versuchen. |
| Unsupported parameter   | Providerspezifisches Feld wird vom Gateway nicht exponiert        | Optionale Felder entfernen, dann nacheinander wieder hinzufügen.             |
| Context length exceeded | Prompt plus angeforderter Output überschreitet Routenlimit        | Kürzen, abrufen, zusammenfassen oder max_completion_tokens verringern.       |
| Invalid image           | URL nicht erreichbar, Format nicht unterstützt oder Base64 fehlerhaft | Eine direkte HTTPS-Bild-URL testen und korrekten MIME-Prefix setzen.         |
| Broken streamed JSON    | Chunks wurden als vollständige Objekte geparst                    | Den Stream puffern und erst nach vollständigem JSON-Payload parsen.          |
| Tool loop never ends    | Kein Schrittbudget oder uneindeutige Tool-Ergebnisse              | Runden begrenzen, Tool-Beschreibungen verbessern und explizite Tool-Fehler zurückgeben. |

## Wann sollten Sie die GLM-5.3 Flash API verwenden?

### Gute Einsatzfelder

• Repository‑weites Codeverständnis und Multi-File-Review

• Visuelles Coding, Screenshot-Analyse und Interface-QA

• Lange Dokumentpakete und evidenzgestützte Synthese

• Tool-unterstützte Agenten mit wiederholter Planung und Verifikation

• Hochvolumige Workflows, bei denen Tokenkosten die Stückkosten wesentlich beeinflussen

• Anwendungen, die vom Wechseln oder Vergleichen von Modellen über ein Gateway profitieren

### Verwenden Sie eine andere Route oder ein anderes Modell, wenn

• Das Produkt Bild- oder Videoausgabe statt Textausgabe benötigt.

• Die Aufgabe eine kleine, risikoarme Klassifikation ist, die ein kleineres Modell zuverlässig bewältigt.

• Ein providerspezifisches Feature zwingend ist, aber auf der Gateway-Route nicht exponiert wird.

• Der Workflow Thinking (immer aktiv) oder dessen Latenzprofil nicht toleriert.

• Die Anwendung das Modell noch nicht mit eigenen Tools, Daten und Fehlerfällen getestet hat.

## FAQ

###

### Was sollten Sie auf der exakt gewählten CometAPI-Route vor dem Start verifizieren?

Verfügbarkeit des Modells, akzeptierte multimodale Formate, maximalen Output, Reasoning-Felder, Verhalten bei strukturierter Ausgabe, Rate Limits und aktuelle Preise mit repräsentativen Anfragen verifizieren.

### Welche Kennzahlen sollte eine Produktionsevaluation verfolgen?

Erfolg der Aufgabe, Time to First Token, Gesamtlatenz, Input- und Output-Tokens, Tool-Call-Fehler, Retry-Rate und Kosten pro abgeschlossenem Workflow tracken, nicht nur die Kosten pro API-Aufruf.

### Wie sollten Sie zwischen Z.ai direct und CometAPI wählen?

Z.ai direct nutzen, wenn unmittelbarer Zugriff auf providerspezifisches Verhalten essenziell ist. CometAPI nutzen, wenn einheitliche Authentifizierung, Abrechnung, Modellvergleich und Gateway-Level-Fallback wichtiger sind.

### Was macht ein Fallback sicher?

Ein sicheres Fallback akzeptiert dieselbe Eingabemodalität, bewahrt erforderliche Tool-Schemas, entfernt nicht unterstützte Parameter, bleibt innerhalb der Aufgaben‑Autorisierungsgrenzen und schlägt sichtbar fehl, wenn Verhalten nicht erhalten werden kann.

## Fazit

GLM-5.3 Flash ist über eine API besonders nützlich, wenn langer Kontext, visuelle Eingabe, Reasoning und Toolnutzung Teil eines Workflows sind. Die grundlegende CometAPI-Integration ist klein: ein serverseitiger Schlüssel, ein OpenAI-kompatibler Client, die Model-ID glm-5.3-flash und der Chat-Completions-Endpunkt. Produktionsreife entsteht durch alles rund um diesen Request: fokussierte Prompts, Output-Grenzen, Schema-Validierung, Tool-Autorisierung, Retries, Observability und workloadspezifische Evaluation.

Beginnen Sie mit einem kurzen Textaufruf, fügen Sie jeweils eine fortgeschrittene Fähigkeit hinzu und testen Sie die komplette User Journey, bevor Sie skalieren. Bestätigen Sie die Live-GLM-5.3 Flash-Modellseite für aktuelle Verfügbarkeit, unterstütztes Routenverhalten und Preise.

## SEO-Metadaten

Meta title: GLM-5.3 Flash API verwenden: Entwicklerleitfaden

Meta description: Erfahren Sie, wie Sie die GLM-5.3 Flash API mit CometAPI nutzen, inklusive Beispielen für Python und JavaScript, Vision, Streaming, Tools, JSON-Ausgabe und Best Practices.

Keywords: GLM-5.3 Flash API, GLM-5.3 Flash verwenden, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API Tutorial, multimodale API, Reasoning API, Function Calling

URL slug: how-to-use-glm-5-3-flash-api