Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Hy4 vs GPT-6.1 Terra: Benchmarks, API-Preise und welches Modell Sie wählen sollten
Vergleichen Sie Hy4 und GPT-6.1 Terra in Bezug auf Programmierung, Forschung, offizielle API-Spezifikationen und die CometAPI-Preise. Finden Sie das richtige Modell für Ihre Workload.
Deon GoodwinForschungsteam für KI-Modelle und API
Aktualisiert Nov 14, 2026 10 Min. Lesezeit
Zuerst die Antwort
Vergleichen Sie Hy4 und GPT-6.1 Terra in Bezug auf Programmierung, Forschung, offizielle API-Spezifikationen und die CometAPI-Preise. Finden Sie das richtige Modell für Ihre Workload.
Nutze diese Zusammenfassung für eine schnelle Antwort und lies anschließend den Leitfaden für Kontext, Beispiele und Implementierungsdetails.
Hy4 ist ein starker Ausgangspunkt für Finanzforschung und großvolumige Textgenerierung; GPT-6.1 Terra ist ein starker Ausgangspunkt für Terminal-Coding und Debugging. Beide akzeptieren Text und Bilder und unterstützen Toolnutzung. Die klarsten Unterschiede sind Aufgabenleistung, Ausgabekapazität und Preis: Terra führt den untenstehenden Terminal-Coding-Test an, während Hy4 die Finanz- und Research-Tests anführt und zu den aufgeführten CometAPI-Tarifen weniger kostet.
Key Takeaways
Wählen Sie nach Workload: Hy4 für Recherche und ausgabeintensive Anwendungen; Terra für Terminal-Coding und Debugging.
Beide bieten Kontextfenster von etwa einer Million Token. Terra stellt ein größeres maximales Ausgabebudget bereit.
Terra führt Terminal-Bench 4.0 mit 10.10 Prozentpunkten; das Modell von Tencent führt Finance Agent v2.1 mit 8.74 Punkten in den Ergebnissen von Vals AI an.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Das CometAPI-Beispiel mit 10M Eingabe- und 2M Ausgabe-Token kostet $10.672 gegenüber $16.00 zu den angezeigten Basistarifen.
Passen Sie Endpoint, Tool-Verhalten und Reasoning-Einstellungen an Ihre Anwendung an, bevor Sie den Anbieter wechseln.
Spezifikationen, Benchmark-Momentaufnahmen und Preise geprüft am 6. November 2026.
Hy4 vs GPT-6.1 Terra: Spezifikationen und Funktionen
Hy4 kombiniert Text- und Bildverständnis mit Reasoning und Toolnutzung, einschließlich Workflows über Kommandozeile und grafische Oberflächen. GPT-6.1 Terra unterstützt visuelles Reasoning, Computer-Nutzung und Schreiben, mit expliziten Einstellungen für den Reasoning-Aufwand und einem größeren Ausgabebudget. Die Tabelle unten vergleicht Spezifikationen von Tencent und OpenAI.
Offizielle API-Spezifikationen
Beide Modelle können mit großen Dokumentensammlungen und Codebasen arbeiten. Bei langen Prompts sollten Sie auch Budget für die Antwort einplanen: Tencent gibt für Hy4 eine maximale Eingabe von 960K an. Der kleine Unterschied in der beworbenen Kontextkapazität ist für die Auswahl weniger nützlich als die Frage, wie präzise jedes Modell Ihr Material nutzt.
Terra bietet mit bis zu 128,000 Ausgabetoken mehr Raum für eine lange Antwort als das veröffentlichte 64K-Limit von Hy4. Das hilft, wenn ein Bericht oder ein Code-Artefakt in eine einzige Antwort passen muss. Reasoning-Token verbrauchen ebenfalls Terras Ausgabebudget.
Reasoning-Einstellungen
Terra bietet sechs Einstellungen für den Reasoning-Aufwand: none, low, medium, high, xhigh und max, wobei medium der Standard ist. Damit können Anwendungen den Inferenzaufwand explizit je nach Aufgabe anpassen. Eine Klassifikationsanfrage und eine schwierige Debugging-Aufgabe müssen nicht dasselbe Budget verwenden.
Tencents Launch beschreibt Reasoning in Kombination mit visueller Wahrnehmung und Toolnutzung, definiert in dieser Ankündigung jedoch keine gleichwertige Sechs-Stufen-Steuerung. Behandeln Sie Reasoning-Parameter als endpoint-spezifisch: Übernehmen Sie nicht die Aufwandseinstellung eines Anbieters in eine Anfrage an einen anderen und gehen davon aus, dass sie dieselbe Bedeutung hat.
Hy4 vs GPT-6.1 Terra: Leistung
Vals AI stellt direkte Ergebnisse für beide Modelle zu Coding-, Finanz-, Rechtsrecherche- und Steueraufgaben bereit. Diese Werte zeigen, wo jedes Modell ein nützlicher Kandidat für Ihren Workload ist.
Unabhängige Benchmark-Ergebnisse und Testbedingungen
Die folgenden Ergebnisse des Vals Index v2.2 wurden am 10. November 2026 geprüft. Höhere Werte sind besser.
Vals AI gibt für Hy4 Temperature 0.9, top_p 1.0 und ein 65,536-Token-Ausgabelimit an; Terra verwendet maximalen Reasoning-Aufwand und ein 128,000-Token-Ausgabelimit. Diese Einstellungen unterscheiden sich, daher sind die Ergebnisse als Vergleich der getesteten Konfigurationen zu lesen, nicht als Läufe mit gleichem Budget.
Terras Vorsprung ist bei Terminal-Aufgaben größer als bei der Codegenerierung: 10.10 Prozentpunkte bei Terminal-Bench 4.0 gegenüber 2.99 Punkten bei Vibe Code Bench. Das macht Debugging und Kommandozeilen-Entwicklung zu den klarsten Ansatzpunkten, Terra zu evaluieren.
Hy4 liegt bei Finance Agent, Legal Research Bench und Tax Agent Bench um 8.74, 15.39 bzw. 17.32 Prozentpunkte vorn. Forschungs-Workflows, die Belege sammeln und Domänenregeln anwenden, sind daher vielversprechende Startpunkte für Hy4.
Der Gesamtabstand beträgt 1.19 Prozentpunkte, und die veröffentlichten Unsicherheitsintervalle überlappen sich.
Tencents Hy4-Launch-Benchmarks
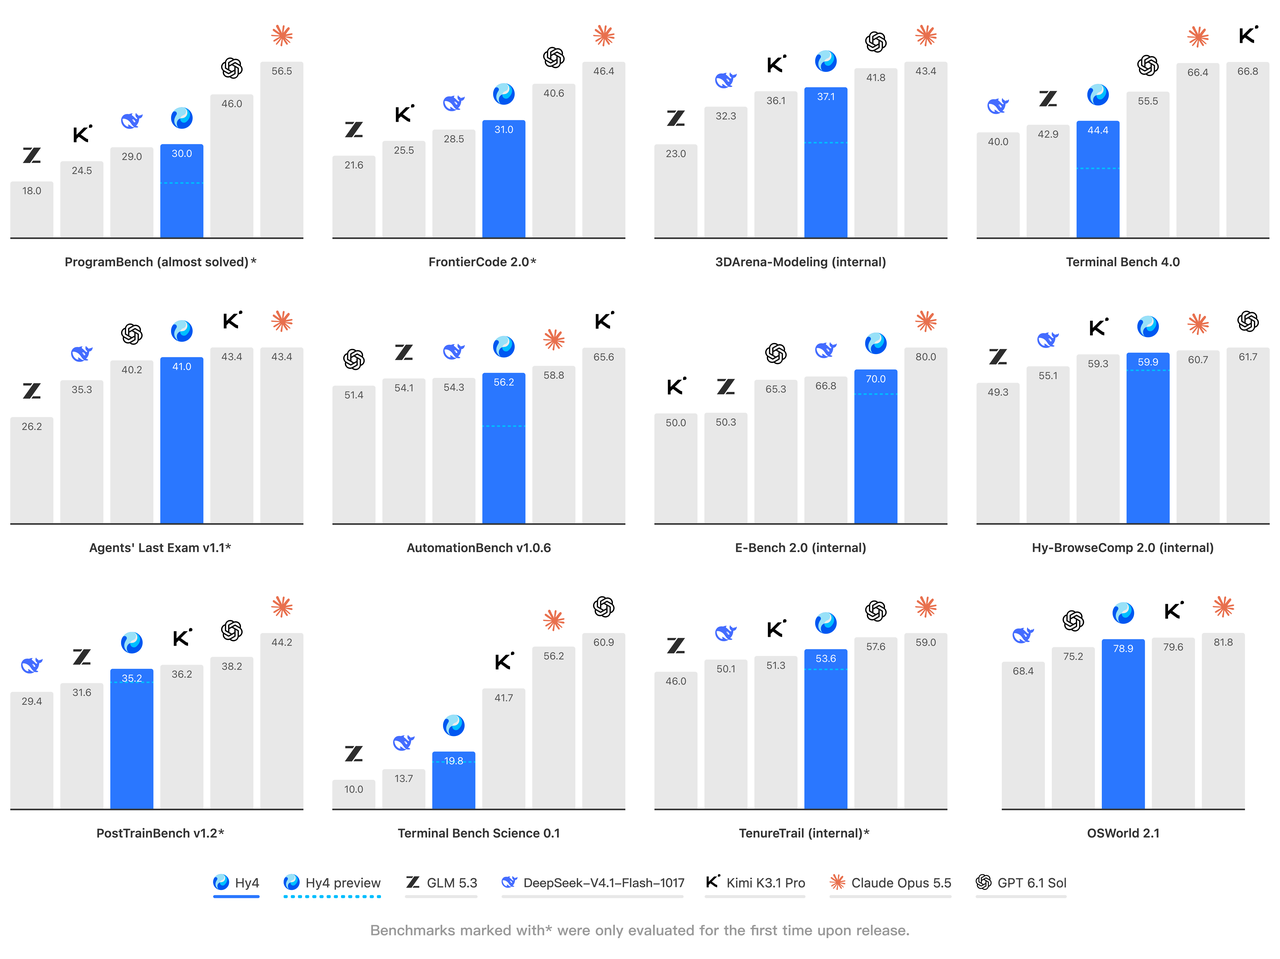
Tencents Launch-Grafik ergänzt Ergebnisse für Coding und Computer-Nutzung. Sie vergleicht Hy4 mit GPT-6.1 Sol; für den direkten Vergleich mit GPT-6.1 Terra verwenden Sie die Vals-AI-Tabelle oben.
Von Tencent gemeldete Hy4-Benchmark-Ergebnisse, November 2026. Das gezeigte OpenAI-Modell ist GPT-6.1 Sol.
In Tencents Launch-Grafik erzielt Hy4 44.4 bei Terminal Bench 4.0 und 78.9 bei OSWorld 2.1. Diese Werte beschreiben Tencents Evaluierungs-Setup und sind getrennt von den oben genannten Vals-AI-Werten.
Vision- und Computer-Nutzungs-Workflows
Tencent führt im offiziellen Release Bildverständnis ein und beschreibt Training für Workflows über Kommandozeilen-Tools, grafische Oberflächen, Blender und CAD. Damit stehen Diagrammanalyse und visuelle Software-Aufgaben im Zentrum der Positionierung.
OpenAI positioniert sein Modell für bildschirmbasierte Workflows, präzises Schreiben und abgegrenzte Code-Fixes. Für eine Kataloganwendung testen Sie das Matching von Produktfotos; für technische Arbeit verwenden Sie Zeichnungen mit kleinen Beschriftungen und Maßen; für Desktop-Automatisierung prüfen Sie die gespeicherten Dateien und den Anwendungszustand.
Ein gutes visuelles Testset sollte Lesen und Handeln trennen. Messen Sie zunächst, ob das Modell die richtigen Werte extrahiert oder das richtige Interface-Element identifiziert. Anschließend messen Sie, ob der komplette Workflow das gewünschte Ergebnis ohne falsche Klicks, fehlende Dateien oder unnötige menschliche Eingriffe erreicht.
Geschwindigkeit und End-to-End-Latenz
Für Chat sind die relevanten Geschwindigkeitsmaße, wie schnell die Antwort beginnt und wie lange sie bis zum Abschluss benötigt. Für Agenten messen Sie die vollständige Aufgabe, einschließlich Toolausführung und etwaiger Korrekturen.
Vergleichen Sie beide Modelle bei typischen und anspruchsvollen Aufgaben unter Ihrer erwarteten Parallelität. Verfolgen Sie Median- und Tail-Latenz zusammen mit erfolgreichem Abschluss: Eine schnelle Antwort ist nur nützlich, wenn sie die Arbeit erledigt.
Hy4 vs GPT-6.1 Terra: Kosten
Vergleichen Sie zuerst die Token-Tarife und berücksichtigen Sie dann den Aufwand, der für ein nutzbares Ergebnis erforderlich ist. Die Preise unten sind CometAPI-Basistarife in US-Dollar pro eine Million Token; sie sind getrennt von den von Vals AI gemeldeten Kosten pro Test.
CometAPI-Preise für Eingabe und Ausgabe
Kostenposition
Hy4 API in CometAPI
GPT-6.1 Terra API in CometAPI
Eingabe pro eine Million Token
$0.6672
$0.80
Ausgabe pro eine Million Token
$2.00
$4.00
Die folgende Tabelle verwendet die aufgelisteten CometAPI-Basistarife in US-Dollar pro eine Million Token. Vergleichen Sie Eingabe und Ausgabe separat und berechnen Sie dann die Kosten Ihrer typischen Anfrage.
Beispielkosten für 10,000 Anfragen
Nehmen Sie 10,000 Anfragen an, die jeweils 1,000 nicht gecachte Eingabe-Token und 200 abrechenbare Ausgabe-Token verwenden. Über alle Anfragen hinweg sind das 10 Millionen Eingabe-Token und 2 Millionen Ausgabe-Token. Unter Verwendung der oben genannten CometAPI-Basistarife:
Hy4 kostet in diesem Beispiel etwa 33.3% weniger. Diese Schätzung umfasst nicht gecachte Eingaben und abrechenbare Ausgaben; fügen Sie Cache-, Tool- und Retry-Kosten hinzu, wenn Sie einen vollständigen Workflow budgetieren.
Abrechnung beim Direktanbieter und Long-Context-Anfragen
Für lange Dokumente bei OpenAIs direkter API lösen Prompts oberhalb von 272K Eingabe-Token für die gesamte Anfrage 2× Eingabe- und Cache-Tarife sowie 1.5× Ausgabe-Tarife aus. Wenden Sie die Abrechnungsregeln des von Ihnen genutzten Dienstes an; das obige CometAPI-Beispiel verwendet CometAPI-Basistarife. OpenAI-Preisdetails.
Kosten pro akzeptierter Aufgabe
Eine akzeptierte Aufgabe ist eine, die die Qualitäts- und Abschlussprüfungen Ihrer Anwendung erfüllt. Zählen Sie alle Versuche, die Toolnutzung und die Review-Arbeit, die erforderlich sind, um dieses Ergebnis zu erreichen, einschließlich der Ausgaben für fehlgeschlagene Versuche.
Kosten pro akzeptierter Aufgabe = Gesamtkosten für Modell, Retries, Tools und manuelle Reviews ÷ Aufgaben, die die Abnahmeprüfungen bestehen.
Ein teurerer Aufruf kann dennoch wirtschaftlich sein, wenn er mehrere Reparaturversuche erspart. Umgekehrt bringt ein höherer Tarif wenig Mehrwert, wenn ein günstigeres Modell die Qualitätsgrenze bereits erfüllt.
Welches Modell sollten Sie wählen: Hy4 oder GPT-6.1 Terra?
Beginnen Sie mit dem Modell, dessen Stärken zu Ihrem Haupt-Workload passen. Nutzen Sie die folgenden Auswahlkriterien, um eine Shortlist zu erstellen, und vergleichen Sie dann Qualität und Kosten abgeschlossener Aufgaben.
Wann Sie Hy4 wählen sollten
Wählen Sie Hy4 vorrangig für Finanzrecherche, Analyse rechtlicher oder steuerlicher Dokumente und Anwendungen mit umfangreicher Textgenerierung. Die Vorsprünge in den drei Domänen-Benchmarks machen es zu einem geeigneten Kandidaten für evidenzlastige Recherche. Zu den angegebenen CometAPI-Tarifen liegt sein Ausgabepreis bei der Hälfte von Terras, was bei hohem Volumen in Erstellung und Berichterstattung einen spürbaren Unterschied machen kann.
Beurteilen Sie bei Recherchearbeit die fertige Antwort nach Quellengenauigkeit, Berechnungen und Abdeckung der Fragestellung. Hy4 passt besser, wenn es diese Anforderungen zu geringeren Gesamtkosten erfüllt, einschließlich Review und Retries.
Wann Sie GPT-6.1 Terra wählen sollten
Wählen Sie GPT-6.1 Terra vorrangig für Terminal-Coding, Debugging und Code-Fixes. Sein Vorsprung von 10.10 Punkten bei Terminal-Bench ist das stärkste Coding-Signal in diesem Vergleich. Das größere Ausgabebudget macht es zudem für lange Berichte und umfangreiche Code-Antworten testenswert.
Beurteilen Sie Terra danach, ob seine Patches Ihre Tests bestehen und die Deliverables vollständig sind. Für visuelle oder Desktop-Arbeit vergleichen Sie beide Modelle auf Ihren tatsächlichen Bildschirmen, Diagrammen und Dateien und prüfen Sie das final gespeicherte Ergebnis.
Research und Coding auf unterschiedliche Modelle routen
Ein gemischter Workload kann davon profitieren, beide Modelle zu nutzen. Ein Assistent für Finanzanalysen könnte Hy4 für Recherche und Berichtsentwurf verwenden und Terra aufrufen, wenn ein Analyseskript Debugging benötigt:
Senden Sie Belegesammlung und Berichtsentwurf an Hy4.
Prüfen Sie Zitationen, Quellwerte und Berechnungen, bevor Sie den Bericht akzeptieren.
Routen Sie ein fehlschlagendes Analyseskript mit Code, Fehlerausgabe und erwartetem Verhalten zu Terra.
Führen Sie das korrigierte Skript aus und wenden Sie vor der Rückgabe des Endergebnisses dieselben Belegprüfungen an.
Nutzen Sie ein zweites Modell, wenn es das Endergebnis genügend verbessert, um die zusätzlichen Kosten und Integrationsarbeit zu rechtfertigen.
Wo können Sie auf Hy4 und GPT-6.1 Terra zugreifen?
Zugang über offizielle Anbieter
Greifen Sie auf Hy4 über Tencent Cloud TokenHub und auf GPT-6.1 Terra über OpenAIs API zu. Verwenden Sie die Dokumentation des Anbieters für Authentifizierung, Modell-IDs und Abrechnung.
CometAPI-Zugang und Tool-Kompatibilität
CometAPI bietet beide Modelle unter den IDs hy4 und gpt-6.1-terra an. Die Modellseiten führen Anfragebeispiele und Preise für jede Route auf: Hy4 und GPT-6.1 Terra.
Für Tool-fähige Anwendungen prüfen Sie die Unterstützung für Function Calls und strukturierte Ausgaben auf der gewählten Route. Bei OpenAIs direkter API erfordert Tool-Calling für Terra die Responses API.
So testen und führen Sie Ihre Wahl ein
Bevor Sie Produktionsverkehr umstellen, vergleichen Sie die Modelle anhand repräsentativer Aufgaben mit denselben Eingaben, Tools und Akzeptanzkriterien. Protokollieren Sie erfolgreiche Abschlüsse, Gesamtkosten und verstrichene Zeit und rollen Sie die stärkere Route schrittweise aus.
Beziehen Sie Routineanfragen und schwierige, für Ihre Nutzer relevante Fälle ein.
Prüfen Sie Tool-Argumente, strukturierte Ausgaben, Fehler und Abschlussstatus.
Setzen Sie Retry-Grenzen und Rollback-Trigger, bevor Sie Live-Traffic senden.
Fazit
Wählen Sie Hy4, wenn Forschungsqualität und geringere Textgenerierungskosten Ihre Prioritäten sind. Wählen Sie GPT-6.1 Terra, wenn Terminal-Coding, Debugging und ein größeres Ausgabebudget am wichtigsten sind.
Für eine gemischte Anwendung beginnen Sie mit einem Modell pro Haupt-Workload und fügen dort eine zweite Route hinzu, wo sie die Ergebnisse verbessert. Die beste Wahl ist diejenige, die Ihre Aufgaben zuverlässig zu tragbaren Kosten erledigt.
Spezifikation
Hy4 · Offizielle Spezifikationen von Tencent Cloud
GPT-6.1 Terra · Offizielle Spezifikationen von OpenAI
Entwickler
Tencent
OpenAI
API model ID
hy4
gpt-6.1-terra
Eingabe / Ausgabe
Text und Bilder / Text
Text und Bilder / Text
Kontextfenster
1024K Token (Tencent-Notation)
1,050,000 Token
Maximale Ausgabe
64K Token (Tencent-Notation)
128,000 Token
Toolaufrufe
Unterstützt (Function Calling)
Unterstützt; erfordert die Responses API
Strukturierte Ausgaben
Unterstützt
Unterstützt
Hauptanwendungen
Softwareentwicklung, Finanzanalyse und lang laufende Agentenaufgaben
Visuelles Reasoning, Computer-Nutzung, Schreiben und abgegrenzte Code-Aufgaben
Benchmark oder Metrik
Hy4: Vals AI-Ergebnisse
GPT-6.1 Terra: Vals AI-Ergebnisse
Interpretation
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 Prozentpunkte
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 Punkte
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 Punkte
Finance Agent v2.1
64.70%
55.96%
Tencent-Modell +8.74 Punkte
Legal Research Bench
41.35%
25.96%
Tencent-Modell +15.39 Punkte
Tax Agent Bench
34.40%
17.08%
Tencent-Modell +17.32 Punkte
Hy4 vs GPT-6.1 Terra: Benchmarks, API-Preise und welches Modell Sie wählen sollten - CometAPI