

TL;DR
Muse Wonder, Claude Opus 5.5 und GPT-6 Sol sind leistungsfähige Modelle für Coding- und Agent-Workflows. Metas neues Muse Wonder betont persistente Memory und nachhaltige Ausführung; Opus 5.5 führt den zitierten aggregierten Intelligence Index an; GPT-6 Sol hat die niedrigsten Standardpreise für Short-Context Input und Output in diesem Vergleich, während sein Long-Context-Tier separat bepreist ist. Wählen Sie anhand repräsentativer Aufgabenqualität, Zuverlässigkeit und Gesamtkosten statt eines einzigen Leaderboard-Scores.
Key Takeaways
- Gesamtintelligenz: Claude Opus 5.5 erzielt 58 gegenüber 52 von Muse Wonder auf dem gemeldeten Intelligence Index v4.3.
- Long-horizon Coding: Muse Wonder erreicht 78.8 auf DeepSWE 1.1 und 53.1 auf SWE-Marathon; Opus 5.5 verzeichnet 74.2 und 46.3 in Metas Tabelle.
- Günstiges Reasoning: GPT-6 Sol startet bei $2 Input / $10 Output pro 1 Mio. Tokens über OpenAIs Short-Context Standard-API.
- Memory-fokussierte Agenten: Muse Wonder führt Active Memory und Active Focus ein.
- Verfügbarkeit zählt: Muse Wonder Full ist ein separates, stärker eingeschränktes Produkt als das für Entwickler zugängliche Standard-Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol auf einen Blick
Wählen Sie Muse Wonder für persistente Agenten und lang laufende Engineering-Aufgaben, Claude Opus 5.5 für breit angelegtes Coding und terminallastige Arbeit und GPT-6 Sol für geringere Standard-Short-Context-Tokenkosten.
| Entscheidungsfaktor | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Starten Sie Tests mit | Persistente Agenten und erweiterte Engineering | Terminallastiges Coding und professionelle Workflows | Kostenbewusstes Coding und Automatisierung |
| Kontextfenster | 1,048,576 Tokens | 1M Tokens | 1,050,000 Tokens |
| Veröffentlichte Stärke | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard Input/Output $2/$10 pro 1M Tokens |
| Standard Input / Output pro 1M Tokens | $4 / $20 | $4 / $20 | $2 / $10; Short-Context-Tier |
| Anbieterzugang | Meta Model API; Full ist ein separates Abo-Produkt | Anthropic API | OpenAI API |
| Auswahlmetrik | Akzeptierte Aufgabenqualität und Gesamtkosten | Akzeptierte Aufgabenqualität und Gesamtkosten | Akzeptierte Aufgabenqualität und Gesamtkosten |
| Entwickler | Meta | Anthropic | OpenAI |
| Release | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| Eingabemodalitäten | Text, Bild, Audio, Video; PDF-Inputs dokumentiert | Text, Bild | Text, Bild |
| Ausgabe | Text | Text | Text |
| Unterscheidungsmerkmal | Active Memory und Active Focus | Tool- und Subagent-Workflows | Konfigurierter Reasoning-Aufwand und API-Tools |
Diese Übersicht fasst die datierten Spezifikationen und veröffentlichten Ergebnisse zusammen, die unten untersucht werden. Benchmark-Zeilen verwenden unterschiedliche Evaluationsmethoden, und niedrige Tokenpreise belegen nicht niedrigere Kosten pro erfolgreicher Aufgabe. Standard Muse Wonder und Muse Wonder Full sind unterschiedliche Zugangsoptionen.
Spezifikationen wurden am 13. Oktober 2026 überprüft. Unterstützte Modalitäten und Funktionen hängen vom gewählten Endpoint und der Release-Oberfläche ab, einschließlich Audio-Verfügbarkeit. Modellseitige Fähigkeiten garantieren nicht die Unterstützung auf jeder Gateway-Route.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Überblick und Spezifikationen
Muse Wonder: Persistente Agent-Workflows
Meta stellte Muse Wonder und Muse Wonder Full am 12. Oktober 2026 vor. Das Standard-Muse Wonder betont lang laufende professionelle Aufgaben, persistente Agenten-Memory und die Wiederherstellung bei Hindernissen. Active Memory soll nützlichen vorherigen Kontext abrufen, während Active Focus den Fortschritt über mehrstufige Arbeiten hinweg aufrechterhalten soll. Meta nennt Coding, Recherche, Finanzanalyse und persönliche Assistenz als Schlüsselszenarien.
Claude Opus 5.5: Professionelles Coding und Toolnutzung
Claude Opus 5.5 zielt auf Coding, Reasoning und professionelle Workflows mit mehreren Tools. Anthropic veröffentlichte es am 22. September 2026. Sein Kontextfenster beträgt eine Million Tokens, während die unten berichteten Coding-Ergebnisse je nach Benchmark unterschiedliche Stärken zeigen.
GPT-6 Sol: Kostenbewusstes Reasoning
GPT-6 Sol soll starkes Reasoning und Toolnutzung mit vergleichsweise erschwinglicher Inferenz kombinieren. Es unterstützt programmgesteuerte Workflows über OpenAIs API-Ökosystem. Seine Standard-Short-Context-Preise liegen unter den gelisteten Claude Opus 5.5 Preisen, obwohl die End-to-End-Ökonomie auch von Retries und Reasoning-Tokenverbrauch abhängt.
OpenAI beschreibt GPT-6 Sol als ein Modell für komplexes Coding und agentische Workflows; die Release-Ankündigung liefert die unten verwendeten Evaluationsergebnisse. Dieser Artikel vergleicht die angegebenen Modellversionen, nicht jedes neuere Modell im Lineup der Anbieter.
Architektur und Reasoning-Kontrollen
Die hier zitierten Quellen liefern keine vergleichbare Aufschlüsselung zu Parameteranzahl und Architektur für alle drei Modelle. Ein Ranking Dense vs. Mixture-of-Experts ist daher nicht gerechtfertigt. Active Memory und Active Focus beschreiben Metas Agentenfunktionen; sie ersetzen keine offengelegte neurale Architektur. GPT-6 Sol bietet konfigurierbaren Reasoning-Aufwand, während die gemeldeten Meta- und Claude-Scores ebenfalls von Aufwand und Evaluationssetup abhängen. Betrachten Sie diese Einstellungen als Teil der verglichenen Konfiguration, nicht als austauschbare Maßzahlen für Compute.
Vergleichsergebnis: Alle drei bieten große Kontextfenster und Entwickler-APIs. Muse Wonder dokumentiert breitere modellseitige Eingabemodalitäten; Opus 5.5 und GPT-6 Sol betonen Text- und Bild-Workflows. Kontextkapazität und Feature-Verfügbarkeit müssen dennoch auf dem gewählten Endpoint überprüft werden.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Performance
Veröffentlichte Benchmarks und Quellenbegrenzungen
Metas offizieller Model-Card bietet direkte Vergleiche Muse Wonder vs. Claude Opus 5.5. OpenAI veröffentlicht die GPT-6 Sol Ergebnisse separat, weshalb die drei Modelle ohne Harmonisierung von Evaluationharnesses, Versionen und Einstellungen nicht auf eine vollständig kontrollierte Rangliste gesetzt werden können.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Höhere Punktzahl |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Die offizielle Model-Card-Methodik unterscheidet interne Tests, Drittanbieter-Evaluationen und vom Anbieter gemeldete Wettbewerberscores. Die Tabelle reproduziert die gemeldeten Werte; sie etabliert keine einheitliche, unabhängig kontrollierte Studie über alle Zeilen hinweg.
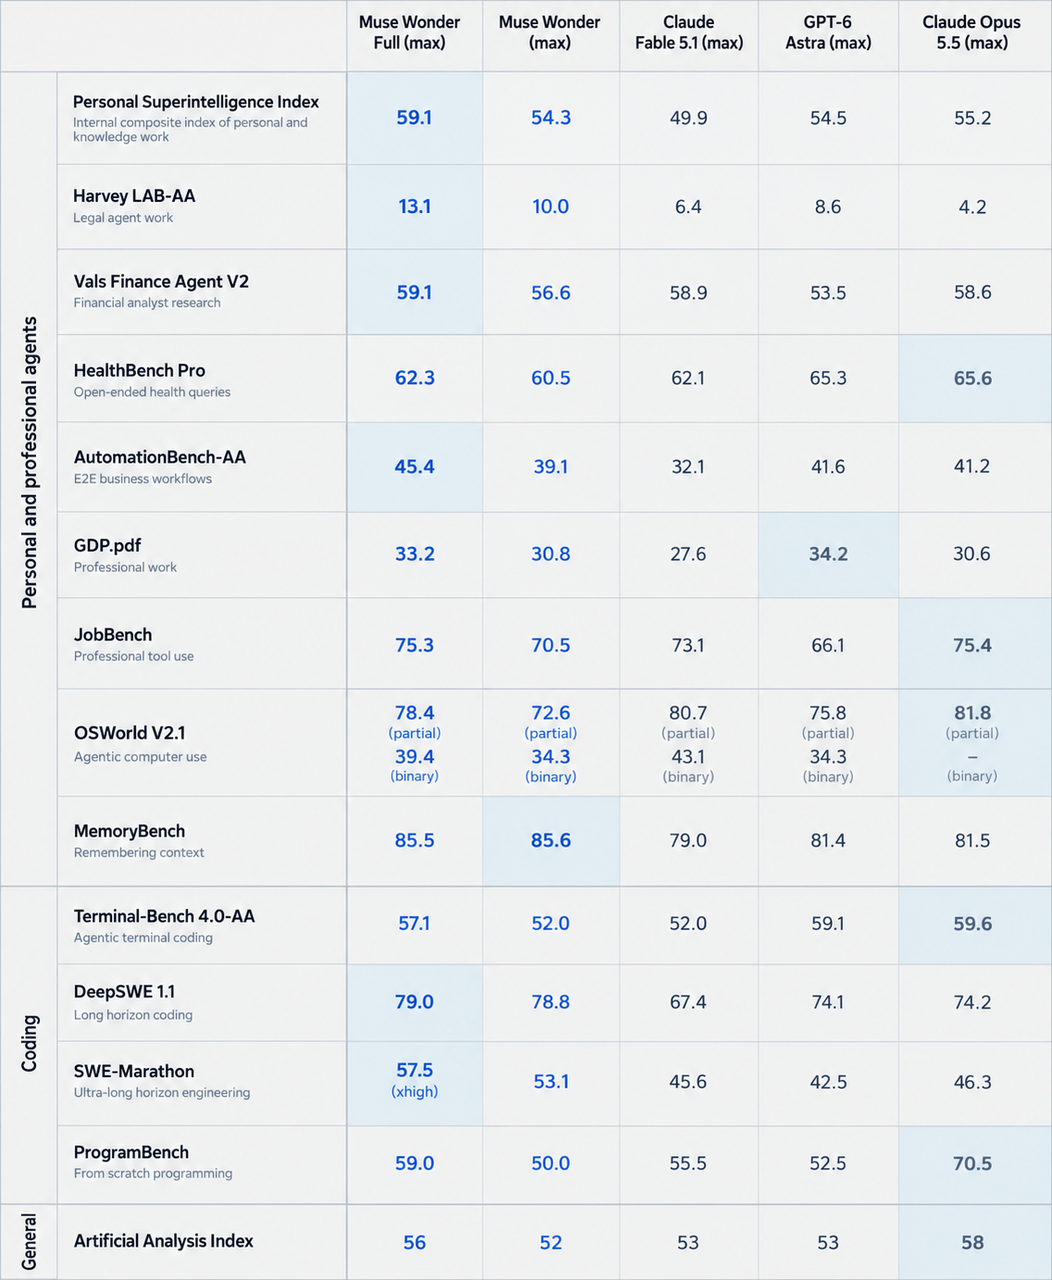
Originale Benchmark-Scorecard aus Metas Muse Wonder Model-Card, ohne Neuzeichnung reproduziert. Das zusätzliche OpenAI-Modell, das in diesem offiziellen Bild gezeigt wird, ist GPT-6 Astra, nicht GPT-6 Sol. Die umliegenden Tabellen identifizieren die für diesen Artikel relevanten Modelle.
Evaluationsbedingungen
DeepSWE v1.1 umfasst 113 Aufgaben über 91 Repositories und fünf Sprachen, bewertet durch Funktions- und Regressionstests mittels pass@1; Metas Scorecard verwendet Datacurve-Ergebnisse für Muse Wonder und Opus 5.5. SWE-Marathon verwendet Projekttests und berichtet pass@1 von Abundant AI; Agent-Harnesses variieren, und Wonder Fulls Score ist als xhigh markiert. ProgramBench verwendet mini-swe-agent und misst Rollouts, die mindestens 95% der versteckten Tests bestehen, mit deaktiviertem Internet nach dem Setup. MemoryBench ist Metas interner 64K–100K-Token-Konversations-Test, bewertet von einem LLM-Judge. Diese Umgebungen und Metriken sollten nicht in eine allgemeine Genauigkeitskennzahl zusammengefasst werden.
Programmierung und Software Engineering
Muse Wonder führt bei den gemeldeten DeepSWE 1.1 und SWE-Marathon Ergebnissen. Claude Opus 5.5 führt bei Terminal-Bench 4.0-AA und ProgramBench. Diese Aufteilung legt nahe, dass langhorizontige Engineering-Aufgaben, Kommandozeilentoolnutzung und Programrekonstruktion unterschiedliche Fähigkeiten beanspruchen.
GPT-6 Sol Ergebnisse und Vergleichbarkeit über Quellen hinweg
| Veröffentliche OpenAI-Evaluation | GPT-6 Sol | Gemeldete Einstellung |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
OpenAIs veröffentlichte Evaluationsergebnisse berichten die obigen Scores. Das OSWorld-Ergebnis ist eine Teilbelohnung auf dem Offline-Set v2026.08.08, nicht eine strikte Aufgabenerfolgsrate. OpenAI weist darauf hin, dass Evaluationen seine Forschungsumgebung oder API nutzten; Produktionskonfigurationen können abweichen.
Die gemeldeten DeepSWE-Scores implizieren eine Lücke von 10.0 Prozentpunkten zwischen Muse Wonder und GPT-6 Sol und 5.4 Punkten zwischen Opus 5.5 und GPT-6 Sol. Dies sind arithmetische Differenzen zwischen Publikationen, keine kontrollierten Schätzungen eines reinen Modellvorteils. Unterschiedliche Agent-Setups, Prompts, Aufwandsstufen und Toolbudgets können das Ergebnis beeinflussen.
Speicher und lang laufende Agenten
Muse Wonder zielt auf Agenten, die frühere Entscheidungen erinnern, Kontext wiederherstellen und unterbrochene Arbeit fortsetzen müssen. Active Memory kann einem Forschungsassistenten helfen, projektspezifische Fakten zu behalten, während Active Focus iterative Aktionen unterstützt, wenn ein früherer Plan nicht zum Erfolg führt. Diese Produktfunktionen ersetzen keine Zustandsverifikation, Berechtigungen, Audit-Trails oder verpflichtende menschliche Bestätigungen für sensible Aktionen.
Leistung von Muse Wonder Full
Muse Wonder Full ist eine separate Produktwahl. Meta bietet Standard-Muse Wonder über seine API an, während Full auf Power Usage- und Maximum Usage-Abos in Muse Code beschränkt ist. Ein höherer Score macht Full nicht zu einem API-Ersatz für das Standardmodell.
Metas gemeldete Wonder Full Ergebnisse sind 56 auf dem Intelligence Index, 59.1 auf Personal Superintelligence, 13.1 auf Harvey LAB-AA und 45.4 auf AutomationBench-AA. Es erzielt außerdem 79.0 auf DeepSWE 1.1, 57.5 auf SWE-Marathon, 85.5 auf MemoryBench und 75.3 auf JobBench. Diese veröffentlichten Ergebnisse beschreiben das separat zugängliche Full-Produkt; sie sind keine neuen Messungen aus einem gemeinsamen Harness-Vergleich.
Im Vergleich zu den oben genannten Standard-Muse-Wonder-Scores verbessert Full sieben dieser acht gemeldeten Messwerte; MemoryBench ist mit 85.5 gegenüber 85.6 leicht niedriger. Opus 5.5 führt den gemeldeten Intelligence Index weiterhin mit 58 an.
Latenz und Zuverlässigkeit
Die zitierte Evidenz liefert keinen abgeglichenen Drei-Modell-Latenzvergleich. Messen Sie die Zeit bis zur ersten nützlichen Ausgabe, die mediane und 95. Perzentil End-to-End-Aufgabendauer, Timeout-Häufigkeit und Abschluss ohne Intervention. Halten Sie Aufgabeninputs, Toolberechtigungen, Parallelität und Abnahmekriterien konstant; protokollieren Sie Aufwandsstufen und Retry-Budgets. Eine schnellere Token-Generierung allein belegt nicht den schnelleren Abschluss einer mehrstufigen Aufgabe.
Vergleichsergebnis: Muse Wonder führt die zitierten Tests für nachhaltiges Engineering an, während Opus 5.5 die zitierten Terminal- und Programrekonstruktions-Tests anführt. GPT-6 Sol bleibt ein Kandidat mit niedrigeren Tokenpreisen, aber die verfügbaren Publikationen belegen kein Qualitäts- oder Geschwindigkeitsranking in gleicher Umgebung über alle drei hinweg.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Kosten
Offizielle API-Tokenpreise
| Preis pro 1M Tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standard Input | $4 | $4 | $2 |
| Standard Output | $20 | $20 | $10 |
| Cacher-Treffer Input | $0.20 | $0.20 | $0.20 |
| Long-Context Input | $4 | $4 | $4 |
| Long-Context Output | $20 | $20 | $15 |
| Long-Context Cacher-Input | $0.20 | $0.20 | $0.40 |
Meta veröffentlicht $4 Input, $20 Output und $0.20 Cacher-Treffer pro 1 Mio. Tokens. Anthropic listet Opus 5.5 mit $4 Input, $20 Output und $0.20 Cache-Hits pro 1 Mio. Tokens. OpenAIs Preistabelle listet GPT-6 Sol mit $2/$10 für Short-Context Input/Output und $4/$15 für Long Context; Cacher-Input-Sätze variieren ebenfalls je nach Tier. Wenden Sie das relevante kontextbezogene Tier, den Verarbeitungsmodus und die Endpoint-Bedingungen pro Anfrage an, bevor Sie einen Workload schätzen.
Für GPT-6 Sol werden Anfragen mit mehr als 272,000 Input-Tokens zu höheren Sätzen abgerechnet:
- Input-Tokens: 2× des Standardpreises, Erhöhung von $2 auf $4 pro 1 Mio. Tokens.
- Cacher-Input-Tokens: 2× des Standardpreises, Erhöhung von $0.20 auf $0.40 pro 1 Mio. Tokens.
- Output-Tokens: 1.5× des Standardpreises, Erhöhung von $10 auf $15 pro 1 Mio. Tokens.
Diese höheren Sätze gelten für die gesamte Anfrage, nicht nur für die Tokens über 272,000. Eine Anfrage mit 272,001 Input-Tokens fällt daher in das Long-Context-Preistier für alle ihre Input-, Cacher-Input- und Output-Tokens.
Im Vergleich dazu erheben Muse Wonder und Claude Opus 5.5 unter ihren Standard-API-Preisen keinen vergleichbaren Long-Context-Aufschlag.
Diese Unterscheidung ist besonders wichtig für die Analyse großer Dokumente, repositoryweite Codierung und lang laufende KI-Agenten, bei denen sich der Short-Context-Preisvorteil von GPT-6 Sol verengen kann, sobald Anfragen größer werden.
CometAPI-Preise und Abrechnungsbedingungen
Zum Zeitpunkt der Begutachtung listete CometAPI Opus 5.5 mit $3.20 Input / $16 Output und GPT-6 Sol mit $1.60 Input / $8 Output pro 1 Mio. Tokens. Dies sind unabhängige Sätze von CometAPI und dürfen nicht mit den oben genannten offiziellen Anbieterpreisen verwechselt werden. Bestätigen Sie die zutreffende Route, das Kontext-Tier und die Abrechnungsbedingungen des Kontos, bevor Sie Kosten schätzen; Preise und Bedingungen können sich ändern.
Kosten pro akzeptierter Aufgabe
Berechnen Sie die Kosten pro akzeptierter Aufgabe als gesamte abgerechnete Modell- und Toolausgaben, einschließlich berechneter Retries und Fallbacks, geteilt durch die Anzahl der Ausgaben, die vordefinierte Abnahmekriterien erfüllen. Erfassen Sie die menschliche Reviewzeit separat oder konvertieren Sie sie mittels einer expliziten Arbeitskostenrate. Verfolgen Sie fehlgeschlagene Anfragen und tatsächliche Gebühren unabhängig: Ein Fehlschlag allein belegt nicht, ob eine Anfrage abgerechnet wurde.
Vergleichsergebnis: GPT-6 Sol hat die niedrigsten gelisteten Standard-Short-Context-Input- und Output-Sätze, während Muse Wonder und Opus 5.5 dieselben Basissätze teilen. Die tatsächlichen Kosten pro akzeptierter Aufgabe hängen von der gewählten Billing-Route, Cache-Nutzung, Kontext-Tiers, Toolgebühren, Retries und Reviewaufwand ab.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Vergleich und Auswahl
Auswahl nach Fähigkeiten und Workload
- Für breit angelegtes Coding und Terminal-Workflows beginnen Sie mit Claude Opus 5.5, da es den zitierten Intelligence Index, Terminal-Bench und ProgramBench anführt. Validieren Sie es bei Refactoring, Toolausführung und Programmkonsistenz auf Ebene des gesamten Programms.
- Für erweiterte Engineering-Projekte beginnen Sie mit Muse Wonder, da seine gemeldeten DeepSWE- und SWE-Marathon-Ergebnisse stärker sind als die von Opus 5.5. Messen Sie Aufgabenabschluss, Wiederherstellung nach Hindernissen und Gesamtkosten der Aufgabe.
- Für persistente persönliche Agenten beginnen Sie mit Muse Wonder, da es Active Memory und Active Focus bietet und einen höheren gemeldeten MemoryBench-Score als Opus 5.5 hat. Testen Sie Recall, Korrekturen, Kontinuität und Projektisolation.
- Für mehrstufige Tool-Workflows evaluieren Sie alle drei Modelle. Muse bietet Active Focus, Opus betont Tool-Orchestrierung und GPT-6 Sol unterstützt Responses API Tools. Vergleichen Sie den gesamten Agent-Stack einschließlich Toolberechtigungen, Retries und Zustandsbehandlung.
- Für professionelle Dokumente und Analysen evaluieren Sie Muse Wonder oder Claude Opus 5.5. Muse hat spezialisierte Stärken, während Opus den stärkeren zitierten aggregierten Index hat. Verwenden Sie repräsentative Dokumente und aufgabenspezifische Abnahmekriterien.
- Für hochvolumige, kostenempfindliche Automatisierung beginnen Sie mit GPT-6 Sol, da es die niedrigsten gelisteten Standard-Short-Context-Input- und Output-Sätze hat. Prüfen Sie Kosten pro akzeptierter Aufgabe, Kontext-Tiers, Latenz und Retries.
- Für Metas High-End-Option evaluieren Sie Muse Wonder Full, sofern es zugänglich ist. Es weist höhere gemeldete Scores bei mehreren spezialisierten Aufgaben auf, ist jedoch separat vom Standard-API-Modell. Bestätigen Sie Abozugang und Eignung vor dem Test.
Professionelle Programmierung
Claude Opus 5.5 ist eine gute Default-Wahl für Teams, die einen breit aufgestellten Engineering-Assistenten benötigen, insbesondere dort, wo Toolausführung, Refactoring und Programmkonsistenz wichtig sind. Seine gemeldeten Vorteile bei Terminal-Bench und ProgramBench stärken diesen Fall, obwohl Teams den gesamten Agent-Stack und nicht nur das Modell validieren sollten.
Automatisierung mit hohem Volumen
GPT-6 Sol ist attraktiv, wenn Anfragen zahlreich sind und Kostensensitivität hoch ist. Selbst ein moderater Qualitätsrückstand kann bei risikoarmen, leicht prüfbaren Aufgaben wie dem Erstellen von Dokumentationsentwürfen, dem Extrahieren strukturierter Felder oder dem Erklären von Code akzeptabel sein. Verfolgen Sie bei langen autonomen Läufen Qualität, Tokens, Latenz und Retries gemeinsam.
Checkliste für Produktionsevaluation
Die Produktionsevaluation sollte sechs Metriken erfassen: Korrektheit, gemessen an akzeptierten Antworten oder bestandenen Tests; Zuverlässigkeit, gemessen an Aufgaben, die ohne menschliche Rettung abgeschlossen wurden; Latenz, gemessen an der End-to-End-Aufgabendauer; Tokenverbrauch, gemessen an insgesamt abgerechneten Input- und Output-Tokens; Agenteneffizienz, gemessen an Toolaufrufen und korrigierenden Retries; und effektive Kosten, berechnet als Gesamtausgaben geteilt durch akzeptierte Aufgaben.
Vergleichsergebnis: Setzen Sie Muse Wonder auf die Shortlist für persistente Agenten und erweiterte Engineering-Aufgaben, Opus 5.5 für breite Coding-Workflows mit starken Terminalanforderungen und GPT-6 Sol, wenn Tokenkosten ein wesentlicher Constraint sind. Befördern Sie einen Kandidaten erst, nachdem er aufgabenspezifische Qualitäts- und Zuverlässigkeitsschwellen erfüllt.
Wo können Sie Muse Wonder, Claude Opus 5.5 und GPT-6 Sol abrufen?
Offizieller Zugang der Anbieter
Nutzen Sie die Meta Model API für Standard-Muse Wonder, die Anthropic API für Opus 5.5 oder die OpenAI API für GPT-6 Sol. Muse Wonder Full ist über die angegebenen Muse Code-Aboplanungen verfügbar und kein Drop-in-Ersatz für das Standard-API-Modell. Prüfen Sie Konto-Zugänge, Nutzungslimits und unterstützte Request-Funktionen für die gewählte Route.
Zugang über CometAPI
Ein einheitliches Gateway kann Authentifizierung, Abrechnung und Routing vereinfachen. Nutzen Sie ein leistungsfähigeres Modell für komplexe Architektur-Reviews und ein günstigeres Modell für repetitive, risikoarme Entwürfe. Die Modellkennung und das unterstützte Request-Format sollten stets gegen den Ziel-API-Endpoint geprüft werden.
Entwickler können die Claude Opus 5.5 API in CometAPI und die GPT-6 Sol API in CometAPI nutzen, um repräsentative Workloads zu evaluieren. Bestätigen Sie die unterstützte API-Oberfläche für jedes Modell, statt anzunehmen, dass ein gemeinsames Gateway alle Request-Formate austauschbar macht.
Die in diesem Artikel genannten CometAPI-Routen decken Opus 5.5 und GPT-6 Sol ab. Dieser Artikel etabliert keine CometAPI-Route für Muse Wonder oder Wonder Full; verwenden Sie die bestätigte Anbieterroute, wenn Sie diese Produkte evaluieren.
Fazit
Kein einzelnes Modell gewinnt in jedem Workload. Muse Wonder ist der stärkste Kandidat für persistentes Agentenverhalten und lang laufende Engineering-Aufgaben. Claude Opus 5.5 ist ein starker Kandidat für breites Coding, terminallastige Workflows und Wissensarbeit, und es führt den von Meta gemeldeten Artificial Analysis Intelligence Index an. GPT-6 Sol bietet die niedrigsten Standard-Short-Context-Tokenpreise und ist für kostensensitive Automatisierung attraktiv. Produktionsteams sollten die endgültige Wahl anhand von Qualität akzeptierter Aufgaben, Zuverlässigkeit, Latenz, Retries, Toolnutzung und Gesamtkosten auf repräsentativen Workloads treffen.
FAQ
Wie können Teams Muse Wonder, Opus 5.5 und GPT-6 Sol fair testen?
Verwenden Sie einen zurückgehaltenen Satz realer Aufgaben mit festen Abnahmekriterien, identischen Input-Artefakten und dokumentierten Toolberechtigungen. Protokollieren Sie jede Modellversion, Aufwandsstufe, Agent-Harness, Timeout und Tokenbudget. Führen Sie Wiederholungen durch, wenn Ausgaben variieren, berichten Sie Fehlschläge ebenso wie Erfolge und trennen Sie einen Vergleich im gemeinsamen Harness von einem Vergleich bestkonfigurierter Systeme. So entstehen Evidenzen, die auf Ihren Workflow zutreffen statt auf das Benchmark-Setup eines anderen Teams.
Kann ein API-Gateway Agentenzustand bewahren, wenn Modelle gewechselt werden?
Eine gemeinsame Gateway-Adresse garantiert nicht von sich aus portablen Konversationszustand, Tool-Call-IDs oder gespeicherte Antwortreferenzen. Halten Sie eine kanonische Anwendungsseite-Aufzeichnung von Nachrichten, Toolausgaben und validiertem Aufgabenstatus. Testen Sie den Zustands- und Toolsemantik jedes Pfads, bevor Sie einen laufenden Job auf ein anderes Modell routen; andernfalls kann ein günstiger Fallback Informationen verlieren, die für den korrekten Abschluss nötig sind.
Wie sollten Teams Retries und menschliche Reviews budgetieren?
Definieren Sie ein akzeptiertes Ergebnis vor dem Test, teilen Sie dann die gesamten abgerechneten Modell- und Toolausgaben durch die akzeptierten Ergebnisse. Berichten Sie Reviewarbeit separat oder inkludieren Sie sie mit einer angegebenen Stundenrate. Zählen Sie fehlgeschlagene Versuche, Korrekturaufrufe und Fallback-Modelle und vergleichen Sie sowohl typische als auch hochkostenintensive Aufgaben. So vermeiden Sie, einen niedrigeren Tokenpreis als garantierte Reduktion der Kosten nützlicher Arbeit zu behandeln.
Was sollte eine speichersensitive Agenten-Evaluation umfassen?
Testen Sie, ob der Agent relevante Fakten erinnert, Korrekturen integriert, veraltete Anweisungen ignoriert und separate Projekte isoliert hält. Integrieren Sie verzögerte Follow-ups und widersprüchliche Updates statt nur eines einzelnen langen Prompts. Prüfen Sie Memory-Verhalten auf Anwendungsebene ebenso wie auf Modellebene, da Persistenz, Retrieval und Löschung vom eingesetzten System abhängen.